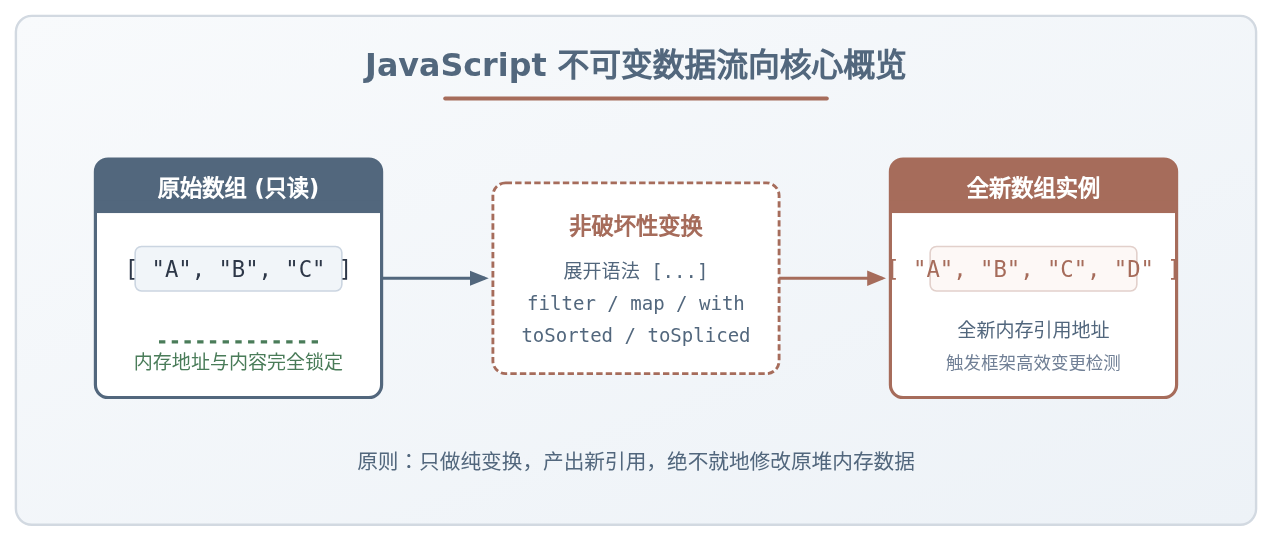
JS怎么动态向对象数组添加元素及合并技巧
全面讲解JavaScript中动态向对象数组添加元素的常用方法与合并技巧,深入分析就地修改与不可变更新、Map主键去重、属性融合机制及浅拷贝引用防范方案。
核心解决路径:在JavaScript中处理对象数组([{ id: 1, ... }])时,动态添加元素主要取决于插入位置与是否保留不可变性(末尾 push 与 [...arr, item]、开头 unshift 与 [item, ...arr]、任意位置 splice);多数组合并的核心则在于是否需要按业务主键去重或融合属性(简单拼接使用 concat / 扩展运算符,去重与字段融合推荐采用 Map 映射哈希)。理解浅拷贝与内存引用共享,是避免状态突变 Bug 的关键前提。
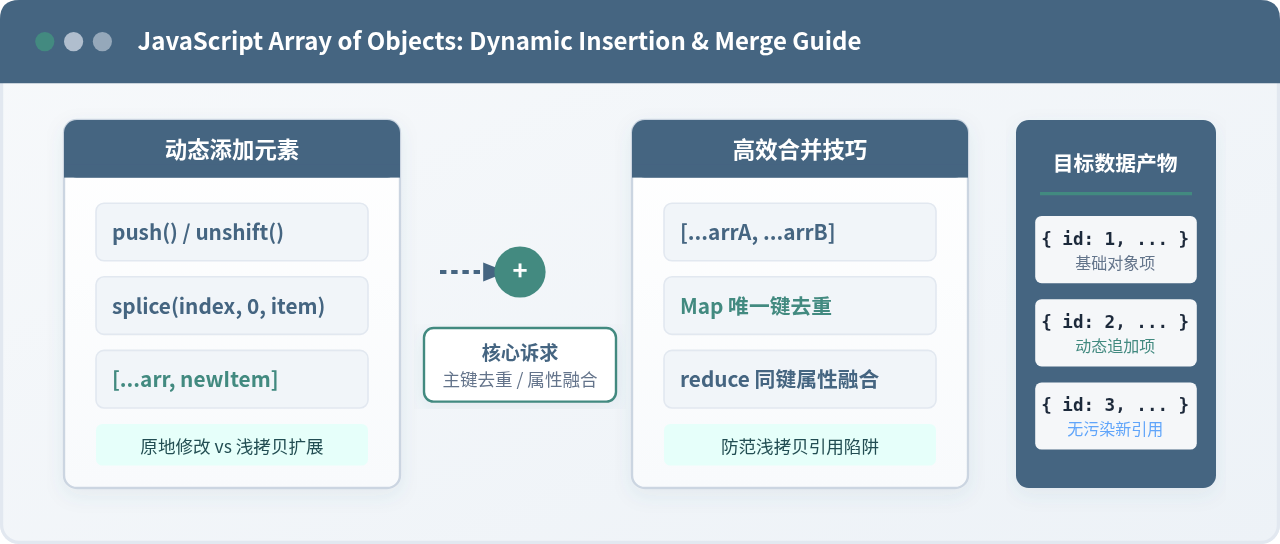
一、动态向对象数组添加元素的方法
向已有的对象数组中插入一个或多个新对象是前端开发中最基础的操作,如表单项动态新增、即时通讯消息追加或表格行插入。根据“是否直接修改原数组内存”,操作方式严格划分为原地修改(可变更新)与不可变复制(返回全新数组)两大流派。
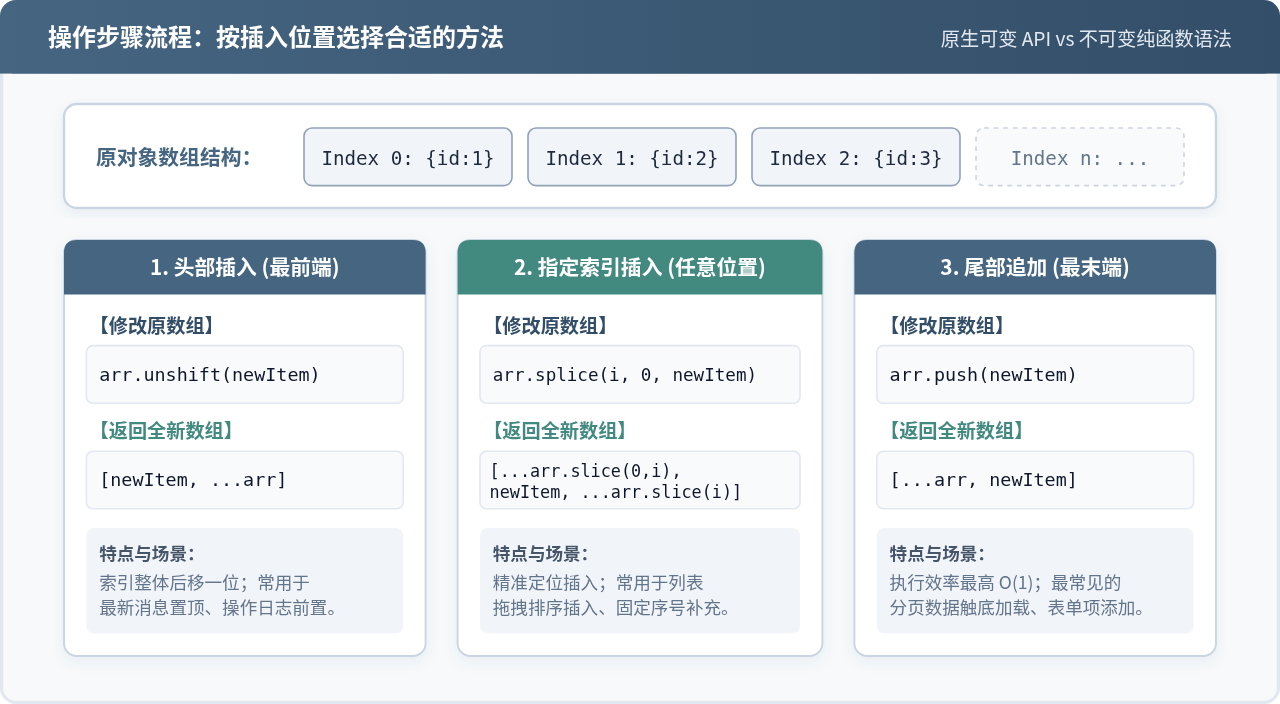
1. 尾部追加元素:push 与扩展运算符
尾部追加是频率最高、执行效率最高(时间复杂度为 O(1))的场景。
做法一:push() 原地修改
如果不需要维护状态库的历史快照,直接使用 push() 效率最高:
// 基础对象数组
const userList = [
  { id: 101, name: '张三', role: '开发' },
  { id: 102, name: '李四', role: '测试' }
];

// 动态创建待添加的新对象
const newUser = { id: 103, name: '王五', role: '运维' };

// 原地向尾部追加,push 返回追加后的数组长度
const newLength = userList.push(newUser);
console.log(newLength); // 输出: 3
console.log(userList);做法二:扩展运算符 [...arr, newItem] 不可变更新
在 React(如 setUsers(prev => [...prev, newUser]))或 Redux 中,修改原数组不会触发浅层对比更新,必须生成新的数组引用:
const baseUsers = [{ id: 101, name: '张三' }];
const nextUsers = [...baseUsers, { id: 102, name: '李四' }];

console.log(nextUsers !== baseUsers); // 输出: true (不同数组引用,触发视图更新)
2. 头部插入元素:unshift 与扩展运算符
当需要实现“最新操作日志置顶”或“最新消息在最上方展示”时,需要向头部插入:
const noticeList = [{ id: 1, title: '系统维护公告' }];
const urgentNotice = { id: 2, title: '紧急停服通知' };

// 方式 A:原地前置 (原数组被修改,后续元素下标全部 +1)
noticeList.unshift(urgentNotice);

// 方式 B:纯函数前置 (生成新数组,原数组不受影响)
const updatedNotices = [urgentNotice, ...noticeList];
3. 指定索引位置插入:splice 与 slice 组合
当对象数组支持拖拽排序、或要求按照特定的优先级序号插入时,使用索引插入:
const taskQueue = [
  { id: 1, task: '任务 A' },
  { id: 3, task: '任务 C' }
];
const insertItem = { id: 2, task: '任务 B (插队)' };

// 语法:splice(起始索引, 删除个数, 要插入的元素)
// 在索引 1 的位置插入 insertItem,删除 0 个元素
taskQueue.splice(1, 0, insertItem);
console.log(taskQueue);如果需要在不修改原数组的前提下指定位置插入,可以使用 slice 结合扩展运算符:
const index = 1;
const newQueue = [
  ...taskQueue.slice(0, index),
  insertItem,
  ...taskQueue.slice(index)
];
二、对象数组的高效合并技巧
不同于基本类型数组(如 [1, 2, 3])只需简单去重,对象数组往往包含复合字段和业务主键(例如 id 或 uuid)。业务场景中合并两个对象数组通常有三种诉求:
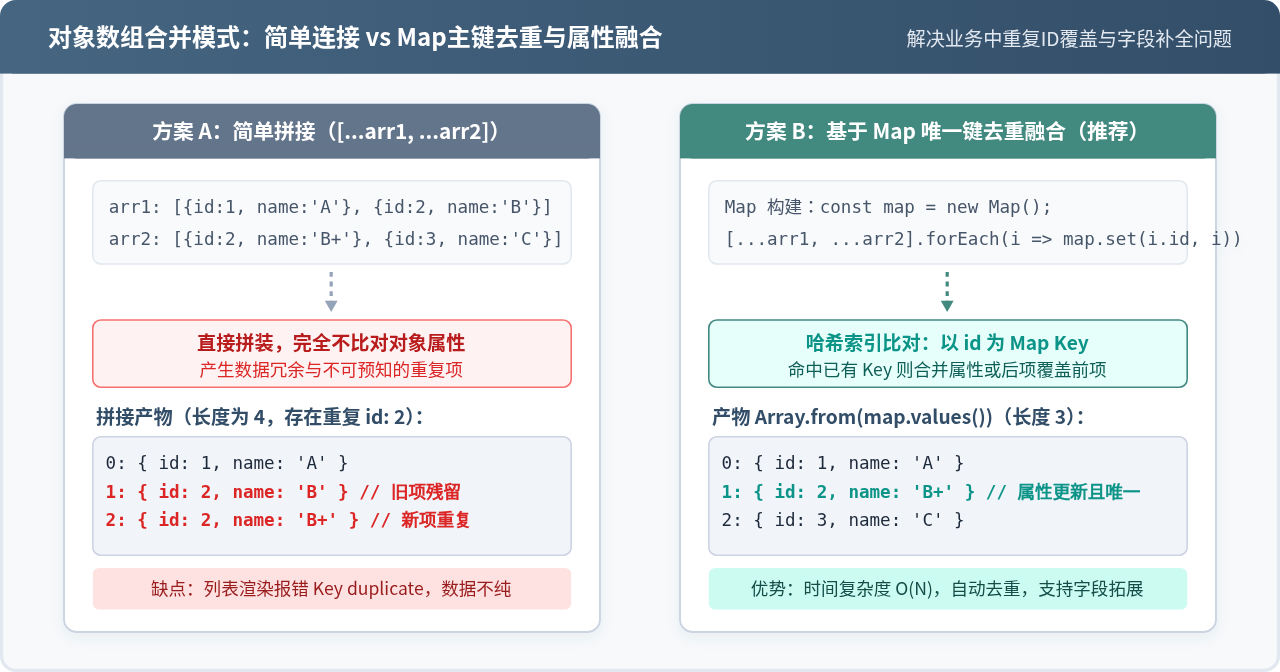
1. 简单连接:允许重复项直接拼接
如果两个数组来源完全独立(如两段不同的审计流水),且允许存在相同的对象字段,直接使用 concat() 或 [...arrA, ...arrB] 即可:
const localData = [{ id: 1, title: '本地草稿' }];
const remoteData = [{ id: 2, title: '云端归档' }];

// 语法简洁推荐:扩展运算符
const allData = [...localData, ...remoteData];
2. 核心技巧:按唯一主键(如 id)去重合并
在实际分页加载或下拉刷新中,后端可能返回已经存在的记录。直接拼接会导致页面渲染报错(如 React 的 Encountered two children with the same key)。
推荐方案:利用 ES6 Map 保持 O(N) 线性时间复杂度
Map 的键具有唯一性,后写入的键会自动覆盖先前的键。这是目前工程上性能最好、代码最清晰的做法:
const sourceA = [
  { id: 1, name: 'Alice', score: 85 },
  { id: 2, name: 'Bob', score: 90 }
];

const sourceB = [
  { id: 2, name: 'Bob', score: 95 }, // id: 2 重复,带有更新的 score
  { id: 3, name: 'Charlie', score: 88 }
];

// 封装为通用的去重合并函数
function mergeByUniqueKey(arr1, arr2, key = 'id') {
  const itemMap = new Map();
  // 依次将元素存入 Map,遇到相同 key 后者会直接覆盖前者
  [...arr1, ...arr2].forEach(item => itemMap.set(item[key], item));
  // 将 Map 的 values 导出为标准数组
  return Array.from(itemMap.values());
}

const merged = mergeByUniqueKey(sourceA, sourceB, 'id');
console.log(merged);forEach 内部加上条件判断:if (!itemMap.has(item[key])) itemMap.set(item[key], item); 即可。
3. 高级技巧:同主键对象的属性深度增量融合
有时两个数组包含的是相同实体在不同维度的字段(例如:数组 A 包含用户的基本资料 { id: 1, name: 'Alice' },数组 B 包含其权限与部门 { id: 1, dept: 'RD', role: 'Lead' })。此时不仅要合并数组,还要将相同 id 的内部字段融为一体:
const userBase = [
  { id: 1, name: 'Alice' },
  { id: 2, name: 'Bob' }
];

const userProfile = [
  { id: 1, dept: '技术部', level: 'P7' },
  { id: 3, dept: '市场部', level: 'P6' }
];

function fuseObjectArrays(arr1, arr2, key = 'id') {
  const resultMap = new Map();

  // 处理基准数组
  arr1.forEach(item => {
    resultMap.set(item[key], { ...item });
  });

  // 增量打补丁:若已存在则属性合流,若不存在则直接设置
  arr2.forEach(item => {
    const existing = resultMap.get(item[key]);
    if (existing) {
      resultMap.set(item[key], { ...existing, ...item });
    } else {
      resultMap.set(item[key], { ...item });
    }
  });

  return Array.from(resultMap.values());
}

const completeList = fuseObjectArrays(userBase, userProfile, 'id');
console.log(completeList);三、关键避坑指南:浅拷贝与引用共享风险
JavaScript 中对象为引用类型(Reference Type)。无论使用 push、concat 还是扩展运算符 [...arrA, ...arrB],复制的仅仅是对象在内存堆中的指针地址,而不是真正的对象副本。
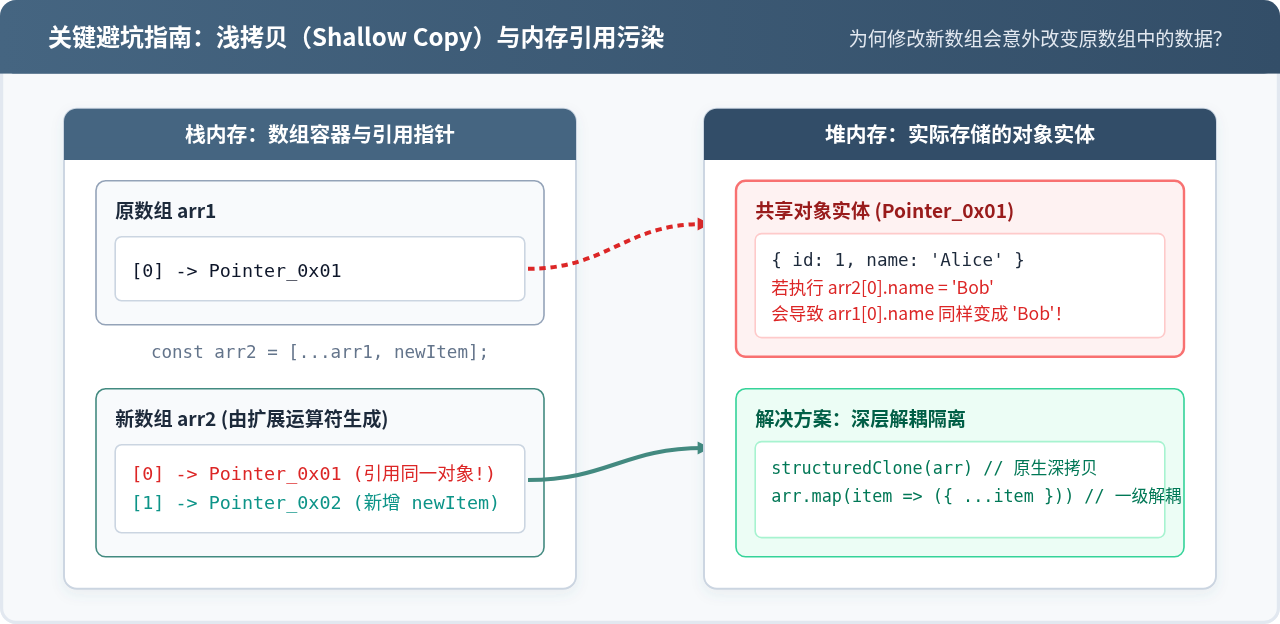
const listA = [{ id: 1, status: 'pending' }];
// 表面上创建了一个“新”数组
const listB = [...listA, { id: 2, status: 'active' }];

// 修改新数组中下标为 0 的对象属性
listB[0].status = 'completed';

// 陷阱触发:原数组中的对象属性也被同步修改了!
console.log(listA[0].status); // 输出: 'completed' (并非期望中的 pending)
如何彻底规避引用污染?
根据对象的层级复杂度,采取针对性解耦策略:
- 单层扁平对象(浅层解耦):在合并或添加时,对每个内部对象执行一次解构:
const safeList = listA.map(item => ({ ...item })); - 多层深层嵌套对象(推荐原生
structuredClone):现代主流浏览器与 Node.js 17+ 原生支持structuredClone(),具备原生高性能深拷贝能力:// 完全隔离内存地址,彻底切断指针引用 const isolatedList = structuredClone(listA); const safeMerged = [...isolatedList, { id: 2, status: 'active' }]; safeMerged[0].status = 'completed'; console.log(listA[0].status); // 保持为: 'pending' (安全隔离)
四、性能考虑与工程选型指南
在不同规模的数据集和不同的框架体系下,操作方法的选择会直接影响内存占用与界面渲染性能。
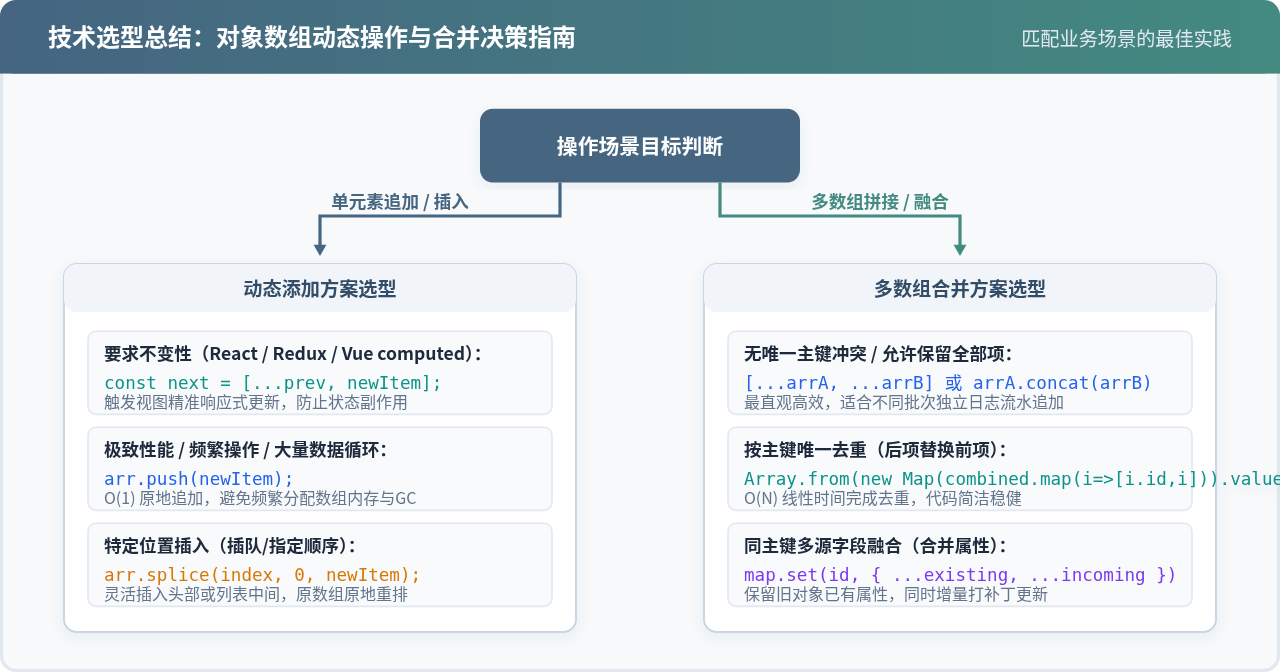
1. 大数据量循环下的 GC 与内存对比
如果在几千次循环中不断执行 arr = [...arr, newItem],每一次执行都会重新申请一块新的连续内存区,并将前序所有元素的指针挨个复制一遍,不仅时间复杂度退化为 $O(N^2)$,还会触发垃圾回收器(Garbage Collector)频繁工作导致界面卡顿。
优化法则:在纯数据运算、循环解析等局部函数内部,优先使用 arr.push() 原地构建数据;最终在返回或者提交到响应式状态管理器时,再做一次统一的引用更新:
// 优秀实践:局部高效构建 + 最终一次性不可变提交
const buffer = [];
for (let i = 0; i < 5000; i++) {
  buffer.push({ index: i, timestamp: Date.now() });
}
// 触发一次 React/Vue 状态赋值
setRecords(prev => [...prev, ...buffer]);
2. 常见方法横向特性速查表
| 操作目标 | 推荐方案 | 是否修改原数组 | 时间复杂度 | 最适合场景 |
|---|---|---|---|---|
| 尾部追加单项 | arr.push(item) |
是 | O(1) | 大量数据循环、算法密集计算 |
| 不可变尾部追加 | [...arr, item] |
否 | O(N) | React/Vue 响应式状态更新 |
| 头部置顶单项 | [item, ...arr] |
否 | O(N) | 最新公告、最新聊天信息前置 |
| 指定位置插队 | arr.splice(i, 0, item) |
是 | O(N) | 拖拽调整顺序、特定序号插入 |
| 无去重要求合并 | [...arrA, ...arrB] |
否 | O(N+M) | 异构数据组装、日志批量合并 |
| 按主键去重合并 | new Map() 键映射 |
否 | O(N+M) | 列表分页加载防重、下拉刷新合并 |
| 同主键字段补丁 | Map + Object.assign |
否 | O(N+M) | 主详情表字段结合、配置热补丁 |
五、常见问题排查与解答
Q1: 为什么使用 new Set([...arrA, ...arrB]) 无法对对象数组去重?
Set 内部是通过类似于全等运算符(===)来判断元素是否相等的。对于对象而言,两个看似内容完全相同的对象字面量(例如 { id: 1 } !== { id: 1 })在堆内存中具有不同的指针地址,因此 Set 无法识别对象内部的业务主键。对象数组去重必须使用基于特定键(如 item.id)的 Map 映射或 filter 索引匹配。
Q2: 数组中有 null 或 undefined 元素时合并报错如何处理?
当数组可能存在未定义项或空项时,直接解构或访问键会触发异常。可以在合并前加入过滤管道:
// 过滤无效假值后再执行合并
const cleanA = rawA.filter(Boolean);
const cleanB = rawB.filter(Boolean);
const safeList = [...cleanA, ...cleanB];JS判断null与undefined的区别及正确写法
2026-11-20 11:15:14
怎么用Promise.race手动封装JavaScript请求超时逻辑
2026-11-20 10:35:07
JS解析JSON报错SyntaxError怎么解决
2026-11-20 10:17:25
JS闭包经典案例:怎么实现计数器与数据私有化
2026-11-20 10:12:25
JavaScript字符串拼接:+运算符与模板字符串用法对比
2026-11-20 09:28:29