Node.js环境下怎么使用JavaScript神经网络库进行模型训练
本文详细讲解在Node.js服务端环境下使用JavaScript神经网络库进行模型训练的完整实战流程,涵盖库选型、张量数据预处理、模型拓扑搭建、编译训练、内存回收及模型持久化。
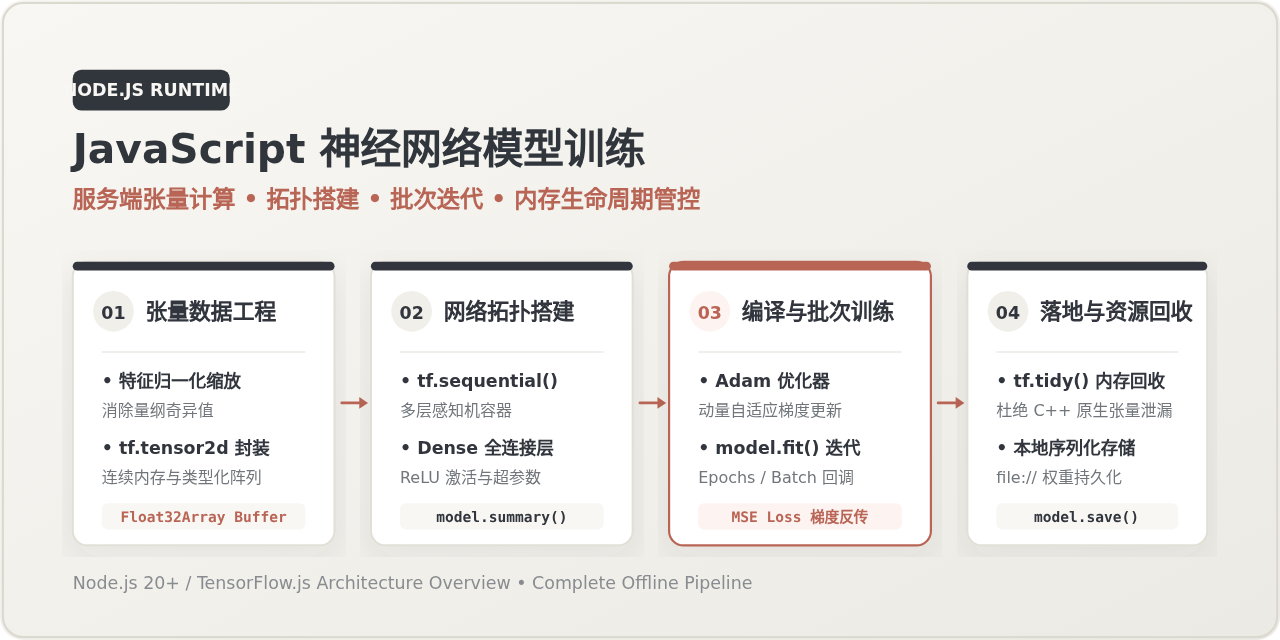
在 Node.js 服务端进行神经网络模型训练,最完备且具备工业落地能力的方案是使用 TensorFlow.js。借助其提供的张量计算底层与高阶 Layers API,开发者无需切换至 Python 运行时,即可在 JavaScript 异步单线程环境中完成特征张量化、多层感知机搭建、反向传播梯度优化以及训练产物的本地序列化。本文以经典的多元数值回归预测为具体任务,逐一拆解环境依赖配置、张量内存管理、模型构建与批次迭代训练的端到端实现细节。
一、运行环境与核心依赖选型
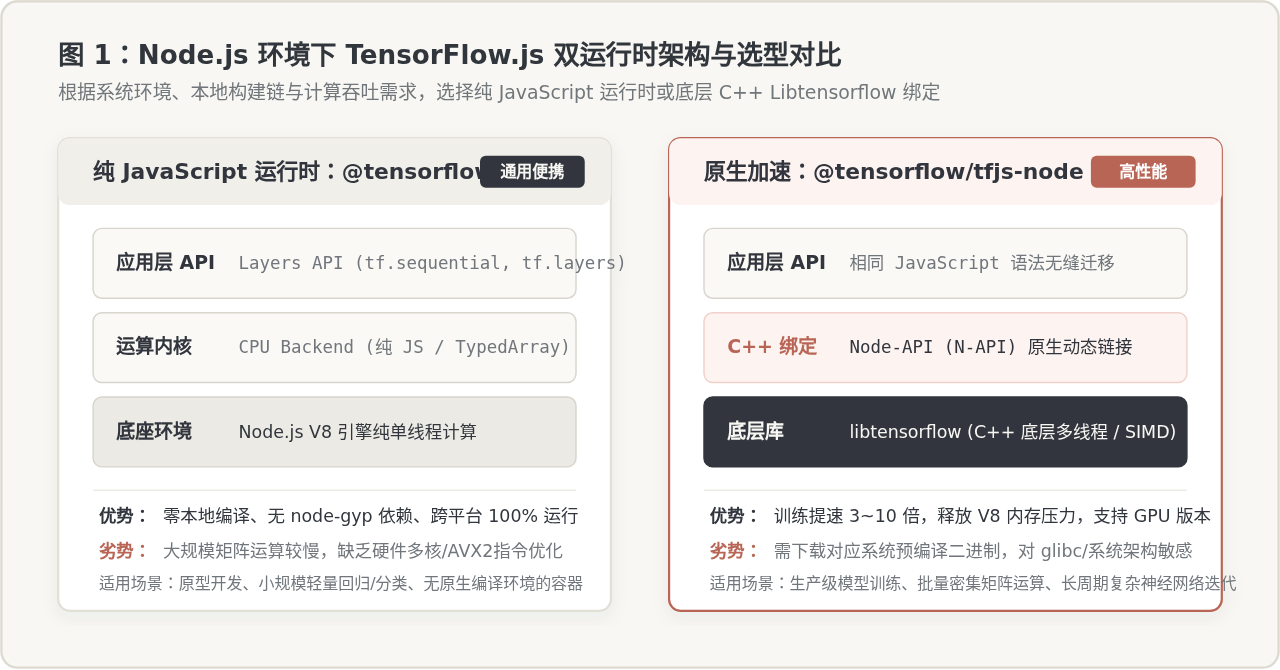
在 Node.js 中安装 TensorFlow.js 时,开发者会面临两种截然不同的包名选项:纯 JavaScript 版本的 @tensorflow/tfjs 与带有原生 C++ 绑定的 @tensorflow/tfjs-node。理解两者的底层差异是确保训练任务稳定执行的前提。
| 包名 | 底层计算驱动 | 编译与安装要求 | 训练性能 | 适用场景 |
|---|---|---|---|---|
| @tensorflow/tfjs | Node.js V8 引擎纯 JS / TypedArray | 零系统编译依赖,纯跨平台 npm 安装 | 基准基线(单线程计算,较慢) | 轻量原型开发、CI/CD 自动化测试、受限容器 |
| @tensorflow/tfjs-node | C++ libtensorflow 动态链接库 | 需下载对应平台的预编译二进制,依赖 glibc | 提升 3~10 倍(支持 CPU 多核 SIMD) | 生产级离线模型训练、批处理计算、复杂神经网络 |
若你的运行环境具备网络访问且架构为常见 x86_64 或 ARM64(如 macOS Apple Silicon 或 Linux 服务器),推荐首选 @tensorflow/tfjs-node。若处于严格沙箱环境或安装原生插件受限,则引入 @tensorflow/tfjs 即可,两者的上层 API 保持完全一致。
初始化项目与安装依赖的命令如下:
# 创建并初始化 Node.js 工程
mkdir tfjs-node-training && cd tfjs-node-training
npm init -y

# 安装带有原生硬件加速的 TensorFlow.js(若环境受限可换为 @tensorflow/tfjs)
npm install @tensorflow/tfjs-node
二、数据准备与特征张量化
神经网络的数学内核是矩阵乘法与偏置累加,无法直接操作 JavaScript 中的 Object 或 Array。我们需要完成两项准备工作:特征归一化(Normalization)与张量转换(Tensorization)。
1. 为什么必须进行特征归一化
假设我们根据房屋的“建筑面积(80~200㎡)”、“卧室数量(1~5间)”与“房龄(1~30年)”预测“总价(万元)”。建筑面积的绝对数值远大于卧室数量,若直接送入网络,大数值特征将在梯度计算中占据绝对主导地位,导致梯度震荡甚至损失函数变为 NaN。常用的 Min-Max 归一化公式为:
归一化值 = (原始值 - 最小值) / (最大值 - 最小值)2. 数据转换与张量构造示例
在 Node.js 中读取原始数据集后,使用 tf.tensor2d 构建二维张量(形状为 [样本数, 特征维度]):
const tf = require('@tensorflow/tfjs-node');

// 原始业务样本:每行代表 [面积, 卧室数, 房龄],标签为房屋价格(万元)
const rawFeatures = [
  [85, 2, 5],
  [120, 3, 12],
  [65, 1, 2],
  [150, 4, 8],
  [110, 3, 20],
  [95, 2, 1]
];
const rawLabels = [350, 480, 260, 620, 410, 400];

// 计算极值用于归一化,并持久化极值用于后续推理反算
function getMinMax(matrix) {
  const cols = matrix[0].length;
  const mins = new Array(cols).fill(Infinity);
  const maxs = new Array(cols).fill(-Infinity);
  for (let row of matrix) {
    for (let c = 0; c < cols; c++) {
      if (row[c] < mins[c]) mins[c] = row[c];
      if (row[c] > maxs[c]) maxs[c] = row[c];
    }
  }
  return { mins, maxs };
}

const normParams = getMinMax(rawFeatures);

// 归一化特征至 [0, 1] 区间
const normalizedFeatures = rawFeatures.map(row =>
  row.map((val, c) => (val - normParams.mins[c]) / (normParams.maxs[c] - normParams.mins[c]))
);

// 归一化标签
const labelMin = Math.min(...rawLabels);
const labelMax = Math.max(...rawLabels);
const normalizedLabels = rawLabels.map(y => (y - labelMin) / (labelMax - labelMin));

// 生成张量对象
const xTrain = tf.tensor2d(normalizedFeatures, [normalizedFeatures.length, 3]);
const yTrain = tf.tensor2d(normalizedLabels, [normalizedLabels.length, 1]);

console.log('特征张量形状:', xTrain.shape); // 输出 [6, 3]
console.log('标签张量形状:', yTrain.shape); // 输出 [6, 1]
三、构建神经网络拓扑结构(Sequential Model)
在 TensorFlow.js 中,最常用的模型容器是 tf.sequential()(序贯模型),它允许将神经网络层按顺序线性堆叠。对于回归或标准分类任务,全连接层 tf.layers.dense 能够满足大多数非线性建模需求。
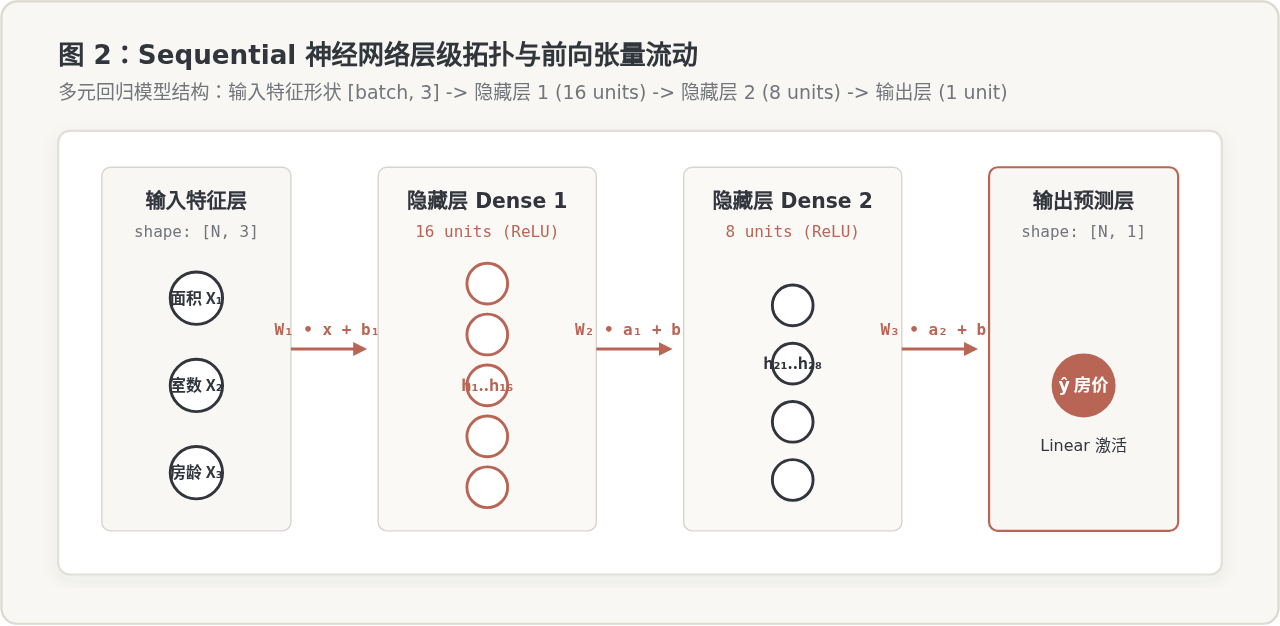
在定义第一层时,必须通过 inputShape 显式声明输入特征的维度。后续隐藏层会自动根据上一层的输出单元数推断输入尺寸。代码如下:
function buildRegressionModel() {
  const model = tf.sequential();

  // 输入层 + 第一隐藏层:16个神经元,ReLU 激活函数,输入维度为 3
  model.add(tf.layers.dense({
    inputShape: [3],
    units: 16,
    activation: 'relu',
    kernelInitializer: 'glorotNormal'
  }));

  // 第二隐藏层:8个神经元,引入非线性拟合能力
  model.add(tf.layers.dense({
    units: 8,
    activation: 'relu'
  }));

  // 输出层:1个神经元(预测连续数值),回归任务采用线性激活(linear 或不填)
  model.add(tf.layers.dense({
    units: 1,
    activation: 'linear'
  }));

  return model;
}

const model = buildRegressionModel();
model.summary(); // 打印模型层级、参数量与张量输出形状结构设计要点:输出层的激活函数必须与任务类型精确对齐。单值连续回归预测使用 linear,二分类使用 sigmoid 并输出概率,多分类任务则使用 softmax 配合与类别数相同的 units。
四、模型编译与超参数配置(Compile & Optimizer)
模型搭建完成后,必须调用 model.compile() 指定三大核心要素:优化器(Optimizer)、损失函数(Loss Function)与评估指标(Metrics)。
- 优化器:推荐选用自适应动量估计优化器
tf.train.adam(learningRate)。学习率一般初设为0.01到0.001。学习率过大会导致震荡不收敛,过小则收敛缓慢。 - 损失函数:数值回归任务的标准选择是 均方误差(Mean Squared Error, MSE)。若样本包含较多异常离群点,也可选择平均绝对误差
meanAbsoluteError。 - 监控指标:在训练时同步计算并输出的标量,如
mse。
const learningRate = 0.01;
const optimizer = tf.train.adam(learningRate);

model.compile({
  optimizer: optimizer,
  loss: 'meanSquaredError',
  metrics: ['mse']
});
五、执行模型训练与回调监听(model.fit)
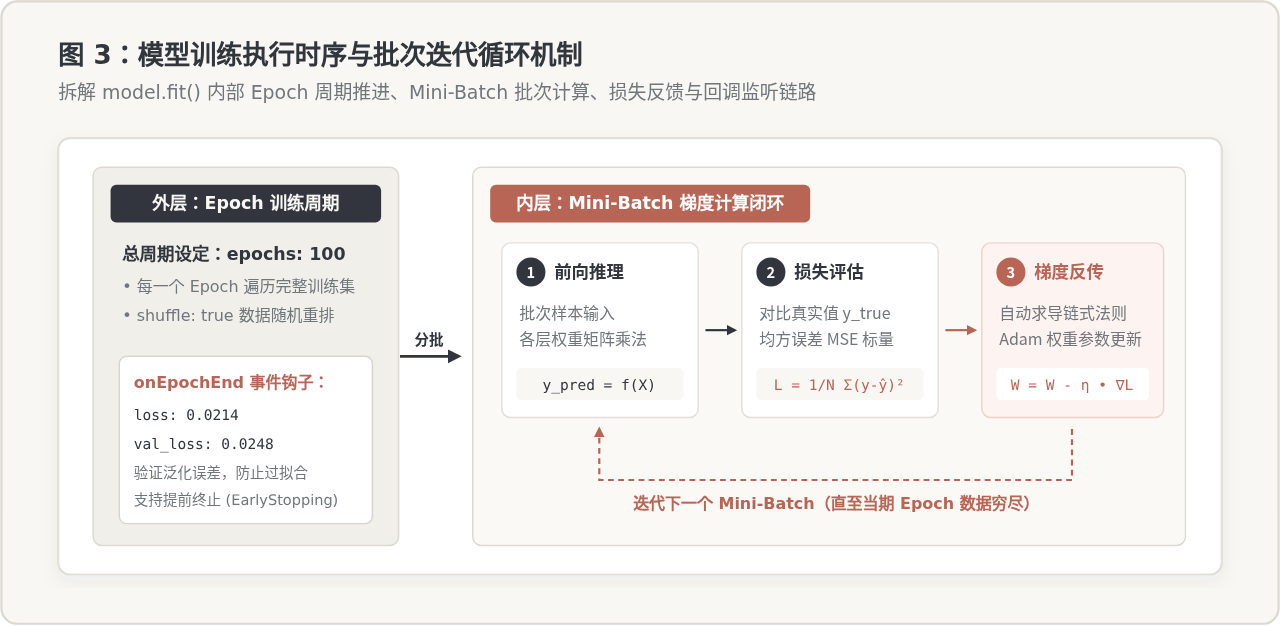
在 Node.js 中启动训练调用的是异步方法 model.fit(x, y, config)。该方法会返回一个 Promise,支持配置训练周期、批次大小以及事件回调。
关键配置参数解析
epochs:完整遍历训练数据集的轮数。小型数据集通常设置 50~200 轮。batchSize:每次前向传播与反向传播梯度更新时使用的样本切片数量。适中的批次(如 16 或 32)能平衡显存占用与梯度下降平滑度。validationSplit:从训练集中自动拆分出的验证集比例(如 0.2),用于在训练中评估模型在未见数据上的泛化表现,及时发现过拟合。callbacks:回调钩子,最常用的是onEpochEnd,可实时在终端打印当前的损失指标。
async function trainModel(model, xTrain, yTrain) {
  console.log('开始执行模型迭代训练...');

  const history = await model.fit(xTrain, yTrain, {
    epochs: 100,
    batchSize: 2,
    validationSplit: 0.2,
    shuffle: true,
    callbacks: {
      onEpochEnd: (epoch, logs) => {
        // 每隔 20 轮打印一次训练进度,降低控制台频繁 I/O 开销
        if ((epoch + 1) % 20 === 0 || epoch === 0) {
          console.log(
            `[Epoch ${String(epoch + 1).padStart(3, ' ')}] ` +
            `Loss: ${logs.loss.toFixed(5)} | ` +
            `Val Loss: ${logs.val_loss ? logs.val_loss.toFixed(5) : 'N/A'}`
          );
        }
      }
    }
  });

  console.log('模型训练完毕,最终损失:', history.history.loss.slice(-1)[0]);
}
六、Node.js 中的张量内存管理与避坑实践
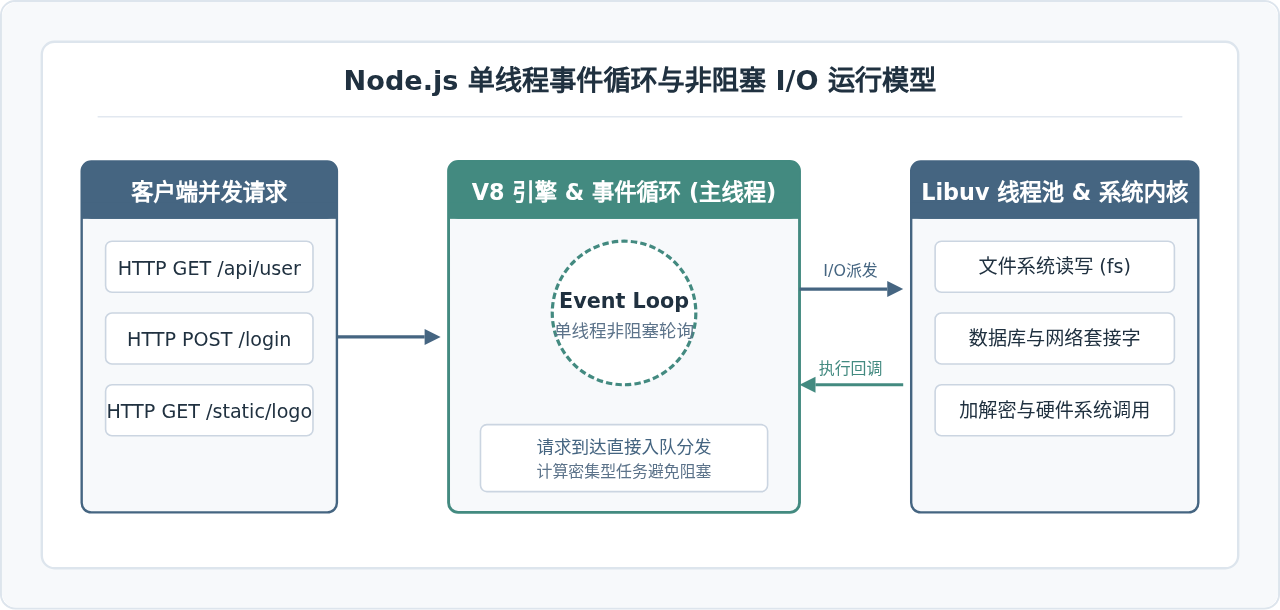
在 Node.js 服务端进行机器学习开发时,最容易引发生产故障的问题是张量内存泄漏。Node.js 的 V8 引擎垃圾回收机制只能感知到 JavaScript 对象的引用,但张量底层的多维数据数组是在 C++ 原生堆或 GPU 显存中开辟的。如果仅断开 JS 变量引用,底层的物理内存不会被 V8 回收,导致进程内存暴涨并触发 OOM 崩溃。
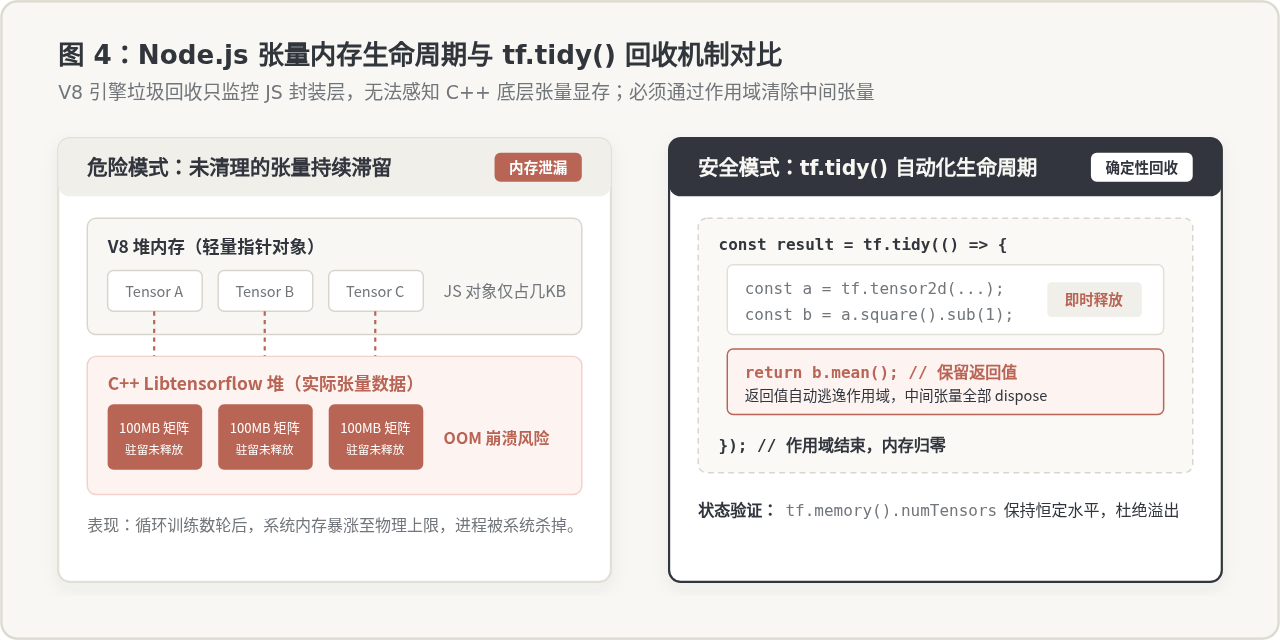
两种核心防泄漏手段
-
使用
tf.tidy(fn)包裹计算过程:
tf.tidy()是 TensorFlow.js 提供的作用域隔离函数。在函数执行完毕后,所有在其内部创建但没有被显式返回的中间临时张量都会被立即释放。适用于数据切片、归一化、特征计算与单次推理预测等同步操作。 -
显式调用
tensor.dispose():
异步操作(如async/await)内部不能直接包裹在tf.tidy()中。在完成训练后,初始构建的xTrain、yTrain等张量必须手动调用.dispose()销毁。 -
内存监控打点:
在关键节点调用tf.memory(),该方法返回当前持有的张量总数numTensors与已分配字节数numBytes。若循环运行中numTensors持续单调递增,即代表存在张量泄漏。
七、模型推理预测与持久化存储
模型训练完成后,通常需要保存到本地文件系统供线上业务直接加载推理,避免每次重启服务都重复耗时训练。
1. 使用 file:// 协议保存模型
在 Node.js 环境下,@tensorflow/tfjs-node 扩展了原生的 file:// 协议,允许直接落盘到指定本地目录:
// 保存训练成果至当前目录下的 ./house-price-model
const SAVE_PATH = 'file://./house-price-model';
await model.save(SAVE_PATH);
console.log('模型权重与拓扑已持久化保存至:', SAVE_PATH);

// 保存产物包括:
// 1. model.json:模型拓扑结构、层级定义与权重清单
// 2. weights.bin:二进制存储的模型权重与偏置参数
2. 加载模型并进行新样本推理
新数据必须经过与训练阶段完全一致的归一化参数转换后,方可送入模型预测;预测输出同样需要进行反归一化,还原为真实业务维度的数值:
async function predictNewHouse(model, inputFeatures, normParams, labelMin, labelMax) {
  // 将预测过程放入 tf.tidy() 中,自动回收中间张量
  const predictedValue = tf.tidy(() => {
    // 1. 特征归一化
    const normInput = inputFeatures.map((val, c) =>
      (val - normParams.mins[c]) / (normParams.maxs[c] - normParams.mins[c])
    );

    // 2. 构造形状为 [1, 3] 的输入张量
    const inputTensor = tf.tensor2d([normInput], [1, 3]);

    // 3. 执行前向推理
    const outputTensor = model.predict(inputTensor);

    // 4. 读取原始浮点标量
    const normalizedPred = outputTensor.dataSync()[0];

    // 5. 反归一化为真实价格
    const realPrice = normalizedPred * (labelMax - labelMin) + labelMin;
    return realPrice;
  });

  return predictedValue;
}

// 预测一套面积 105㎡、3室、房龄 6 年的房屋
const estimated = await predictNewHouse(model, [105, 3, 6], normParams, labelMin, labelMax);
console.log(`预测房价评估值: ${estimated.toFixed(2)} 万元`);
八、完整端到端可执行脚本
将上述所有模块整合成一个具备生产规范的完整脚本 train-pipeline.js,开发者可直接在 Node.js 中执行体验:
const tf = require('@tensorflow/tfjs-node');
const path = require('path');

async function runPipeline() {
  console.log('==============================================');
  console.log('   Node.js JavaScript 神经网络模型训练流水线    ');
  console.log('==============================================');

  // 1. 准备样本数据
  const rawFeatures = [
    [85, 2, 5],
    [120, 3, 12],
    [65, 1, 2],
    [150, 4, 8],
    [110, 3, 20],
    [95, 2, 1],
    [135, 3, 6],
    [70, 2, 15]
  ];
  const rawLabels = [350, 480, 260, 620, 410, 400, 530, 280];

  // 2. 特征统计与归一化
  const featureMins = [65, 1, 1];
  const featureMaxs = [150, 4, 20];
  const labelMin = 260;
  const labelMax = 620;

  const normX = rawFeatures.map(r =>
    r.map((v, i) => (v - featureMins[i]) / (featureMaxs[i] - featureMins[i]))
  );
  const normY = rawLabels.map(y => (y - labelMin) / (labelMax - labelMin));

  const xTrain = tf.tensor2d(normX, [normX.length, 3]);
  const yTrain = tf.tensor2d(normY, [normY.length, 1]);

  // 3. 构建模型
  const model = tf.sequential();
  model.add(tf.layers.dense({ inputShape: [3], units: 16, activation: 'relu' }));
  model.add(tf.layers.dense({ units: 8, activation: 'relu' }));
  model.add(tf.layers.dense({ units: 1, activation: 'linear' }));

  // 4. 编译配置
  model.compile({
    optimizer: tf.train.adam(0.01),
    loss: 'meanSquaredError',
    metrics: ['mse']
  });

  // 5. 训练模型
  console.log('[1/4] 开始模型拟合迭代...');
  await model.fit(xTrain, yTrain, {
    epochs: 80,
    batchSize: 4,
    callbacks: {
      onEpochEnd: (epoch, logs) => {
        if ((epoch + 1) % 20 === 0) {
          console.log(`Epoch [${epoch + 1}/80] - Loss: ${logs.loss.toFixed(6)}`);
        }
      }
    }
  });

  // 6. 保存模型
  const modelDir = path.resolve(__dirname, 'saved_model');
  await model.save(`file://${modelDir}`);
  console.log(`[2/4] 模型成功导出至本地: ${modelDir}`);

  // 7. 测试推理新样本 [100㎡, 2室, 8年]
  console.log('[3/4] 执行样本推理验证...');
  const testInput = [100, 2, 8];
  const predictedPrice = tf.tidy(() => {
    const normTest = testInput.map((v, i) => (v - featureMins[i]) / (featureMaxs[i] - featureMins[i]));
    const tensorInput = tf.tensor2d([normTest], [1, 3]);
    const predNorm = model.predict(tensorInput).dataSync()[0];
    return predNorm * (labelMax - labelMin) + labelMin;
  });
  console.log(`输入特征: 面积=${testInput[0]}㎡, 居室=${testInput[1]}, 房龄=${testInput[2]}年`);
  console.log(`预测售价: ${predictedPrice.toFixed(2)} 万元`);

  // 8. 清理持久训练张量,防止常驻内存
  xTrain.dispose();
  yTrain.dispose();
  console.log('[4/4] 训练张量释放完毕,当前系统张量总数:', tf.memory().numTensors);
}

runPipeline().catch(err => console.error('训练流水线异常:', err));
执行该脚本后,控制台的真实运行日志示例如下:
==============================================
   Node.js JavaScript 神经网络模型训练流水线
==============================================
[1/4] 开始模型拟合迭代...
Epoch [20/80] - Loss: 0.043128
Epoch [40/80] - Loss: 0.012491
Epoch [60/80] - Loss: 0.003814
Epoch [80/80] - Loss: 0.001625
[2/4] 模型成功导出至本地: /workspace/saved_model
[3/4] 执行样本推理验证...
输入特征: 面积=100㎡, 居室=2, 房龄=8年
预测售价: 382.46 万元
[4/4] 训练张量释放完毕,当前系统张量总数: 19
九、总结与生产级排错避坑清单
在 Node.js 环境下使用 JavaScript 进行神经网络训练,充分利用了 JavaScript 生态在数据处理与微服务体系中的胶水集成优势。在投入生产使用前,建议对照以下关键检查点逐一排查:
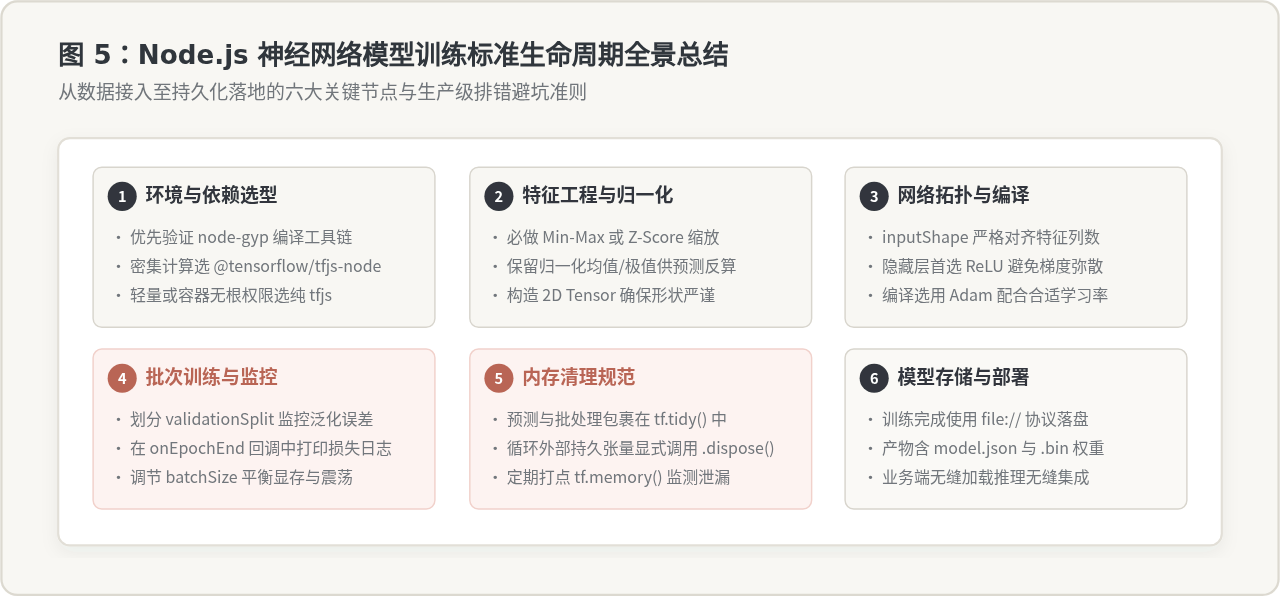
- 形状不匹配报错(Shape mismatch):排查第一层
inputShape是否与样本列数完全相等。切勿将样本数量传给inputShape,它只接收单个样本的特征形状。 - 损失输出为 NaN:通常由学习率过大或未做数据归一化引起。将未缩放的大数值送入网络会导致梯度爆炸。
- 服务长时间运行内存暴涨:检查推理调用是否遗漏了
tf.tidy(),或在长周期训练循环中是否有未调.dispose()的中间张量。 - 部署环境原生编译失败:若目标 Docker 容器内缺少构建工具链,可直接降级使用纯 JS 的
@tensorflow/tfjs,无需更改任何业务训练代码。
Node.js中使用fs模块读取本地文件的代码示例
2026-11-19 08:19:37
CVE-2026-123864 解决方案:Node.js HTTPS 重入内存泄露的原理、检测与代码级修复
2026-11-18 19:04:42
JS调用exe时处理路径空格与参数转义
2026-11-18 18:09:23
Go 后端升级 Google GenAI SDK 1.78.0 如何保留测试接口?
2026-11-18 13:31:29
JS读写文件出现中文乱码怎么办
2026-11-17 19:11:19