不依赖第三方库,怎么用 JS 原生代码导出 Excel 数据
介绍在不引入任何第三方依赖的前提下,如何使用纯原生 JavaScript 将前端数据导出为 Excel 可打开的文件。涵盖 CSV 编码转义、UTF-8 BOM 乱码处理、Blob 二进制下载以及 HTML 表格伪装方案。
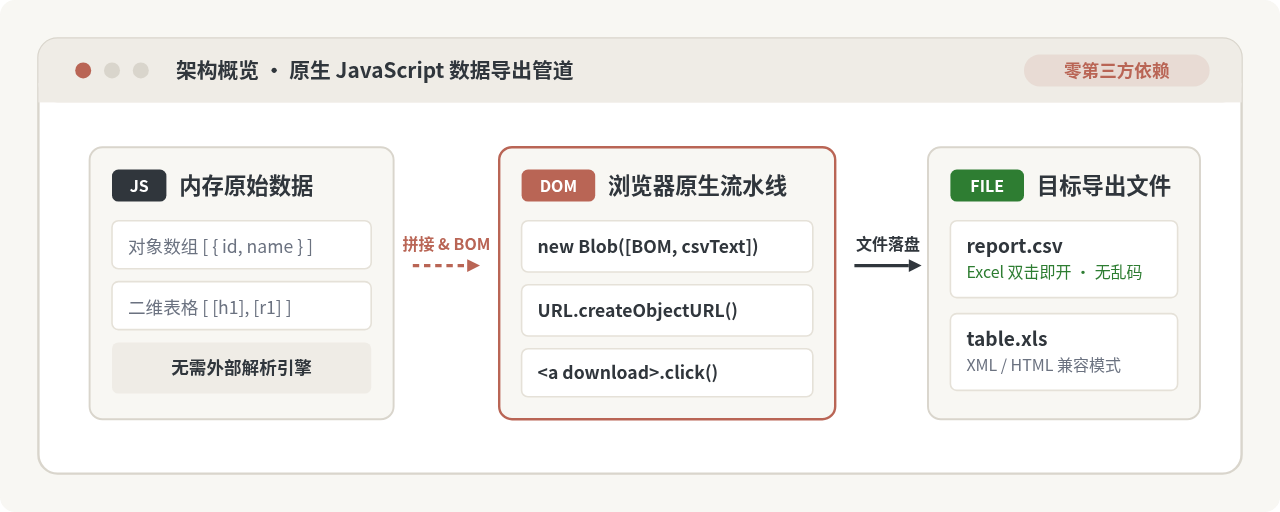
在前端导出常规表格数据时,引入像 SheetJS (xlsx) 或 ExcelJS 这样的第三方库虽功能完善,但其数十至数百 KB 的打包体积往往超出简单报表需求。如果不追求复杂的多级样式、宏或图表,仅利用原生 JavaScript 中的 Blob、URL.createObjectURL 以及带 UTF-8 BOM 标头的 CSV 文本,十几行原生代码就能稳定生成能被 Excel 直接识别并双击打开的表格文件,实现真正的零依赖与即时下载。
一、为什么 CSV 是原生导出的首选格式
在不借助任何二进制压缩与解析库的前提下,直接生成真正的 .xlsx 文件几乎不现实——因为 .xlsx 本质上是由多个 XML 文件组成的 ZIP 压缩包(Open Packaging Conventions 标准),纯原生 JS 手写 ZIP 打包算法既繁琐且性能开销过大。
而 CSV(Comma-Separated Values,逗号分隔值) 是一种纯文本格式,天生受到 Microsoft Excel、Apple Numbers、WPS 以及各类在线表格软件的完全兼容支持。只要满足标准的行和列分隔规范,Excel 会在用户双击 .csv 文件时自动将其还原成网格工作表。因此,原生导出 Excel 的本质,就是将前端的内存数据拼装为合规的 CSV 字符串,再借助浏览器底层的二进制下载接口落盘为文件。
二、原生导出 Excel 的完整四步执行流程
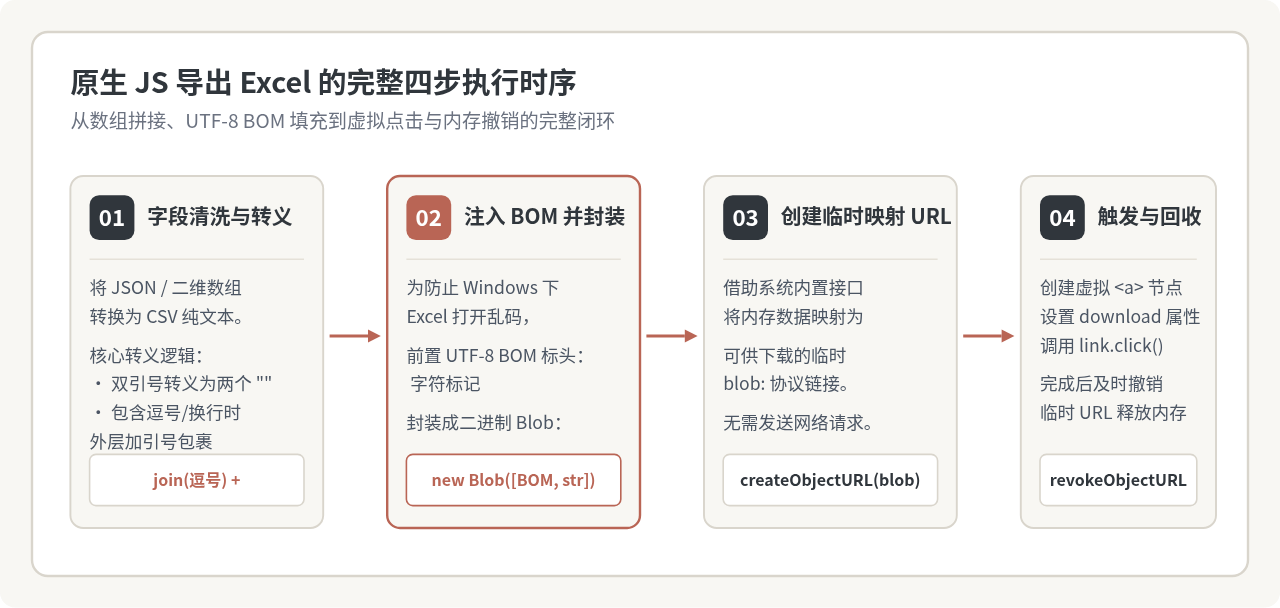
浏览器从内存中的 JavaScript 数组到生成可供用户保存的本地文件,分为四个连续且不可分割的关键步骤:
- 数据清洗与转义:遍历二维数组或对象集合,将每个单元格的内容进行合规检查,处理逗号、双引号和换行符,拼装为以换行符分隔的文本流;
- 注入 UTF-8 BOM 并构建 Blob:在文本最前面拼接字节顺序标记
,并使用浏览器原生Blob类包装为带有正确 MIME 类型的二进制对象; - 生成临时引用 URL:通过
URL.createObjectURL(blob)建立指向该内存区域的临时虚拟路径; - 挂载虚拟节点触发下载与销毁:创建隐藏的
<a>标签,设置download文件名后调用click()触发原生下载,并在短延时后调用URL.revokeObjectURL()释放内存句柄。
三、核心代码实现:标准 CSV 导出函数
以下提供一个可以直接复制并用于生产环境的纯原生导出函数。该函数支持二维数组输入,并严格遵循 RFC 4180 规定的 CSV 字段转义标准:
/**
 * 将二维数组导出为 Excel 可打开的 CSV 文件
 * @param {string} filename 导出文件名,如 "用户列表.csv"
 * @param {Array<string>} headers 表头数组
 * @param {Array<Array<any>>} rows 数据行二维数组
 */
function exportToCsv(filename, headers, rows) {
  // 1. 单个字段转义格式化:遵循 CSV 规范
  const formatCell = (value) => {
    if (value === null || value === undefined) {
      return '';
    }
    let str = String(value);

    // 如果包含双引号、逗号或换行符,需将内部双引号翻倍,并用外层双引号包裹
    if (/[",
]/.test(str)) {
      str = `"${str.replace(/"/g, '""')}"`;
    }
    return str;
  };

  // 2. 拼装 CSV 内容行
  const headerLine = headers.map(formatCell).join(',');
  const rowLines = rows.map(row => row.map(formatCell).join(','));
  const csvContent = [headerLine, ...rowLines].join('\r\n');

  // 3. 注入 UTF-8 BOM (\uFEFF) 防止 Excel 中文乱码,并创建 Blob
  const blob = new Blob(['\uFEFF' + csvContent], {
    type: 'text/csv;charset=utf-8;'
  });

  // 4. 通过虚拟 a 标签触发浏览器下载
  const url = URL.createObjectURL(blob);
  const link = document.createElement('a');
  link.href = url;
  link.setAttribute('download', filename.endsWith('.csv') ? filename : `${filename}.csv`);
  document.body.appendChild(link);
  link.click();

  // 5. 及时清理 DOM 节点与内存对象
  document.body.removeChild(link);
  setTimeout(() => {
    URL.revokeObjectURL(url);
  }, 100);
}
若业务数据是常见的对象数组格式 [{ name: '张三', age: 25 }, ...],只需在此函数前进行一次简单的数据解构转换即可调用:
// 对象数组调用示例
const dataList = [
  { id: '001', name: '李雷', phone: '13800000001', remark: ' VIP客户,需加急处理 ' },
  { id: '002', name: '韩梅梅', phone: '13800000002', remark: '普通用户\n地址待补齐' }
];

const headers = ['编号', '姓名', '联系电话', '备注说明'];
const rows = dataList.map(item => [
  item.id,
  item.name,
  `\t${item.phone}`, // 前置制表符,避免长数字被转为科学计数法
  item.remark
]);

exportToCsv('客户档案汇总.csv', headers, rows);
四、核心原理攻坚:解决 Excel 打开中文乱码
很多开发者初次尝试纯原生导出 CSV 时,经常会遇到一个典型现象:在 VS Code 或记事本中打开导出的文件中文完全正常,但一用 Microsoft Excel 双击打开,所有中文字段全部变成无意义的乱码符号(如 姓å )。
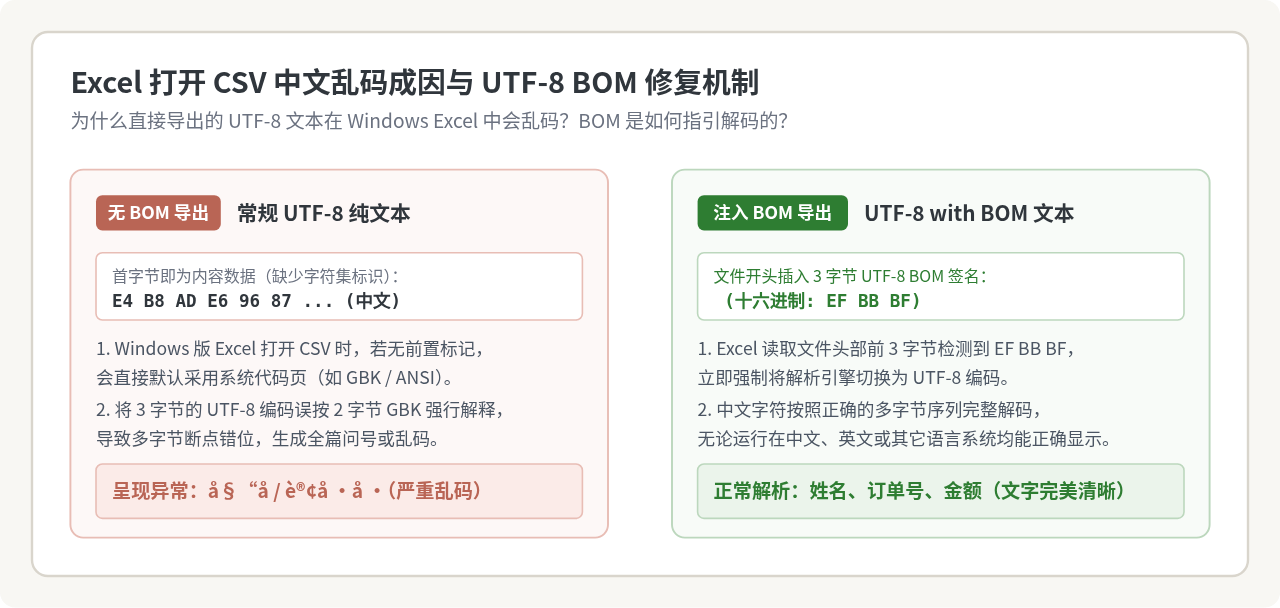
根本原因在于 Excel 的历史兼容机制:
- 在 Windows 操作系统中,Excel 双击打开文本文件(包括
.csv)时,如果文件开头没有特征签名,Excel 不会 默认将其当作 UTF-8 解析,而是强制采用当前操作系统的区域 ANSI 代码页(在中国大陆简体中文版 Windows 下即为GBK / CP936)。 - UTF-8 编码的汉字通常占用 3 个字节(如“中”字为
0xE4 0xB8 0xAD),而 GBK 采用 2 字节编码。Excel 用双字节规则强行拆分三字节序列,就会发生错位,最终输出不可读的乱码。
原生代码的破解之道:在构建 Blob 时,于字符串最前部显式追加 (即 Unicode 的 Zero-Width No-Break Space,在 UTF-8 下编码为十六进制 0xEF 0xBB 0xBF,称为 Byte Order Mark,即 BOM)。当 Excel 读到这 3 个特征字节后,便会识别出该文件为 UTF-8 编码,自动调用 UTF-8 引擎进行解码,中文乱码问题迎刃而解。
五、备选方案:导出带简单样式的 HTML / XML 表格
如果业务上确实需要导出带有背景色、字体加粗、居中对齐或单元格合并的报表,CSV 格式因其纯文本本质无法承担这类排版属性。此时可以采用第二种原生策略:HTML Table 伪装法。
Excel 从很早的版本起就支持直接打开 HTML 格式的 <table> 文件。只要我们在前端拼接出常规的 HTML 表格字符串,并为其指定 Excel 专属的 MIME 类型 application/vnd.ms-excel,保存为 .xls 后缀,Excel 便能将其当作表格解析并还原内联的样式与合并格。
/**
 * 导出支持单元格样式与合并的 HTML 表格为 .xls 文件
 */
function exportStyledHtmlTable(filename, tableHtml) {
  const template = `
    <html xmlns:o="urn:schemas-microsoft-com:office:office"
          xmlns:x="urn:schemas-microsoft-com:office:excel"
          xmlns="http://www.w3.org/TR/REC-html40">
      <head>
        <meta http-equiv="content-type" content="text/html; charset=UTF-8">
        <!--[if gte mso 9]>
        <xml>
          <x:ExcelWorkbook>
            <x:ExcelWorksheets>
              <x:ExcelWorksheet>
                <x:Name>Sheet1</x:Name>
                <x:WorksheetOptions><x:DisplayGridlines/></x:WorksheetOptions>
              </x:ExcelWorksheet>
            </x:ExcelWorksheets>
          </x:ExcelWorkbook>
        </xml>
        <![endif]-->
      </head>
      <body>
        ${tableHtml}
      </body>
    </html>
  `;

  const blob = new Blob([template], {
    type: 'application/vnd.ms-excel;charset=utf-8'
  });

  const url = URL.createObjectURL(blob);
  const link = document.createElement('a');
  link.href = url;
  link.download = filename.endsWith('.xls') ? filename : `${filename}.xls`;
  link.click();
  setTimeout(() => URL.revokeObjectURL(url), 100);
}
由于 .xls 实际上存储的是 HTML 文本而非二进制 BIFF8 结构,在高版本 Microsoft Office(Excel 2010 及之后)中双击打开时,会弹出一个黄色警告对话框:“您尝试打开的文件 'xxx.xls' 的格式与文件扩展名指定的格式不一致。打开文件前请验证文件没有损坏且来源可信。是否立即打开该文件?”。虽然点击“是”即可正常展示样式,但该提示会降低对外部普通用户的专业信任度。因此,此方案适合内部运营系统或特定管理后台,面向外部用户时仍首选无警告的 CSV 方案。
六、方案对比与选型决策指南
前端生成 Excel 数据的不同方案在体积消耗、样式支持和兼容性上存在明显分野。合理评估业务所处的发展阶段,是保持项目代码清爽高效的关键。
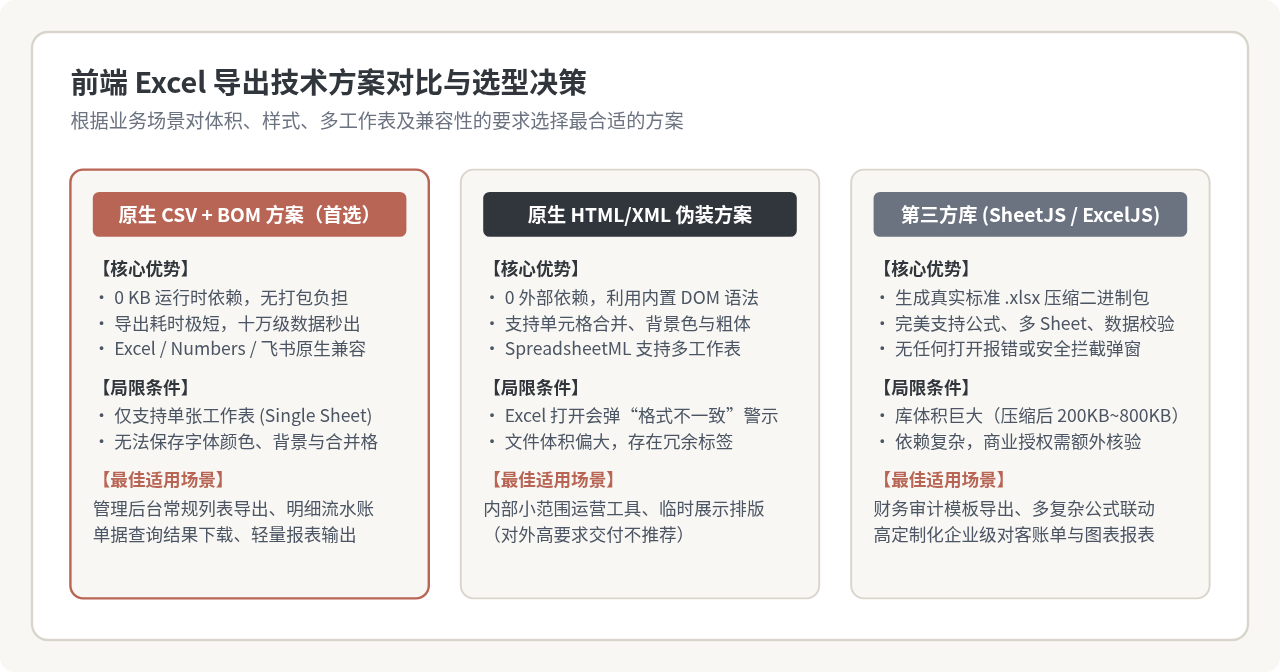
| 评估维度 | 原生 CSV + BOM 方案(推荐) | 原生 HTML/XML 方案 | 第三方库(SheetJS / ExcelJS) |
|---|---|---|---|
| 运行时体积 | 0 KB(纯原生代码) | 0 KB(纯原生代码) | 200 KB ~ 800 KB+ |
| 生成性能 | 极快,简单字符串拼接即可 | 较快,包含 DOM 标签拼接 | 较慢,需内存构建复杂 ZIP 目录树 |
| 样式与合并格 | 不支持(纯二维文本) | 支持 CSS 基础样式与 colspan | 完全支持所有高级样式与富文本 |
| 多工作表 (Sheet) | 不支持 | 支持(需配置 SpreadsheetML) | 完全支持多 Sheet 管理与联动 |
| 打开体验 | 无警告直接秒开 | 部分 Excel 版本有格式不符弹窗 | 标准 .xlsx 无任何警告弹窗 |
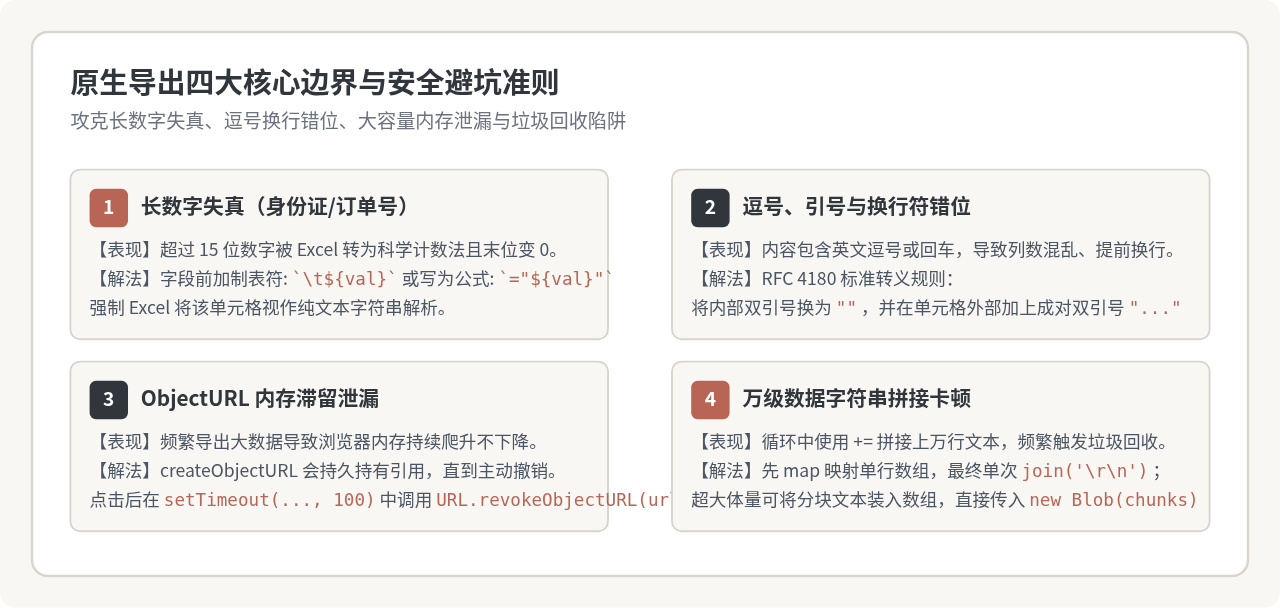
七、原生导出的四大核心避坑准则
在实际生产环境中,业务数据的复杂程度远超简单的数字与英文。为确保导出的表格能够被 Excel 稳定无误地呈现,必须注意以下四个技术边界:
1. 避免 18 位身份证与超长订单号丢失末位精度
Excel 会自动将连续超过 11 位的纯数字格式化为科学计数法(如 1.23457E+17),更严重的是,Excel 内部数字精度遵循 IEEE 754 双精度浮点标准,有效数字仅有 15 位。凡是超过 15 位的整数(如 18 位身份证号码、微信支付单号),后三位会被强行替换为 000,造成不可逆的数据失真。
解决方案有两种:
- 推荐做法(追加制表符):在长数字文本前方追加一个制表符
` ${idCard}`。Excel 读取到制表符后,会无条件将该单元格视作纯文本(Text)存储,既不破坏视觉显示,也能完整保留 18 位数字; - 公式包裹法:写为
`="${idCard}"`,让 Excel 将其视作返回字符串常量的公式处理。
2. 正确转义字段内的英文逗号、双引号与换行
CSV 依靠逗号分列、换行符分行。如果某个地址或备注字段本身包含了半角逗号 ,,未转义的直接输出会导致该行数据发生严重的列错位。遵循 RFC 4180 标准,当字段中含有 ,、"、 或
时,必须用成对双引号包裹整个字段;若字段内部已有双引号,必须替换为两个连续双引号("")进行转义。
3. 严格防范 URL.createObjectURL 造成的内存泄漏
每次调用 URL.createObjectURL(blob),浏览器都会在内部维持对该 Blob 数据的强引用,即使对应的 <a> 标签被销毁,这块内存也不会被垃圾回收机制释放。如果在管理后台中用户多次触发导出、或单次导出了几万条流水记录,容易导致标签页内存占用持续飙升。
最佳实践:在触发 link.click() 后,利用 setTimeout(() => URL.revokeObjectURL(url), 100) 将对象 URL 撤销。设置 100 毫秒的小延时,既确保了浏览器已经成功捕获下载流,又及时断开了内存引用。
4. 万级数据量下的字符串拼接与 GC 优化
在导出 5 万行以上的数据时,千万不要在循环体中直接使用 content += row.join(',')。频繁创建中间临时字符串会导致 V8 引擎频繁执行垃圾回收(GC),造成页面瞬时卡死。
优化策略:先使用数组收集每行的格式化文本,最后单次调用 rows.join('\r\n');更进一步,如果数据体量超过数十兆,可将按批处理好的多段子字符串装入数组,直接传入 new Blob([BOM, ...stringChunks]),利用 Blob 原生对分块数组的高效打包能力,避免生成巨型单一字符串。
八、结语
纯原生 JavaScript 导出 Excel 并非妥协之选,而是在权衡了应用体积、构建成本和运行性能后的务实方案。只要掌握了 CSV 的转义规范、UTF-8 BOM 标头的乱码消除机制以及长文本字段的保真技巧,无需背负数百 KB 的外部依赖包,十几行代码就能满足绝大多数前端日常业务的表格导出需求。
兼容旧浏览器的JS URL参数截取方案
2026-11-19 21:37:39
JS中location.reload、history.go与window.location.href的区别
2026-11-19 20:05:44
JS怎么获取鼠标滚轮的滚动方向与距离
2026-11-19 14:49:25
原生JavaScript实现滑动验证码:Canvas绘图与拖拽逻辑详解
2026-11-19 13:35:44
为什么JS设置的cursor样式不生效?常见原因排查
2026-11-19 11:20:41