

JS中parseInt、parseFloat与正则提取数字的区别
深入对比JavaScript中parseInt、parseFloat与正则表达式在数字提取中的核心工作机制、扫描路径、小数与科学计数法支持、进制处理及边界陷阱,提供实用的技术选型决策指导与完整代码示例。
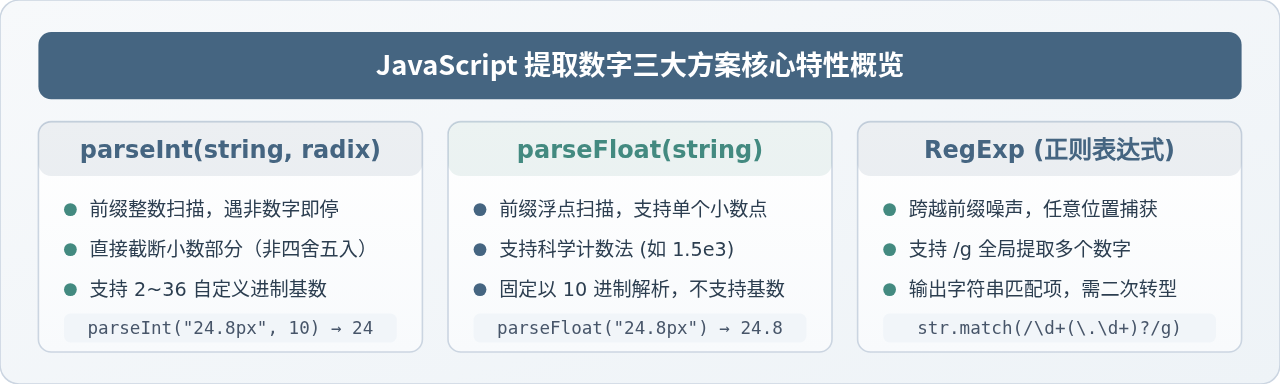
parseInt、parseFloat 以及正则表达式(RegExp)。它们虽然都能“将文本转为数字”,但工作机理截然不同:parseInt 与 parseFloat 是前缀扫描器,必须从字符串首字符(忽略前导空白)开始解析,遇到首个非数字字符即刻停止,无法提取深埋于文本中间的数字;而正则表达式基于模式匹配,能穿透任意前缀与环绕噪声,在任意位置甚至全文范围内批量提取符合要求的整数、浮点数或特定格式数字。
一、parseInt:从左至右的整数扫描器
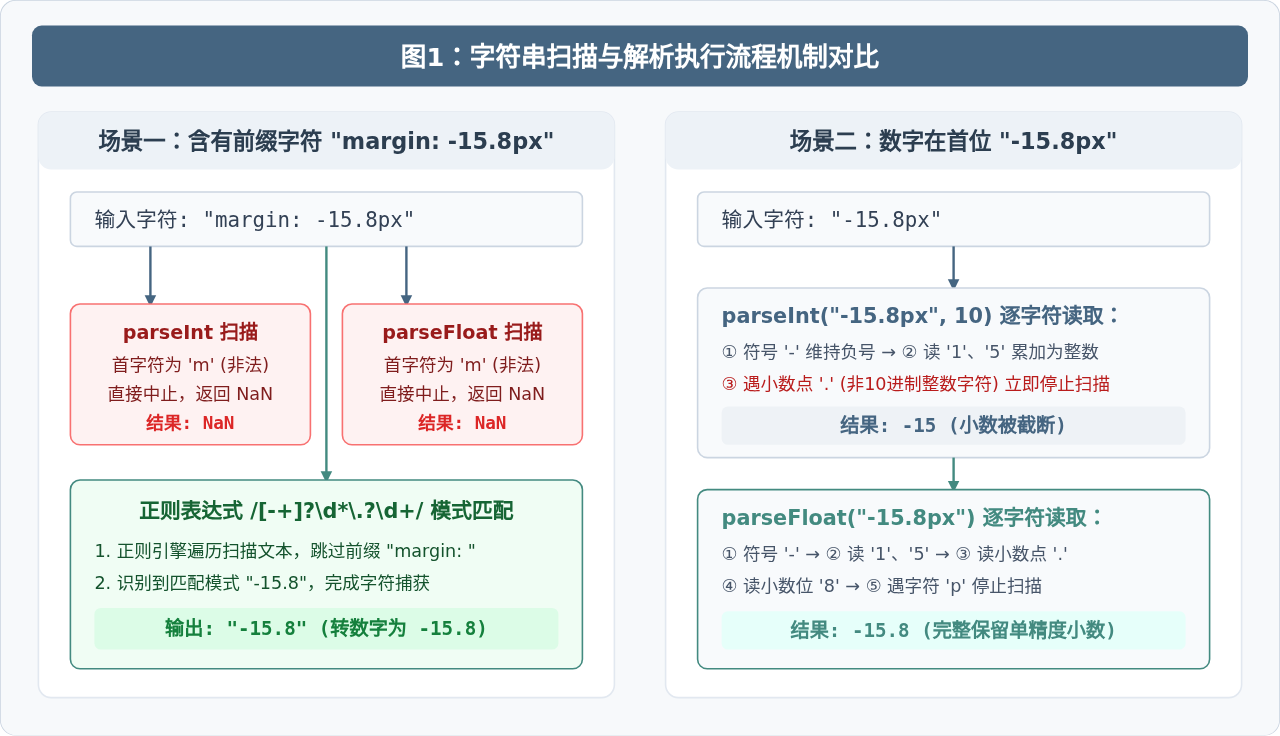
parseInt(string, radix) 的定位是将传入的字符串按照指定进制基数(radix)解析为十进制整数。它的内部执行步骤如下:
- 跳过前导空白:自动忽略字符串最左侧的空格、换行或制表符。
- 识别正负号:如果第一个非空白字符是正号
+或负号-,予以保留。 - 逐字符验证基数:依据第二个参数
radix(范围为 2 到 36)逐字符验证。一旦遇到不符合该进制的字符(包括小数点.),立即截断并停止扫描。 - 返回结果:将已识别的有效数字序列计算为十进制整数并返回;若首个非空白字符非有效数字,则返回
NaN。
// 示例 1:parseInt 典型解析行为
const result1 = parseInt("42px", 10);      // 示例输出: 42 (遇 'p' 停止)
const result2 = parseInt("  -128元", 10);  // 示例输出: -128 (忽略前置空白与保留负号)
const result3 = parseInt("3.84rem", 10);   // 示例输出: 3 (遇 '.' 立即停止,向零截断)
const result4 = parseInt("宽: 100px", 10); // 示例输出: NaN (首字符'宽'非合法数字)虽然 ES5 以后规范要求省略
radix 时默认按 10 进制解析,但如果字符串以 0x 或 0X 开头,仍会被默认按十六进制解析。为了消除歧义与历史引擎的八进制兼容风险,在任何工程代码中都必须书写 parseInt(str, 10)。
二、parseFloat:面向单精度与科学计数的浮点扫描器
parseFloat(string) 专门用来将字符串解析为十进制浮点数。与 parseInt 相比,它的关键机制区别在于:
- 支持单个小数点:扫描过程中允许遇到第一个小数点
.并继续读取后续的小数部分;遇到第二个小数点时停止。 - 支持科学计数法指数:能够原生识别字符
e或E及其后跟随的正负整数指数,例如"3.14e2"会被直接解析为314。 - 固定十进制:
parseFloat不接受第二个基数参数,始终以十进制规则进行解析。如果输入字符串是"0x10",它在遇到非十进制字符'x'时停止,输出为0而非16。 - 同样具备前缀依赖性:若字符串开头存在货币符号(如
"¥99.9")或英文前缀,同样直接返回NaN。
// 示例 2:parseFloat 典型解析行为
const float1 = parseFloat("19.99元");     // 示例输出: 19.99 (保留小数位,遇'元'终止)
const float2 = parseFloat("12.3.4");      // 示例输出: 12.3 (遇第二个小数点终止)
const float3 = parseFloat("2.5e3");       // 示例输出: 2500 (原生解析科学计数法)
const float4 = parseFloat("$19.99");      // 示例输出: NaN (首字符'$'导致解析失败)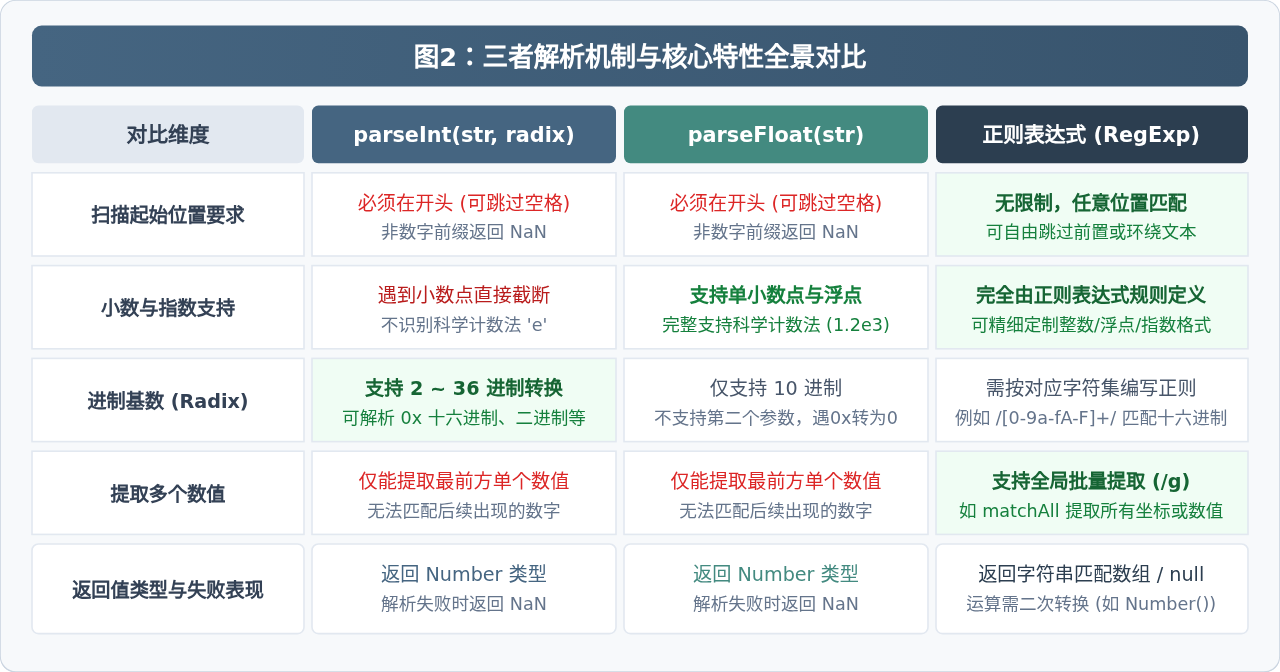
三、正则表达式:灵活无拘的模式匹配提取
当目标数字处于字符串中间、被各种标点或汉字包裹,或者一段文本中存在多个需要提取的数值时,parseInt 与 parseFloat 完全无能为力。此时,正则表达式(RegExp)是唯一可靠且灵活的武器。
1. 常用提取数字的正则表达式范式
- 提取正整数:
/\d+/g(匹配连续的阿拉伯数字)。 - 提取包含正负号的整数:
/[-+]?\d+/g。 - 提取正负浮点数:
/[-+]?\d*\.?\d+/g(支持-12.5、.75等格式)。 - 完整浮点与科学计数法匹配:
/[-+]?\d+(?:\.\d+)?(?:[eE][-+]?\d+)?/g。
2. 核心差异:返回值类型与二次转换
parseInt 和 parseFloat 返回的是原生 Number 类型值(或 NaN),可以直接参与算术运算。而正则表达式的 match() 或 matchAll() 返回的是匹配到的字符串结果数组。在进行数学运算前,必须显式调用 Number() 进行转换。
// 示例 3:正则表达式从混合复杂文本中精准提取数字
const rawText = "商品单价: ¥129.50元,运费: -10元,件数: 3件";

// 提取全部数字(包含符号和小数点)
const pattern = /[-+]?\d+(?:\.\d+)?/g;
const matchedStrings = rawText.match(pattern);
// 示例输出: ["129.50", "-10", "3"] (得到字符串数组)

// 二次转型为实际数值以便后续数学计算
const numbers = matchedStrings ? matchedStrings.map(Number) : [];
// 示例输出: [129.5, -10, 3] (变为原生数值)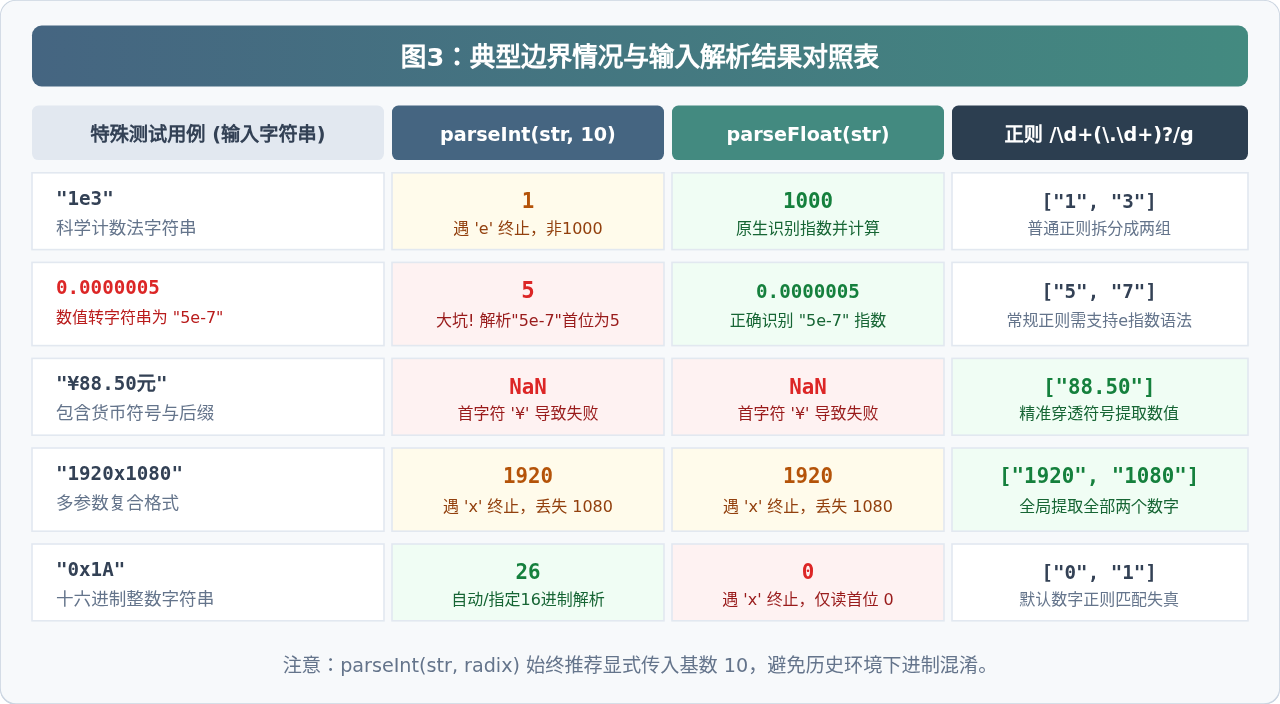
四、经典边界陷阱与高频考点剖析
在前端开发与面试场景中,以下几个边界特例经常让开发者产生误判:
1. 科学计数法中的截断陷阱
对于字符串 "1e3":
parseInt("1e3", 10):输出为1。因为在 10 进制扫描模式下,字符'e'不是合法数字,扫描在此立即截断终止。parseFloat("1e3"):输出为1000。它能识别e为指数符号,进而完成运算。
2. 极小数值转字符串时的隐藏暗礁
当对小于 10^-6 的极小浮点数执行 parseInt(0.0000005) 时,预期往往是 0,但其实际输出结果却是 5!
原因解释:parseInt 接收的第一个参数必须是字符串。如果传入的是数字,引擎会隐式调用 String(0.0000005),而 JavaScript 将其格式化为科学计数法字符串 "5e-7"。随后 parseInt("5e-7", 10) 从头扫描,读到 5 遇到 'e' 停止,最终输出 5。而 parseFloat(0.0000005) 保持 0.0000005。
3. 提取多个数字的截断
对于类似 "1920x1080" 的分辨率文本,parseInt 和 parseFloat 均在读取到字母 'x' 时停止,只能返回 1920,后续的 1080 被永久丢弃。必须使用 "1920x1080".match(/\d+/g) 才能完整拿到包含两项的数组。
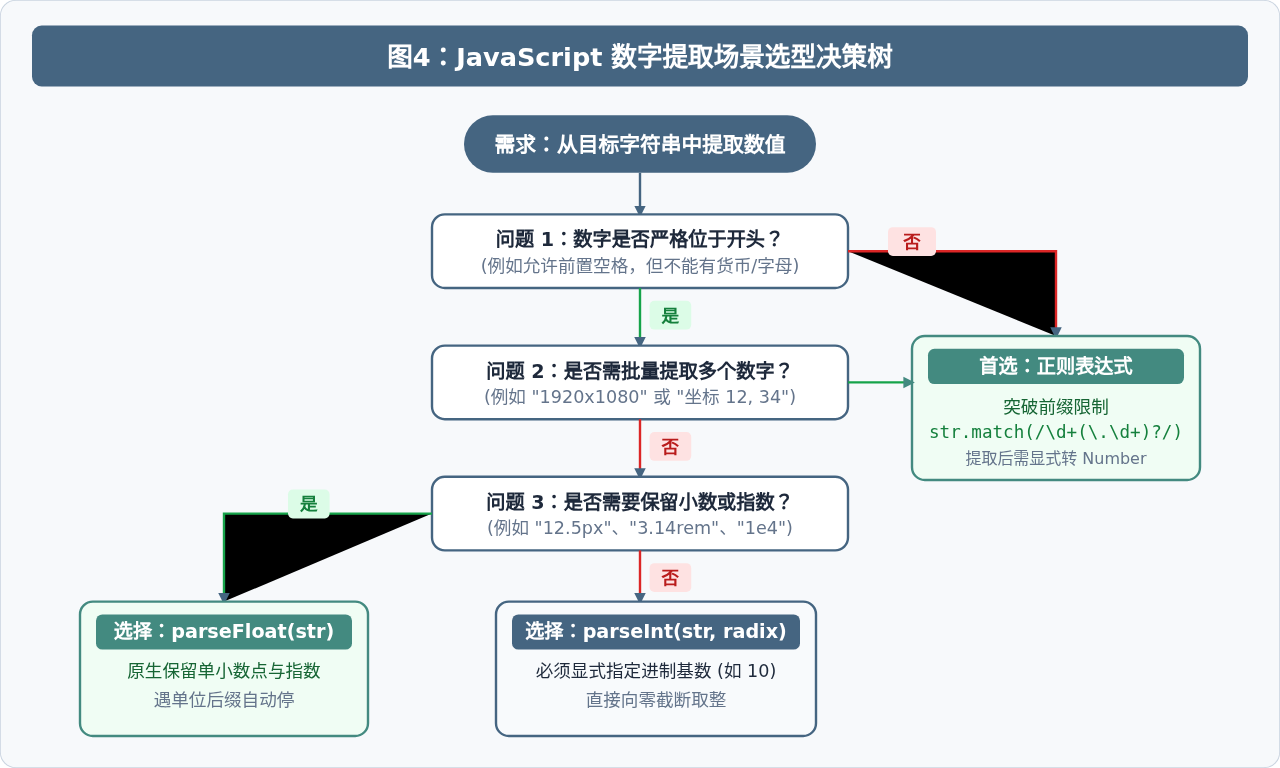
五、实战选型对比与开发建议
为了帮助大家在日常业务中快速准确地做出选择,我们将三者的关键特征横向对比如下:
| 对比特征 | parseInt(str, radix) | parseFloat(str) | 正则表达式 (RegExp) |
|---|---|---|---|
| 扫描起始位置 | 严格要求位于首部(允许前置空格) | 严格要求位于首部(允许前置空格) | 无限制,支持全文本任意位置提取 |
| 小数处理 | 遇到 . 即刻截断舍弃 |
完整保留单小数点的小数部分 | 由正则表达式模式规则自定义 |
| 科学计数法 | 不支持,遇 e/E 终止 |
原生支持并计算实际值 | 需编写支持 [eE] 的正则规则 |
| 进制基数支持 | 支持 2~36 进制(显式指定) | 仅支持 10 进制 | 需定义对应字符集模式 |
| 多数值提取 | 不支持,仅取首个有效段 | 不支持,仅取首个有效段 | 支持,通过 /g 标志批量捕获 |
| 返回值类型 | Number(或 NaN) |
Number(或 NaN) |
Array<string>(需手动转 Number) |
业务场景最佳实践总结
- 解析标准 CSS 像素/尺寸属性:若已知单位紧跟数字且只需整数(如
"32px"),首选parseInt(val, 10);若涉及小数单位(如"1.25rem"、"50.5%"),首选parseFloat(val)。 - 处理带有前缀或混合符号的文本:如货币价格(
"$99.9"、"¥180.00")、日志信息("error code: 404"),严禁直接使用parseInt/parseFloat,必须使用正则表达式匹配后转换为数字。 - 严谨的完整格式校验:如果业务目标是校验“整个字符串是否严格为一个合法数字”(不允许包含
"px"等杂质后缀),三者均不适合作为首选校验工具,应当结合Number(str)配合!isNaN(),或采用严格正则/^[-+]?\d+(\.\d+)?$/进行校验。
JS怎么在控制台打印信息:console.log基础用法与查看
2026-11-19 19:42:47
JS获取星期几:原生Date与day.js写法对比
2026-11-18 22:33:03
JS实现GBK与UTF-8中文编码转换的方法
2026-11-18 14:30:22
cloud-trace-querying 1.0.3 为什么要明确项目和时间范围?
2026-11-18 08:39:16
OpenAI Agents SDK Python 0.25.0 会回滚失败交接的副作用吗?
2026-11-18 08:38:20







