

JS实现GBK与UTF-8中文编码转换的方法
详细讲解在现代浏览器与 Node.js 环境下使用 JavaScript 实现 GBK 与 UTF-8 编码互转的具体方法,剖析底层字节结构、原生 Encoding API 限制与 iconv-lite、BOM 头等实践方案。
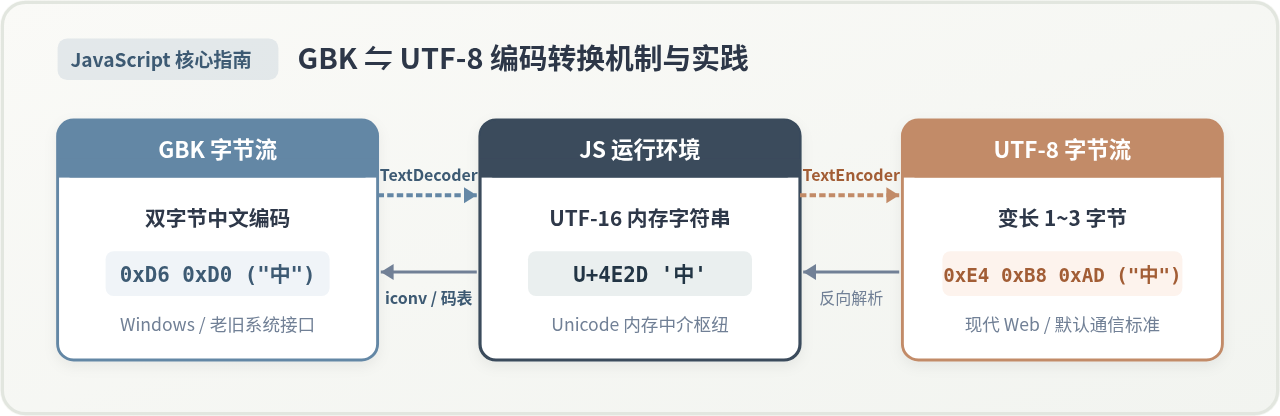
一、字符编码底层结构与转换本质
在编写任何转换代码前,需要明确一个基本判断:JavaScript 变量中不存在所谓“GBK 编码的字符串”。无论一段文本原本来源于 GBK 文件还是 UTF-8 接口,只要它被解析成 JavaScript 的原生 string 类型,其在内存中的每一个字符都已经转换为标准的 Unicode 码位。因此,转换的起点与终点必然存在二进制数据的参与。
以常用汉字“中”(Unicode 码点为 U+4E2D)为例,其在不同编码下的字节组织截然不同:
- GBK 编码:固定占用 2 个字节。高位字节为
0xD6(十进制 214,二进制11010110),低位字节为0xD0(十进制 208,二进制11010000)。GBK 依靠高位字节的最高位(bit 7 为 1,取值区间0x81~0xFE)来识别当前字节为汉字引导字,并向后读取一个字节组成完整汉字。 - UTF-8 编码:中文通常占用 3 个字节。汉字“中”被编码为
0xE4 0xB8 0xAD。UTF-8 属于变长前缀编码,首字节前缀1110xxxx标识该字符由 3 字节构成,后续每个字节均以10xxxxxx开头,拥有极其严格的校验机制。
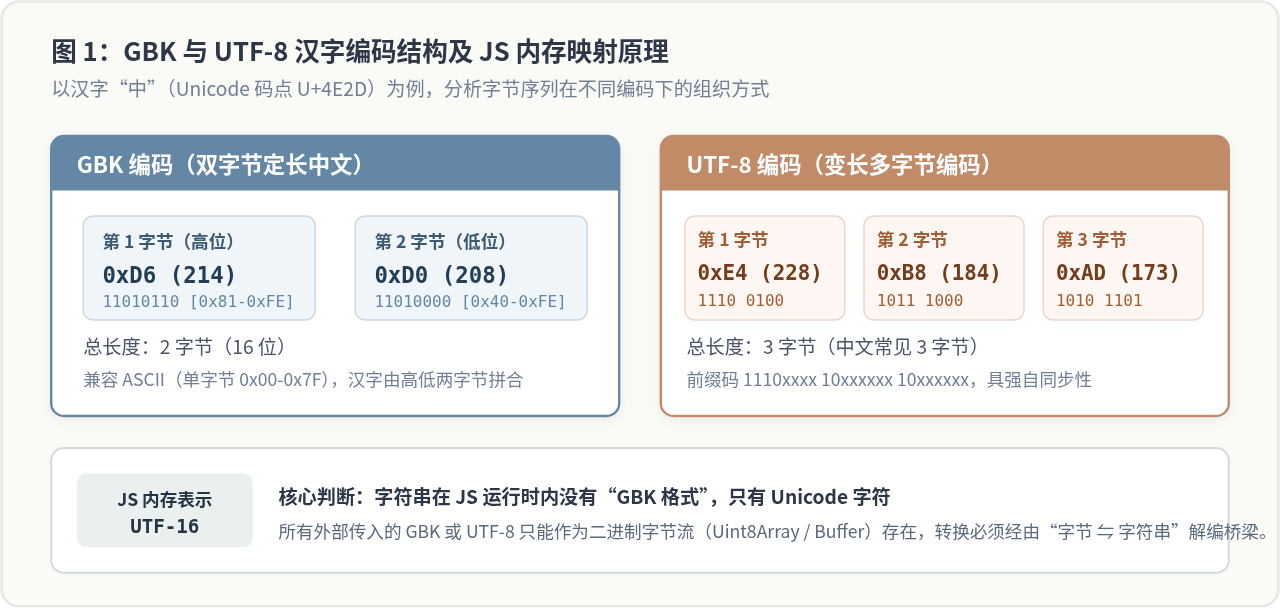
当外部传入未标明编码的字节流,若错误地以 UTF-8 方式去逐字节匹配 GBK 的双字节序列,由于前缀位无法通过 UTF-8 校验,解码器便会将无效字节标记为替换字符 �;反之,若用 GBK 解析 UTF-8,也会因 3 字节无法按双字节配对而产生乱码。解决这一问题的关键,在于正确声明源编码,将字节解码为内存字符串,再按目标编码输出。
二、GBK 二进制流转 UTF-8:原生 TextDecoder 标准实现
GBK 二进制流转 UTF-8 是最普遍的需求,例如读取用户本地上传的 Windows ANSI 格式 CSV 文件,或对接尚未改造的政府与金融系统接口。
在现代浏览器与 Node.js 11+ 环境中,官方标准 Encoding API(TextDecoder)已经原生内置了对 GBK 及其超集 GB18030 的解码能力,无需引入任何第三方 npm 依赖即可直接运行。
1. ArrayBuffer / Uint8Array 转 UTF-8 文本与字节流
当已经拿到 GBK 字节数组时,只需传入 'gbk'(或 'gb18030')初始化解码器,即可还原为正常的 JavaScript 字符串。若业务要求继续输出 UTF-8 二进制字节,则调用 TextEncoder 进行包装:
// 1. 假设收到代表“中文测试”的 GBK 二进制数据(Uint8Array)
// "中"(D6 D0) "文"(CE C4) "测"(B2 E2) "试"(CA D4)
const gbkBytes = new Uint8Array([0xD6, 0xD0, 0xCE, 0xC4, 0xB2, 0xE2, 0xCA, 0xD4]);

// 2. 实例化原生 TextDecoder,明确指定解码格式为 'gbk'
const gbkDecoder = new TextDecoder('gbk');

// 3. 执行解码,输出 JavaScript 内部 Unicode 字符串
const decodedText = gbkDecoder.decode(gbkBytes);
console.log('解码文本:', decodedText); // 输出: "中文测试"

// 4. 若需得到标准的 UTF-8 二进制字节流,使用 TextEncoder 重编码
const utf8Encoder = new TextEncoder(); // TextEncoder 规范默认且仅支持 utf-8
const utf8Bytes = utf8Encoder.encode(decodedText);
console.log('UTF-8 字节长度:', utf8Bytes.length); // 4个汉字占用 12 字节
2. 前端 FileReader 读取本地 GBK 文件
在网页端处理用户选择的 <input type="file"> 文件或 Blob 对象时,传统的 FileReader 也支持传入编码参数:
function readGbkBlob(fileBlob) {
  return new Promise((resolve, reject) => {
    const reader = new FileReader();
    reader.onload = () => resolve(reader.result);
    reader.onerror = () => reject(reader.error);
    // 第二个参数指定以 gbk 字符集解析文件内容
    reader.readAsText(fileBlob, 'gbk');
  });
}

// 使用示例:
// const text = await readGbkBlob(fileInput.files[0]);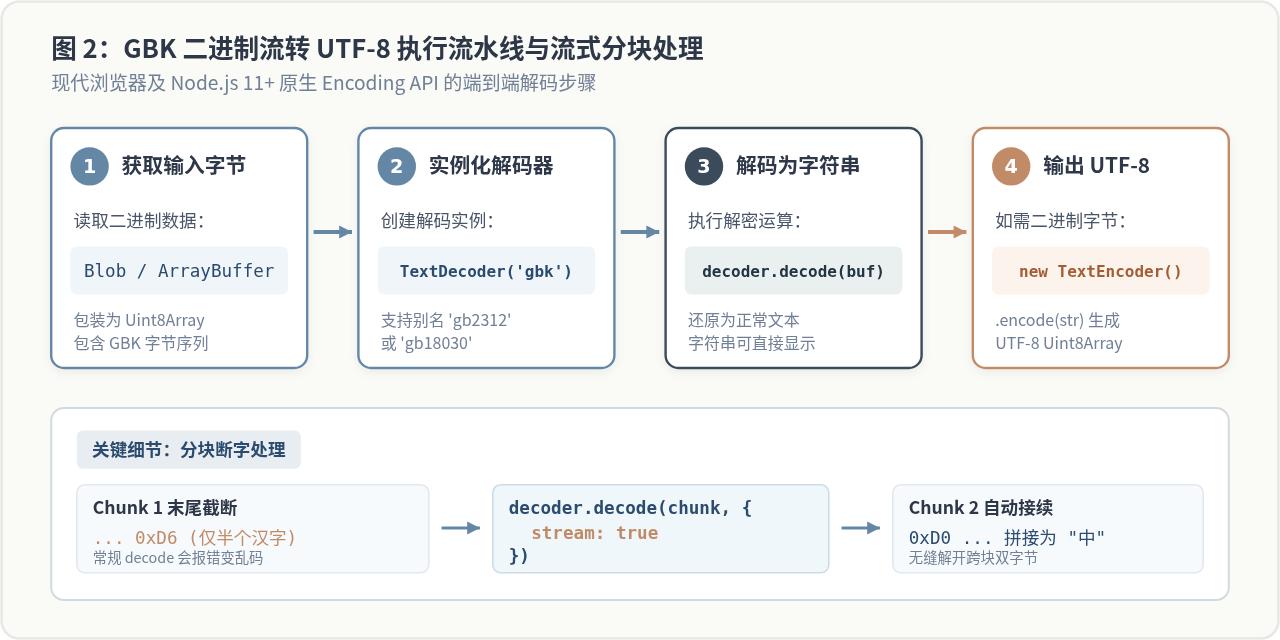
在处理大型文件或通过 Fetch / ReadableStream 接收数据块(Chunk)时,由于网络切片大小是任意的,一个 GBK 汉字的高位字节(如 0xD6)很可能落在当前分块末尾,而低位字节(0xD0)落在下一分块开头。
如果直接对每个分块分别执行 decoder.decode(chunk),当前分块末尾的单个字节会因不完整而产生替换字符乱码。
正确的做法是在每个中间分块调用时传递配置项:decoder.decode(chunk, { stream: true })。此时解码器会自动将末尾不完整的字节保留在内部缓冲区中,与后续分块开头拼合后再行解码;仅在最后一个分块传递 decoder.decode(lastChunk, { stream: false }) 即可。
三、UTF-8 转 GBK:突破原生限制的两种落地路径
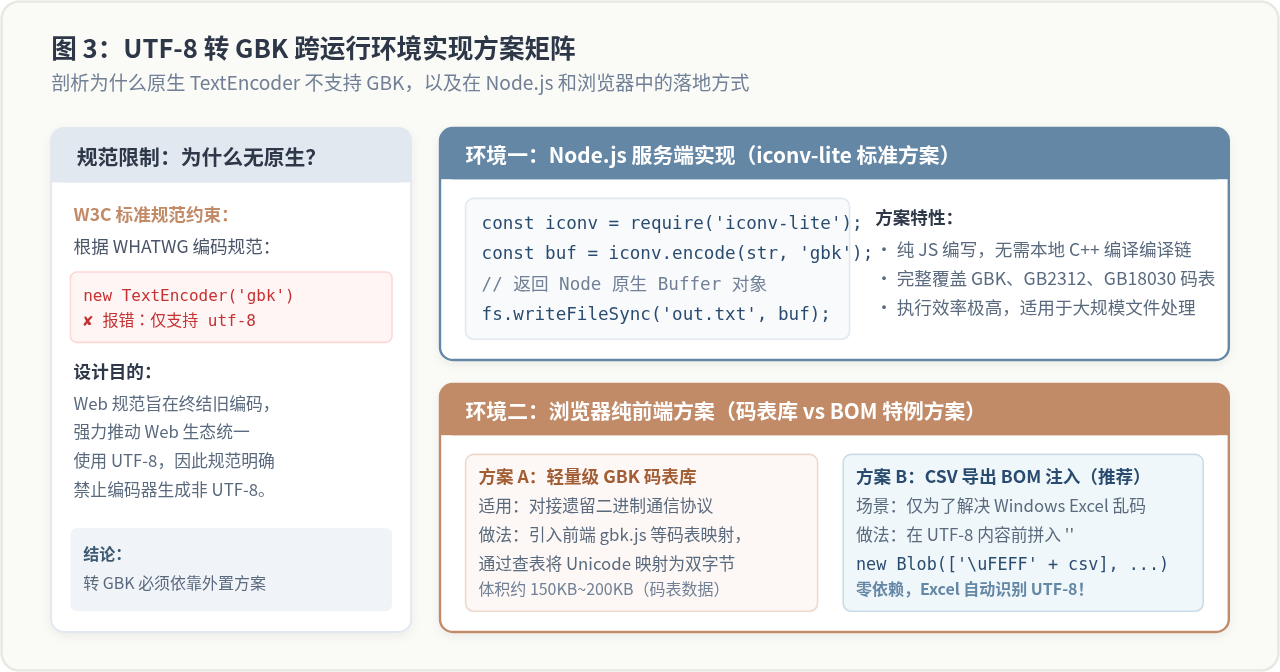
当业务需要向外部系统输出 GBK 数据时,许多开发者会下意识尝试编写 new TextEncoder('gbk'),但这会直接抛出异常。
这是 WHATWG 标准规范的刻意设计:规范制定者为了加速 Web 生态向 UTF-8 统一,明确规定 TextEncoder 的构造函数只能接受 utf-8 作为编码参数,禁止原生编码器生成除 UTF-8 以外的任何编码。因此,将 UTF-8 或 JavaScript 字符串编码为 GBK 二进制,必须采用外置方案。
1. Node.js 服务端方案:使用 iconv-lite
在 Node.js 服务端,iconv-lite 是处理多编码转换的标准库。它采用纯 JavaScript 编写,无需本地 C++ 编译器(如 node-gyp),执行性能经过深度优化,且完整支持 GBK、GB2312、GB18030、Big5 等全套中文编码。
// 需先执行: npm install iconv-lite
const iconv = require('iconv-lite');
const fs = require('fs');

const originalText = '需要导出为GBK编码的中文内容';

// 1. 将 JavaScript 字符串编码为 GBK Buffer
const gbkBuffer = iconv.encode(originalText, 'gbk');
console.log('GBK Buffer 字节长度:', gbkBuffer.length);

// 2. 写入文件(例如生成供 Windows 软件识别的文本数据)
fs.writeFileSync('output_gbk.txt', gbkBuffer);

// 3. 反向验证:将该 Buffer 重新按 GBK 解码
const restoredText = iconv.decode(gbkBuffer, 'gbk');
console.log('验证还原结果:', restoredText === originalText); // true
2. 浏览器纯前端方案:码表映射 vs BOM 规避
在浏览器前端,若需要将字符串转换为真正的 GBK 二进制字节,通常需要引入打包好的轻量级 GBK 码表模块(例如单文件码表转换脚本,通过 Unicode 码点到 GBK 双字节的查表逻辑映射):
// 浏览器纯前端将字符串转换为 GBK 字节流的通用逻辑示意
function encodeStringToGbkUint8Array(str, gbkLookupTable) {
  const bytes = [];
  for (let i = 0; i < str.length; i++) {
    const charCode = str.charCodeAt(i);
    if (charCode <= 0x7F) {
      // ASCII 单字节直接写入
      bytes.push(charCode);
    } else {
      // 查表取得对应 GBK 双字节 (0x8140 ~ 0xFEFE)
      const gbkCode = gbkLookupTable[charCode];
      if (gbkCode !== undefined) {
        bytes.push((gbkCode >> 8) & 0xFF); // 高位字节
        bytes.push(gbkCode & 0xFF);        // 低位字节
      } else {
        // 未收录字符回退为问号字符 '?' (0x3F)
        bytes.push(0x3F);
      }
    }
  }
  return new Uint8Array(bytes);
}
3. 常见业务场景特例:导出 CSV 防止 Windows Excel 乱码
在实际前端业务中,超过 80% 的“转 GBK”需求仅仅是为了解决导出的 CSV 文件在 Windows Excel 中双击打开显示为乱码。
Windows Excel 在默认打开 CSV 时,若文件没有字节序标记,会盲目按照当前系统的 ANSI 区域设置(中文版 Windows 即 GBK)进行解析,从而将 UTF-8 误判为乱码。针对这一特定场景,完全不需要将文本转码为 GBK,只需在生成的 UTF-8 文件首部拼入一个 (UTF-8 BOM 头,对应十六进制字节 0xEF 0xBB 0xBF):
// 前端导出 CSV 避免 Excel 中文乱码的最佳实践(零依赖)
function exportCsvWithoutGbk(filename, csvContent) {
  // 在 UTF-8 字符串最前端添加 Byte Order Mark (\uFEFF)
  // Windows Excel 识别到 BOM 后会自动使用 UTF-8 引擎渲染,完美支持中文
  const bomPrefix = '\uFEFF';
  const blob = new Blob([bomPrefix + csvContent], {
    type: 'text/csv;charset=utf-8;'
  });

  const downloadUrl = URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = downloadUrl;
  anchor.download = filename;
  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);
  URL.revokeObjectURL(downloadUrl);
}

// 调用示例:
// exportCsvWithoutGbk('用户列表.csv', '姓名,工号,部门\n张三,1001,技术部\n李四,1002,财务部');
四、技术选型决策与常见故障排查
不同场景下的实现成本差异巨大。为了避免在无需转码的场景下引入沉重的码表依赖,可按照以下导图梳理决策逻辑:
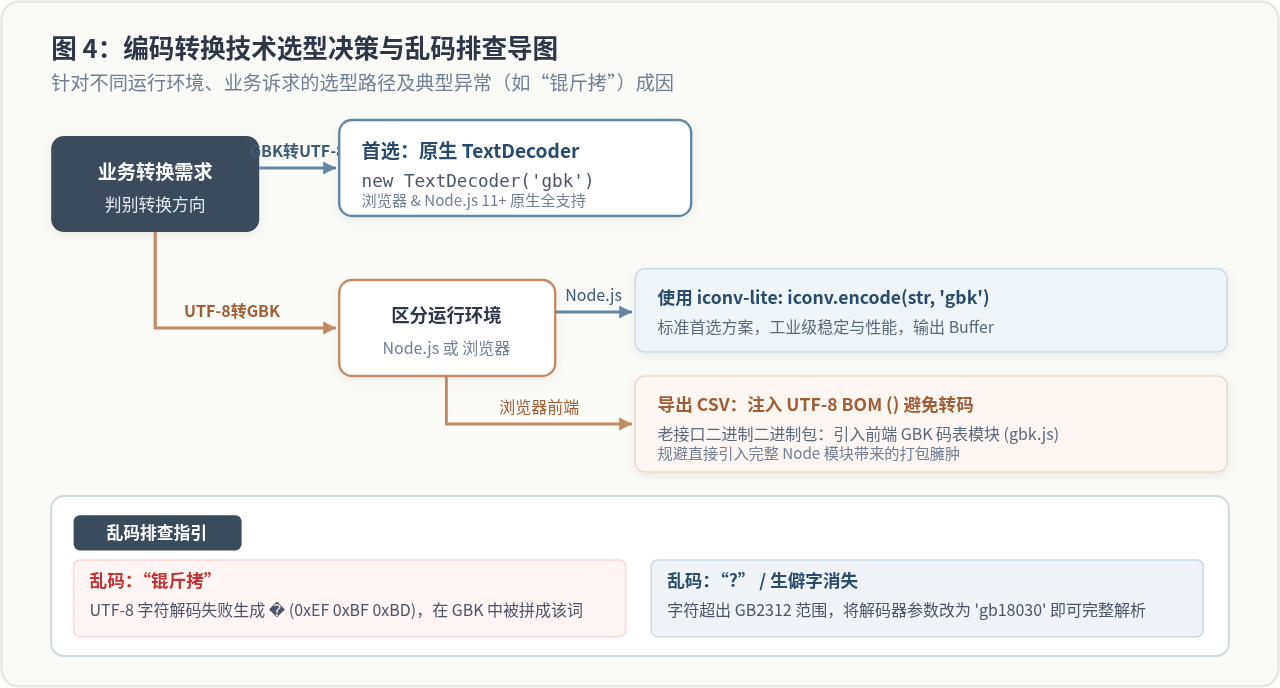
常见乱码现象排查
-
现象一:出现大面积连续的“锟斤拷”
这是多系统流转中最具代表性的特征乱码。其成因是源数据原本为 UTF-8 字符串,但在第一道转换时被错误当作 GBK 解码;当遇到无法配对的非法字节时,解码系统将这些字节替换成了 Unicode 专用替代字符�。当这段数据随后再次被转回 UTF-8 时,一个�变成了0xEF 0xBF 0xBD;两个连续的�连成0xEF 0xBF 0xBD 0xEF 0xBF 0xBD。最后,当这串字节又被用 GBK 编码方式打开时,每两个字节一组:0xEFBF在 GBK 码表中对应“锟”,0xBDEF对应“斤”,后续再拼出“拷”。排查要点:只要看到“锟斤拷”,说明数据在源头或中途已经经历了一次将 UTF-8 错当 GBK 解码的不可逆损坏,必须在最开始读取字节流的位置纠正TextDecoder('gbk')的逻辑。 -
现象二:常用汉字正常,生僻字或人名地名显示为“?”或方框
GB2312 编码标准仅收录了 6763 个常用汉字。如果系统在解码时使用了严格的'gb2312'参数,遇到生僻字(如“玥”、“堃”、“燚”)或少数民族文字时便会因码位缺失而退化为问号。排查要点:在实例化TextDecoder时,优先指定'gb18030'。GB18030 是中国国家强制标准,完全向后兼容 GBK 和 GB2312,同时覆盖了数十万个汉字及少数民族文字,能彻底杜绝生僻字解码丢失问题。
cloud-trace-querying 1.0.3 为什么要明确项目和时间范围?
2026-11-18 08:39:16
OpenAI Agents SDK Python 0.25.0 会回滚失败交接的副作用吗?
2026-11-18 08:38:20
Ducter v0.0.71、v0.0.72 怎样处理停止借用后的消息与外部待办?
2026-11-18 00:14:59
Claude Trading Skills 的 VCP 综合排名为何排除有价格缺口的候选?
2026-11-17 22:21:15
Qwen Code v0.28.0 的无界面工具批次怎样经过审批?
2026-11-17 20:07:39







