JS传统for循环遍历数组:索引访问与基础写法
深入详解 JavaScript 传统 for 循环遍历数组的底层机制、三要素结构、索引访问规则、正反向遍历模式与常见越界避坑指南。
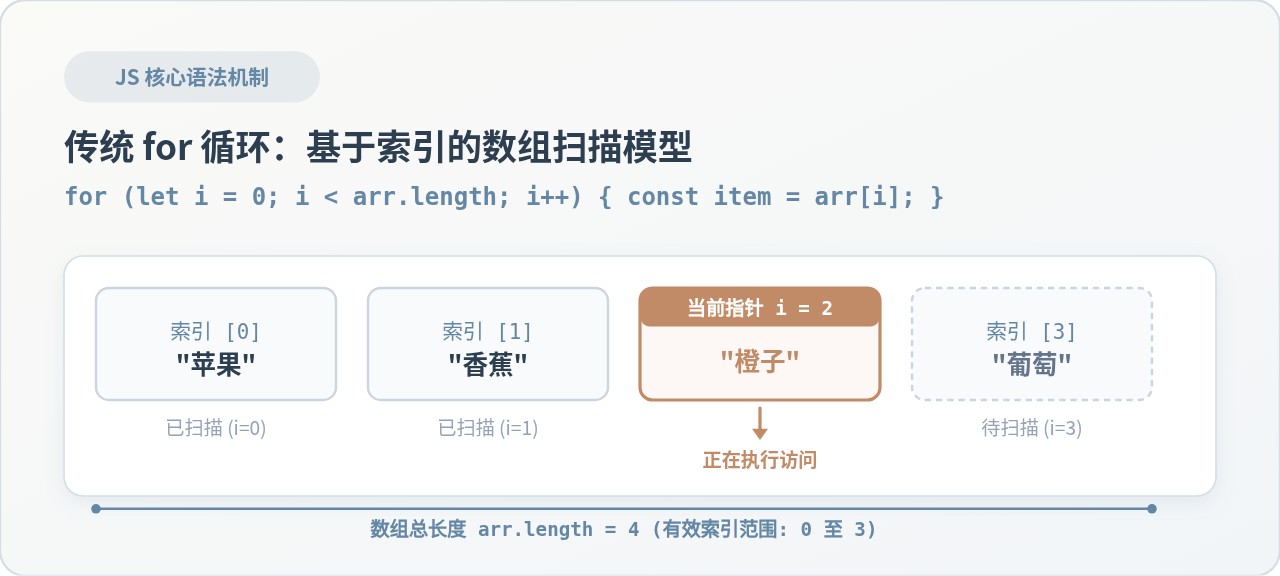
for 循环是最直观、最受底层掌控的数组遍历方式。它通过维护一个数值计数器(通常命名为 i),直接充当数组元素的索引下标,从 0 依次递增至 arr.length - 1。这种基于索引的显式访问机制,不仅赋予开发者精确的读写修改权限,还支持随时使用 break、continue 或自定义步长调整遍历轨迹。本文将全面拆解传统 for 循环的三要素结构、索引访问机理、实用变体与关键边界陷阱。
一、传统 for 循环的三要素结构与执行顺序
传统 for 循环的标准语法由圆括号内的三个分号分隔的控制表达式,以及其后包裹的花括号循环体组成:
for (let i = 0; i < arr.length; i++) {
  // 循环体:在此处执行单次遍历的操作
  console.log(arr[i]);
}
初学者常把这行语句看作一个整体,但要精确控制它,必须拆解这三个核心部分各自的职能与运行时机:
- 初始化表达式(
let i = 0):在整个循环正式开始前执行,且仅执行一次。这里定义了循环计数器i,并将初始值设定为0(因为 JS 数组的起始索引为 0)。强烈建议使用let声明,以限定其作用域在当前for循环内部。 - 条件判断表达式(
i < arr.length):在每次进入循环体之前都会进行求值判定。只要该表达式返回true,程序就会进入并执行循环体;一旦表达式求值为false,循环立即终止,直接跳往花括号之后的代码。 - 递增/更新表达式(
i++):在每次循环体代码执行完毕后才被调用。它的任务是将计数器i自增 1(相当于i = i + 1),随后程序自动返回第二步重新判定条件表达式。
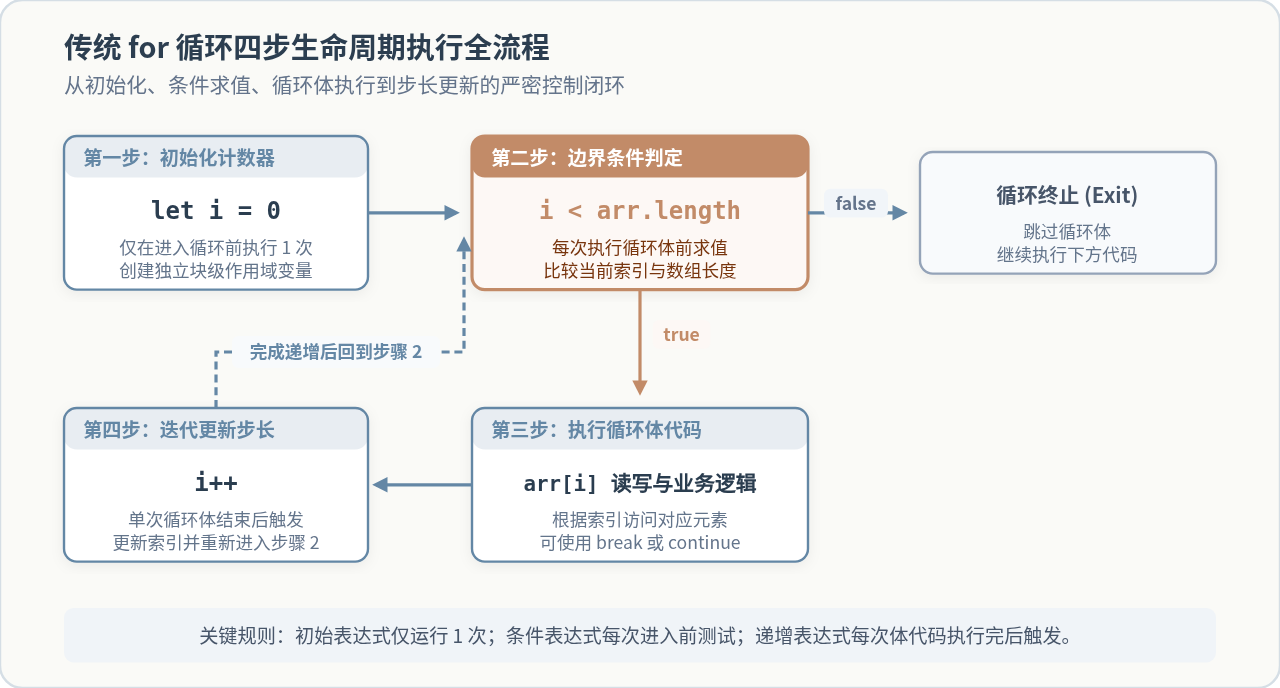
理解这一执行顺序至关重要:条件判断永远先于循环体执行,而步长递增永远后于循环体执行。如果数组本身没有任何元素(即 arr.length === 0),首次条件判定 0 < 0 即为 false,循环体一次都不会执行,天然具备防止空遍历的安全性。
二、基于索引访问数组元素的读写机制
在 JavaScript 中,数组本质上是特殊的对象,其属性键名是连续的非负整数字符串(在日常书写中表现为数值索引)。我们通过方括号语法 arr[i] 来读写对应槽位的值。
1. 读取元素与获取当前索引
在很多实际开发场景中,业务不仅需要获取数组中的每个元素,还需要知道该元素处于第几项(例如为列表项生成序号、表格行索引)。传统 for 循环无需额外定义计数变量,i 变量本身即是准确的索引值:
const fruits = ["苹果", "香蕉", "橙子", "葡萄"];

for (let i = 0; i < fruits.length; i++) {
  const item = fruits[i];
  console.log(`第 ${i + 1} 项(索引 ${i}):${item}`);
}
2. 就地修改数组元素(原地更新)
高阶遍历函数如 forEach 或 map 往往需要遵循函数式纯函数规范,而传统 for 循环允许开发者直接对原数组下标进行赋值赋值操作(arr[i] = newValue),避免了额外分配新数组的内存开销:
const prices = [10, 20, 30, 40];

// 原地为每个商品价格增加 10% 服务费
for (let i = 0; i < prices.length; i++) {
  prices[i] = prices[i] * 1.1;
}
console.log(prices); // 输出: [11, 22, 33, 44]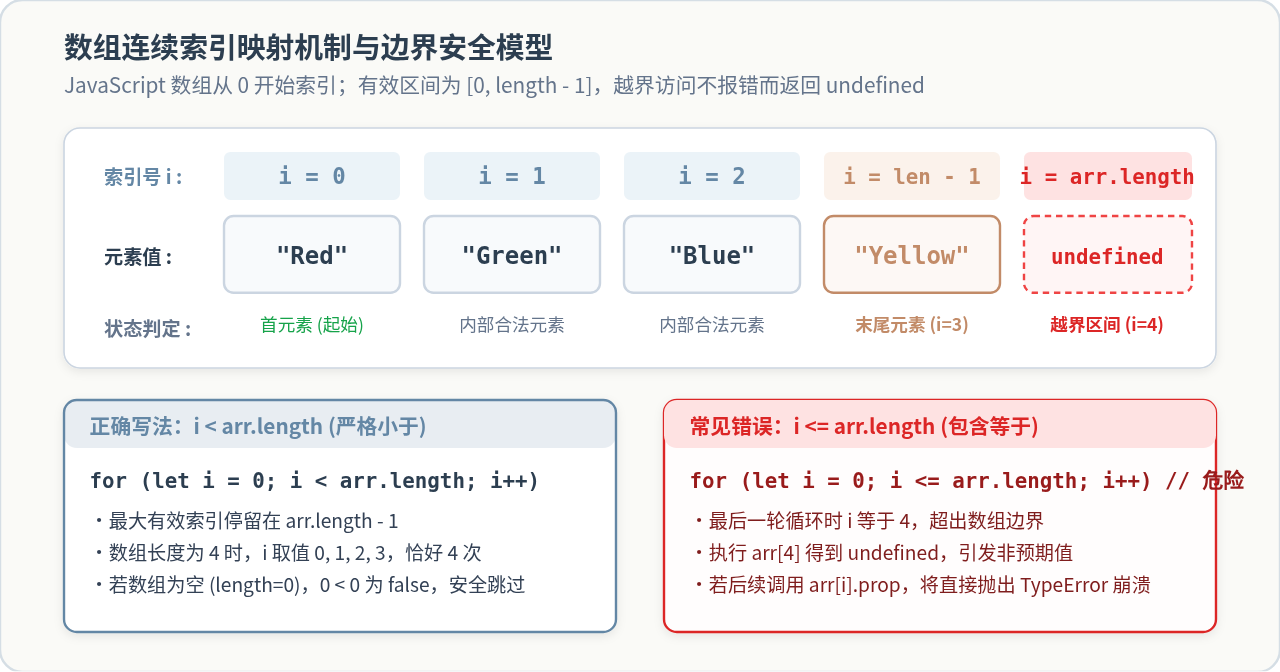
0 开始编号。如果一个数组包含 4 个元素,那么这 4 个元素的索引分别为 0, 1, 2, 3。此时 arr.length 等于 4。如果错误地将条件写为
i <= arr.length,在第 5 次循环时,i 的值将变成 4。此时访问 arr[4] 超出了数组边界,JavaScript 引擎不会直接抛出异常,而是静默返回 undefined。如果你的后续业务直接调用了 arr[i].toString(),程序就会抛出致命的 TypeError: Cannot read properties of undefined。因此,正向遍历必须严格使用小于号 <。
三、常见遍历模式与流程控制实用技巧
传统 for 循环之所以历久弥新,是因为计数器与流程控制语句具有高度可塑性。下面列举四种最常用的实战写法。
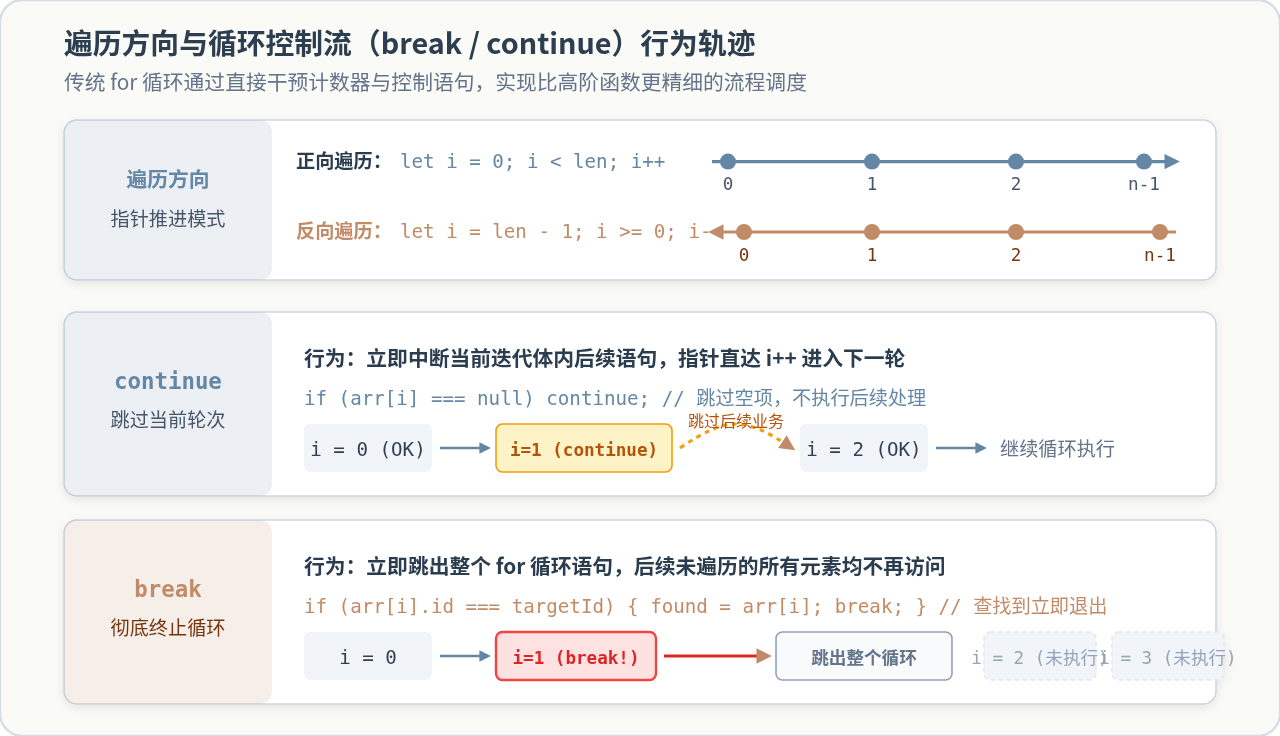
1. 反向逆序遍历(从尾到头)
当需要逆向处理数据(例如倒叙渲染时间线、从后向前过滤特定项)时,传统 for 循环只需调整三要素,即可直接实现高效的倒叙遍历,而无需使用 arr.reverse() 破坏原数组:
const list = ["A", "B", "C", "D"];

// 起点是最后一个元素的索引 list.length - 1,终点是 0
for (let i = list.length - 1; i >= 0; i--) {
  console.log(list[i]);
}
// 依次输出: "D", "C", "B", "A"
2. 自定义步长(跳跃遍历)
更新表达式不仅能写 i++,还可以写 i += 2、i += 3 等任意算术表达式。例如在处理成对的坐标数据或只提取偶数位元素时非常实用:
const points = [10, 20, 30, 40, 50, 60];

// 步长为 2:只访问偶数索引 0, 2, 4
for (let i = 0; i < points.length; i += 2) {
  const x = points[i];
  const y = points[i + 1];
  console.log(`坐标点: (${x}, ${y})`);
}
3. 中断与跳过:break 与 continue
在很多遍历方法(例如 Array.prototype.forEach)中,无法通过任何常规手段提前终止循环。而在传统 for 循环中,我们可以利用 break 和 continue 达成细粒度的流程控制:
const users = [
  { id: 101, name: "张三", active: true },
  { id: 102, name: "李四", active: false }, // 非活跃用户
  { id: 103, name: "王五", active: true },
  { id: 104, name: "赵六", active: true }
];

for (let i = 0; i < users.length; i++) {
  // 遇到非活跃用户:使用 continue 跳过当前轮次,不打印,直接进入下一个用户
  if (!users[i].active) {
    continue;
  }

  console.log(`处理活跃用户: ${users[i].name}`);

  // 当找到目标用户王五时:使用 break 立即终止整个循环,后续用户不再被扫描
  if (users[i].id === 103) {
    console.log("已找到目标,立即停止循环");
    break;
  }
}
4. 缓存数组长度的写法与现代引擎分析
在很多旧版教程或性能优化规范中,你可能会见到如下写法:
// 缓存 length 到局部变量 len
for (let i = 0, len = arr.length; i < len; i++) {
  // 循环体
}
这种写法的原理是:早期 JavaScript 引擎在每次条件判定时都会重新访问 arr.length 属性。将长度缓存在 len 变量中,可以减少属性寻址时间。
现代开发考量:在当下的现代 V8 或 JavaScriptCore 等 JIT 引擎中,对于普通静态数组,引擎会自动优化属性读取,两者的性能差距微乎其微。但在遍历动态 DOM 节点集合(如 document.getElementsByTagName 返回的实时 HTMLCollection)时,缓存 length 依旧非常关键,因为每次读取实时集合的 length 都会触发 DOM 树的重新计算。
四、避坑指南:必须掌握的边界与作用域陷阱
1. 变量声明必须使用 let,警惕 var 的作用域污染
在 ES6 之前,循环变量使用 var i = 0 声明。因为 var 不具备块级作用域(只有函数作用域或全局作用域),在循环执行完毕后,变量 i 会泄漏到外部作用域中。
更严重的隐患出现在异步回调或闭包场景中:
// 错误示范:使用 var 在异步操作中产生闭包穿透 bug
for (var i = 0; i < 3; i++) {
  setTimeout(function() {
    console.log(i); // 3 次输出全部都是 3!而不是 0, 1, 2
  }, 100);
}

// 正确做法:使用 let 产生每次迭代专属的块级作用域
for (let i = 0; i < 3; i++) {
  setTimeout(function() {
    console.log(i); // 正确按序输出 0, 1, 2
  }, 100);
}
当使用 let 时,JavaScript 引擎会为每一次循环迭代单独创建一个词法作用域,确保每次循环体中的异步回调都能捕获当前独立的 i 值。
2. 在遍历过程中直接增删元素(避免索引错位)
如果你在正向遍历数组的同时,使用 splice(i, 1) 删除了某个元素,那么原数组中的后续所有元素都会向前平移一位。由于下一步 i++ 仍会正常递增,这会导致紧邻被删元素后面的那一项被无辜跳过:
const nums = [1, 2, 2, 3];

// 需求:删除所有等于 2 的数字
// 错误写法:直接正向删除
for (let i = 0; i < nums.length; i++) {
  if (nums[i] === 2) {
    nums.splice(i, 1); // 删除了第一个 2,后续元素前移
  }
}
console.log(nums); // 结果为 [1, 2, 3],第二个 2 被漏掉了!
解决策略:
- 方案 A(补正索引):在
splice删除元素后,紧接着执行i--抵消掉下一次的递增。 - 方案 B(反向遍历,推荐):从数组末尾向前遍历(
let i = arr.length - 1; i >= 0; i--)。由于删除操作只影响后方的元素,不会影响前方待处理元素的索引位置,因此天然安全。
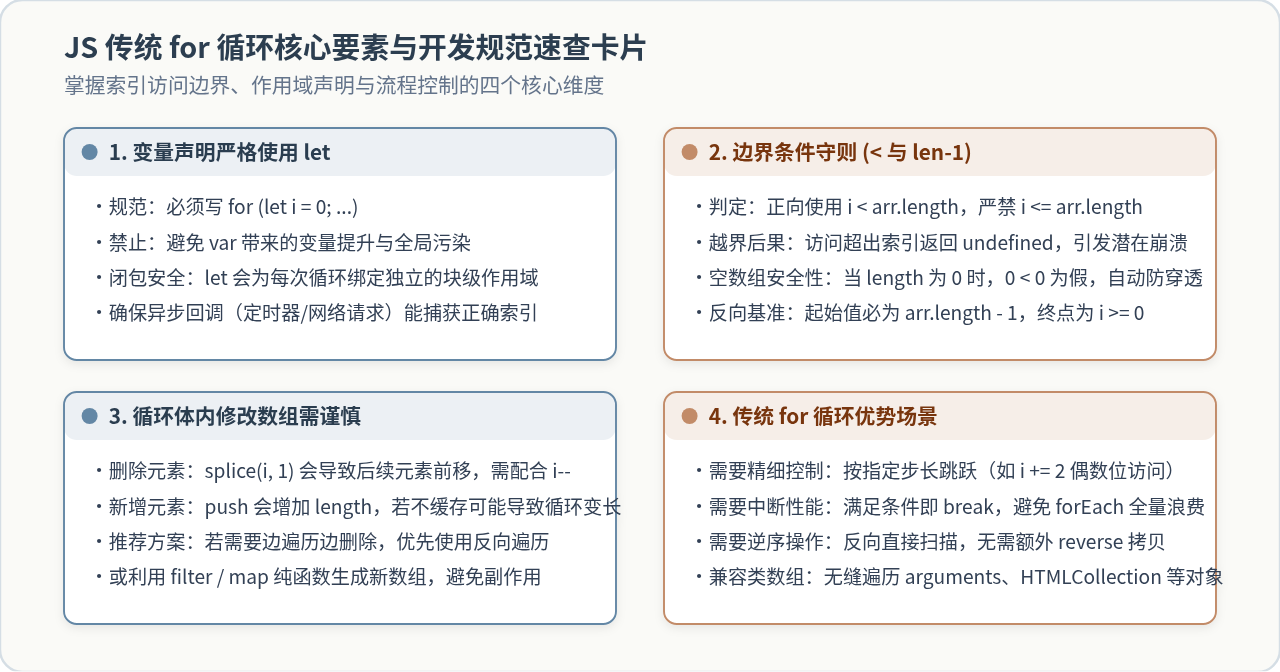
五、知识要点速查与最佳实践总结
虽然现代 JavaScript 提供了丰富的遍历语法(如 for...of、forEach、map、filter),但传统 for 循环依然是所有机制中最底层、性能损耗最小、掌控力最强的一种方式。
| 遍历方式 | 能否提前中断 (break) | 是否直接具备数值索引 | 支持反向/步长定制 | 最适场景 |
|---|---|---|---|---|
| 传统 for 循环 | 支持 | 直接提供 (i) | 完全自由定制 | 需要精细索引、逆序遍历、提前跳出或性能极致的算法处理 |
| for...of 循环 | 支持 | 需搭配 entries() |
仅支持正向 | 简单纯净地获取数组元素值 |
| forEach 回调 | 不支持 | 通过参数提供 | 仅支持正向 | 简单的日常只读遍历,代码书写短小整洁 |
掌握传统 for 循环的核心在于建立清晰的“索引指针模型”:熟记起始点为 0,终止判定严格为 < arr.length,声明使用 let 固化作用域,并在涉及元素修改时格外注意指针与长度的动态关系。只要遵循这些基础规范,就能写出结构严密、运行高效且不易出 bug 的数组遍历代码。
前端开发必备:5类高频使用的JavaScript辅助库
2026-11-19 21:33:37
解析JavaScript汉诺塔算法的时间与空间复杂度
2026-11-19 20:28:23
JavaScript数组随机排序:Fisher-Yates洗牌算法实现
2026-11-19 20:20:54
JavaScript WeakMap实现私有变量的原理与最佳实践
2026-11-19 19:09:15
JSON.parse(stringify)深拷贝的局限:无法处理Date、RegExp和undefined
2026-11-19 18:18:30