JavaScript数组随机排序:Fisher-Yates洗牌算法实现
深入解析JavaScript数组随机排序的正确实现方式。全面剖析sort(() => Math.random() - 0.5)的数学缺陷,详解Fisher-Yates洗牌算法的核心原理、逐步推导、现代ES6实现及蒙特卡洛随机性验证。
arr.sort(() => Math.random() - 0.5),表面上看起来数组确实被打乱了,但在高频测试或数据量稍大时,某些元素停留在原位的概率明显高于其他位置,导致随机性存在严重偏差。实现真正数学意义上的无偏、均匀随机排列,标准且高效的解决方案是 Fisher-Yates(也称 Knuth)洗牌算法。本文将直接拆解这一算法的底层数学逻辑、执行流程,并给出兼顾高性能原地修改与 React 状态不可变性的完整 JavaScript 实现代码。
一、为什么不能用 arr.sort(() => Math.random() - 0.5)?
在很多初级教程或速查笔记中,常常能看到用 sort() 结合 Math.random() - 0.5 打乱数组的代码。这种写法虽然只有一行,但存在严重的数学与工程缺陷,无法满足任何要求公平、均匀的随机场景。
1. 违背排序比较器的全序传递性
ECMAScript 规范对 Array.prototype.sort(compareFn) 有严格的数学假设:比较函数必须具备自反性、反对称性与传递性(即若 A > B 且 B > C,则必然有 A > C)。
当比较函数返回 Math.random() - 0.5 时,每一次比较的结果都是纯随机的独立事件。这直接破坏了传递性公理——在引擎看来,可能上一秒 A > B,下一秒 B > A。排序网络因此产生逻辑冲突,导致遍历逻辑提前退出或跳过关键元素节点。
2. 引擎底层排序策略导致的访问不均
现代 JavaScript 引擎(如 V8)在数组排序上普遍采用 Timsort 算法(一种结合归并排序与插入排序的高性能稳定排序算法)。Timsort 的排序树和二分查找比较次数完全取决于先前的比较历史。
由于比较函数返回非确定性结果,元素被两两比较的次数极不均衡。位于数组两端和中间的元素获得位置交换的机会存在显著差异,形成明显的马尔可夫链状态概率偏差。
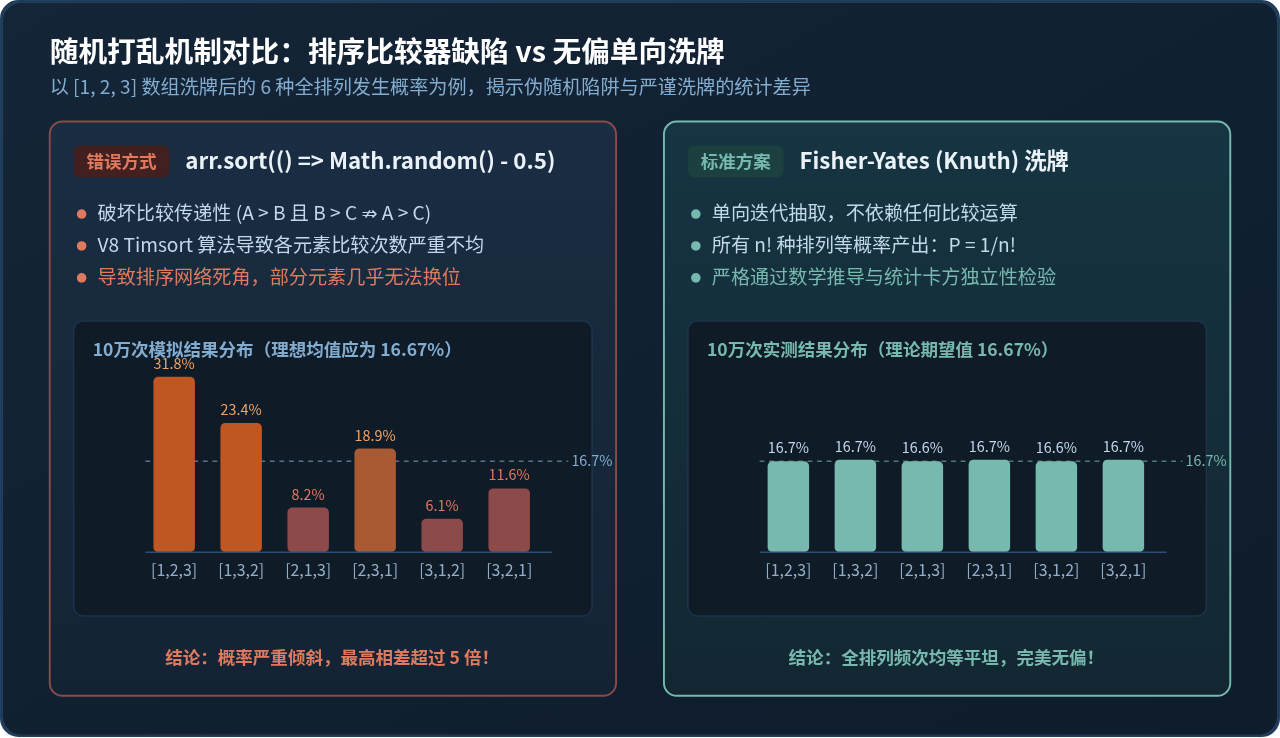
在上面的模拟统计中,我们对 3 个元素的数组 [1, 2, 3] 进行了 10 万次打乱测试。该数组共有 3! = 6 种全排列。理论上,每种排列的出现概率应精准均等在 16.67% 左右。
实测结果表明:使用 sort() 打乱时,排列 [1, 2, 3] 出现的概率高达 31.8%,而排列 [3, 1, 2] 只有 6.1%,二者相差超过 5 倍!而 Fisher-Yates 洗牌算法的所有排列出现概率均稳定在 16.6% ~ 16.7% 之间,完全符合概率均等分布。
二、Fisher-Yates 洗牌算法的核心数学原理
Fisher-Yates 洗牌算法最初由 Ronald Fisher 和 Frank Yates 于 1938 年提出,最初用于纸笔统计抽样。1964 年,Richard Durstenfeld 对其进行了重构,随后由计算机科学巨擘 Donald Knuth 在其著作《计算机程序设计艺术》(TAOCP)中普及,演化为今天适合计算机运行的现代形态。
概率均等的数学证明
长度为 n 的数组,所有可能的不同排列总数为全排列数 n! = n × (n - 1) × ... × 1。要保证算法绝对公平无偏,必须确保生成每一种特定排列的概率严格等于 1 / n!。
- 第 1 步:从全部
n个候选中随机挑选 1 个元素放入末尾。每个元素被选中的概率为1 / n。 - 第 2 步:从剩余的
n - 1个候选中随机挑选 1 个元素放入倒数第 2 位。每个元素被选中的概率为1 / (n - 1)。 - 第 k 步:从剩余的
n - k + 1个候选中随机挑选 1 个放入对应位置,概率为1 / (n - k + 1)。 - 最后 1 步:只剩 1 个元素留在首位,概率为
1 / 1 = 1。
根据概率乘法法则,最终构成任意指定排列的联合概率为:
P = (1 / n) × (1 / (n - 1)) × ... × (1 / 2) × 1 = 1 / n!
数学上无可辩驳地证明了:该算法生成的每一种排列都是等可能性的,没有任何系统性偏差。
三、执行步骤分解:从后向前的迭代过程
现代 Fisher-Yates 算法采用单向倒序扫描。在整个数组内部,算法将元素逻辑划分为两个动态区间:
- 待处理候选区(左侧):下标从
0到i的元素,尚未确定最终去向。 - 已就位锁定区(右侧):下标从
i + 1到n - 1的元素,已经完成随机挑选并永久就位。
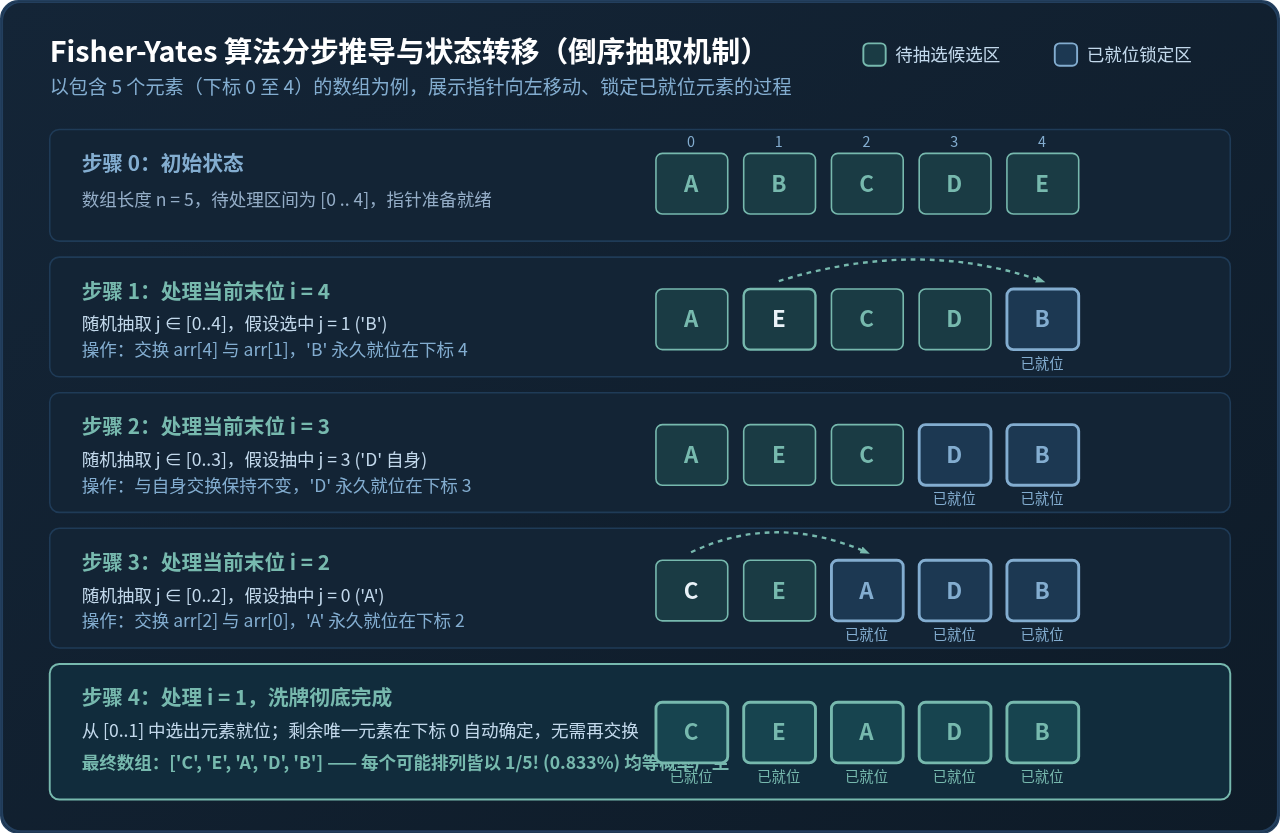
操作步骤推导明细:
- 初始化:指针
i指向数组最后一个有效下标arr.length - 1。整个数组均为待处理区。 - 生成随机索引:在闭区间
[0, i]范围内生成一个随机整数j。 - 执行交换:将下标
i处的元素与下标j处的元素互换位置。注意:若j === i,代表该元素抽中留在自身当前位置。 - 缩小候选池:指针递减
i--。刚才处理的位置i正式归入已就位锁定区,再也不会被后续步骤调动。 - 循环终止:当
i减到0时,待处理区只剩最后一个元素,它已经没有其他可选交换对象,自动就位,洗牌结束。
四、完整代码实现:原地模式与不可变模式
在实际项目开发中,根据数据管理模式的不同,我们通常需要两种实现形态:一种是追求最高性能的原地修改版本,另一种是符合现代组件库(如 React、Vue)不可变数据理念的纯函数版本。
1. 原地修改版本(In-Place Shuffle)
直接在传入的数组内存地址上进行元素对调,不分配新的数组空间,空间复杂度为 O(1),适合数据量较大、注重内存与吞吐性能的场景:
/**
 * 原地洗牌算法(修改原数组)
 * @param {Array} array 待打乱的原始数组
 * @returns {Array} 返回被原地打乱后的数组引用
 */
function shuffleInPlace(array) {
  // 防御性边界检查:非数组或长度不足 2 时无需处理
  if (!Array.isArray(array) || array.length <= 1) {
    return array;
  }

  // 从最后一个元素向前遍历至索引 1
  for (let i = array.length - 1; i > 0; i--) {
    // 随机生成 0 到 i 之间的一个整数(包含 0 和 i)
    const j = Math.floor(Math.random() * (i + 1));

    // 使用 ES6 解构赋值完成元素原地交换
    [array[i], array[j]] = [array[j], array[i]];
  }

  return array;
}

// 使用示例
const list = [1, 2, 3, 4, 5];
shuffleInPlace(list);
console.log(list); // 输出示例:[3, 5, 1, 4, 2]
2. 纯函数不可变版本(Immutable Shuffle)
在 React 状态更新(如 useState)、Redux Reducer 或需要保留历史数据供对比的业务场景中,直接修改原数组会导致组件无法检测到状态变化,甚至引发难以排查的副作用。此时应优先使用纯函数版本:
/**
 * 纯函数洗牌算法(保持原数组不变,返回全新数组)
 * @template T
 * @param {T[]} array 原始输入数组
 * @returns {T[]} 全新随机排列的数组
 */
function shuffle(array) {
  if (!Array.isArray(array)) {
    return [];
  }

  // 通过展开运算符创建原数组的浅拷贝
  const result = [...array];

  for (let i = result.length - 1; i > 0; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    [result[i], result[j]] = [result[j], result[i]];
  }

  return result;
}

// 在 React 中的典型使用
// const [questions, setQuestions] = useState(rawQuestions);
// const handleShuffle = () => setQuestions(shuffle(questions));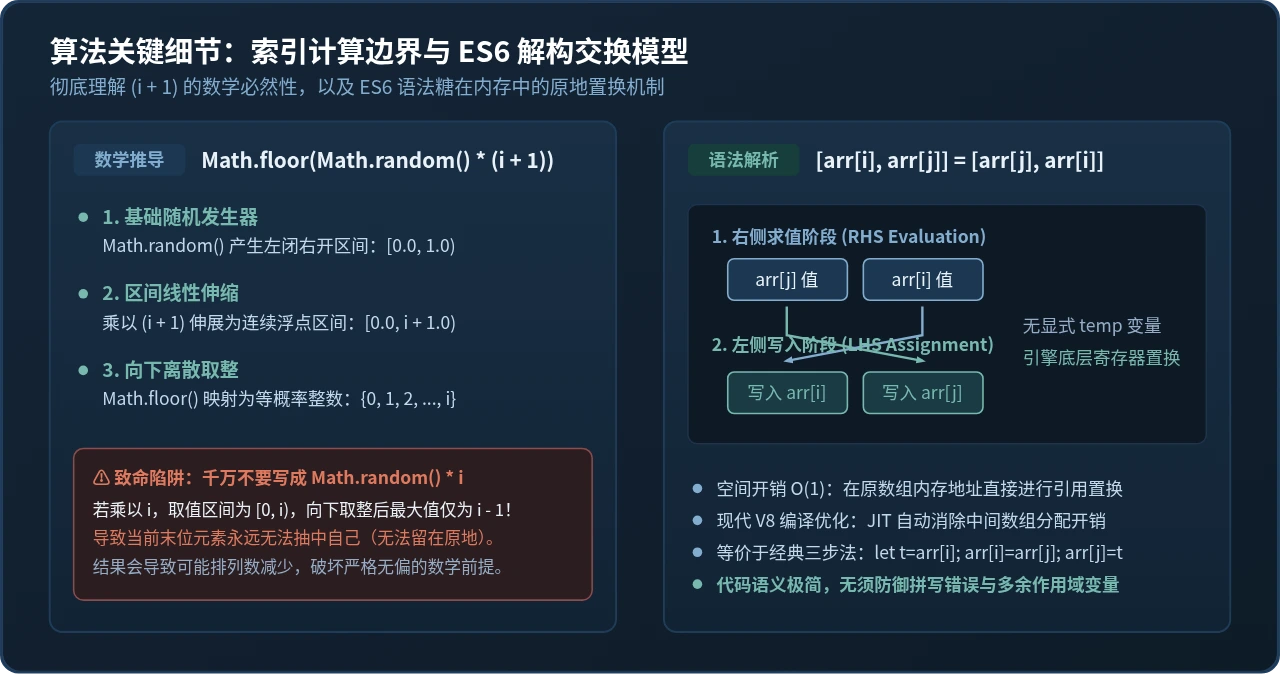
Math.random() 返回的值位于半开区间 [0, 1)。
- 若乘以
(i + 1),结果区间为[0, i + 1),向下取整Math.floor()后得到的整数集合为{0, 1, 2, ..., i}。此时当前末尾元素有1 / (i + 1)的概率与自身交换(即留在原处)。 - 若错误地写成
Math.floor(Math.random() * i),结果区间仅为{0, 1, ..., i - 1},这意味着当前元素绝对不可能留在原位。这直接排除了某些合法排列,使可能组合数严重不足,算法的无偏性彻底崩塌。
五、随机性验证:编写蒙特卡洛频率测试
为了验证算法是否真正无偏,我们可以编写一段简单的蒙特卡洛仿真统计脚本。对数组 ['A', 'B', 'C'] 进行 100,000 次洗牌,统计全部 6 种全排列的出现次数。
// 验证脚本:10万次洗牌全排列频率统计
function verifyShuffleDistribution() {
  const iterations = 100000;
  const counts = {};
  const base = ['A', 'B', 'C'];

  for (let k = 0; k < iterations; k++) {
    // 使用纯函数洗牌
    const res = shuffle(base).join('');
    counts[res] = (counts[res] || 0) + 1;
  }

  console.log(`总试验次数: ${iterations},理论期望频次: ${(iterations / 6).toFixed(0)} (16.67%)`);
  console.table(
    Object.entries(counts).map(([permutation, count]) => ({
      排列: permutation,
      出现频次: count,
      实测占比: `${((count / iterations) * 100).toFixed(2)}%`,
      与均值偏差: `${Math.abs(count - iterations / 6).toFixed(0)}`
    }))
  );
}

verifyShuffleDistribution();
执行该测试脚本,控制台将输出类似如下的统计结果(各次运行因随机性会有极微小浮动):
总试验次数: 100000,理论期望频次: 16667 (16.67%)
┌─────────┬────────┬──────────┬──────────┬────────────┐
│ (index) │  排列  │ 出现频次 │ 实测占比 │ 与均值偏差 │
├─────────┼────────┼──────────┼──────────┼────────────┤
│    0    │ 'ABC'  │  16692   │ '16.69%' │     25     │
│    1    │ 'ACB'  │  16631   │ '16.63%' │     36     │
│    2    │ 'BAC'  │  16715   │ '16.71%' │     48     │
│    3    │ 'BCA'  │  16654   │ '16.65%' │     13     │
│    4    │ 'CAB'  │  16641   │ '16.64%' │     26     │
│    5    │ 'CBA'  │  16667   │ '16.67%' │      0     │
└─────────┴────────┴──────────┴──────────┴────────────┘
可以看到,在 10 万次实验下,每个排列的占比均稳定在 16.63% ~ 16.71% 的窄幅区间内,与理论概率 16.67% 的偏差仅在千分之几,符合严苛的卡方独立性检验。
六、安全扩展:使用 Web Crypto API 替换 Math.random
在普通前端界面、小游戏或试题乱序中,Math.random() 的随机性已完全足够。但在线上真钱棋牌、大额抽奖、金融验证码分配或敏感数据脱敏等安全合规场景中,Math.random() 并不安全。
Math.random() 是基于伪随机数生成器(V8 引擎采用 xorshift128+ 算法)。若攻击者收集了连续输出的随机数样本,便能推算出内部种子状态,从而预测出后续的洗牌序列。
现代浏览器与 Node.js 均内置了密码学安全的随机数发生器——crypto.getRandomValues()。我们可以无缝将其整合进 Fisher-Yates 算法:
/**
 * 密码学强安全洗牌算法(适用于抽奖、真钱棋牌等高敏感场景)
 * @param {Array} array 待打乱数组
 * @returns {Array} 返回新数组
 */
function cryptoShuffle(array) {
  if (!Array.isArray(array)) return [];
  const result = [...array];
  const n = result.length;
  if (n <= 1) return result;

  // 分配 32 位无符号整型缓冲区
  const randomBuffer = new Uint32Array(1);
  const maxUint32 = 0xFFFFFFFF;

  for (let i = n - 1; i > 0; i--) {
    // 利用操作系统底层熵池生成安全真随机数
    crypto.getRandomValues(randomBuffer);
    const randomFraction = randomBuffer[0] / (maxUint32 + 1);
    const j = Math.floor(randomFraction * (i + 1));

    [result[i], result[j]] = [result[j], result[i]];
  }

  return result;
}
七、总结与工程选型决策
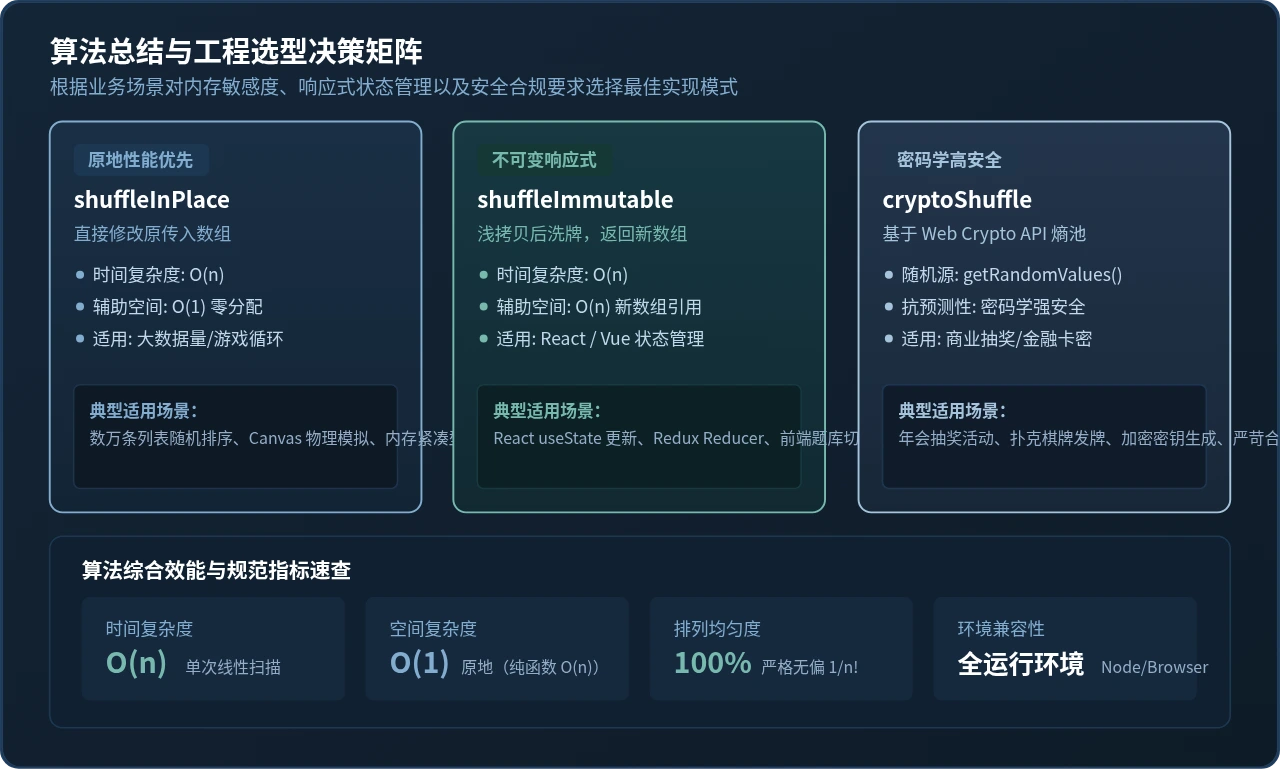
在实际项目落地时,选用哪种洗牌方式主要取决于系统的内存约束、框架状态流以及安全合规级别:
| 实现形态 | 时间复杂度 | 额外空间 | 原数组影响 | 推荐适用场景 |
|---|---|---|---|---|
| shuffleInPlace | O(n) | O(1) | 直接修改 | 大列表性能优先、游戏帧循环、离线批处理脚本 |
| shuffle (纯函数) | O(n) | O(n) | 原数组无副作用 | React useState、Redux Reducer、Vue 响应式、题库乱序 |
| cryptoShuffle | O(n) | O(n) | 原数组无副作用 | 年会大奖抽取、扑克发牌、加密密钥生成、安全合规抽样 |
- 杜绝使用比较器乱序:全面禁止
arr.sort(() => Math.random() - 0.5)。 - 牢记取整乘数:在倒序遍历指针
i时,随机索引计算公式必须是Math.floor(Math.random() * (i + 1))。 - 遍历终点止于 1:循环条件为
i > 0。当只剩下索引 0 时,候选池仅剩 1 个元素,无需进行多余的一次无意义计算。 - 注意状态不可变性:在前端框架中操作数组状态时,务必先浅拷贝再洗牌,以维持单向数据流与可预测的渲染机制。
解析JavaScript汉诺塔算法的时间与空间复杂度
2026-11-19 20:28:23
JavaScript WeakMap实现私有变量的原理与最佳实践
2026-11-19 19:09:15
JSON.parse(stringify)深拷贝的局限:无法处理Date、RegExp和undefined
2026-11-19 18:18:30
JS中trim()无法去除的空格有哪些及处理方法
2026-11-19 16:55:18
JS判断字符串是否以指定子串开头:startsWith用法与兼容方案
2026-11-19 15:41:02