

解析JavaScript汉诺塔算法的时间与空间复杂度
深入解析经典JavaScript汉诺塔递归算法的时间复杂度O(2^n)与空间复杂度O(n)。结合分治转移逻辑、二叉调用树数学推导及V8引擎执行栈动态分析,阐明时间指数爆炸与空间线性增长的底层机制。
一、JavaScript 汉诺塔的经典递归实现与状态拆解
汉诺塔源于古老的数学谜题:有三根柱子(通常记为源柱 A、辅助柱 B、目标柱 C)和 n 个大小互不相等的圆盘。初始状态下,全部圆盘均依“大盘在下、小盘在上”的顺序套在源柱 A 上。规则要求:
- 每次只能移动一根柱子最顶端的一个圆盘;
- 任何时刻,较小的圆盘必须始终置于较大圆盘之上;
- 最终必须将所有圆盘完整移动到目标柱 C 上。
求解该问题的核心是分治思想(Divide and Conquer)。要将第 n 个(最大的底盘)从 A 移动到 C,前提必须清空压在其上方的全部 n - 1 个圆盘。因此,任何规模为 n 的转移任务,都可以确定性地拆分为三个顺序动作:
- 第一步(子问题 1):将源柱 A 上方的
n - 1个圆盘,借助目标柱 C 转移至辅助柱 B; - 第二步(单盘操作):此时柱 A 仅剩第
n个最大底盘,直接将其从源柱 A 移动至目标柱 C(常数耗时); - 第三步(子问题 2):将位于辅助柱 B 上的
n - 1个圆盘,借助原源柱 A 转移至目标柱 C。
在 JavaScript 中,我们可以通过如下简洁的递归函数完整实现这一逻辑:
/**
 * JavaScript 经典汉诺塔递归求解实现
 * @param {number} n - 当前待移动的圆盘总数
 * @param {string} from - 源柱标识
 * @param {string} to - 目标柱标识
 * @param {string} aux - 辅助柱标识
 * @param {Function} onMove - 移动回调函数
 */
function hanoi(n, from, to, aux, onMove) {
  // 基线条件(Base Case):没有圆盘时直接返回
  if (n <= 0) {
    return;
  }

  // 第一步:将上面 n - 1 个盘子从 from 移至 aux,借用 to 作为中转
  hanoi(n - 1, from, aux, to, onMove);

  // 第二步:将第 n 个(最底部的最大盘)从 from 移到 to
  if (typeof onMove === 'function') {
    onMove(n, from, to);
  } else {
    console.log(`移动圆盘 ${n}: ${from} -> ${to}`);
  }

  // 第三步:将 aux 上的 n - 1 个盘子移到 to,借用 from 作为中转
  hanoi(n - 1, aux, to, from, onMove);
}

// 示例调用:求解 3 个圆盘从 A 移动至 C
let stepCount = 0;
hanoi(3, 'A', 'C', 'B', (disk, from, to) => {
  stepCount++;
  console.log(`第 ${stepCount} 步: 将圆盘 ${disk} 从 [${from}] 移至 [${to}]`);
});
// 控制台输出:准确输出 7 步移动记录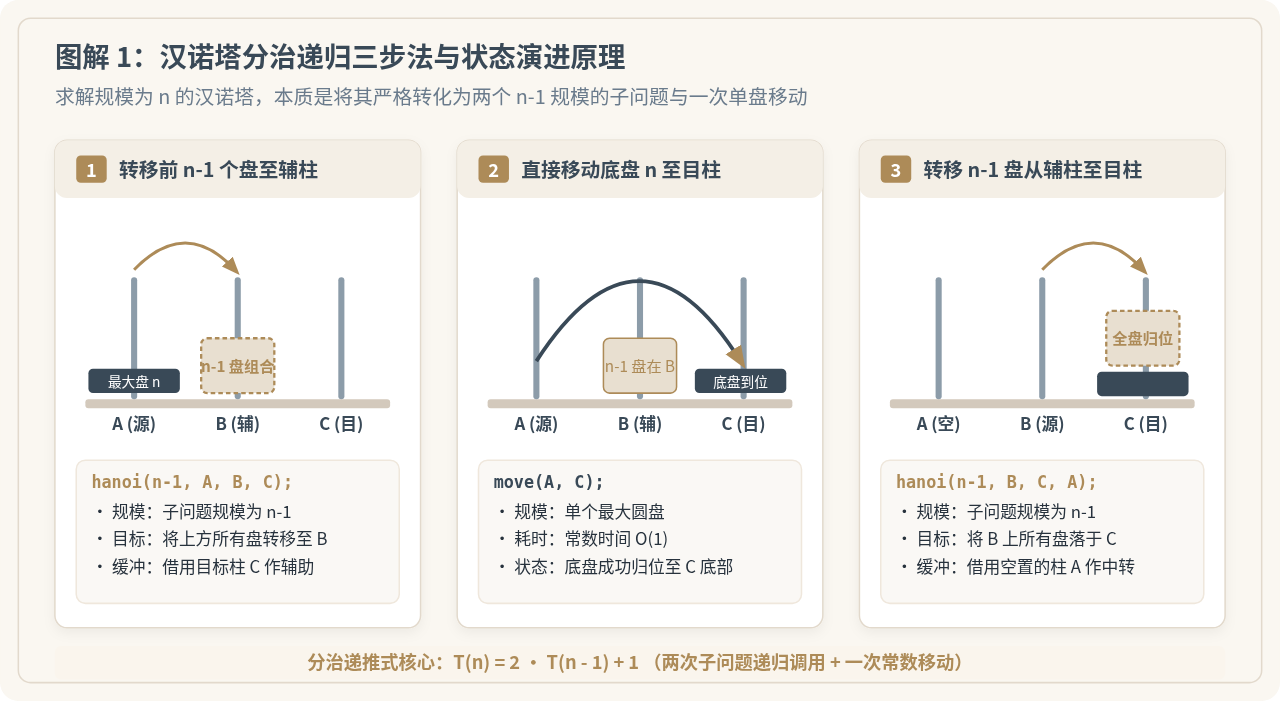
二、时间复杂度推导:为什么是 O(2ⁿ)?
要严格解析该算法的时间复杂度,我们需要衡量函数在执行期间实际完成的基本操作次数。在上述实现中,每次移动圆盘的操作耗时为常数 O(1),而函数内部对自身进行了两次规模为 n - 1 的递归调用。
1. 递推方程的建立
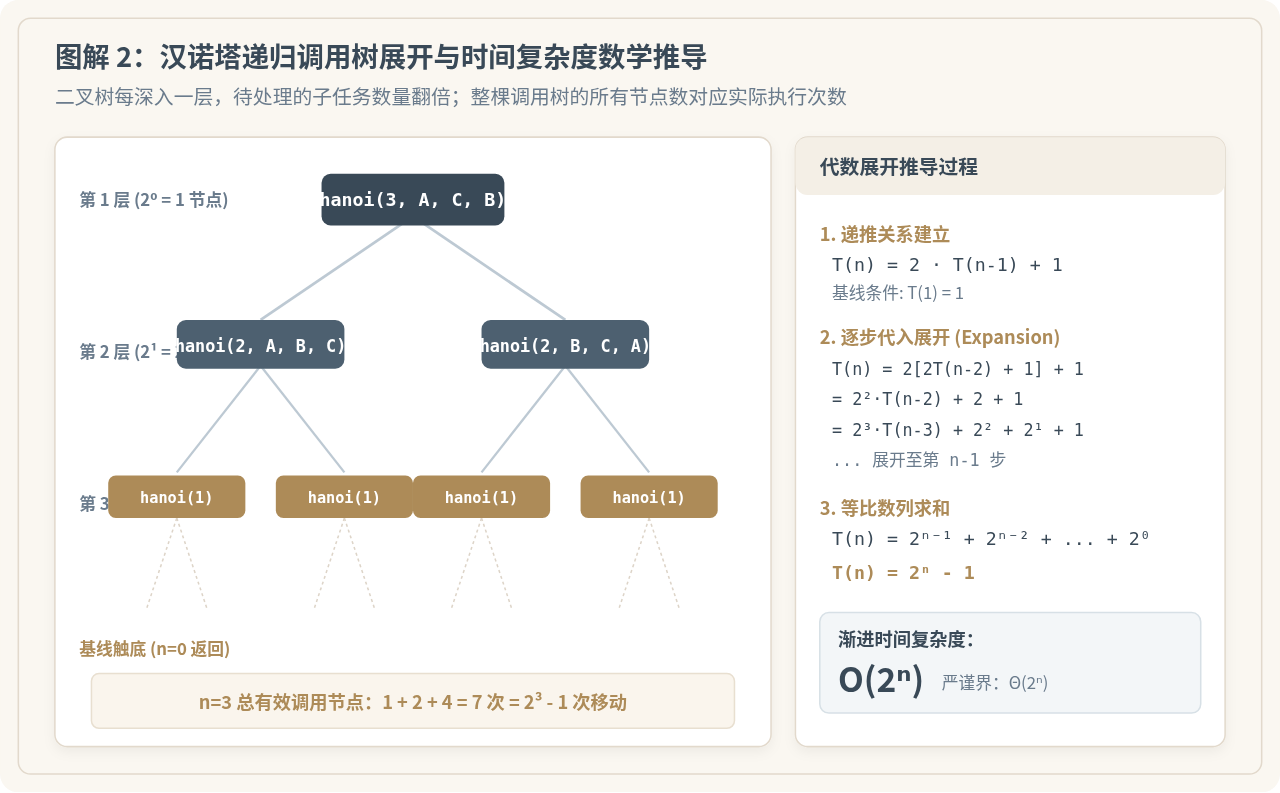
设解决规模为 n 的汉诺塔所需的总基本操作次数为 T(n)。根据上述三步分治:
- 执行
hanoi(n - 1, from, aux, to)耗时T(n - 1); - 移动第
n个底盘耗时1次常数操作; - 执行
hanoi(n - 1, aux, to, from)再次耗时T(n - 1)。
由此可列出标准的递归关系式与边界条件:
T(n) = 2 · T(n - 1) + 1  (当 n > 1)
T(1) = 1                 (当 n = 1,单盘一步即移完)
2. 代数逐步展开推导
利用代数代入法展开递推式:
T(n) = 2 · T(n - 1) + 1- 将
T(n - 1) = 2 · T(n - 2) + 1代入:
T(n) = 2 · [2 · T(n - 2) + 1] + 1 = 2² · T(n - 2) + 2 + 1 - 继续代入
T(n - 2):
T(n) = 2² · [2 · T(n - 3) + 1] + 2 + 1 = 2³ · T(n - 3) + 2² + 2¹ + 1 - 以此类推,递推展开至第
k步,可得通用展开通式:
T(n) = 2ᵏ · T(n - k) + 2ᵏ⁻¹ + 2ᵏ⁻² + ... + 2¹ + 1
当递归触底至基线条件时,令 n - k = 1,即 k = n - 1。代入通式:
T(n) = 2ⁿ⁻¹ · T(1) + 2ⁿ⁻² + 2ⁿ⁻³ + ... + 2¹ + 2⁰
由于 T(1) = 1 = 2⁰,这构成了一个公比为 2、项数为 n 的标准等比数列求和:
T(n) = ∑ (i = 0 到 n-1) 2ⁱ = (2⁰ · (1 - 2ⁿ)) / (1 - 2) = 2ⁿ - 1
因此,移动 n 个圆盘所需的精准操作步数为 2ⁿ - 1。根据大 O 渐进符号的定义,舍去低阶项与常数系数,汉诺塔算法的时间复杂度严格为 O(2ⁿ)(渐进紧确界为 Θ(2ⁿ))。
3. 递归树(Recursion Tree)几何模型
从树状拓扑的角度看,每一次非叶子节点均裂变为两个子节点。这是一棵高度为 n 的满二叉树(Full Binary Tree):
- 根节点(第 1 层):规模为
n,包含2⁰ = 1个调用; - 第 2 层:规模为
n - 1,包含2¹ = 2个调用; - 第
k层:规模为n - k + 1,包含2ᵏ⁻¹个调用; - 第
n层(叶子层):规模为1,包含2ⁿ⁻¹个调用。
整棵二叉树的全部有效节点总和即为 1 + 2 + 4 + ... + 2ⁿ⁻¹ = 2ⁿ - 1。这从直观结构上印证了每增加一个圆盘,整体耗费的运算量都将整整翻倍。
三、空间复杂度推导:为什么是 O(n) 而非 O(2ⁿ)?
初学者最容易产生的一个误解是:“既然整个算法总共生成了 2ⁿ - 1 次调用,是不是内存中也要同时开辟 2ⁿ 级别的存储单元?”
答案是否定的。汉诺塔算法的辅助空间复杂度仅为 O(n)。
1. JavaScript 引擎的调用栈(Call Stack)本质
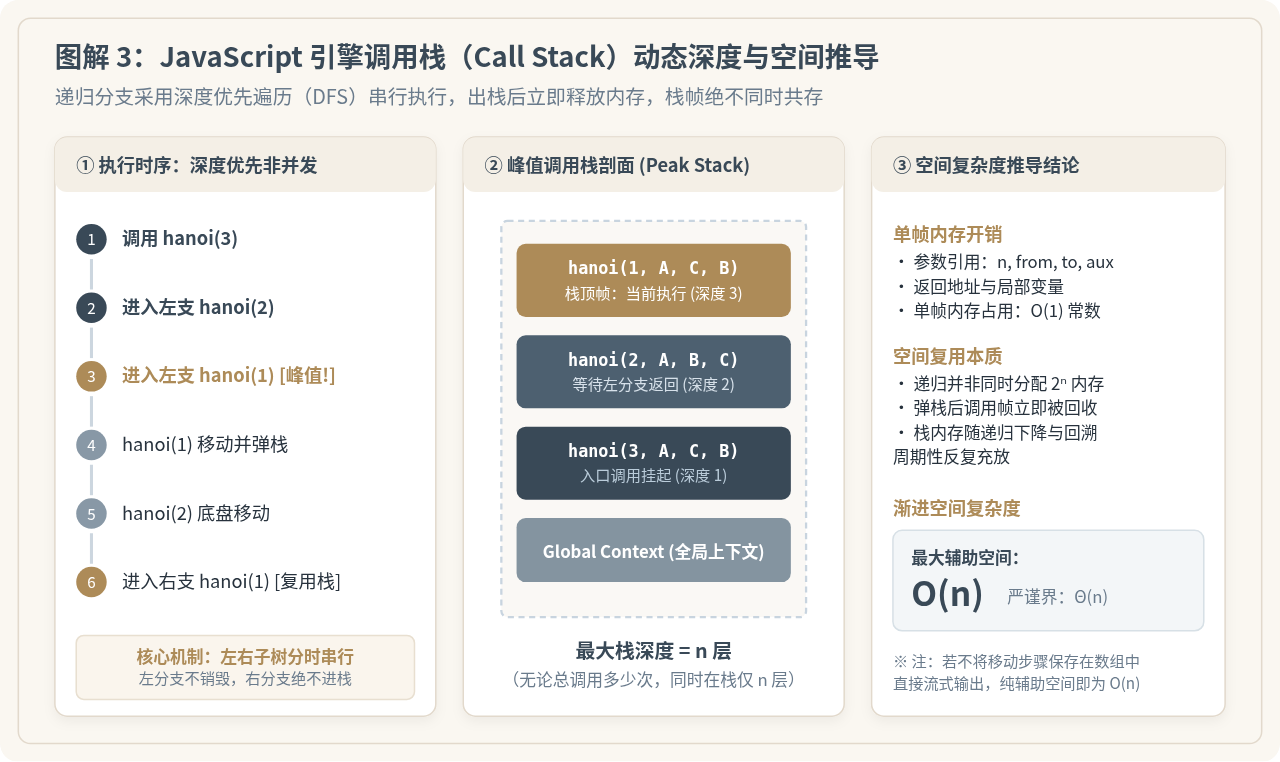
在 JavaScript 的单线程执行环境(例如 Google V8 引擎)中,代码是以同步的方式沿着调用栈(Call Stack)顺序执行的。每次触发一个函数调用,引擎会在调用栈顶端分配一个执行上下文栈帧(Stack Frame),用于保存当前函数的入参(n, from, to, aux)、局部变量以及调用结束后的返回地址。
2. 深度优先搜索(DFS)后序回溯机制
最为关键的是,代码中的两处递归调用 hanoi(...) 并不是并发执行的,而是严格串行触发的:
- 当执行到第一个子问题
hanoi(n - 1, from, aux, to)时,当前执行上下文被挂起,引擎向栈顶压入新的栈帧; - 程序持续向左子树深钻,直到触底基线(
n = 0); - 左分支执行完毕后立即弹栈(Pop),该栈帧占用的内存空间随即被引擎标记释放或复用;
- 随后完成中间的常数移动,最后才调用第二个子问题
hanoi(n - 1, aux, to, from); - 此时,右分支的栈帧直接复用了刚才左分支释放出来的栈空间。
这意味着:二叉树中左右两个对称分支,在内存中永远不会同时存在!
3. 空间复杂度定量推导
从根调用 hanoi(n) 出发,调用栈一路压栈到达最深叶子节点 hanoi(1)(加上触底基线检查 hanoi(0)),栈中同时容纳的帧数最大仅为 n + 1 层:
- 栈帧深度:
Depth = n + 1; - 每个栈帧存储 4 个引用或数值参数及基础元信息,仅消耗常数内存
O(1); - 瞬时内存峰值:
(n + 1) · O(1) = O(n)。
只要我们在移动时直接流式消费(如打印日志或通过事件回调抛出),不将庞大的 2ⁿ - 1 条轨迹数据存入内存数组中,该算法的纯辅助空间消耗严格为 O(n)。
四、规模临界点与时空瓶颈:为什么时间先于空间崩溃?
理解了时间 O(2ⁿ) 与空间 O(n) 的巨大反差后,我们来探讨工程实践中最重要的问题:在实际运行环境中,汉诺塔算法到底会先遇到什么瓶颈?
1. V8 调用栈安全上限与汉诺塔的对比
在 Node.js 或各大主流浏览器中,V8 引擎为调用栈分配了固定大小的内存缓冲区。通常情况下,JavaScript 调用栈的最大嵌套深度大约在 10,000 ~ 12,000 层 之间(具体取决于平台与局部变量体量)。如果递归深度超过该限制,就会抛出致命错误:
RangeError: Maximum call stack size exceeded
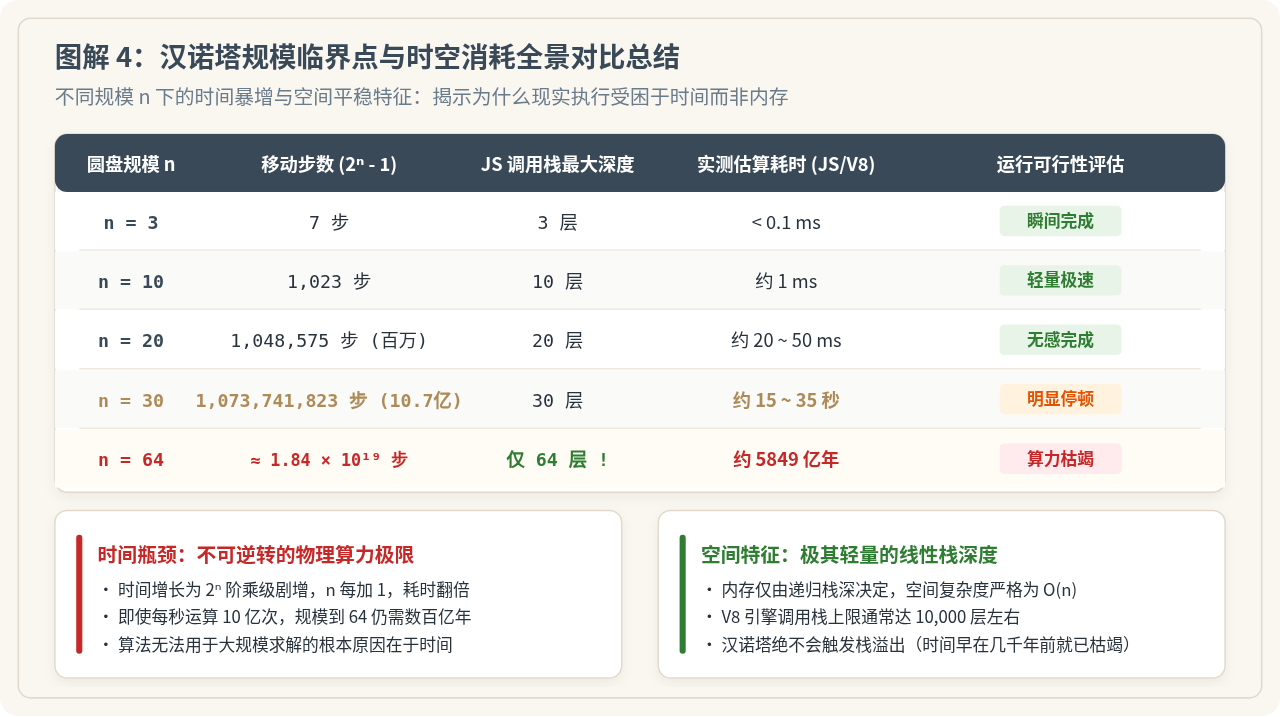
但在汉诺塔算法中,要让调用栈深度达到 10,000 层,需要圆盘数 n = 10,000。然而,当 n 仅仅达到 64 时:
- 调用栈深度:仅需
64层栈帧,在 V8 引擎中只占几 KB 的微小内存,离 10,000 层上限差了几个数量级; - 所需移动步数:
2⁶⁴ - 1 ≈ 18,446,744,073,709,551,615次。
假设世界上最顶级的超级计算机每秒钟能够执行 100 亿次(10¹⁰)盘子移动,要算完 64 个盘子的汉诺塔,也需要整整 58.49 亿年(这已经接近太阳系当前的年龄)。
| 圆盘数 n | 移动总步数 (2ⁿ - 1) | 调用栈最大深度 | 理论/实测耗时 (JavaScript) | 资源瓶颈评估 |
|---|---|---|---|---|
| 3 | 7 | 3 层 | < 0.1 毫秒 | 瞬时完成,资源开销可忽略 |
| 10 | 1,023 | 10 层 | 约 0.5 毫秒 | 极速完成 |
| 20 | 1,048,575 | 20 层 | 约 20 ~ 40 毫秒 | 无感完成,调用栈仅 20 层 |
| 30 | 1,073,741,823 (10.7亿) | 30 层 | 约 15 ~ 35 秒 | 浏览器页面明显卡死,栈深仍仅 30 层 |
| 40 | 约 1.1 × 10¹² | 40 层 | 约 12 ~ 15 天 | 单机常规执行已不可行 |
| 64 | 约 1.84 × 10¹⁹ | 64 层 | 约 5849 亿年 | 时间维度完全超越物理宇宙生命周期 |
五、常见问题与优化探讨
1. 能否用尾递归优化(TCO)将空间进一步压减为 O(1)?
在 ES6 标准中虽然提出了尾调用优化(Tail Call Optimization),但汉诺塔的双递归结构天生不满足尾调用条件:
- 第一处递归
hanoi(n - 1, from, aux, to)在函数中部,执行完后还需要执行底盘移动和第二个递归,必须保留当前上下文; - 虽然第二处递归位于函数末尾,但大部分现代 JavaScript 引擎(包括 Chrome V8、Node.js)默认并未开启隐式 TCO 支持;
- 即便通过手工维护显式模拟栈(将递归改写为循环迭代),由于必须记录待回溯的任务分支,显式栈的元素个数峰值依旧为
O(n)。
值得一提的是,利用二进制位运算或格雷码(Gray Code)算法可以写出纯迭代式的汉诺塔解法,在不借助显式栈的情况下实现 O(1) 的极致辅助空间。然而,时间复杂度 O(2ⁿ) 是物理信息的下界:无论使用递归、迭代还是位运算,因为必须如实移动 2ⁿ - 1 次圆盘,任何算法的时间复杂度都不可能低于 Ω(2ⁿ)。
2. 为什么有时候运行 n=25 也会让浏览器崩溃?
很多开发者在浏览器 DevTools 中测试 hanoi(25, ...) 时,经常发现标签页卡死甚至崩溃。这通常不是由于递归调用栈爆掉,而是因为在代码中将每步移动推入了一个全局数组(例如 result.push(...)):
- 当
n = 25时,数组需要容纳33,554,431个包含字符串的对象; - 这瞬间需要分配数个 Gigabyte 的 V8 堆内存(Heap Memory),直接导致 JavaScript 触发
OutOfMemory: Heap limit allocation failed; - 若改为流式回调直接丢弃中间状态,则内存几乎为零,仅表现为 CPU 满载约 1 秒。这再次证明:保存历史轨迹是
O(2ⁿ)堆空间,而递归算法本身的执行辅助空间仅仅是O(n)。
六、总结
解析 JavaScript 汉诺塔算法的时空复杂度,为我们提供了一个极其经典的模型:
- 时间复杂度 O(2ⁿ):源于分治模型中
T(n) = 2T(n-1) + 1的二叉裂变,规模每增加 1,操作次数成倍扩张,是典型的不可多项式求解(NP/指数级)问题; - 空间复杂度 O(n):源于 JavaScript 单线程引擎对调用栈的深度优先(DFS)后序回溯机制,左右子树分时串行执行,内存随出栈迅速复用,瞬时峰值仅与树高
n呈线性关联; - 时空瓶颈:现实执行的铁壁永远是指数级的时间开销,而非微不足道的调用栈深。
JavaScript数组随机排序:Fisher-Yates洗牌算法实现
2026-11-19 20:20:54
JavaScript WeakMap实现私有变量的原理与最佳实践
2026-11-19 19:09:15
JSON.parse(stringify)深拷贝的局限:无法处理Date、RegExp和undefined
2026-11-19 18:18:30
JS中trim()无法去除的空格有哪些及处理方法
2026-11-19 16:55:18
JS判断字符串是否以指定子串开头:startsWith用法与兼容方案
2026-11-19 15:41:02







