

JavaScript使用DOMParser解析XML字符串完整示例
本文详细讲解如何在 JavaScript 中使用原生 DOMParser 将 XML 格式字符串解析为标准的 XMLDocument 文档对象。涵盖初始化、MIME 类型设置、特殊的 parsererror 异常拦截机制、节点遍历与属性提取,并提供完整可执行代码示例。
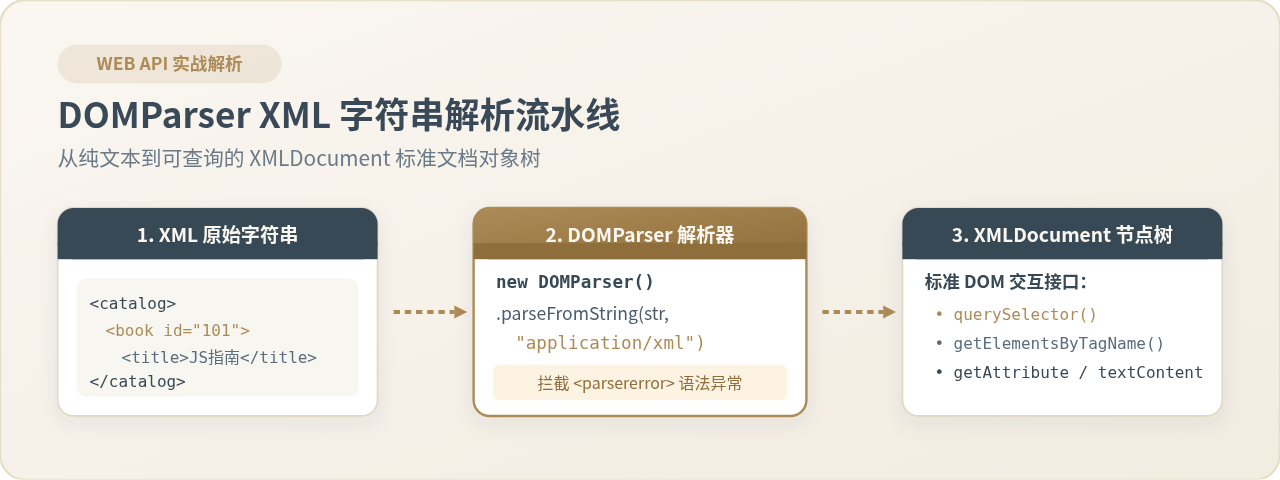
在 JavaScript 中,解析 XML 格式的字符串主要依赖浏览器原生提供的 DOMParser API。通过 new DOMParser() 实例化解析器,调用其 parseFromString(xmlString, "application/xml") 方法,即可将纯文本形式的 XML 转换成标准的 XMLDocument 文档对象。随后便能像操作常规 HTML DOM 一样,利用 querySelector、getElementsByTagName、getAttribute 以及 textContent 等接口查询并提取数据。需要特别注意的是,DOMParser 在遇到 XML 语法错误时不会抛出 JavaScript 运行时异常,而是会在生成的文档树中注入一个特殊的 <parsererror> 节点,因此主动检测该节点是编写稳定解析逻辑的关键所在。
一、DOMParser 基础用法与核心调用规范
DOMParser 属于现代浏览器环境(包括 Chrome、Firefox、Safari、Edge 等)标配的全局构造函数,用于将存储在字符串中的 XML 或 HTML 标记解析为 DOM Document 对象。整个过程在内存中完成,不需要将内容挂载到页面的实际渲染树中,具有高效、轻量且免外部依赖的优点。
使用 DOMParser 解析 XML 时,核心调用结构如下:
const parser = new DOMParser();
const xmlDoc = parser.parseFromString(xmlString, "application/xml");
parseFromString 方法接收两个必需参数:
- 第一个参数(str):待解析的字符串内容。通常是由服务端接口下发、本地文件读取或用户输入的原始 XML 文本。
- 第二个参数(mimeType):指定解析上下文的 MIME 类型。解析标准 XML 时,推荐使用
"application/xml"或"text/xml"。如果传入"image/svg+xml"则以 SVG 上下文解析;若传入"text/html",解析器将采用 HTML5 的宽容纠错模式生成HTMLDocument,而不会执行严格的 XML 格式校验。
生成的 xmlDoc 是一个完整的 XMLDocument 实例,继承自标准 Document。这意味着开发者可以使用与操作普通网页 DOM 完全一致的 API 来查询元素、读取属性以及提取文本内容。
二、标准解析流程与操作步骤
在工程实践中,严谨的 XML 解析不能仅执行单行调用,必须涵盖文本检查、解析执行、异常拦截与对象转换等完整阶段。下图展示了从原始文本到提取可用 JavaScript 数据的标准化执行路径:
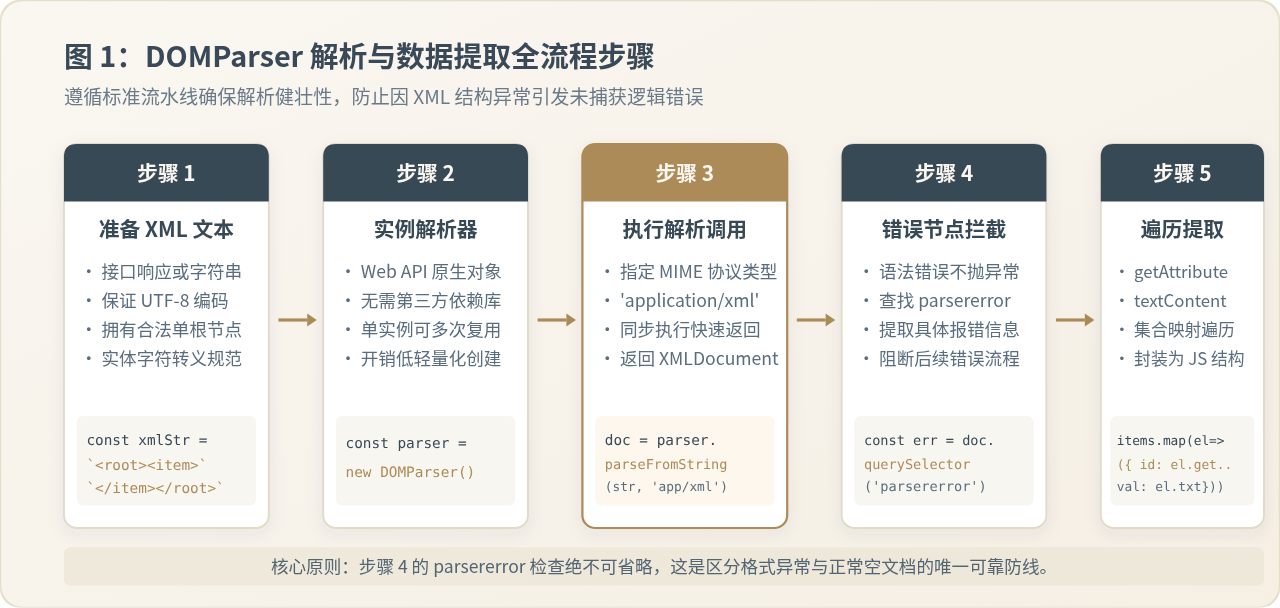
整个流程分为五个明确的阶段:
- 准备 XML 文本:确保待解析的文本为合法字符串,编码为 UTF-8,并且具备唯一的根节点(XML 规范要求每个有效文档必须且仅能有一个顶级根元素)。
- 实例化解析器:通过
new DOMParser()获得解析器对象。在单页应用中,该解析器实例可以多次复用,无需在每次解析时反复新建。 - 调用 parseFromString:传入待解析字符串并显式声明
"application/xml",解析器会同步扫描字符串并构建内部节点关系。 - 检查并拦截 parsererror 节点:这是保障系统健壮性最关键的转折点。如果字符串存在标签未闭合、属性缺少引号等语法硬伤,解析器不会崩溃,而是返回包含错误信息的文档树。必须在进入数据读取前拦截该节点。
- 节点查询与数据映射:确认无语法错误后,通过选择器定位目标节点,抽取属性(
getAttribute)和纯文本(textContent),并转化为原生 JavaScript 数组或对象。
三、XML 字符串与 DOM 节点树的映射模型
理解 XML 文本转化为 DOM 之后的节点类型与层级关系,有助于准确选用提取方法。XML 文档是严格的树形分层结构,每个标签、属性和内部文本在 DOM 树中都对应着具体的 Node 类型。
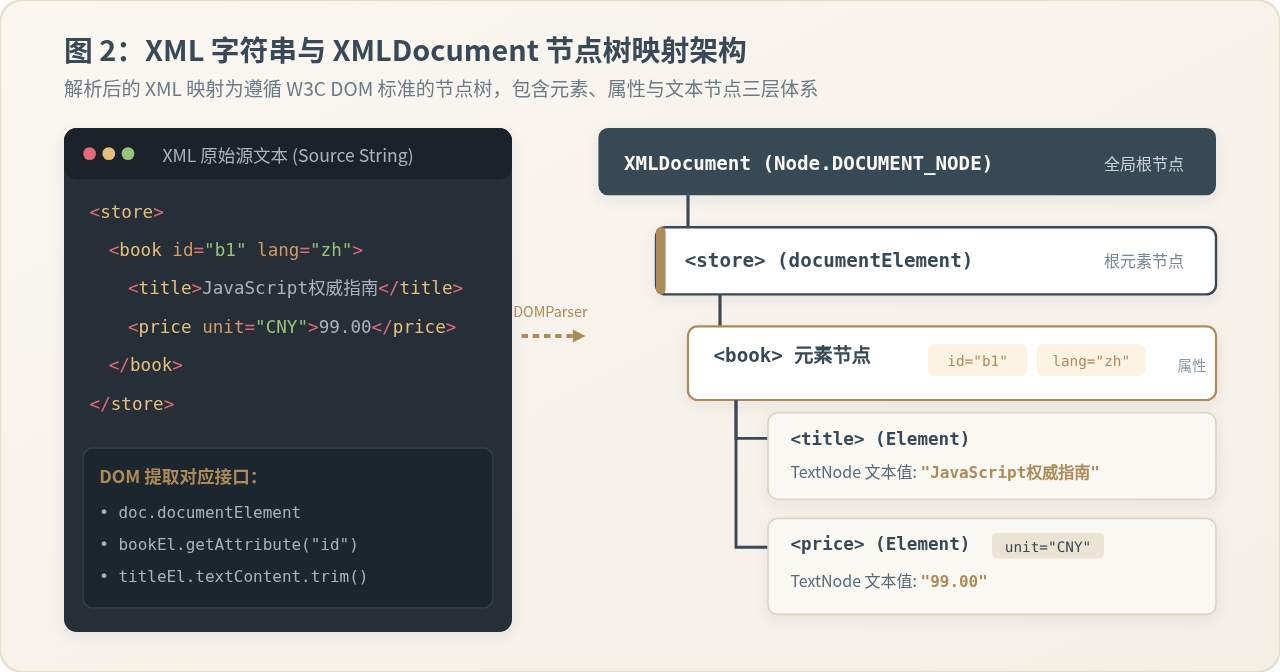
在映射模型中,主要包含以下层级与节点类型:
- Document 节点(
#document):整个解析文档的顶级容器,提供documentElement属性直接指向根标签,同时提供全局查询方法querySelector和getElementsByTagName。 - Element 元素节点:对应 XML 中的每对标签(例如
<book>、<title>)。元素节点拥有标签名(tagName或nodeName)、子节点列表(children/childNodes)以及属性映射表。 - Attribute 属性节点:对应标签内部声明的键值对(例如
id="b1")。在 DOM Level 2 以后,通常不把属性作为独立的子节点直接遍历,而是通过元素节点的element.getAttribute(name)和element.hasAttribute(name)接口直接读写。 - Text 文本节点与 CDATA 区块:标签之间的纯文本(例如
JavaScript权威指南)在内部表示为Text节点。如果 XML 内部使用了<![CDATA[ ... ]]>包裹富文本或特殊符号,在读取其父元素的textContent属性时,DOMParser 会自动将其内容作为纯字符串整合输出,无需编写额外的 CDATA 解码逻辑。
四、关键细节:为什么不能直接使用 try...catch 捕获语法错误
许多习惯了解析 JSON 的开发者常犯的一个严重错误是:企图使用 try...catch 块来检测 XML 解析失败。实际上,这在 DOMParser 下是完全无效的。
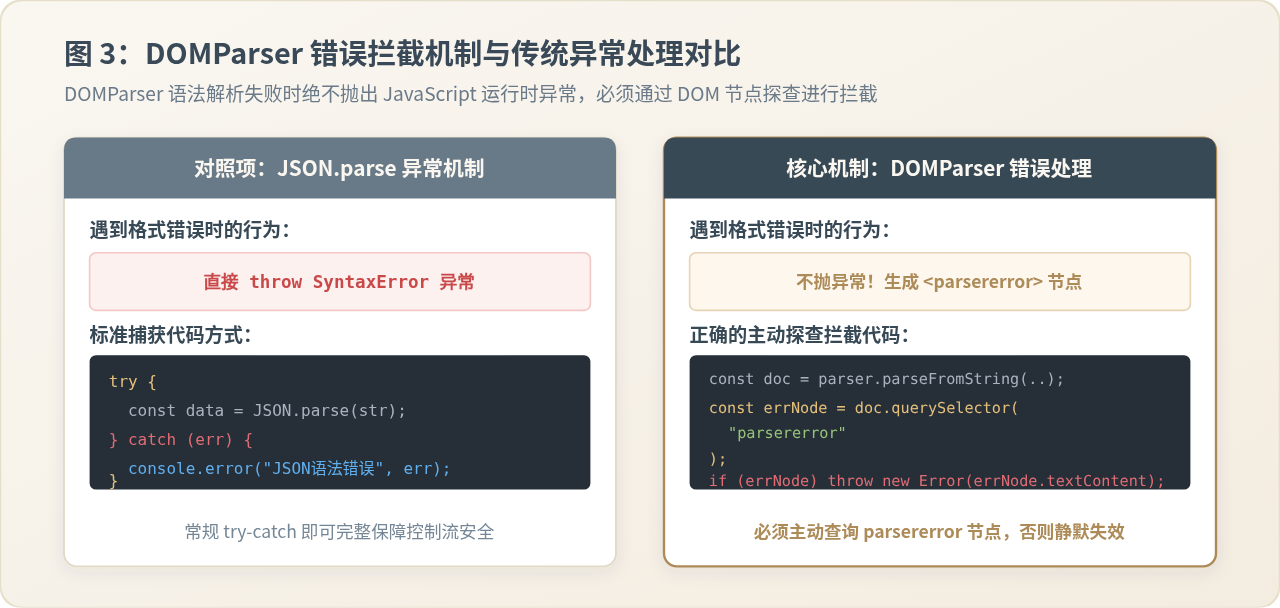
当执行 JSON.parse("invalid json") 时,V8 引擎会主动抛出 SyntaxError 运行时异常;但 W3C DOMParser 规范明确规定:当 XML 格式非法时,parseFromString 严禁抛出异常,而必须在返回的 XMLDocument 根部或内部注入一个标签名为 <parsererror> 的元素节点,并将详细的行号、列号与语法错误描述放置在该节点的文本或内部 HTML 中。
如果开发者仅写了 try { doc = parser.parseFromString(...) } catch(e) {},当遇到破坏性的非法 XML 时,catch 块根本不会被触发。代码会继续向下执行 doc.querySelector("myTag").textContent,此时由于找不到正常业务节点而导致后续代码报出经典的 TypeError: Cannot read properties of null,反而掩盖了根本的 XML 格式问题。
通用 parsererror 错误检测函数实现
在不同浏览器(Chrome、Firefox、Safari)中,<parsererror> 节点的命名空间或包裹方式略有差异,但它们都统一包含 parsererror 标签名。我们可以封装一个高可靠性的语法验证辅助函数:
/**
 * 校验 XMLDocument 是否包含解析错误
 * @param {Document} xmlDoc - DOMParser 返回的文档对象
 * @returns {string|null} 若解析失败返回错误描述字符串,成功返回 null
 */
function checkXmlParseError(xmlDoc) {
  // 优先使用 querySelector 检索 parsererror 节点
  const errorNode = xmlDoc.querySelector("parsererror");
  if (errorNode) {
    // 提取错误详细描述并清洗首尾空白字符
    return errorNode.textContent.trim();
  }

  // 针对个别老旧浏览器补充命名空间检索兜底
  const nsErrors = xmlDoc.getElementsByTagName("parsererror");
  if (nsErrors.length > 0) {
    return nsErrors[0].textContent.trim();
  }

  return null;
}
五、端到端完整可执行实战示例
为了让读者直观掌握从原始 XML 到结构化 JavaScript 对象的完整闭环,以下提供一个生产级别的完整实战范例。该示例模拟了一个包含商品元数据、多层级列表、属性键值、特殊转义字符及 CDATA 说明文档的真实 XML 字符串。
// 1. 准备一段典型的 XML 字符串源(包含属性、嵌套、数值与 CDATA 描述)
const rawXmlString = `<?xml version="1.0" encoding="UTF-8"?>
<store inventory="TechWarehouse" lastUpdated="2026-11-18">
  <product id="P-1001" category="hardware" inStock="true">
    <name>4K 超清专业显示器</name>
    <brand>UltraVision</brand>
    <pricing currency="CNY">
      <cost>2199.00</cost>
      <msrp>2699.00</msrp>
    </pricing>
    <tags>
      <tag>4K</tag>
      <tag>Type-C 90W</tag>
      <tag>IPS</tag>
    </tags>
    <description><![CDATA[专业设计级色彩显示器,支持 <99% DCI-P3> 色域覆盖,出厂校色。]]></description>
  </product>
  <product id="P-1002" category="peripherals" inStock="false">
    <name>人体工学机械键盘</name>
    <brand>KeyCraft</brand>
    <pricing currency="CNY">
      <cost>549.00</cost>
      <msrp>699.00</msrp>
    </pricing>
    <tags>
      <tag>无线三模</tag>
      <tag>热插拔</tag>
    </tags>
    <description><![CDATA[Gasket 结构静音轴体,适合全天候码字与办公环境。]]></description>
  </product>
</store>`;

/**
 * 解析 XML 字符串并将其转换为 JavaScript 业务对象
 * @param {string} xmlText - 原始 XML 字符串
 * @returns {object} 包含仓库信息与产品列表的结构化对象
 */
function parseStoreInventory(xmlText) {
  // 第一步:实例化解析器并执行解析
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlText, "application/xml");

  // 第二步:执行语法错误拦截
  const parseError = xmlDoc.querySelector("parsererror");
  if (parseError) {
    throw new Error("XML 解析失败: " + parseError.textContent.trim());
  }

  // 第三步:获取根节点及其全局属性
  const storeElement = xmlDoc.documentElement;
  const inventoryName = storeElement.getAttribute("inventory") || "未知仓库";
  const lastUpdated = storeElement.getAttribute("lastUpdated") || "";

  // 第四步:查询产品列表并批量映射数据
  const productNodes = storeElement.querySelectorAll("product");
  const products = Array.from(productNodes).map(node => {
    // 读取产品基本属性与子标签
    const id = node.getAttribute("id");
    const category = node.getAttribute("category");
    const inStock = node.getAttribute("inStock") === "true";

    const name = node.querySelector("name")?.textContent.trim() || "";
    const brand = node.querySelector("brand")?.textContent.trim() || "";

    // 读取价格对象信息并完成数字类型转换
    const pricingNode = node.querySelector("pricing");
    const currency = pricingNode?.getAttribute("currency") || "CNY";
    const cost = parseFloat(pricingNode?.querySelector("cost")?.textContent || "0");
    const msrp = parseFloat(pricingNode?.querySelector("msrp")?.textContent || "0");

    // 提取列表集合标签(tags)
    const tagNodes = node.querySelectorAll("tags > tag");
    const tags = Array.from(tagNodes).map(t => t.textContent.trim());

    // 读取 CDATA 区块文本
    const description = node.querySelector("description")?.textContent.trim() || "";

    return {
      id,
      name,
      brand,
      category,
      inStock,
      pricing: { currency, cost, msrp },
      tags,
      description
    };
  });

  return {
    inventory: inventoryName,
    lastUpdated,
    totalCount: products.length,
    products
  };
}

// 执行测试解析
try {
  const parsedData = parseStoreInventory(rawXmlString);
  console.log("解析成功结果:", JSON.stringify(parsedData, null, 2));
} catch (err) {
  console.error("处理流程捕获异常:", err.message);
}
示例执行控制台输出结果
在浏览器开发者工具(F12 控制台)中运行上述脚本,控制台输出如下(标明为示例运行输出):
解析成功结果: {
  "inventory": "TechWarehouse",
  "lastUpdated": "2026-11-18",
  "totalCount": 2,
  "products": [
    {
      "id": "P-1001",
      "name": "4K 超清专业显示器",
      "brand": "UltraVision",
      "category": "hardware",
      "inStock": true,
      "pricing": {
        "currency": "CNY",
        "cost": 2199,
        "msrp": 2699
      },
      "tags": ["4K", "Type-C 90W", "IPS"],
      "description": "专业设计级色彩显示器,支持 <99% DCI-P3> 色域覆盖,出厂校色。"
    },
    {
      "id": "P-1002",
      "name": "人体工学机械键盘",
      "brand": "KeyCraft",
      "category": "peripherals",
      "inStock": false,
      "pricing": {
        "currency": "CNY",
        "cost": 549,
        "msrp": 699
      },
      "tags": ["无线三模", "热插拔"],
      "description": "Gasket 结构静音轴体,适合全天候码字与办公环境。"
    }
  ]
}
六、进阶场景与关键注意事项
1. XML 命名空间(Namespace)的处理技巧
在处理 SOAP 报文、SVG 矢量或者特定行业标准 XML(如 RSS/Atom/Maven POM)时,节点通常带有命名空间前缀(例如 <soap:Envelope xmlns:soap="...">)。常规的 getElementsByTagName("Envelope") 可能会检索不到带有前缀的节点。此时建议采用以下两种方案之一:
- 忽略前缀匹配本地名(Local Name):使用属性通配选择器,例如
xmlDoc.querySelectorAll("*|Envelope"),或通过原生属性过滤:const nodes = Array.from(xmlDoc.getElementsByTagName("*")) .filter(el => el.localName === "Envelope"); - 严格命名空间匹配:使用
xmlDoc.getElementsByTagNameNS(namespaceURI, "Envelope"),确保在复杂的混编 XML 文档中准确唯一定位。
2. Node.js 服务端环境适配
DOMParser 属于浏览器窗口环境的 Web API,Node.js 原生运行环境中并未内置该构造函数。如果在 Node.js 后端服务、脚本或单元测试中执行解析,可以安装 W3C 规范兼容库:
# 在项目根目录下执行安装命令
npm install @xmldom/xmldom
安装后在代码中按如下方式导入即可与浏览器代码保持 100% 接口一致:
import { DOMParser } from "@xmldom/xmldom";
const parser = new DOMParser();
const xmlDoc = parser.parseFromString(xmlString, "application/xml");
3. 防御性数据提取:规避空指针异常
与 JSON 解析后对象属性直接存在或返回 undefined 不同,当 XML 节点缺少某个子标签时,doc.querySelector("not-exist") 会直接返回 null。如果直接访问 .textContent 会抛出未捕获异常。在实际编码中,务必养成使用可选链操作符(?.)和默认值回退(|| "")的习惯:
// 推荐的安全提取方式
const author = itemNode.querySelector("author")?.textContent.trim() || "未知作者";
七、总结速查表
下表和速查图总结了在日常使用 DOMParser 解析 XML 时最常用的核心属性、方法与关键准则:
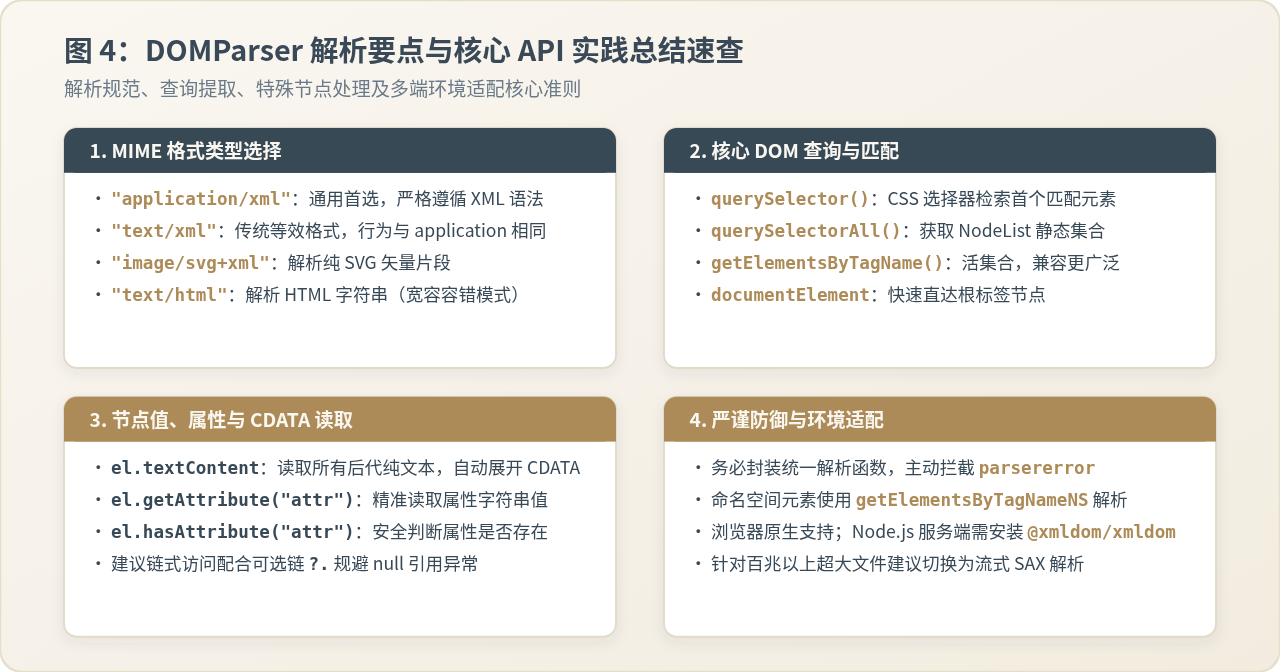
| API 接口 / 属性 | 功能作用 | 使用注意事项 |
|---|---|---|
new DOMParser() |
创建解析器实例 | 轻量对象,推荐单例复用,无需频繁新建 |
parseFromString(str, mime) |
同步解析字符串并返回 Document | 解析 XML 时请务必传入 "application/xml" |
doc.querySelector("parsererror") |
拦截语法错误节点 | 核心步骤,解析器不抛异常,必须主动检查此节点 |
doc.documentElement |
获取 XML 顶级根节点 | 合法 XML 有且仅有一个顶级根节点 |
el.getAttribute("attrName") |
读取元素属性字符串 | 若属性不存在返回 null,需做好空值防御 |
el.textContent |
获取元素内所有文本内容 | 自动拼接子节点文本并展开 CDATA 区块;推荐配合 .trim() 清除多余换行与空格 |
综上所述,JavaScript 中使用 DOMParser 解析 XML 字符串的关键在于把握两点:一是理解其与标准 DOM 的无缝兼容性,灵活运用各种选择器抽取结构化数据;二是在调用 parseFromString 后立即建立主动的 parsererror 拦截防线,从而确保数据解析流程的严密与稳健。
JS批量修改页面段落字体样式的方法
2026-11-19 18:07:10
JS实现点击下载:a标签download属性用法与限制
2026-11-19 14:14:20
JS追加HTML:为什么推荐insertAdjacentHTML而非innerHTML
2026-11-19 13:34:28
window.open弹窗关闭后怎么用JS刷新父页面
2026-11-19 13:28:13
封装支持回调的JS通用淡入淡出函数
2026-11-19 12:16:46







