JS实现点击下载:a标签download属性用法与限制
深入讲解JavaScript结合a标签download属性实现点击下载的核心原理、五步标准流程、Blob内存导出及跨域失效排查方案。
在前端交互开发中,通过 JavaScript 触发文件下载的核心手段是操作带有 download 属性的 <a> 标签。该属性指示浏览器将链接目标作为本地文件保存,并允许由前端自定义默认保存的文件名。然而,这一属性的功能边界受到浏览器同源策略(Same-Origin Policy)、网络协议以及服务器响应头的直接约束。本文将讲解 download 属性的基础语法、JavaScript 动态创建与派发事件的标准步骤、Blob 内存数据的导出方法,并剖析跨域限制产生的根源与应对方案。
一、a 标签 download 属性的基础语法与工作机制
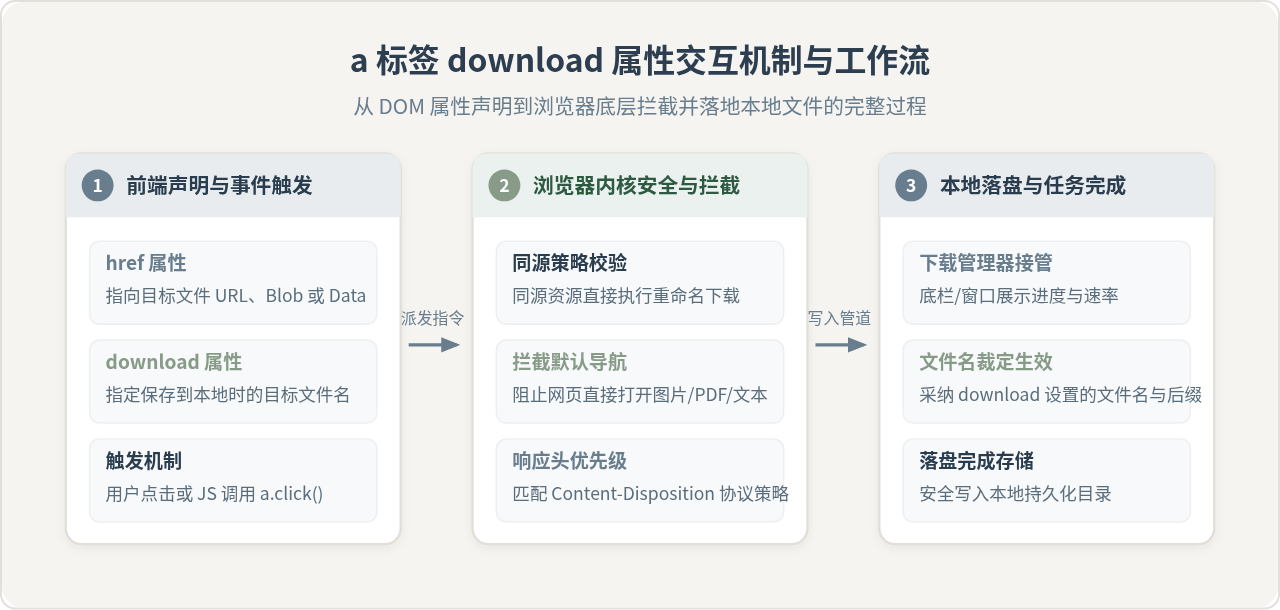
在 HTML5 规范之前,点击指向 PDF、图片或文本文件的链接时,浏览器的默认行为通常是在当前窗口或新标签页中直接打开并预览该文件。若希望强制弹出本地保存对话框,以往只能依赖服务端在 HTTP 响应头中注入 Content-Disposition: attachment。
HTML5 引入的 download 属性改变了这一情况。只要超链接声明了该属性,浏览器就会优先拦截页面的跳转导航行为,转而唤起底层的下载管道:
<!-- 方式 1:空值,默认采用资源原有的文件名 -->
<a href="/reports/monthly-summary.pdf" download>下载月度报告</a>

<!-- 方式 2:指定自定义文件名 -->
<a href="/reports/monthly-summary.pdf" download="2026年财务汇总.pdf">重命名并下载</a>
当给 download 属性赋值时,该值将成为文件保存到磁盘时的预设文件名。如果省略属性值,浏览器将从 URL 路径末尾截取文件名,或者根据响应头中的信息自动推断扩展名。
二、JavaScript 动态创建与触发下载的完整步骤
在实际业务中,许多下载行为由用户点击按钮、勾选表格或者异步接口请求完成后触发,页面上并不会预先放置静态的 <a> 标签。此时需要利用 JavaScript 在内存中动态创建锚点节点并模拟点击。
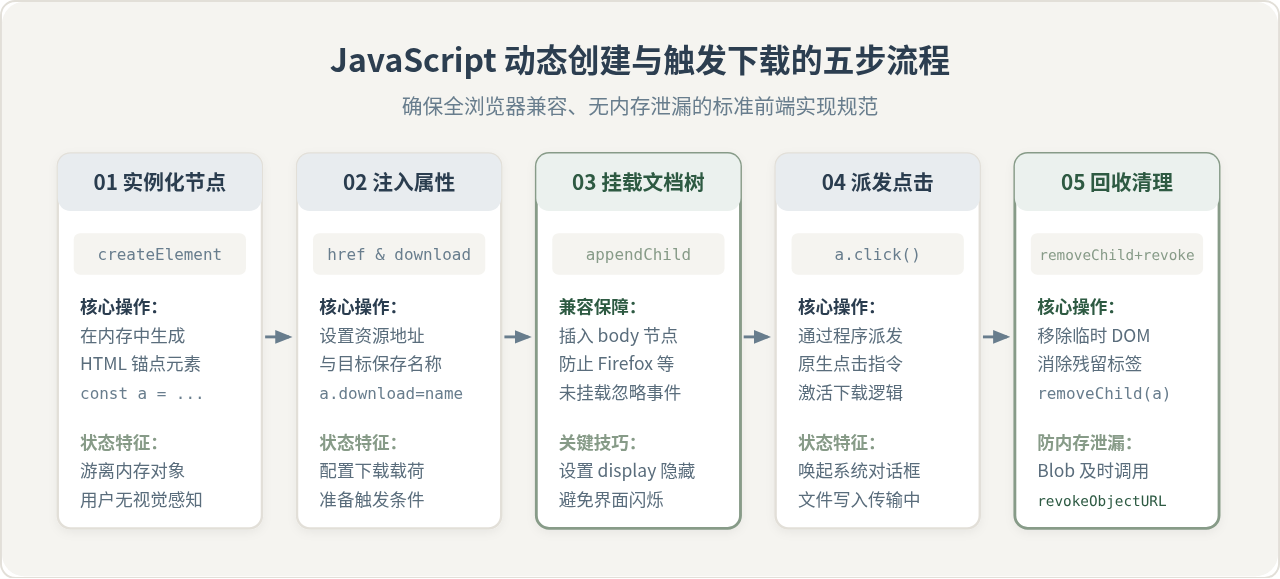
标准实现通常包含以下五个连贯步骤:
- 创建节点:调用
document.createElement('a')在内存中实例化一个超链接对象。 - 配置属性:将资源的访问路径赋给
href,将期望的目标文件名赋给download。 - 挂载文档树:调用
document.body.appendChild(a)。在部分浏览器环境(例如早期的 Firefox 版本)中,如果元素未挂载到主文档树(DOM Tree),直接调用click()可能被安全机制拦截或静默忽略。为确保全平台稳定,将其临时追加至 body 是行业通用规范。 - 派发点击:调用
a.click()派发原生点击指令,唤起浏览器下载弹窗。 - 节点与资源清理:调用
document.body.removeChild(a)及时移除临时 DOM 节点,避免页面 DOM 冗余。
以下是封装好的基础下载函数示例:
/**
 * 通过 URL 触发文件下载
 * @param {string} url 资源地址(支持同源静态链接、Blob URL、Data URL)
 * @param {string} filename 保存时的预设文件名
 */
function downloadByUrl(url, filename) {
  // 1. 创建临时的 a 标签
  const anchor = document.createElement('a');
  // 2. 注入地址与重命名参数
  anchor.href = url;
  anchor.download = filename || '';
  // 隐藏元素,避免挂载瞬间引起界面抖动
  anchor.style.display = 'none';

  // 3. 挂载到主文档树中
  document.body.appendChild(anchor);

  // 4. 模拟点击事件
  anchor.click();

  // 5. 从文档树中安全移除
  document.body.removeChild(anchor);
}
三、前端动态生成数据的导出:Blob 与 Object URL
除了静态文件路径,现代前端常需将内存中的结构化数据(如表格导出的 CSV、JSON 日志或 Canvas 绘制的图片)直接生成文件供用户下载。针对这种场景,浏览器提供了 Blob(Binary Large Object)和 URL.createObjectURL() 机制。
Data URL(形如 data:text/plain;base64,...)将所有数据直接编码进 URL 字符串中。当导出数据量达到数兆字节时,Base64 会使体积膨胀约 33%,并因浏览器 URL 长度限制而导致解析失败甚至页面卡死。相比之下,URL.createObjectURL(blob) 会在浏览器内存中建立一个映射句柄(形如 blob:https://example.com/uuid),无需编码转换,读取效率高,适合导出中大型数据。
通过 Blob 导出纯前端生成数据的标准封装如下:
/**
 * 将内存数据转化为本地文件并触发下载
 * @param {BlobPart} content 文本、二进制流或 TypedArray
 * @param {string} filename 导出的文件名
 * @param {string} mimeType 文件的 MIME 类型
 */
function downloadBlob(content, filename, mimeType = 'text/plain;charset=utf-8') {
  // 1. 实例化 Blob 对象
  const blob = new Blob([content], { type: mimeType });

  // 2. 生成本地指向内存的 Blob URL
  const objectUrl = URL.createObjectURL(blob);

  // 3. 借助 a 标签触发下载
  const anchor = document.createElement('a');
  anchor.href = objectUrl;
  anchor.download = filename;
  anchor.style.display = 'none';

  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);

  // 4. 关键:释放内存中的映射引用
  URL.revokeObjectURL(objectUrl);
}

// 使用示例:导出 CSV 表格数据
const csvData = "姓名,工号,部门\n张三,E1001,技术部\n李四,E1002,运营部";
downloadBlob(csvData, "员工花名册.csv", "text/csv;charset=utf-8;");URL.createObjectURL() 创建的 URL 会常驻浏览器内存,直到所属文档被卸载。在单页应用(SPA)频繁导出报表的场景下,必须在触发下载后调用 URL.revokeObjectURL(url) 解除映射,否则会造成内存占用持续累加。
四、a 标签 download 属性的核心限制与跨域排查
在实际项目中,开发者经常遇到 “写了 download 属性却直接在浏览器打开了文件” 或者 “自定义文件名没有生效,保存的文件名依然是一串随机哈希” 的现象。这类问题的核心原因在于浏览器的安全隔离机制。
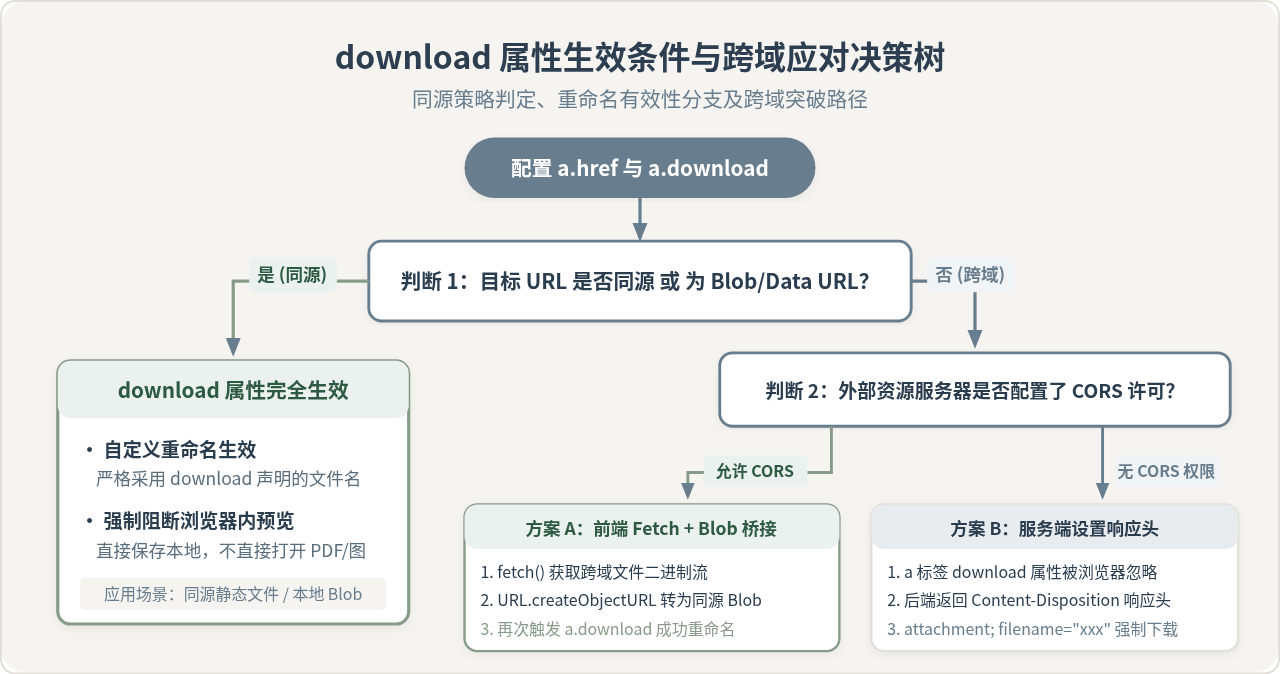
1. 同源策略限制(Same-Origin Policy)
根据 W3C HTML 规范及主流浏览器(Chrome 65+、Firefox、Safari)的安全实现,download 属性的强制重命名和下载行为仅对同源 URL 生效。对于指向跨域域名的超链接,浏览器出于防止恶意钓鱼和防止未知文件静默注入的安全考量,会直接忽略 download 属性:
- 如果该文件是浏览器原生支持预览的文件类型(如
.jpg,.png,.pdf,.txt),浏览器会退化为直接在当前标签或新标签页中打开它,而不执行保存。 - 即使触发了下载,浏览器也只会使用 URL 最后的路径片段命名,忽略你在
download属性中填写的中文名或自定义名。
2. 跨域场景的有效解决路径
面对跨域资源的下载需求,可以根据外部服务器的控制权限选择不同的处理手段:
路径 A:服务端支持 CORS,前端通过 Fetch + Blob 桥接
如果第三方存储(如阿里云 OSS、腾讯云 COS、AWS S3)配置了跨域资源共享(CORS),允许当前域名的 GET 请求,前端可先使用 fetch() 将远程资源读取为本地内存中的 Blob,由于 Blob URL 属于当前页面的同源资源,此时再注入 download 属性即可恢复重命名与下载能力:
/**
 * 下载跨域资源并强制重命名(前提:资源服务器允许 CORS)
 * @param {string} url 跨域文件的完整 URL
 * @param {string} filename 期望保存的文件名
 */
async function downloadCrossOriginFile(url, filename) {
  try {
    const response = await fetch(url, { mode: 'cors' });
    if (!response.ok) {
      throw new Error(`下载失败,HTTP 状态码: ${response.status}`);
    }
    const blob = await response.blob();
    const objectUrl = URL.createObjectURL(blob);

    const anchor = document.createElement('a');
    anchor.href = objectUrl;
    anchor.download = filename;
    anchor.style.display = 'none';

    document.body.appendChild(anchor);
    anchor.click();
    document.body.removeChild(anchor);

    // 释放内存引用
    setTimeout(() => URL.revokeObjectURL(objectUrl), 1000);
  } catch (error) {
    console.error('跨域资源下载异常:', error);
    // 降级处理:尝试直接打开
    window.open(url, '_blank');
  }
}
路径 B:服务端无 CORS 支持,改由后端直接控制响应头
当无法在跨域源上配置 CORS 规则,或者文件体积巨大(例如数百兆的安装包、高清视频)不适合全量载入浏览器内存时,必须由提供资源的后端服务设置 HTTP 响应头:
Content-Disposition: attachment; filename="contract-2026.pdf"; filename*=UTF-8''contract-2026.pdf
Content-Type: application/octet-stream
一旦服务端响应包含 attachment,无论请求是否跨域,也不管前端超链接是否设置了 download 属性,浏览器都会强制弹出本地保存对话框,并遵从响应头中指定的文件名。
五、常见技术方案对比与技术选型总结
在前端工程实践中,文件下载往往需要根据文件来源、跨域条件以及内存容纳上限综合决策。下表汇总了四种主流实现方式的技术边界:
| 技术方案 | 跨域支持能力 | 重命名支持度 | 客户端内存消耗 | 首选应用场景 |
|---|---|---|---|---|
| 静态 a[download] | 仅同源生效 | 同源完美支持 | 零内存占用 | 静态同源文档、固定模板下载 |
| JS + Blob 内存构造 | 原生同源 (Blob) | 完美支持 | 取决于生成数据量 | 前端纯数据导出(CSV、JSON、Canvas) |
| Fetch + Blob 转接 | 需资源服务端 CORS 配合 | 完美支持 | 整个文件常驻内存 | 中小型跨域图片、文档重命名归档 |
| 后端 Content-Disposition | 原生无视跨域与格式 | 由服务端精确控制 | 零前端内存 (流式直写) | 超大文件(>100MB)、带鉴权机制的报表 |
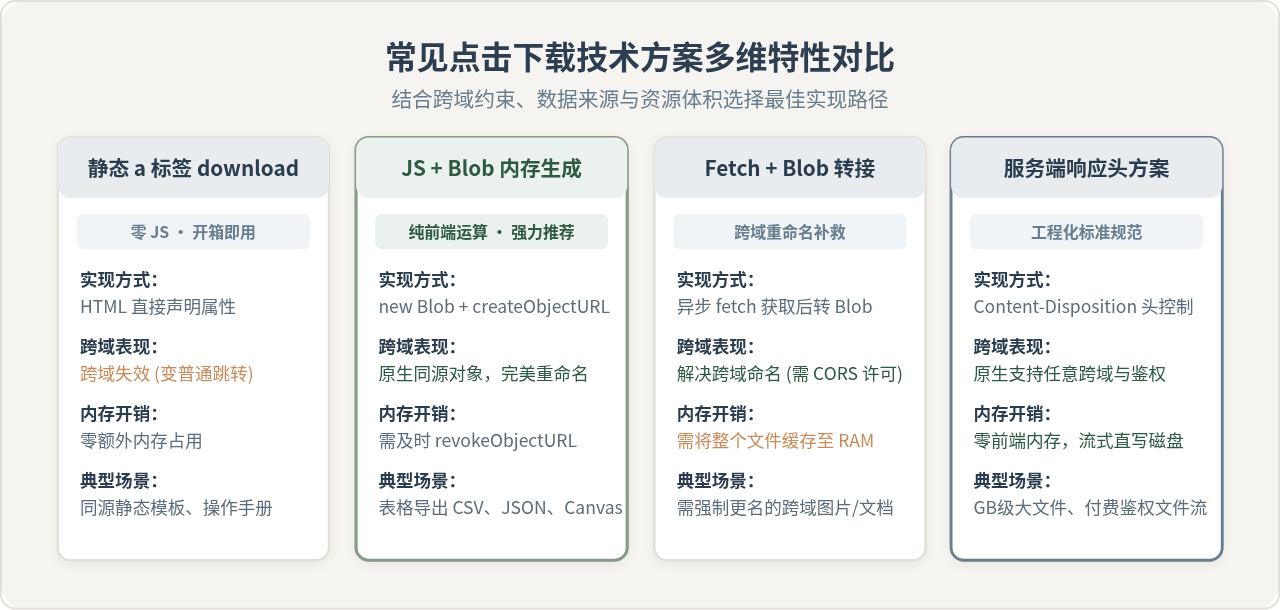
总结而言,<a> 标签的 download 属性为纯前端控制下载提供了极大的便利,是处理同源静态资源与前端 Blob 导出时的首选利器。在面对跨域与超大文件时,应当理性认识其同源策略的安全界限,适时选用 Fetch 转换或与后端 Content-Disposition 响应头相配合,构建可靠稳健的前端文件导出链路。
JS追加HTML:为什么推荐insertAdjacentHTML而非innerHTML
2026-11-19 13:34:28
window.open弹窗关闭后怎么用JS刷新父页面
2026-11-19 13:28:13
封装支持回调的JS通用淡入淡出函数
2026-11-19 12:16:46
解决JS获取文件路径显示C:\fakepath\的问题
2026-11-19 11:46:40
JS计算器支持键盘输入与连续运算的实现逻辑
2026-11-19 11:31:47