

JavaScript正则贪婪与非贪婪匹配原理及避坑指南
深入解析JavaScript正则表达式贪婪与非贪婪(惰性)匹配的核心机制,通过NFA指针回溯过程、状态推导、排除型字符组对比以及四大高危实战避坑案例,全面掌握高效安全的正则编写方案。
一、语法基石:贪婪与非贪婪的量词对应关系
在 ECMAScript 规范中,正则表达式的匹配行为受量词(Quantifier)严格控制。量词规定了紧邻在其左侧的字符或子组可以连续重复的次数。所有量词默认都是贪婪的。要将其切换为非贪婪模式,只需在常规量词末尾紧跟一个英文问号 ? 即可。
| 贪婪量词 | 贪婪语义 | 非贪婪量词 | 非贪婪语义 | 典型示例对比(输入:"10000") |
|---|---|---|---|---|
* |
匹配 0 次或尽可能多次 | *? |
优先匹配 0 次,必要时单步扩展 | /\d*/ 匹配 "10000";/\d*?/ 匹配 "" |
+ |
匹配 1 次或尽可能多次 | +? |
优先匹配 1 次,必要时单步扩展 | /\d+/ 匹配 "10000";/\d+?/ 匹配 "1" |
? |
匹配 0 次或 1 次(贪婪取 1) | ?? |
优先匹配 0 次(非贪婪取 0) | /\d?/ 匹配 "1";/\d??/ 匹配 "" |
{m,n} |
匹配 m 至 n 次(贪婪取 n) | {m,n}? |
优先匹配 m 次(非贪婪取 m) | /\d{2,4}/ 匹配 "1000";/\d{2,4}?/ 匹配 "10" |
特别注意问号 ? 在 JavaScript 正则中有三重截然不同的语法含义,切勿混淆:
- 作为独立量词:例如
/a?/,表示匹配 0 次或 1 次字符a。 - 作为量词修饰符:紧跟在其他量词之后,例如
/+?/、/*?/、/{2,5}?/、/??/,用于将贪婪量词转为非贪婪。 - 作为语法结构前缀:在圆括号内作为非捕获组
(?:...)、正向先行断言(?=...)或负向后行断言(?<!...)的前缀。
二、引擎内核:NFA 状态机与指针回溯的运作全过程
JavaScript 的 RegExp 引擎遵循 NFA(不确定有限状态自动机,Non-deterministic Finite Automaton) 架构。NFA 引擎是以“正则表达式为驱动”的,当遇到量词时,引擎需要决定指针是前进消费字符,还是停留在原地尝试后续子模式。贪婪与非贪婪的本质区别,就在于这个分支决策的优先次序与状态回溯路径。
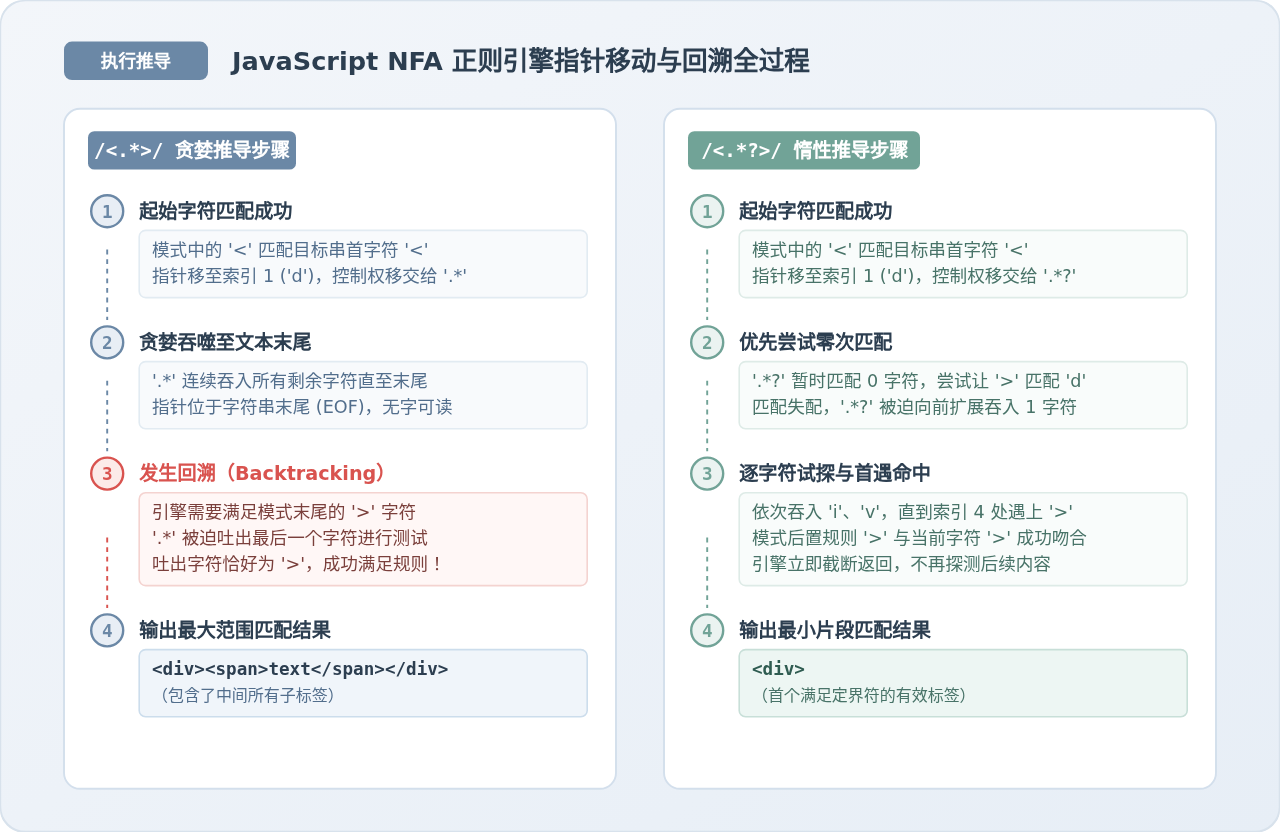
1. 贪婪匹配的执行剖析(以 /<.*>/ 为例)
假设输入字符串为 <div><span>text</span></div>,执行 /<.*>/.exec(str):
- 首字符命中:引擎从索引 0 开始,模式中的字符
<成功匹配到字符串首位的<。 - 贪婪吞噬:进入
.*状态。由于处于贪婪模式,引擎一口气把从d开始直到字符串最末尾的字符全部读入。此时文本读取指针停留在索引 35(EOF,字符串结束位置)。 - 尝试后续模式:引擎发现正则模式后面还有一个字符
>需要匹配。但此时输入串已经没有字符可读。 - 触发回溯(Backtracking):引擎开始从已匹配的
.*堆栈中“吐出”字符(回退指针)。首先吐出末尾的>。此时将这个吐出的字符与模式中的>比较,刚好完全吻合! - 匹配成功输出:引擎宣布匹配成功,最终返回截获的字符串为整个
<div><span>text</span></div>。
2. 非贪婪匹配的执行剖析(以 /<.*?>/ 为例)
面对相同的输入串,执行 /<.*?>/.exec(str) 时的执行步调截然相反:
- 首字符命中:同样在索引 0 处命中
<,指针移至索引 1(字符d)。 - 优先零次测试:
.*?优先尝试匹配 0 个字符。引擎暂不吞入字符d,而是立刻用模式末尾的>去匹配当前的d。 - 失配向前扩展:字符
d不是>,匹配失败。.*?只能被迫向前“扩吞”1 个字符(消耗掉d),指针移至索引 2(字符i)。 - 循环试探:引擎再次尝试让模式中的
>匹配字符i,再次失败。.*?继续吞入i,再尝试v,依然失败;继续吞入v,指针到达索引 4(字符>)。 - 初遇闭合即止:此时模式中的
>成功匹配字符串中的>。引擎立刻截断并报告匹配成功,返回结果<div>。
三、深度对比:贪婪、非贪婪与排除型字符组性能矩阵
许多前端工程师在提取括号内容、HTML 属性或双引号字符串时,第一反应往往是随手写下 /".*?"/ 或 /<.*?>/。然而,在工业级代码中,这种写法隐藏着显著的性能劣势与边界失控风险。更健壮、更高效的方案通常是排除型字符组(Negated Character Class),即 /[^"]*/ 或 /<[^>]*>/。
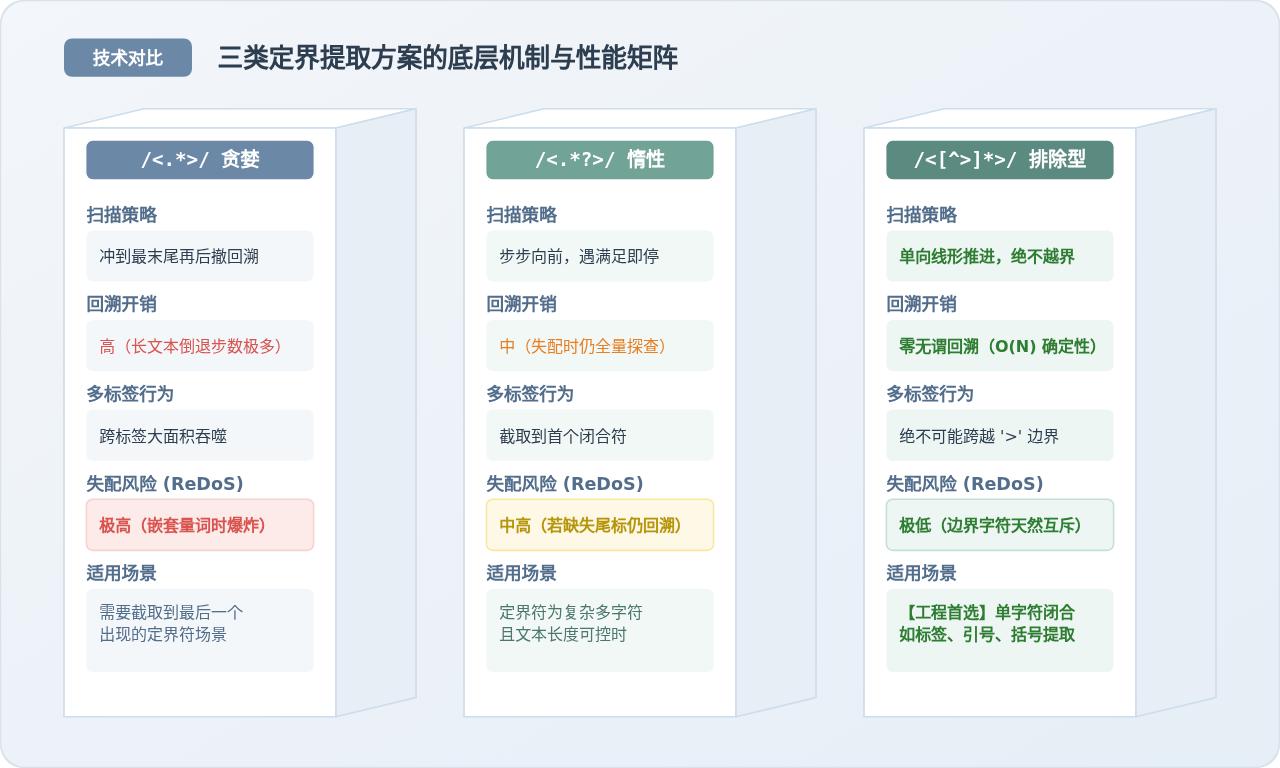
为什么 /[^>]*/ 远胜于 /.*?/?
核心差异在于定界字符的互斥性。在 /<[^>]*>/ 中,模式清晰界定了内部内容“绝对不包含 >”。这意味着:
- 无需猜测,线性推进:引擎在遇到下一个
>之前,可以全力单向读取字符。由于匹配集与定界符互斥,根本不存在任何二义性,因而不需要记录分支状态,更无需发生任何无效回溯。 - 失配响应极为敏捷:如果输入的 HTML 标签存在语法错误(例如缺失闭合的
>),/<[^>]*>/会在读到行尾或下一个无关字符时立即判定失败。而/<.*?>/则会继续盲目吞入后续数千行代码,沿途不断尝试匹配>,产生巨大的 CPU 计算浪费。
// 示例代码:基准对比与执行输出
const rawHtml = '<div class="box" id="main">Content</div><div class="footer"></div>';

// 1. 贪婪匹配:吞噬整个片段直到末尾
const greedyMatch = rawHtml.match(/<.*>/);
console.log(greedyMatch[0]);
// 输出: <div class="box" id="main">Content</div><div class="footer"></div>

// 2. 非贪婪匹配:通过单步扩吞停止在首个 >
const lazyMatch = rawHtml.match(/<.*?>/);
console.log(lazyMatch[0]);
// 输出: <div class="box" id="main">

// 3. 排除型字符组匹配:零回溯高效线性提取(推荐实践)
const negatedMatch = rawHtml.match(/<[^>]*>/);
console.log(negatedMatch[0]);
// 输出: <div class="box" id="main">
四、实战避坑指南:四大典型陷阱与防御重构
在生产环境中,依赖直觉编写的非贪婪正则经常在边缘边界测试或异常数据输入时暴露出严重缺陷。以下是四种最常见的踩坑场景及重构手法。
陷阱 1:前置贪婪量词覆盖了非贪婪意图(“贪婪吃尽”)
开发者希望提取字符串中以数字开头、以 foo 结尾的尽可能短的片段,常误写为 /^\d+.*?(foo)/。
// 错误示范:期望提取最靠近开头的 foo,实际却被前置 .*? 之前的位置挤压
const text = "123abc_foo_def_foo_end";
const badPattern = /^.*?(foo)/; // 以为有 ? 就会惰性匹配第一个 foo
console.log(text.match(badPattern)[1]); // 输出: "foo" (虽然碰巧对,但看下方变体)

const text2 = "prefix_A_mid_A_target";
const trapPattern = /.*(A.*?target)/; // 前面的 .* 是贪婪的!
console.log(text2.match(trapPattern)[1]);
// 实际输出: "A_target",而不是期望的 "A_mid_A_target"
// 原因:前置的贪婪量词 .* 拥有最高优先权,它会尽量向右吃,直到把第一个 A 挤掉!.*),它会尽最大努力吞噬字符,迫使右侧的非贪婪量词只能在已被吃剩的极小区间内执行。
重构策略:严格限定左侧量词的匹配字符集,禁止使用过于宽泛的
.* 作为前缀。
陷阱 2:跨行与 DotAll(s 标志)引发的无边界跨标签吞食
在提取 HTML 文本时,如果存在多个同级代码块且代码块中包含换行,开发者常开启 s 修饰符配合 .*?。如果页面中某处标签语法残缺(例如漏写闭合标签),惰性量词会跨越整个文档一路吞噬至文档最后一个闭合标签。
// 错误示范:尝试批量提取代码块
const htmlDoc = `
<pre><code>const a = 1;</code></pre>
<p>一段普通文本</p>
<pre><code>const b = 2; // 注意这里人为丢失闭合标签
<p>更多内容</p>
<pre><code>const c = 3;</code></pre>
`;

// 如果第二个 code 标签缺少 </code>,非贪婪会直接跨越整段文本直到第三个 </code>!
const matches = htmlDoc.match(/<code>[\s\S]*?<\/code>/g);
console.log(matches.length); // 结果只有 2 个,中间的大段无关 HTML 全部被当成代码吞没![\s\S]*?。如果一定要用正则做轻量提取,必须为内容加入边界阻断,例如通过负向先行断言 (?:(?!<pre>)[\s\S])*? 确保不会跨越下一个块级起点。更推荐使用标准的 DOMParser 进行树级解析。
陷阱 3:嵌套量词导致的灾难性回溯(ReDoS 拒绝服务攻击)
当把非贪婪量词放入一个外层带量词的分组时,例如 /(.*?)+$/ 或 /(<.*?>)+/,一旦输入长串无法匹配的字符串,引擎将陷入指数级状态探索。
// 高危警报:ReDoS 漏洞模式演示
const vulnerableRegex = /^(<.*?>)+$/;

// 正常字符串极速通过
vulnerableRegex.test("<div><span></span></div>"); // 耗时 < 0.1ms

// 恶意构造的攻击载荷:超长无闭合标签
const attackPayload = "<div" + "a".repeat(30) + "!";
// 执行下行代码将导致 Node.js 单线程 EventLoop 完全锁死数秒至数十秒!
// vulnerableRegex.test(attackPayload);
成因揭秘:外层的 + 和内层的 *? 均有匹配空串或单字符的能力。当末尾遇到 ! 导致全式失配时,引擎会穷举外层和内层量词的所有组合可能($2^N$ 复杂度),造成 CPU 占用飙升至 100%。
陷阱 4:试图用非贪婪正则解析嵌套/成对结构
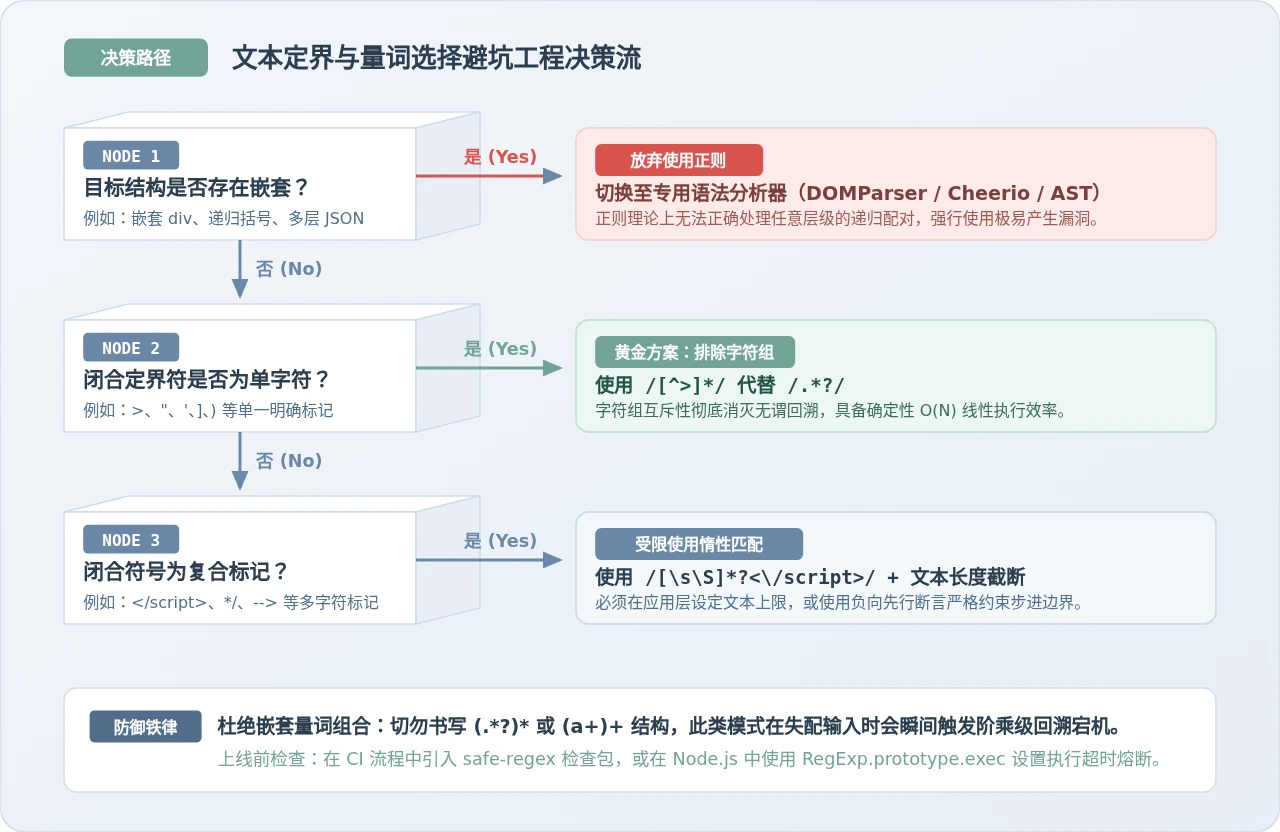
这是经典也是反复出现的误区:尝试用 /<div>.*?<\/div>/ 提取带有子容器的 div。
const nested = "<div id='parent'><div id='child'>Inner</div></div>";
const result = nested.match(/<div.*?>.*?<\/div>/);
console.log(result[0]);
// 输出: "<div id='parent'><div id='child'>Inner</div>"
// 严重错误:它在子 div 的闭合标签处就提前退出了,留下了孤立的外层闭合标签!
由于 JavaScript 原生正则不支持递归匹配(Recursive Regex),任何正则均无法正确处理深度不固定的任意嵌套结构。
五、全景架构与最佳实践指南
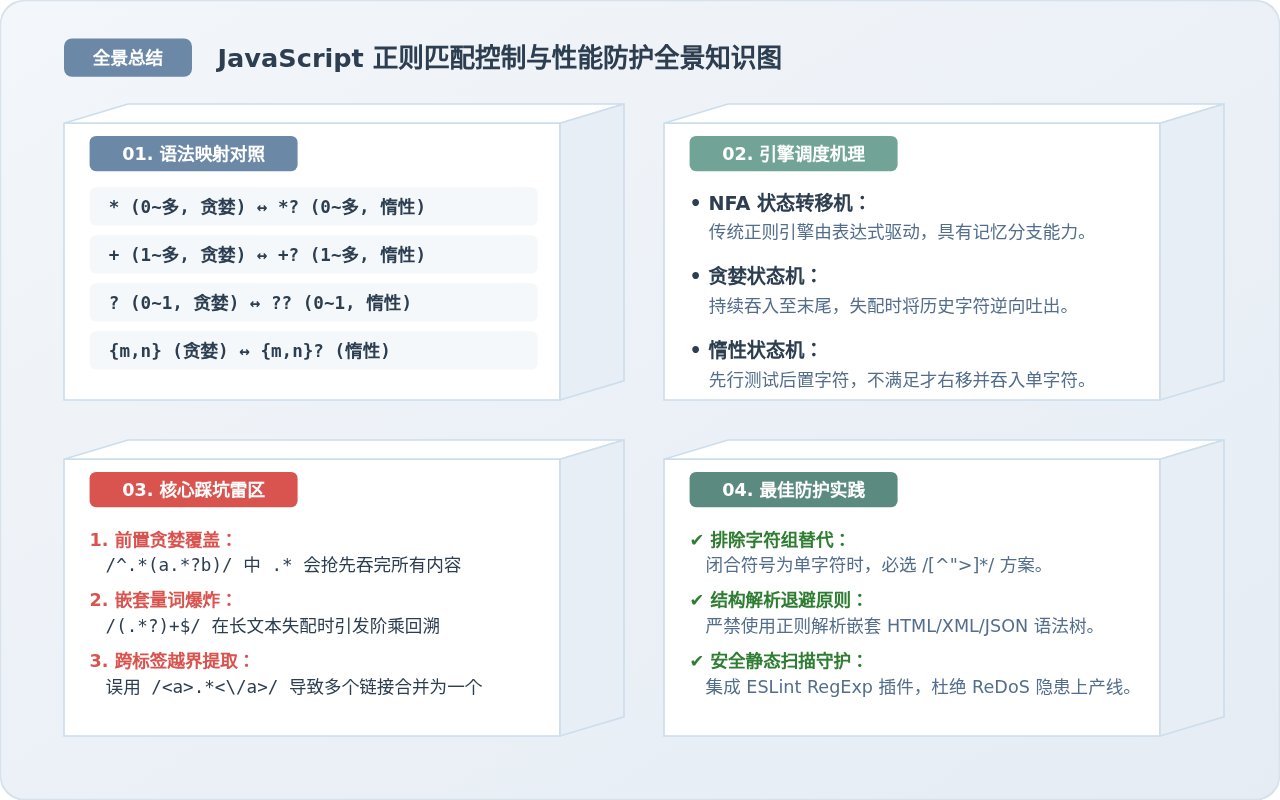
为了在团队协作与生产系统中规范正则表达式的编写,推荐落实以下四项防御准则:
- 定界符单字符时,必用排除型字符组:凡是提取
"..."、'...'、(...)或<...>,始终优先采用/[^"]*/、/[^>]*/等形式,从根源消除回溯。 - 绝不将量词嵌套置于同一分支:杜绝形如
/(a*)*?/、/(.*?)+/、/(.+?)*/的结构。如果必须处理重复子组,请确保各子项在字符集上严格互斥。 - 工程流水线集成安全检测:在 CI/CD 中引入
eslint-plugin-regexp,开启no-super-linear-backtracking与optimal-quantifier-concatenation规则,在代码审查阶段拦截潜在的性能炸弹。 - 解析树任务坚决让位给解析器:针对 HTML 采用
DOMParser或cheerio;针对复杂配置文件使用专用 AST 解析库。正则只适合处理规则明确的扁平片段匹配。
JS数组合并:concat与展开运算符(...)的用法及区别
2026-11-19 12:42:53
JS怎么实现对象深层属性的安全添加与合并
2026-11-19 09:23:08
JavaScript数组对比忽略顺序的实现方法
2026-11-19 08:50:38
JavaScript基础常见误区:undefined与null的区别
2026-11-18 23:27:33
JS处理科学计数法精度丢失的原因与解决
2026-11-18 21:15:48







