

JS处理科学计数法精度丢失的原因与解决
深入剖析 JavaScript 处理科学计数法与超长数值时产生精度丢失的底层机理,从 IEEE 754 双精度浮点标准到接口传输、类型解析、业务运算与视图展示,提供完备的全链路无损解决方案与实用代码。
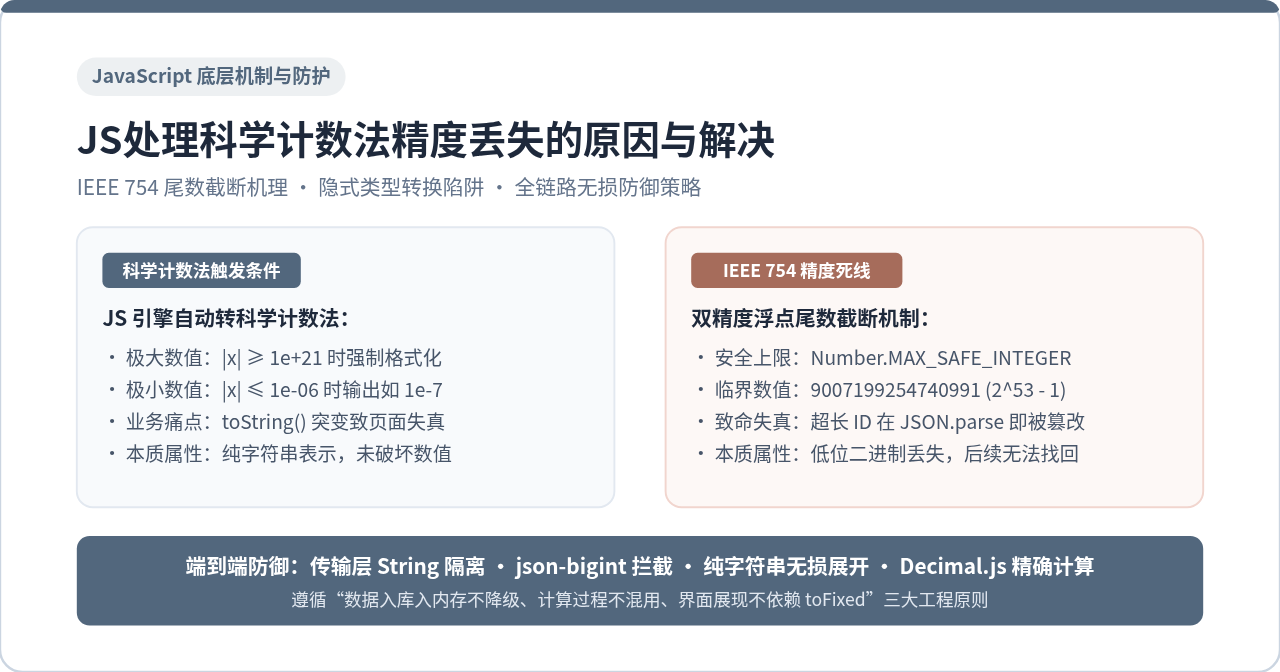
在 JavaScript 中,科学计数法与精度丢失往往是一对如影随形的并发现象。当数值绝对值达到 1e+21 以上或缩小至 1e-6 以下时,V8 等 JS 引擎会在序列化或打印时自动将其转换为形如 1.23e-7 的科学计数法;而在底层,由于原生 Number 遵循 IEEE 754 双精度 64 位浮点格式,其有效精度被硬性限制在 53 位二进制(约 15 至 17 位十进制有效数字),一旦超出 Number.MAX_SAFE_INTEGER,数据的低位就会在转换的瞬间被强行截断篡改。彻底解决科学计数法带来的精度问题,不能停留在事后使用 toFixed() 掩耳盗铃,而必须建立一套包含传输拦截、类型容器隔离、高精度运算和纯字符串无损展开的端到端工程防护体系。本文将深入拆解底层成因、排查流程与四种核心应对方案。
一、科学计数法与精度丢失的根本机制
很多开发者在控制台看到 1e-7 或者超长订单号末三位变成 000 时,第一反应往往是“显示出了 Bug”,试图用正则或字符串拼接把它修好。然而,这两个现象背后是两个完全不同维度的计算机原理,必须先厘清它们的本质差异。
1. 科学计数法的自动触发阈值
JavaScript 规范(ECMAScript 规范中的 Number.prototype.toString() 算法)对数字转为十进制字符串有明确的格式化规则。当一个数字转为字符串时:
- 微小浮点数:如果小数点后前导零达到 6 个及以上,即数值满足
0 < |x| <= 1e-6(如0.0000001),JS 引擎会自动以负指数科学计数法格式输出为1e-7。 - 极大数字:如果整数部分的位数超过 21 位,即数值满足
|x| >= 1e+21时,JS 引擎会自动以正指数科学计数法格式输出为1e+21。
这种纯粹因为引擎格式化规则而呈现的科学计数法,其底层数值本身并没有超出浮点数的表示范围,属于“假性丢失”——数值原本是准的,仅仅是打印或提交给表单时格式变成了科学计数法,导致后端校验失败或界面排版错乱。
2. IEEE 754 浮点标准的物理极限
真正的“致命损坏”源自 IEEE 754 双精度(64 位)浮点数的存储机理。在 V8 引擎中,每个常规数字占用 64 个二进制位:
- 1 位符号位(Sign):0 表示正数,1 表示负数。
- 11 位阶码位(Exponent):用于存放指数,偏移量为 1023。
- 52 位尾数位(Fraction / Mantissa):存放有效数字,配合规格化隐藏的最高位 1,实际有效精度为 53 位二进制数。
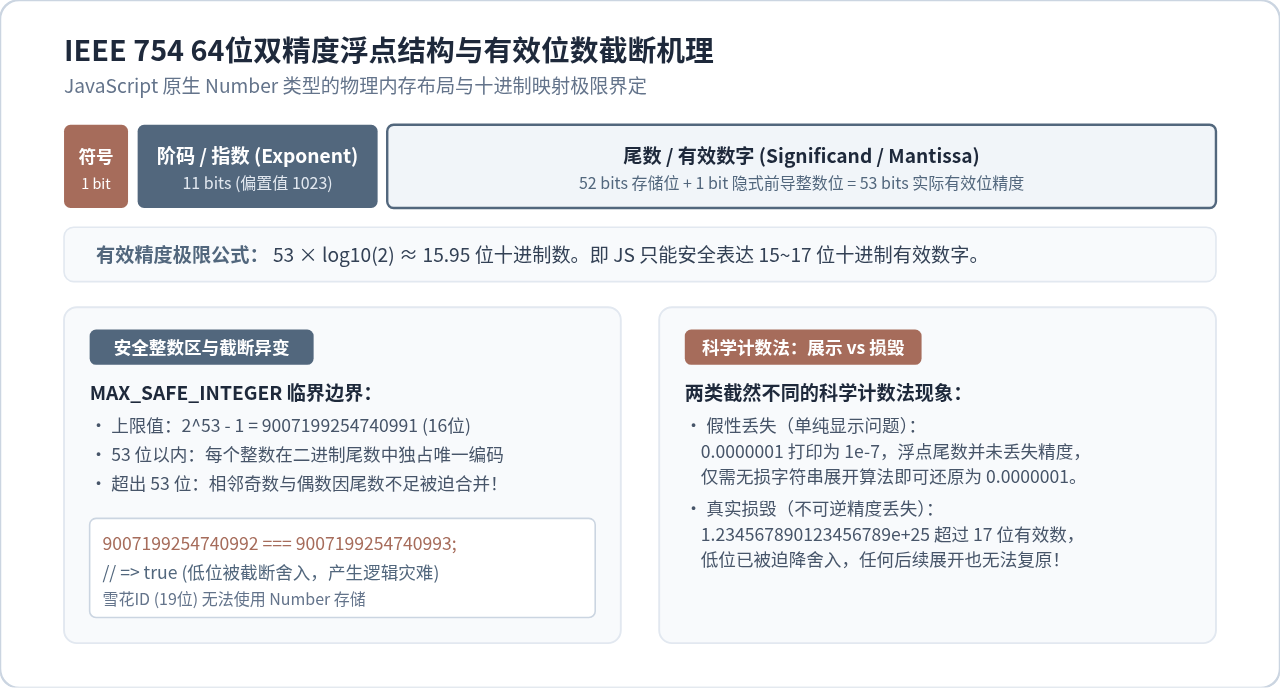
53 位二进制所能表达的最大无损整数即为著名的安全整数极限:2^53 - 1 = 9007199254740991(16位)。换算成十进制有效位数,53 × log10(2) ≈ 15.95 位。这意味着,无论是极大整数(例如 19 位的雪花算法 Snowflake ID:1789234891238912839),还是包含多位有效小数的高精度数值,一旦超过 16~17 位有效数字,第 53 位之后的二进制位就会被物理丢弃并执行临近舍入(Round to Nearest)。
关键警示:一旦一个超出 53 位的数值被当作 Number 解析进内存,低位信息就已被物理抹杀。此时即便后续调用任何格式化函数或转为字符串,得到的也只是被篡改后的数字(例如 1789234891238912839 会永久变成 1789234891238912800),无法无中生有地还原丢失的信息。
二、排查与定位:精度丢失究竟死在哪个环节?
在前后端交互的项目中,当出现科学计数法或数字末尾失真时,切忌盲目在页面代码中加转换。最关键的一步是顺着数据流向,定位精度丢失的确切发生点。
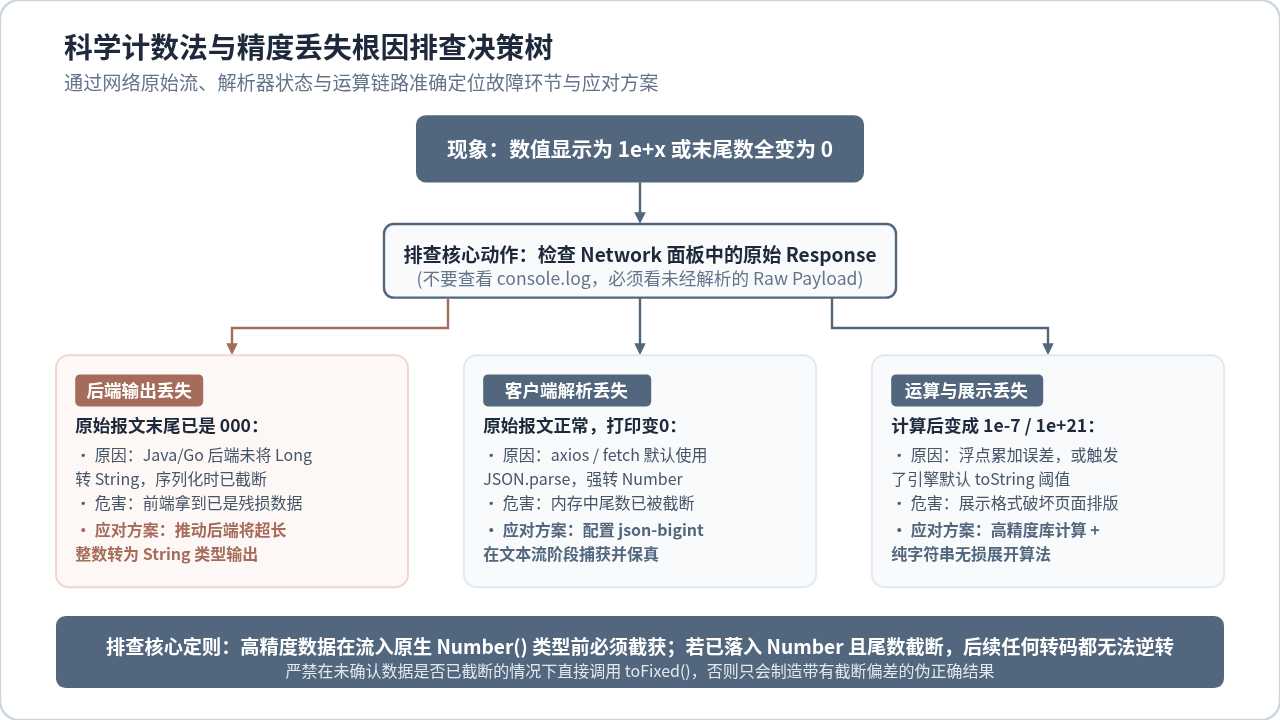
排查的第一动作永远是:打开浏览器开发者工具的 Network(网络)面板,找到对应的接口请求,查看未经任何脚本解析的“原始响应(Response)”字符串。注意:绝对不要在 Console 控制台打印对象查看,因为控制台展示的内容已经被前端运行时的 JSON.parse 污染过了。
- 情况 A(后端序列化损坏):Network 原始报文中,字段本身已经被截断(如
{"id": 1789234891238912800})或者直接输出了科学计数法{"amount": 1.5e+22}。这表明后端(Java/Go/Python 等)在序列化 JSON 文本之前,就已经将其作为浮点数或长整型强转导致截断。此情况前端无法自愈,必须要求后端在实体类注解中加上@JsonSerialize(using = ToStringSerializer.class)等转换器,以String格式输出。 - 情况 B(前端解析器损坏):Network 原始报文中是一个完整的 19 位数字
{"id": 1789234891238912839},但在 Axios 的response.data.id中变成了1789234891238912800。这是典型的JSON.parse默认将无引号的数字直接映射为Number造成的尾数迫降。此阶段必须在网络适配层拦截并接管反序列化过程。 - 情况 C(纯前端运算与格式化突变):数据进入前端时正常,但在经过连续加减乘除后变为了
1e-7或3.0000000000000004e-5,或者在表单提交需显式展示为普通十进制时变成了科学计数法。此阶段需要针对运算层替换高精度库,并在展示层使用纯字符串展开算法。
三、全链路无损解决方案与实用代码
理清了数据流向与损坏环节后,针对不同的业务应用场景,我们应当采取精准的分层应对策略。
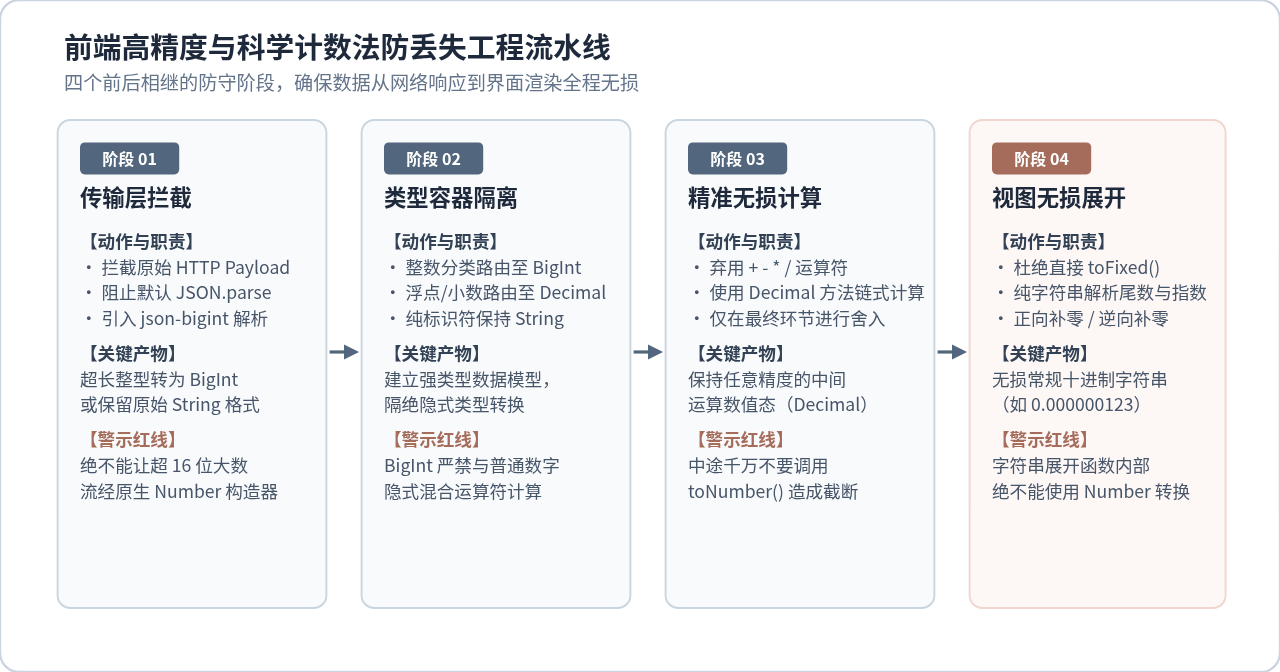
1. 传输层防护:使用 json-bigint 拦截接口大数
在主流的前端 HTTP 请求库(如 Axios)中,其内部默认使用浏览器内置的 JSON.parse 处理响应体。为了在超大整数被破坏前将其拯救,我们需要在 Axios 的 transformResponse 中介入,使用 json-bigint 将超过安全范围的数字直接解析为字符串或 BigInt。
import axios from 'axios';
import JSONBig from 'json-bigint';

// 配置 json-bigint:
// storeAsString: true 会将所有超出 IEEE 754 安全范围的数字无损保存为原生 JavaScript 字符串
const JSONBigString = JSONBig({ storeAsString: true });

const apiClient = axios.create({
  baseURL: '/api',
  // 必须在此处覆盖默认的 transformResponse,禁止执行原生 JSON.parse
  transformResponse: [
    function (data) {
      if (typeof data === 'string') {
        try {
          return JSONBigString.parse(data);
        } catch (err) {
          return data;
        }
      }
      return data;
    }
  ]
});

// 示例效果:
// 后端原始返回:{"orderId": 1789234891238912839, "status": "PAID"}
// 解析后对象:{"orderId": "1789234891238912839", "status": "PAID"}
// orderId 保持为纯字符串,完整保留所有 19 位有效数字,杜绝被转为科学计数法或截断为 00
2. 运算层防护:原生 BigInt 标准整数处理
如果业务场景仅涉及纯大整数(如 Snowflake ID 比较、加密哈希位移、区块链区块号运算),ECMAScript 2020 引入的原生 BigInt 是最轻量且完全零依赖的选择。
// 1. 创建 BigInt:在数字后追加 'n',或传入字符串
const id1 = BigInt("1789234891238912839");
const id2 = 1789234891238912839n;

// 2. 算术运算保持绝对精确
const nextId = id1 + 1n; // 1789234891238912840n

// 3. 陷阱与修复:BigInt 无法直接被 JSON.stringify 序列化
// 默认执行 JSON.stringify({ id: id1 }) 会抛出:TypeError: Do not know how to serialize a BigInt
// 工程化标准修复方案:为 BigInt.prototype 挂载 toJSON 方法
(BigInt.prototype as any).toJSON = function () {
  return this.toString();
};

console.log(JSON.stringify({ orderId: id1 }));
// 输出正常:{"orderId":"1789234891238912839"}注意:BigInt 不支持小数运算(小数会被直接向下截断取整),且不能直接与原生 Number 进行隐式加减(必须显式使用 BigInt(num) 或 Number(bigint) 转换,且后者有精度溢出风险)。对于带小数的高精度运算,必须选用下方的高精度数学库方案。
3. 展示层无损展开:纯字符串科学计数法展开算法
在报表渲染、输入框回填等场景中,后端或计算结果可能会给出一个科学计数法格式的数字(如 1.234567e-7 或 5.88e+23)。许多人尝试调用 num.toFixed(10),但这会引来两重灾难:一是 toFixed 最多支持 100 位,极大数直接抛异常;二是 toFixed 依赖底层浮点四舍五入,会产生诡异的末尾偏差。
下述算法完全基于纯文本解析与补零,绝不走 Number() 浮点转换路径,支持负数、正负指数以及任意精度的有效数字,保证绝对无损:
/**
 * 将任意数字或科学计数法字符串无损展开为普通十进制字符串
 * @param {number|string} value 需要转换的输入值
 * @returns {string} 展开后的常规十进制表示
 */
function toNonExponentialString(value) {
  if (value === null || value === undefined || value === '') return '';

  const str = String(value).trim();
  // 正则匹配科学计数法:符号、尾数整数位、尾数小数位、指数
  const expMatch = str.match(/^([+-]?)(\d+)(?:\.(\d+))?[eE]([+-]?\d+)$/);

  if (!expMatch) {
    // 非科学计数法,原样返回(包含常规数字与小数)
    return str;
  }

  const sign = expMatch[1] === '-' ? '-' : '';
  const integerPart = expMatch[2];
  const decimalPart = expMatch[3] || '';
  const exponent = parseInt(expMatch[4], 10);

  if (exponent === 0) {
    return decimalPart ? `${sign}${integerPart}.${decimalPart}` : `${sign}${integerPart}`;
  }

  if (exponent > 0) {
    // 正指数:小数点向右移动
    if (exponent >= decimalPart.length) {
      // 小数位数不足,向右补零
      const zeros = '0'.repeat(exponent - decimalPart.length);
      return `${sign}${integerPart}${decimalPart}${zeros}`;
    } else {
      // 小数点落在小数部分中间
      const intSegment = decimalPart.slice(0, exponent);
      const decSegment = decimalPart.slice(exponent);
      return `${sign}${integerPart}${intSegment}.${decSegment}`;
    }
  } else {
    // 负指数:小数点向左移动
    const absExp = Math.abs(exponent);
    if (absExp >= integerPart.length) {
      // 整数位数不足,向左补零
      const zeros = '0'.repeat(absExp - integerPart.length);
      const result = `0.${zeros}${integerPart}${decimalPart}`;
      return `${sign}${result}`;
    } else {
      // 小数点落在整数部分中间
      const splitIndex = integerPart.length - absExp;
      const intSegment = integerPart.slice(0, splitIndex);
      const decSegment = integerPart.slice(splitIndex);
      return `${sign}${intSegment}.${decSegment}${decimalPart}`;
    }
  }
}

// 验证用例(涵盖正负数、极大极小、含小数基数):
console.log(toNonExponentialString(1e-7));
// 输出: "0.0000001"

console.log(toNonExponentialString("1.23456789e-8"));
// 输出: "0.0000000123456789"

console.log(toNonExponentialString("-3.14159265358979323846e+10"));
// 输出: "-31415926535.8979323846"

console.log(toNonExponentialString("7e+22"));
// 输出: "70000000000000000000000"
4. 复杂浮点运算防护:decimal.js 工业级高精度计算
对于电商计价、汇率换算、复杂复利计算等涉及小数且严禁任何精度损耗的场景,推荐引入成熟的高精度库(如 decimal.js)。它的内部基于数组保存任意长度的大数,并提供了完备的四则运算、舍入模式与格式化 API。
import Decimal from 'decimal.js';

// 1. 全局配置精度与舍入模式
Decimal.set({
  precision: 40,            // 有效数字位数(远超 Number 的 16 位)
  rounding: Decimal.ROUND_HALF_UP, // 标准四舍五入
  toExpNeg: -30,            // 指数低于 -30 时才转换为科学计数法(默认 -7)
  toExpPos: 30             // 指数高于 30 时才转换为科学计数法(默认 20)
});

// 2. 避免使用 Number 传参,必须传入原始字符串!
const price = new Decimal("0.00000015");
const count = new Decimal("3");

// 3. 高精度链式运算
const total = price.times(count); // 0.00000045

// 4. 精确格式化输出
console.log(total.toFixed(8)); // "0.00000045"
console.log(total.toString()); // "0.00000045"(不再会被默认变为 4.5e-7)
四、方案选型与避坑指南
不同的技术路线在精度、运行时开销以及侵入性上各有取舍。在实际架构设计中,应当依据具体业务诉求合理组合。
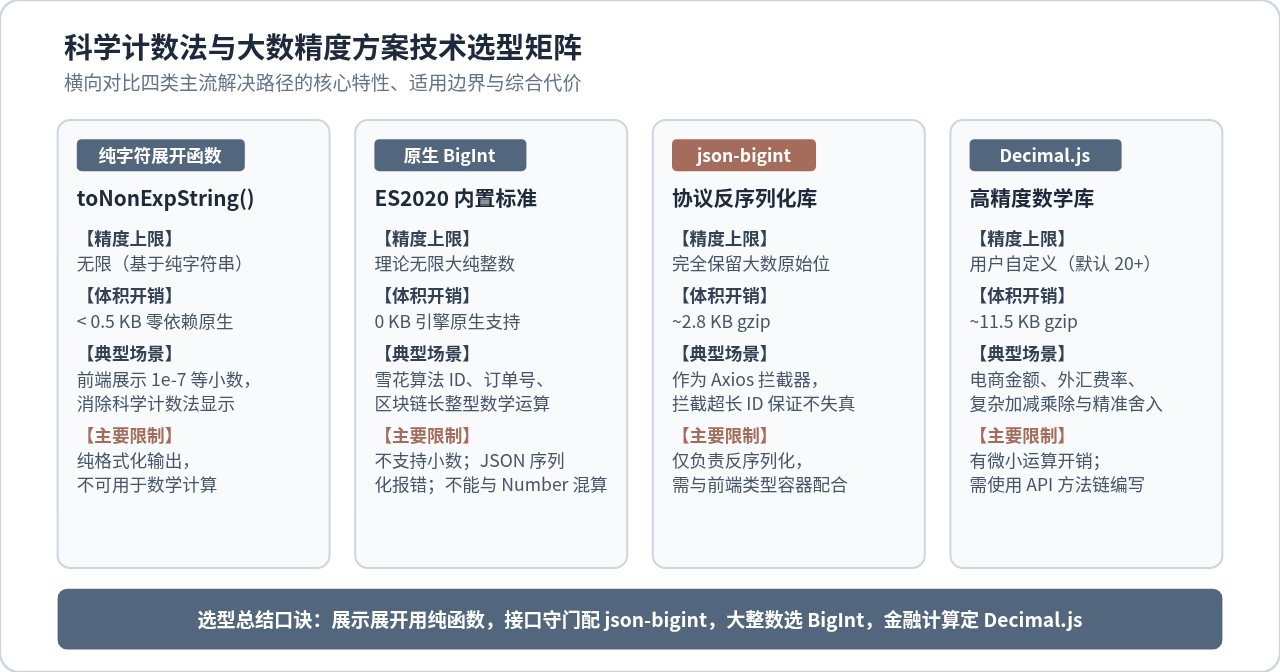
| 解决方案 | 精度支持 | 包体积开销 | 适用核心场景 | 工程注意点 |
|---|---|---|---|---|
| 纯字符串展开函数 | 无限精度 | < 0.5 KB(无依赖) | 表格/图表消除 1e-7 等科学计数法显示 | 纯文本处理,不具备加减乘除数学运算能力 |
| 原生 BigInt | 无限大整数 | 0 KB(ES2020内置) | 雪花 ID、订单编号、加密散列 | 完全不支持小数;需补充 toJSON 序列化补丁 |
| json-bigint | 反序列化无损 | ~2.8 KB gzip | Axios / Fetch 接口拦截超长长整型 | 需在网络层全局接管 transformResponse |
| Decimal.js | 任意位浮点 | ~11.5 KB gzip | 金融、外汇、科学计算、复利利息 | 禁止传入 Number 构造,必须始终传递原始 String |
日常开发三大高频误区
- 误区一:把
toFixed()当作消除科学计数法的万能钥匙。
toFixed()内部依然运行在 IEEE 754 浮点模型下,不仅会将1.005.toFixed(2)错误舍入为1.00,而且在面对大于1e+21的数字时,规范规定它依然会直接输出科学计数法。 - 误区二:在入参时使用
new Decimal(Number(str))。
如果字符串原本是"1789234891238912839",一旦包了一层Number(),传进 Decimal 构造函数时里面的值已经是截断后的1789234891238912800。高精度计算库必须直接接收纯字符串。 - 误区三:前后端只改前端。
若后端的数据库主键采用 64 位整型(如 MyBatis / Spring Boot 默认实体),后端输出 JSON 时若未配置@JsonFormat(shape = JsonFormat.Shape.STRING),报文自出网关的那一刻就已经失真,前端无法力挽狂澜。前后端契约统一为字符串传输是系统健壮性的根本基石。
五、工程落地自检清单
在涉及大数与精密计算的功能上线前,建议对照以下五项逐一自检:
- [ ] 接口报文核验:确认 Network 响应中,雪花 ID、交易流水号等超长整数均带有双引号(String 格式),或客户端已全局启用
json-bigint拦截。 - [ ] 数据入库隔离:Vuex / Pinia / Redux 等状态管理中,超大数值是否保持为字符串或
BigInt,严禁被组件层转换为Number。 - [ ] 序列化兼容:若使用
BigInt,确认已全局注入BigInt.prototype.toJSON,避免发送请求时抛出序列化异常。 - [ ] 纯字符展示:对于微小浮点数展示,是否统一使用了基于字符串位移补零的展开函数,排查是否残留未经保护的
toFixed()。 - [ ] 复杂计算收口:涉及计费的核心公式,是否全部收敛在
Decimal.js实例方法中,并且仅在渲染终点执行舍入截断。
JS数组map与forEach遍历赋值的区别与应用场景
2026-11-18 20:14:07
卫生间做防水用JS砂浆还是聚氨酯?优缺点对比
2026-11-18 19:46:50
JS中怎么根据条件批量修改数组元素?
2026-11-18 18:51:53
JS合并数组生成新数组:concat与展开运算符对比
2026-11-18 16:55:21
怎么解决jsPDF导出PDF图片模糊和样式错位问题
2026-11-18 16:00:34







