JS数组map与forEach遍历赋值的区别与应用场景
深入对比JavaScript中map与forEach在数组遍历赋值时的核心区别、底层内存机制、执行流程与典型应用场景,通过详尽示例解析原始类型与引用类型的赋值差异。
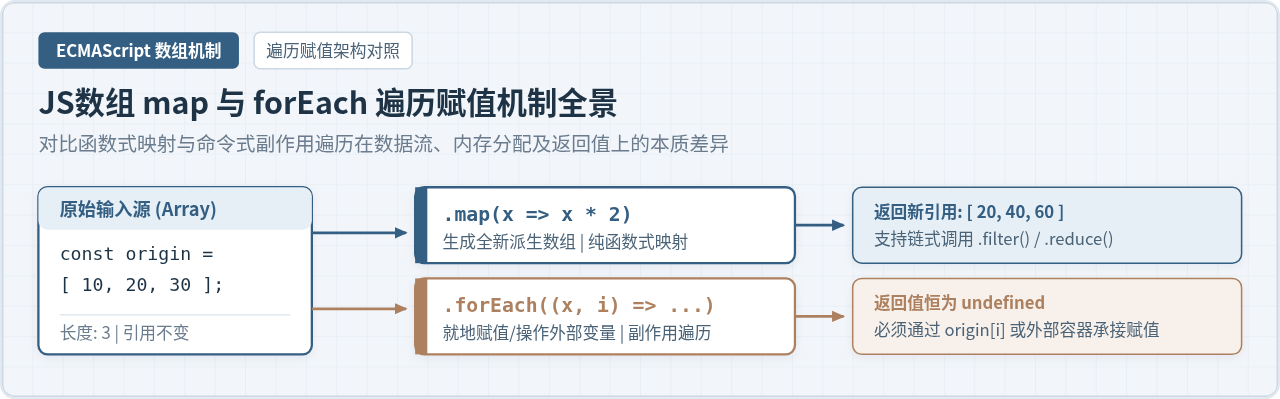
在 JavaScript 日常业务开发中,遍历数组并为变量或数组项赋值是一项高频操作。许多开发者在初学或快速编写代码时,常将 map 与 forEach 混淆使用,甚至误认为它们只是语法糖层面的微小差异。实际上,二者在底层执行逻辑、内存分配、返回值设计以及是否产生副作用上有着本质不同。如果需要基于原数组转换生成一个长度一致的新数组,不可变模式的 map 是标准解法;如果需要原地修改数组元素、向外部变量写入数据或执行包含赋值在内的副作用操作,则应当使用 forEach。理解它们的底层差异,能帮助开发者写出更清晰、高效且不易滋生隐蔽缺陷的高质量代码。
一、核心机制与返回值差异
理解两者区别的前提是厘清它们的本质定义与规范行为:
Array.prototype.map():纯函数式映射器。该方法会按顺序为原数组中的每个有效元素调用一次回调函数,并利用每次回调的返回值(return值)组合构造出一个与原数组长度完全相同的新数组。map不会修改调用它的原数组本身(前提是回调内没有刻意去修改原对象的属性)。Array.prototype.forEach():命令式迭代器。该方法单纯负责按顺序为数组中的每个有效元素执行提供的回调函数,其执行返回值固定恒为undefined。它本身不提供任何收集返回值的机制,所有赋值行为都必须依赖于在回调内部操作原数组项或修改外部闭包变量。
// 1. map 的标准赋值:直接承接返回值
const rawScores = [60, 75, 90];
const adjustedScores = rawScores.map(score => score + 5);
console.log(adjustedScores); // [65, 80, 95](全新数组)
console.log(rawScores);      // [60, 75, 90](原数组完全不受影响)

// 2. forEach 的错误赋值示例(试图接收返回值)
const badResult = rawScores.forEach(score => score + 5);
console.log(badResult);      // undefined!(forEach 不返回任何计算结果)
由于 forEach 始终返回 undefined,将其执行结果直接赋给变量是一种典型的语法误用。任何需要将结果承接为新变量的场景,首要考察的就是 map。
二、遍历赋值的内存机制与指针差异
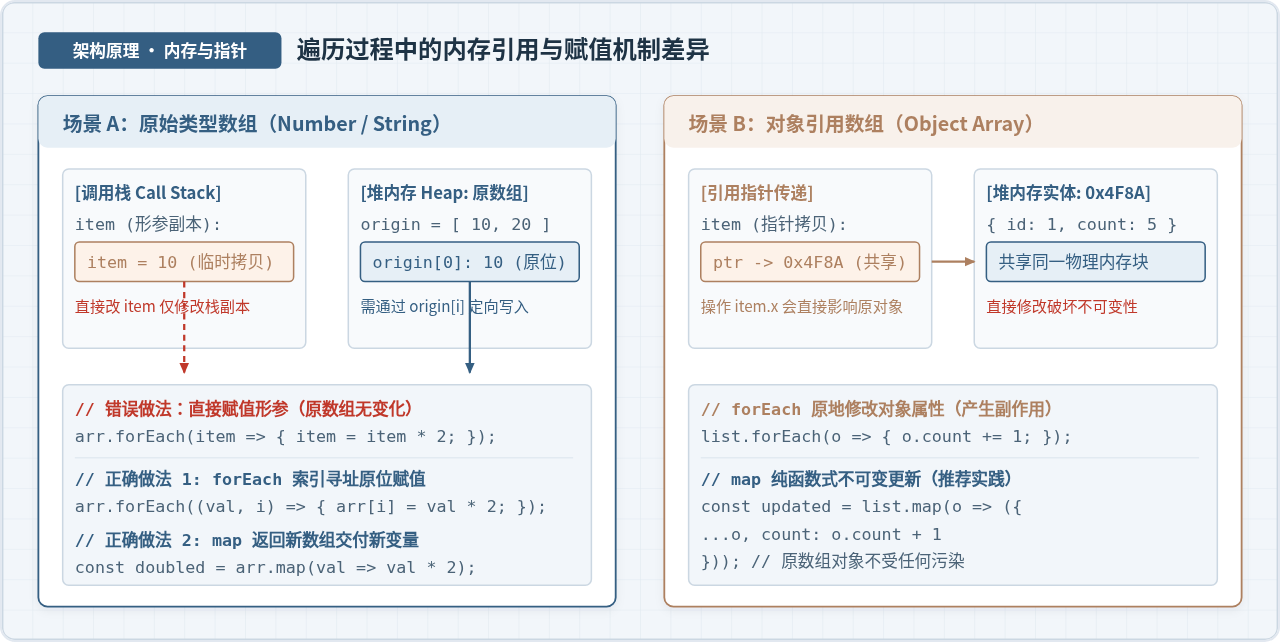
“遍历赋值”在实际开发中通常分为两种数据结构:原始类型数组(数字、字符串、布尔值)和引用类型数组(包含对象的数组)。在这两类数据结构中,map 与 forEach 的行为逻辑截然不同。
1. 原始类型数组的赋值陷阱
当数组元素为原始类型时,回调函数的第一个形参 item 接收到的只是当前元素的一个值副本(Value Copy)。在 forEach 内部直接对该形参执行重新赋值语句(如 item = 100),修改的仅仅是当前回调函数执行栈中的局部临时变量,完全无法触及堆内存中数组自身的真实槽位。
const numbers = [10, 20, 30];

// 【常见错误】:直接赋值形参
numbers.forEach(num => {
  num = num * 2; // 仅改变了局部变量 num,原数组毫无变化!
});
console.log(numbers); // [10, 20, 30](原地赋值失败)

// 【正确做法 A】:通过索引显式回写原数组(就地修改)
numbers.forEach((val, index, arr) => {
  arr[index] = val * 2;
});
console.log(numbers); // [20, 40, 60](原地赋值成功)

// 【正确做法 B】:使用 map 生成新数组
const doubled = numbers.map(val => val * 2);
console.log(doubled); // [40, 80, 120]
2. 引用类型数组的属性赋值与浅拷贝风险
当数组元素是对象或嵌套数组时,形参 item 获得的是指向堆内存中同一对象的引用指针(Reference Pointer)。此时,如果直接在 forEach 或 map 中修改 item.prop = newValue,哪怕是通过 map 赋予了新变量,原数组中的对象属性也已经被同步改变了。
const goodsList = [
  { id: 101, title: '键盘', stock: 10 },
  { id: 102, title: '鼠标', stock: 20 }
];

// 隐蔽缺陷:map 内部直接修改对象属性,破坏了不可变性
const mappedGoods = goodsList.map(item => {
  item.stock += 5; // 危险!直接篡改了堆中原对象的引用
  return item;
});
console.log(goodsList[0].stock); // 15!(原数组已被悄悄破坏)

// 推荐实践:利用对象解构浅拷贝返回全新对象引用
const safeGoods = goodsList.map(item => ({
  ...item,
  stock: item.stock + 5
}));
console.log(safeGoods[0].stock);  // 20
console.log(goodsList[0].stock); // 15(保持稳定)prev !== next)。若在 map 内部直接修改原对象属性,会导致组件判定数据引用未变,进而引发视图不更新或状态难以追溯的顽固缺陷。对对象数组使用 map 赋值时,务必返回浅拷贝后的新对象。
三、执行全流程与分流步骤
为了在工程层面精确把控两者的性能开销与运行细节,下图梳理了从原数组读取到赋值完成的生命周期步骤:
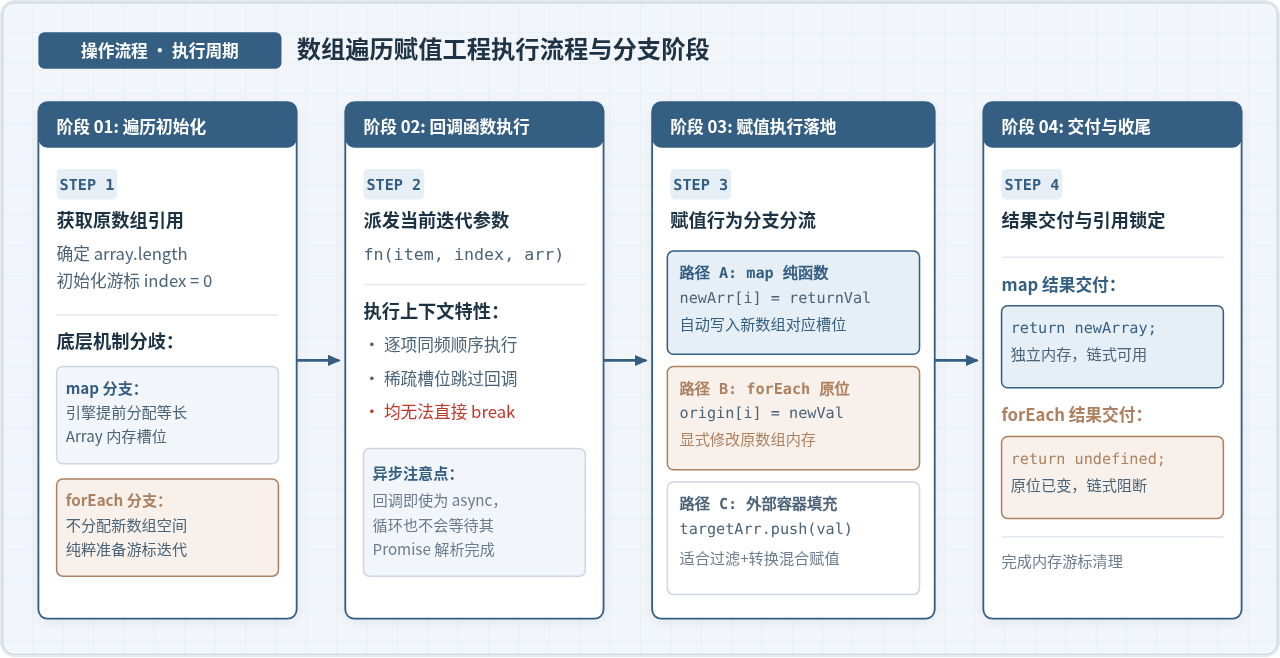
执行流程主要包含四个阶段:
- 遍历初始化(阶段 01):JavaScript 引擎锁定原数组长度并设置游标。
map在这一阶段会在底层预先开辟与原数组等长的线性连续内存槽;而forEach仅维护计数器,不预先申请目标数组内存。 - 回调函数分发(阶段 02):引擎按顺序针对每个有效索引槽位调用传入的回调函数,压入
(item, index, array)三个入参。注意:如果数组中存在未赋初值的空槽(即稀疏数组[1, , 3]),两者都会自动跳过空槽执行。 - 赋值执行落地(阶段 03):这是两者的核心分流点。
map自动收集回调函数的return表达式值并填入预设槽位;forEach则必须依赖用户编写的指令——要么通过arr[index] = val进行内存覆写,要么将结果push进外部初始化的容器中。 - 交付与收尾(阶段 04):
map锁定构建完毕的新数组并作为表达式返回值抛出;forEach执行完最后一次回调后返回undefined,等待垃圾回收销毁单次迭代栈帧。
四、四种典型遍历赋值模式与代码对比
根据实际开发场景,遍历赋值可以归纳为四种典型工程模式,各自对应不同的最佳选型:
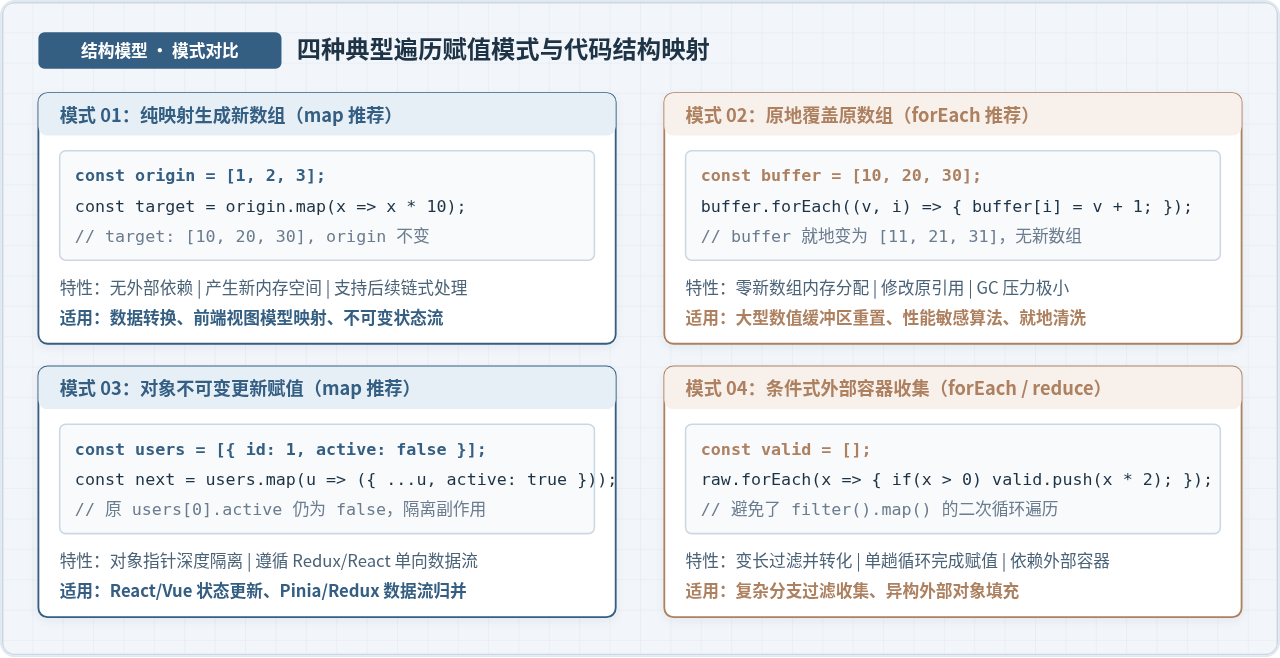
模式 1:声明式新数组生成(首选 map)
场景描述:原数组数据需要经过规则统一运算或结构转换,作为全新变量交付给后续逻辑使用,原数组保持只读。
// 典型应用:格式化接口数据以适配组件表格
const serverUsers = [
  { uid: 1, name: 'alice', role_id: 10 },
  { uid: 2, name: 'bob',   role_id: 20 }
];

const tableRows = serverUsers.map(user => ({
  key: user.uid,
  displayName: user.name.toUpperCase(),
  isAdmin: user.role_id === 10
}));
模式 2:原地索引覆盖赋值(首选 forEach)
场景描述:需要直接更新已有数组的元素,不允许开辟新数组(例如处理大型高频数据缓冲区、内存受限环境或需要维持全局单例数组引用的场合)。
// 典型应用:重置高频计数器数组
const metricsBuffer = [12.4, 45.1, 88.0, 31.6];

metricsBuffer.forEach((val, idx, arr) => {
  arr[idx] = Math.round(val); // 就地取整赋值,零新数组内存开销
});
console.log(metricsBuffer); // [12, 45, 88, 32]
模式 3:不可变对象更新赋值(首选 map + 解构浅拷贝)
场景描述:修改列表中的特定项目状态,同时保证其余项目和被修改项的不可变性。
// 典型应用:根据 ID 切换任务完成状态
const todos = [
  { id: 1, text: '编写单元测试', done: false },
  { id: 2, text: '更新文档',     done: false }
];

const targetId = 2;
const nextTodos = todos.map(todo => {
  if (todo.id !== targetId) return todo; // 保持旧引用
  return { ...todo, done: true };        // 返回包含新属性的新对象
});
模式 4:过滤并赋值合并(forEach 外部容器 vs 链式调用)
场景描述:并不是所有元素都需要赋值输出,只有满足条件的元素才转换并存入新容器。此时如果使用 map,不满足条件的项若无返回值会变成 undefined 占位,导致数组出现空洞。
const mixedData = [-5, 12, 0, 44, -3];

// 方案 A:使用 forEach + 外部容器 push(单次循环完成过滤与赋值)
const positiveDoubled = [];
mixedData.forEach(n => {
  if (n > 0) {
    positiveDoubled.push(n * 2);
  }
});

// 方案 B:函数式声明式(filter 过滤 + map 转换)
const declarativeResult = mixedData
  .filter(n => n > 0)
.map(n => n * 2);reduce,避免两次遍历带来的额外循环开销。
五、关键维度的深度对比
为了系统梳理 map 与 forEach 的全部差异,下表从语法意图、底层机制到工程限制进行了横向对比:
| 对比维度 | Array.prototype.map |
Array.prototype.forEach |
|---|---|---|
| 返回值 | 长度与原数组一致的全新数组 | 恒为 undefined |
| 赋值机制 | 依赖回调的 return 值自动填充新数组 |
依赖显式编写 arr[i] = ... 或外部容器赋值 |
| 原数组影响 | 默认不修改原数组(纯函数哲学) | 可通过第三参数或索引直接修改原数组(副作用) |
| 链式调用 | 支持(后续可继续接 .filter() / .reduce() 等) |
不支持(返回 undefined,链条立即中断) |
| 内存与 GC 压力 | 分配新数组内存空间,GC 开销相对较高 | 原地赋值时不额外分配数组内存,GC 压力极小 |
| 中断控制 (break) | 不支持(必须完整遍历全量元素) | 不支持(使用 return 仅跳过当前单次迭代) |
| 语义意图 | “将数据 A 转换为数据 B” | “针对每个元素执行某些具体操作” |
六、常见误区与排查方法
在实际代码审查(Code Review)中,经常能遇到以下四种与遍历赋值相关的典型错误:
误区 1:在不需要返回值时强行使用 map
某些开发者仅因为 map 语法简洁,就在回调内部仅执行日志打印或外部 API 调用,却不接收返回值:
// 【不良代码】:将 map 当作单纯的循环执行工具
users.map(user => {
  sendAnalyticsEvent(user.id);
});排查与危害:此时 JavaScript 引擎仍然会在内存中默默开辟一个等长的新数组并填充为 [undefined, undefined, ...],随后由于未被引用又交给垃圾回收器清理。这不仅浪费了 CPU 和内存资源,还会向阅读代码的维护者传递“此操作需要产生新数据”的错误信号。凡是仅执行副作用的操作,均应坚决改用 forEach 或 for...of。
误区 2:在 map 回调中遗漏 return
当使用大括号 { ... } 编写多行 map 逻辑时,极易忘记显式写出 return 语句:
// 【致命错误】:丢失 return
const processed = list.map(item => {
  const newVal = item.val * 2;
  // 缺少 return newVal;
});
console.log(processed); // [undefined, undefined, ...]排查与修复:检查控制台中新数组元素是否全为 undefined。如果是简短转换表达式,可直接使用单行箭头函数的隐式返回语法(如 list.map(item => item.val * 2))。
误区 3:试图通过 return false 中断遍历
在常规 for 循环中,可以使用 break 提前跳出遍历。但在 map 和 forEach 的回调函数中,return 仅仅相当于普通循环中的 continue(即结束当前这一轮函数的执行,紧接着执行下一轮):
const list = [1, 2, 3, 4, 5];

list.forEach(num => {
  if (num === 3) return; // 无法中断!仅跳过 3,后续 4 和 5 依然会继续执行
  console.log(num);
});
// 输出: 1, 2, 4, 5排查与修复:一旦遍历过程中存在“满足条件立即停止整个循环并完成赋值”的需求,请直接换用支持 break 的 for...of 循环,或者使用具有短路特性的数组方法 some() / every()。
七、选型决策指南与总结
为了帮助你在面对具体遍历赋值需求时能够在一秒钟内做出正确的 API 选型,请参考下面的选型决策树:
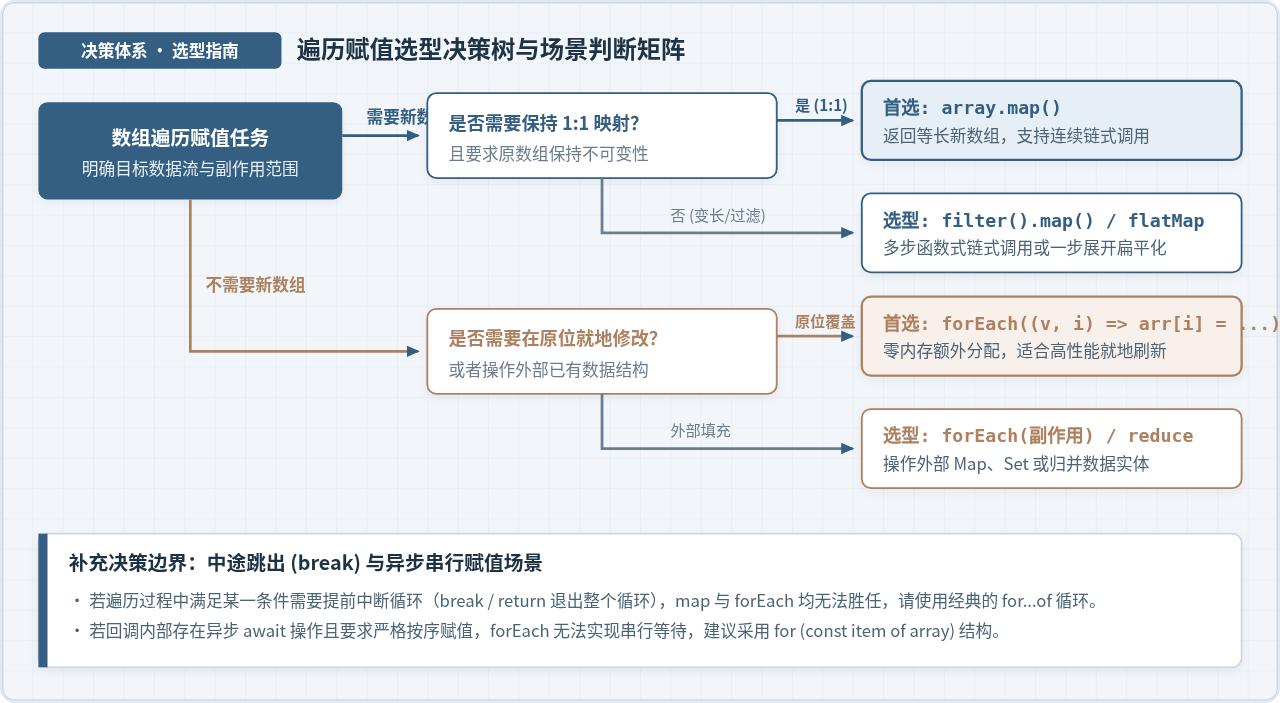
总结选型判定规则如下:
- 只要目标是获得一个转换后的新数组,且原数组需保持不变,坚决使用
map。 - 需要在数组上连续组合过滤、排序或汇总操作(如
.filter().map().sort()),必须使用map维持链式调用通道。 - 必须在原数组上直接修改元素以节省内存,或者仅需要遍历执行外部赋值、写库、触发事件等副作用,使用
forEach。 - 遍历过程中需要依据特定条件提前终止循环(
break),或者回调涉及严格按序执行的异步await时,不要使用map或forEach,而应当使用原生的for (const item of array)循环。
卫生间做防水用JS砂浆还是聚氨酯?优缺点对比
2026-11-18 19:46:50
JS中怎么根据条件批量修改数组元素?
2026-11-18 18:51:53
JS合并数组生成新数组:concat与展开运算符对比
2026-11-18 16:55:21
怎么解决jsPDF导出PDF图片模糊和样式错位问题
2026-11-18 16:00:34
JS业务场景中何时使用alert、confirm或自定义弹窗
2026-11-18 14:46:10