JavaScript原型链继承的工作原理与属性查找机制
深入剖析 JavaScript 原型链继承的工作原理与属性查找机制。详细讲解构造函数、原型对象与实例对象的三角关系,属性读取时的原型链回溯算法与写入时的属性遮蔽机理,并对比经典继承演进方案与工程实战避坑技巧。
JavaScript 并非基于类模板的拷贝式继承,而是采用对象间的隐式原型委托机制(Prototypal Delegation)。每个对象内部均存在一个指向其原型的内置隐式指针 [[Prototype]],由多层指针串联而成的单向单链表即为原型链(Prototype Chain)。在执行属性读取时,引擎先检查对象自身,若未命中则沿着原型链逐层向上回溯,直到找到目标属性或遍历至链路终点 null;而在写入非只读属性时,引擎默认就地在当前对象创建自有属性并形成属性遮蔽(Property Shadowing),不会擅自修改原型对象。掌握原型拓扑与查找算法,是厘清实例复用、避免全实例原型污染及理解现代 ES6 继承本质的核心基石。
一、原型链的物理拓扑:构造函数、原型对象与实例
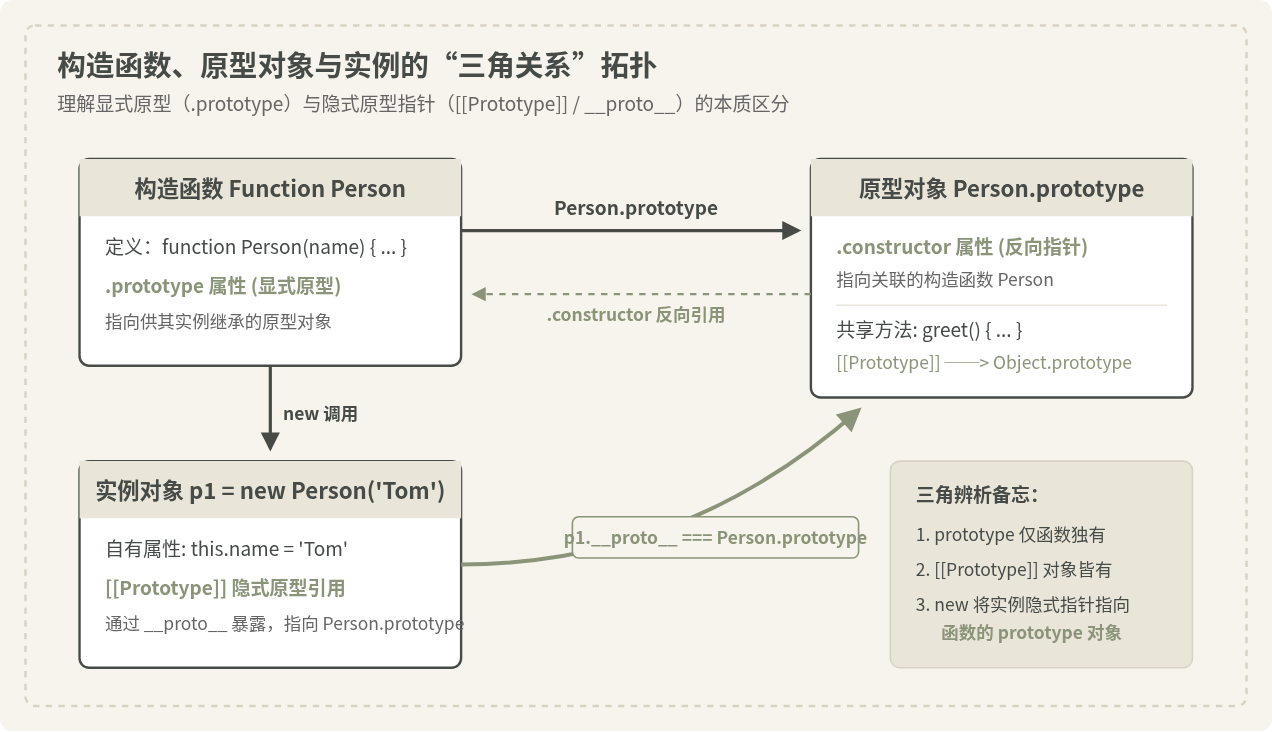
在传统基于类的面向对象语言(如 Java、C++)中,类是用来创建对象的代码模板,实例化过程相当于按照图纸将字段与方法完整“复制”一份到全新的内存堆中。但 JavaScript 设计之初并未引入类实体的物理隔离,而是通过普通对象之间的直接链接来实现能力共享。要理解这条链路的形成,首先需要厘清构造函数、原型对象与实例对象之间的“三角协作机制”。
1. 关键角色的职能分工
-
构造函数(Constructor Function):任何普通的函数只要通过
new操作符调用,便承担构造函数角色。函数在被声明时,JavaScript 引擎会默认赋予其一个名为prototype的显式属性。 -
显式原型(
Function.prototype):该属性是一个普通对象,其设计目的在于存放由该构造函数创建的所有实例共享的方法与公共属性。原型对象默认包含一个constructor属性,反向指向该构造函数。 -
实例对象(Instance):通过
new Constructor()运算返回的新对象。实例本身并不拥有prototype属性,但它拥有一条内部隐式链接[[Prototype]](浏览器中通过__proto__访问器属性暴露,标准推荐通过Object.getPrototypeOf()获取),该指针在实例化时被自动指向构造函数的prototype对象。
2. new 运算符在内存中的执行步骤
很多人误以为 new 将类的方法深拷贝到了实例中,实际上它的底层运行机制极为轻量,仅包含以下四个确定步骤:
- 在内存中开辟空间,创建一个全新的空对象
obj = {}。 - 将该新对象的内部隐式指针指向构造函数的原型对象:
obj.[[Prototype]] = Constructor.prototype。 - 将构造函数内部的执行上下文
this绑定到新创建的obj,并执行构造函数体内部代码,为实例赋予自有属性。 - 检查构造函数的返回值:如果构造函数显式返回了一个非原始类型的对象,则返回该对象;否则返回步骤 1 中创建的新对象
obj。
function Person(name, age) {
  this.name = name; // 实例自有属性 (Own Property)
  this.age = age;
}

// 在原型对象上定义公共方法,所有实例复用同一份函数引用
Person.prototype.greet = function() {
  return `你好,我是 ${this.name}`;
};

const alice = new Person("Alice", 20);

console.log(alice.name); // 示例输出: "Alice"(自有属性)
console.log(alice.greet()); // 示例输出: "你好,我是 Alice"(沿着原型链寻址找到原型方法)
console.log(Object.getPrototypeOf(alice) === Person.prototype); // 示例输出: true
console.log(Person.prototype.constructor === Person); // 示例输出: true
3. 链路终点:Object.prototype 与 null
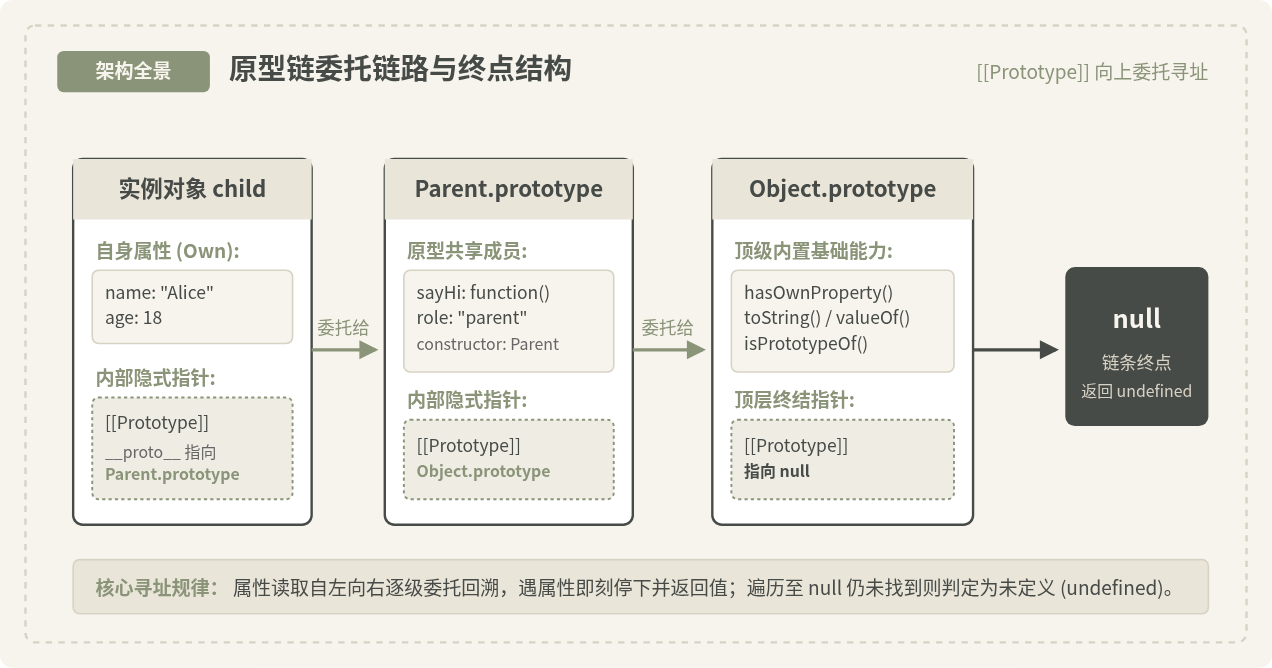
由于 Person.prototype 本身也是一个普通对象,因此它同样具备内部指针 [[Prototype]]。默认情况下,普通对象的原型指针直接指向 JavaScript 内置的顶层原型对象 Object.prototype。
而在 Object.prototype 对象中,定义了所有 JavaScript 对象通用的基础方法,例如 hasOwnProperty()、toString()、valueOf() 等。那么顶层原型的上层是什么?根据 ECMAScript 规范定义,Object.prototype.[[Prototype]] 的值严格等于 null。
null 在规范语义中代表“原型指针的虚无与终点”。原型链本质上是一条以实例为起点、通过 [[Prototype]] 逐级递升、最终以 null 封顶的单向引用链表。
二、属性查找机制与属性遮蔽机理
原型链在运行时的核心价值,在于处理属性访问表达式(例如 obj.foo 或 obj.bar())。在 ECMAScript 规范中,属性的“读取(Get)”与“写入(Put/Set)”遵循完全不同的算法路线,许多开发中的难以察觉的问题正是由于混淆了这两者的逻辑差异。
1. 读取属性(Get)的递归回溯算法
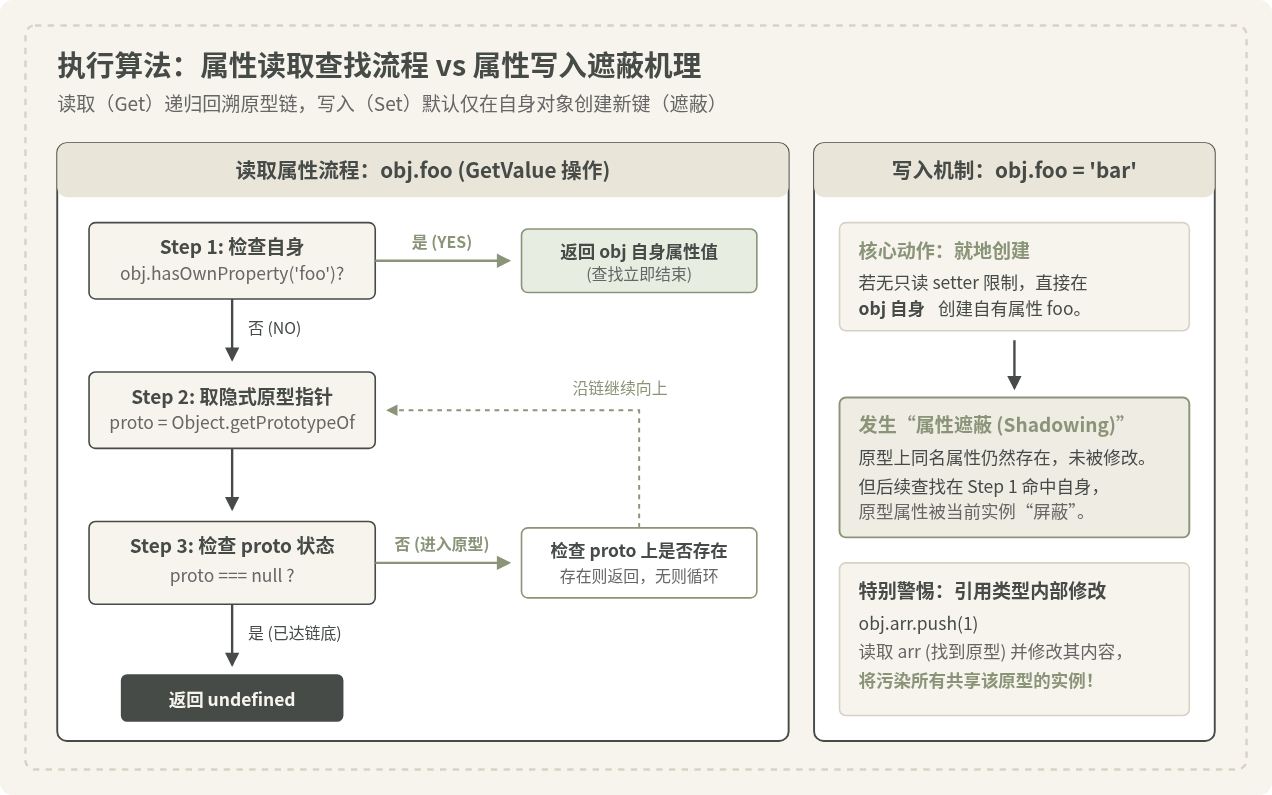
当代码尝试通过 obj.propertyName 读取某个属性的值时,运行时引擎内部会触发 [[Get]] 内部方法,其查找步骤如下:
-
步骤 1(检查自身):首先在
obj对象自身的自有属性集合中搜索是否存在名为propertyName的属性。如果存在,则直接返回其对应的值,查找过程在此处立即结束。 -
步骤 2(检查原型指针):如果自身不存在该属性,引擎获取该对象内部的隐式原型指针
Object.getPrototypeOf(obj)。 -
步骤 3(判定终点与回溯):
- 如果原型指针为
null,表明整条原型链已经遍历穷尽且未命中目标,查找结束,返回undefined。 - 如果原型指针指向一个有效的上级原型对象,则将当前查找指针切换至该原型对象,回到步骤 1 对该原型对象执行相同的检查逻辑。
- 如果原型指针为
const parent = {
  skinColor: "wheat",
  greet: function() { return "Hello from Parent"; }
};

const child = Object.create(parent); // child.[[Prototype]] 指向 parent
child.name = "Bob"; // 自有属性

// 查找链路推导:
// 1. child.name -> 自身命中,输出 "Bob"
// 2. child.skinColor -> 自身无 -> 原型 parent 命中,输出 "wheat"
// 3. child.toString -> 自身无 -> parent 无 -> Object.prototype 命中,输出函数
// 4. child.nonExistent -> 自身无 -> parent 无 -> Object.prototype 无 -> 到达 null,输出 undefined
console.log(child.name);        // 示例输出: "Bob"
console.log(child.skinColor);   // 示例输出: "wheat"
console.log(child.toString);    // 示例输出: [Function: toString]
console.log(child.nonExistent); // 示例输出: undefined
2. 写入属性(Set)与“属性遮蔽(Property Shadowing)”
与读取操作层层穿透不同,通过 obj.propertyName = value 进行普通赋值时,在不存在 setter 访问器的情况下,赋值操作总是作用在当前接收者对象(Receiver)自身上。
如果原型链的上游对象已经存在名为 propertyName 的属性,执行 obj.propertyName = value 并不会跨层去修改原型对象中的该属性,而是在 obj 自身直接新增一个同名的自有属性。
由于后续读取该属性时,步骤 1 会在自身对象上直接命中,导致原型链更上层的同名属性被“屏蔽隐藏”。这种现象在规范中称为属性遮蔽(Property Shadowing)。
const proto = { count: 10 };
const inst = Object.create(proto);

console.log(inst.count); // 示例输出: 10 (来自 proto)
console.log(inst.hasOwnProperty("count")); // 示例输出: false

// 触发写入:仅在 inst 自身新建属性,不会修改 proto.count
inst.count = 99;

console.log(inst.count); // 示例输出: 99 (发生遮蔽,命中自有属性)
console.log(inst.hasOwnProperty("count")); // 示例输出: true
console.log(proto.count); // 示例输出: 10 (上层原型属性毫发无损)

// 删除自有属性后,遮蔽解除,底层的原型属性重新暴露
delete inst.count;
console.log(inst.count); // 示例输出: 10 (再次读取到 proto)初学者极易产生一个严重误区:“既然赋值是就地创建属性,那么原型上的属性绝对安全”。这只对直接赋值表达式成立。
如果原型上存放的是一个引用类型(例如数组或普通对象),而你使用的是 obj.tags.push("JavaScript"),此时代码的执行实质是“先执行 Get 读取 tags,再对找到的同一个数组执行变异方法”。这会导致所有派生自该原型的实例的 tags 发生连带变化,从而引发极其隐蔽的原型污染 Bug。
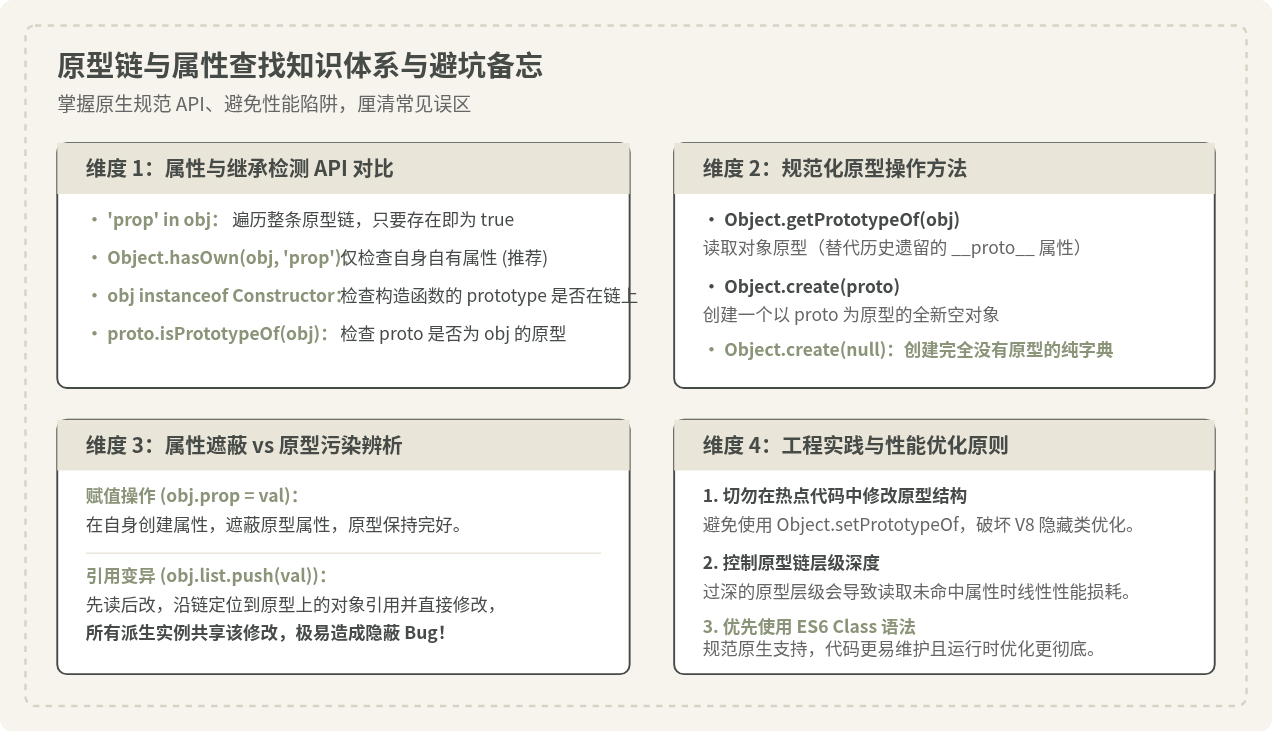
3. 判定属性归属的标准 API 对比
| 判断方式 | 检查范围 | 是否穿透原型链 | 推荐使用场景 |
|---|---|---|---|
prop in obj |
自身属性 + 原型链所有属性 | 是(沿链查找直至 null) | 确认对象及其继承体系中是否具备某能力或属性 |
Object.hasOwn(obj, prop)(ES2022+ 标准) |
仅限当前对象自身 | 否(仅查自有属性) | 最推荐的自有属性判定,不会因原型重写而失效 |
obj.hasOwnProperty(prop) |
仅限当前对象自身 | 否(仅查自有属性) | 历史项目常见,但在 Object.create(null) 对象上调用会报 TypeError |
instanceof 运算符 |
构造函数的 prototype |
是(检查原型对象是否在实例链上) | 判断对象是否属于某一构造函数的派生体系 |
三、继承实现模式的演进与标准实现
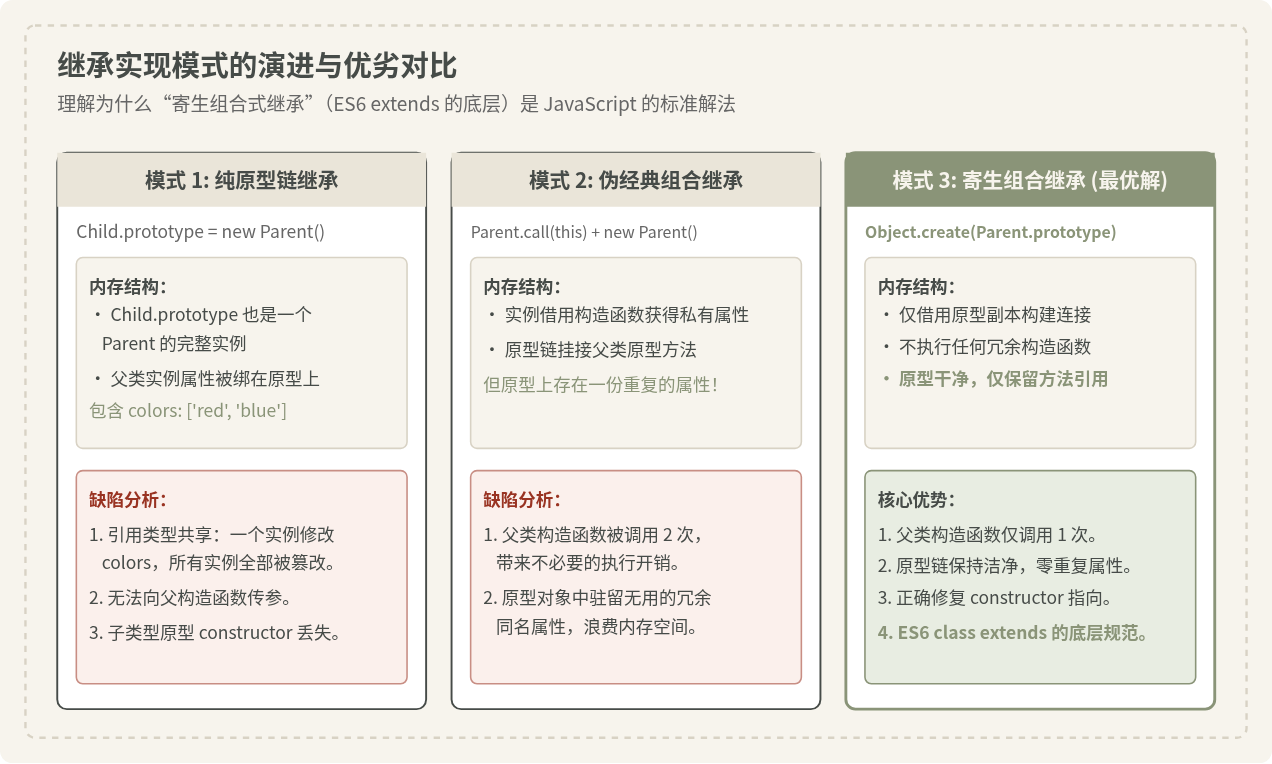
在 JavaScript 发展过程中,开发者们探索了多种建立原型链的方式。通过对比这些方案的内存分布与优劣,可以清晰看到现代继承设计的演进脉络。
1. 模式一:纯原型链继承(反面模式)
早期最简单的写法是将子类的原型直接赋值为父类的新实例:Child.prototype = new Parent()。
function Parent() {
  this.colors = ["red", "green"];
}
function Child() {}

// 将子类原型指向父类实例
Child.prototype = new Parent();

const c1 = new Child();
const c2 = new Child();

c1.colors.push("blue"); // 通过引用直接修改原型上的数组
console.log(c2.colors); // 示例输出: ["red", "green", "blue"] —— c2 的数据被意外篡改!致命缺陷:父类实例属性变成了子类原型上的共享属性。所有子类实例共同持有一个数组引用,一旦一个实例变异该引用,其余所有实例全被影响;此外,在创建子类实例时无法向父类构造函数传参。
2. 模式二:经典组合继承(伪经典模式)
为解决引用共享与传参问题,开发者提出了“借用构造函数 + 原型链挂接”的组合继承:
function Parent(name) {
  this.name = name;
  this.colors = ["red", "green"];
}
Parent.prototype.sayName = function() {
  return this.name;
};

function Child(name, age) {
  Parent.call(this, name); // 第一次调用父构造函数:继承自有属性并支持传参
  this.age = age;
}

Child.prototype = new Parent(); // 第二次调用父构造函数:构建原型链接
Child.prototype.constructor = Child; // 修复丢失的构造函数反向指针
缺陷分析:父类构造函数被执行了两次。这导致 Child.prototype 原型对象上存在一份冗余的 name 和 colors 属性,虽然实例的自有属性会将其遮蔽,但在内存中造成了不必要的浪费与脏数据残留。
3. 模式三:寄生组合式继承(规范公认的最优解)
寄生组合继承的思想极其纯粹:既然我们只需要链接到父类的原型,为什么非要实例化一次父类?通过 Object.create() 创建一个空对象,其原型直接指向 Parent.prototype 即可。
/**
 * 标准寄生组合式继承实现工具函数
 * @param {Function} subType 子类构造函数
 * @param {Function} superType 父类构造函数
 */
function inheritPrototype(subType, superType) {
  // 1. 创建父类原型的一个纯净空副本,不执行 superType 构造函数体
  const prototype = Object.create(superType.prototype);

  // 2. 修复 constructor 指针,避免实例的原型构造器反向索引错乱
  prototype.constructor = subType;

  // 3. 将新创建的洁净原型赋予子类的 prototype 属性
  subType.prototype = prototype;
}

// --- 实际使用示例 ---
function Parent(name) {
  this.name = name;
  this.tags = ["code"];
}
Parent.prototype.eat = function() {
  return `${this.name} is eating`;
};

function Child(name, score) {
  Parent.call(this, name); // 仅在子类实例化时调用一次父构造函数
  this.score = score;
}

// 挂接纯净的原型链
inheritPrototype(Child, Parent);

Child.prototype.study = function() {
  return `${this.name} got ${this.score} marks`;
};

const s1 = new Child("Tom", 95);
const s2 = new Child("Jerry", 88);

s1.tags.push("design");
console.log(s1.tags); // 示例输出: ["code", "design"]
console.log(s2.tags); // 示例输出: ["code"] (相互独立,零污染)
console.log(s1 instanceof Child);  // 示例输出: true
console.log(s1 instanceof Parent); // 示例输出: true
4. ES6 class 与 extends 的底层真相
ES6 引入的 class 与 extends 关键字,在 JavaScript 引擎中并不是引入了新的对象模型,而是一层极其精细的语法糖。其在底层所做的工作正是寄生组合式继承,并在原型链上多做了一层构造函数之间的静态继承链接:
- 实例方法链:
SubClass.prototype.[[Prototype]] === SuperClass.prototype(负责实例方法向上查找)。 - 静态方法链:
SubClass.[[Prototype]] === SuperClass(使得子类可以直接调用父类的静态静态方法,如SubClass.staticMethod())。 - 必须在子类构造函数中首先调用
super(),因为 ES6 类的实例首先由父类构造函数创建(赋予this),再由子类构造函数修饰。
四、高频认知误区辨析与工程避坑总结
在前端开发与源码阅读中,原型链也是最容易出现隐晦认知偏差的领域。以下结合具体现象进行客观剖析:
1. 误区一:“原型继承就是对象间的深度复制”
剖析:这种说法完全错误。原型链继承是引用绑定而非值复制。原型对象在内存中始终只有一份。
这意味着原型具备“动态热更新特性”:如果在代码运行后动态向 Parent.prototype 上挂载新方法,所有在此之前已经实例化的旧对象,在调用该方法时依然能够立即生效,因为它们保存的只是指向原型的内存地址。
2. 误区二:“__proto__ 与 prototype 含义相同,可以随意混用”
剖析:两者在作用和宿主上有着严格界限:
prototype是只有函数(Function)才拥有的显式属性(箭头函数除外),它用于指定通过该函数作为构造器所生成的实例对象的原型。[[Prototype]]是所有普通对象(包括函数、数组、普通字面量)都拥有的隐式内部槽。历史遗留的__proto__只是Object.prototype暴露的一个访问器属性。在生产环境中,严禁直接使用obj.__proto__,应统一使用规范的Object.getPrototypeOf(obj)。
3. 误区三:“运行时可以随意通过 Object.setPrototypeOf 动态改变原型”
剖析:从技术规范上说可以,但在工程实践中属于严重反模式。
主流 JavaScript 引擎(如 V8)高度依赖隐藏类(Hidden Class)与内联缓存(Inline Cache, IC)来优化属性查找速度。动态修改一个现有对象的原型链会直接导致该对象及其派生链路上的所有优化缓存全部失效(De-optimization),使属性访问退化为低效的哈希字典查找。如果需要特定原型,务必在对象创建之初使用 Object.create(proto) 或构造函数确定。
4. 实践技巧:如何创建纯净无污染的字典对象
在实现哈希映射、缓存表或事件总线时,常规字面量 const map = {} 会默认继承 Object.prototype 上的 toString、valueOf、constructor 等属性,极易被恶意输入触发原型属性污染或判断失误。
// 极其安全的高性能纯字典:完全切断原型链
const pureMap = Object.create(null);

console.log(pureMap.toString); // 示例输出: undefined
console.log(Object.getPrototypeOf(pureMap)); // 示例输出: null

// 此时 pureMap 不受任何顶层 Object 属性干扰,用作键值存储绝对干净
pureMap["key"] = "value";JS Fetch API上传头像及错误处理最佳实践
2026-11-19 12:34:05
JavaScript组合继承怎么实现且避免父类构造函数执行两次
2026-11-19 12:01:52
ES6模板字符串简化JS日期拼接:一行代码实现日期转字符串
2026-11-19 11:24:24
JS怎么正确初始化二维或多维数组
2026-11-19 09:38:01
JS使用[...str]展开运算符遍历含Emoji的字符串
2026-11-18 19:20:39