Node.js 中使用 http 模块发起 HTTP 请求
深入讲解在 Node.js 中使用内置 http 模块发起 HTTP 请求的完整方法,涵盖 GET/POST 请求流程、流式数据处理、请求头计算、超时控制与异常排查等核心工程实践。
http 模块发起 HTTP 请求是最纯粹、可靠的解决方案。本文将围绕原生 http 模块的流式通信机制,完整拆解发起 GET 与 POST 请求的操作步骤、请求体精确构造、响应流安全解析,以及超时与异常处理的核心工程实践。
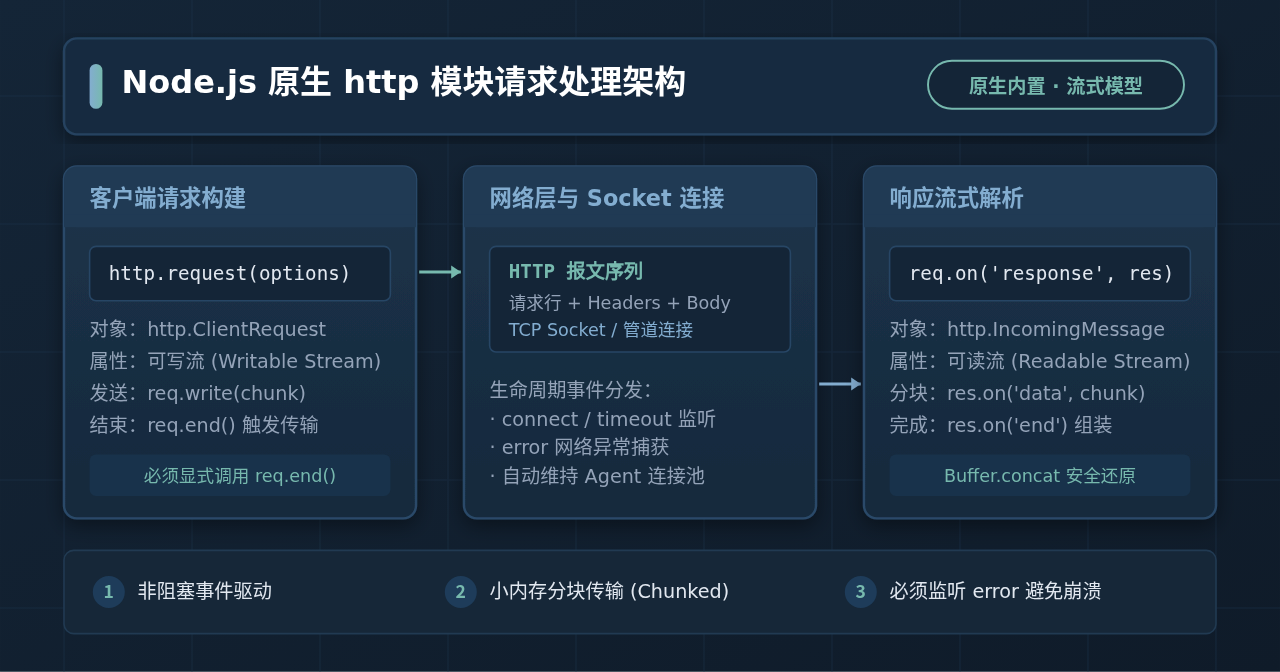
一、http 模块的通信机制与对象模型
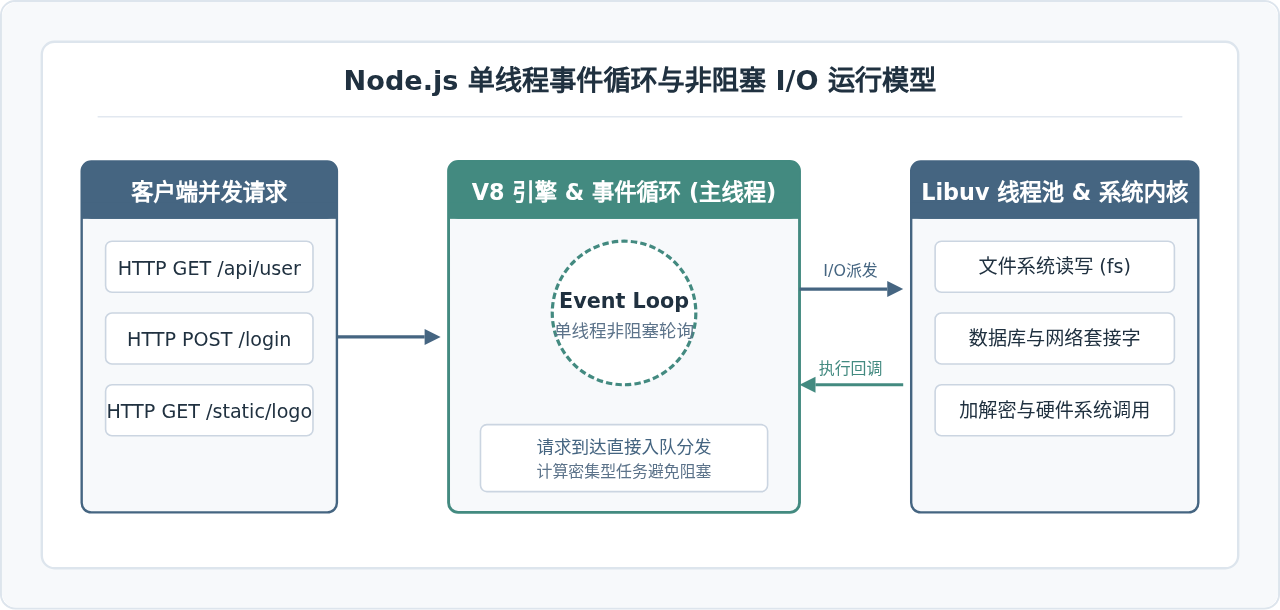
Node.js 的原生 http 模块基于底层的 net.Socket、Stream(流)与 EventEmitter(事件发射器)构建。它并没有像浏览器 fetch 或第三方库那样直接返回一个包含完整响应体的 Promise,而是将网络请求和响应抽象为两个独立的流对象:
http.ClientRequest(客户端请求对象):继承自可写流(Writable Stream)。当开发者调用http.request()时,该对象被创建。开发者可以通过req.write()持续写入请求体,并必须显式调用req.end()封闭报文,告知系统将数据从内核 TCP 缓冲区推送到远端服务器。http.IncomingMessage(服务端响应对象):继承自可读流(Readable Stream)。当服务器返回 HTTP 响应头时,客户端触发response事件并携带该实例。响应数据会以数据块(Chunk)形式分批到达,需要通过监听data事件逐块接收,并在end事件触发后统一拼接还原。
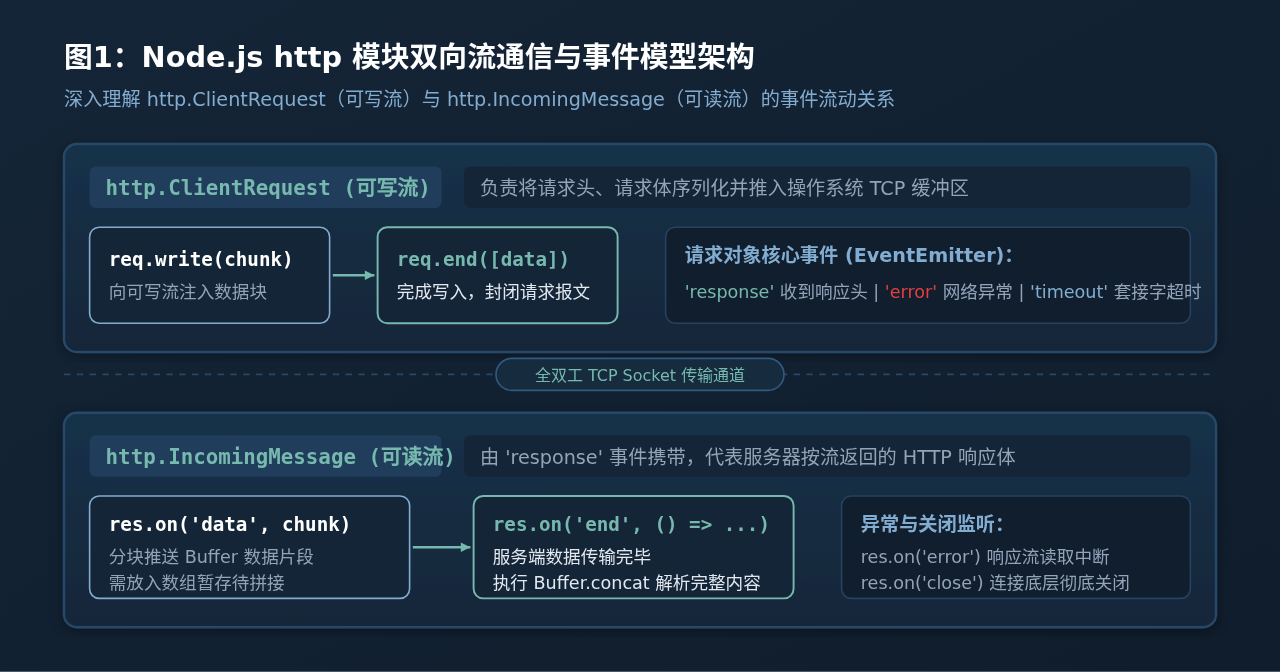
这种基于流的设计赋予了 Node.js 极低的内存开销与卓越的并发性能:在传输大文件或流式 JSON 时,Node.js 无需将整个请求或响应体全部缓存在内存中,而是随收随发。但这也要求开发者必须理解事件的触发时序,否则极易出现请求挂起或字符乱码。
二、使用 http.request() 发起 GET 请求的完整步骤
发起一次规范的 HTTP GET 请求需要经过 5 个标准步骤:准备请求参数、创建请求实例、挂载核心事件、发送报文,以及按流消费响应数据。
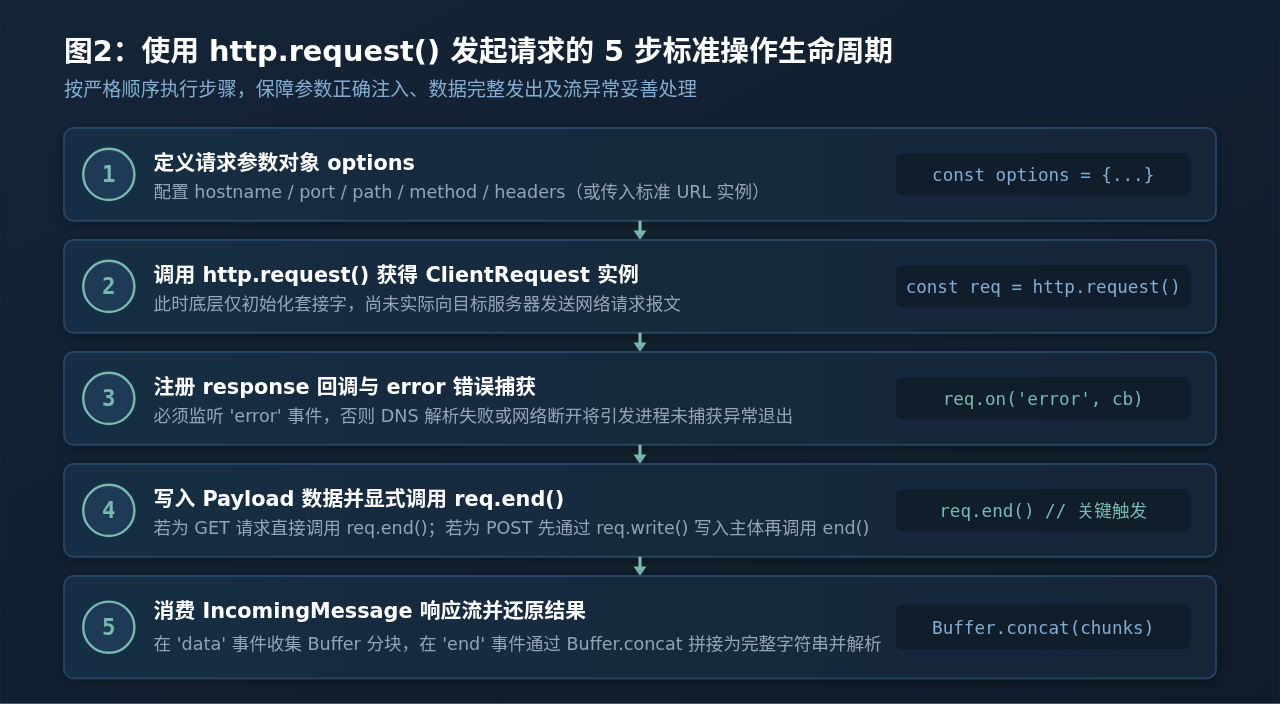
1. 编写完整的 GET 请求示例
以下是发起标准 GET 请求的完整代码。示例请求本地测试服务的 /api/status 接口:
const http = require('http');

// 1. 配置请求参数
const options = {
  hostname: '127.0.0.1',
  port: 3000,
  path: '/api/status?from=node-client',
  method: 'GET',
  headers: {
    'Accept': 'application/json',
    'User-Agent': 'Node-HttpClient/1.0'
  }
};

// 2. 调用 http.request 创建 ClientRequest 实例
const req = http.request(options, (res) => {
  console.log(`响应状态码: ${res.statusCode}`);
  console.log(`响应头信息:`, res.headers);

  // 校验 HTTP 状态码
  if (res.statusCode < 200 || res.statusCode >= 300) {
    console.error(`请求失败,非 2xx 状态码: ${res.statusCode}`);
    // 丢弃响应流以释放套接字内存
    res.resume();
    return;
  }

  // 3. 消费响应流:定义 Buffer 数组收集数据块
  const rawChunks = [];

  res.on('data', (chunk) => {
    rawChunks.push(chunk);
  });

  res.on('end', () => {
    // 4. 在 end 事件中安全拼接并解码
    const responseBody = Buffer.concat(rawChunks).toString('utf-8');
    try {
      const parsedData = JSON.parse(responseBody);
      console.log('响应解析成功:', parsedData);
    } catch (parseErr) {
      console.error('JSON 解析失败:', parseErr.message);
    }
  });
});

// 5. 必须挂载 error 事件监听
req.on('error', (err) => {
  console.error('HTTP 请求发生网络异常:', err.message);
});

// 6. 显式调用 end(),触发报文发出
req.end();
对于只读的 GET 请求,Node.js 提供了便捷的 http.get(options[, callback]) 方法。与 http.request 的唯一区别在于:http.get() 会自动将请求方法设为 GET,并自动在末尾调用 req.end()。如果不需要向服务器发送请求体,使用 http.get 能减少一行代码,但事件监听与流处理逻辑完全一致。
三、发起 POST 请求与请求体(Payload)精细控制
与 GET 请求不同,POST 请求通常需要向目标服务器提交数据(如 JSON、表单数据)。在原生 http 模块中,POST 请求的核心在于两个关键细节:请求头的准确设置与请求体的数据写入。
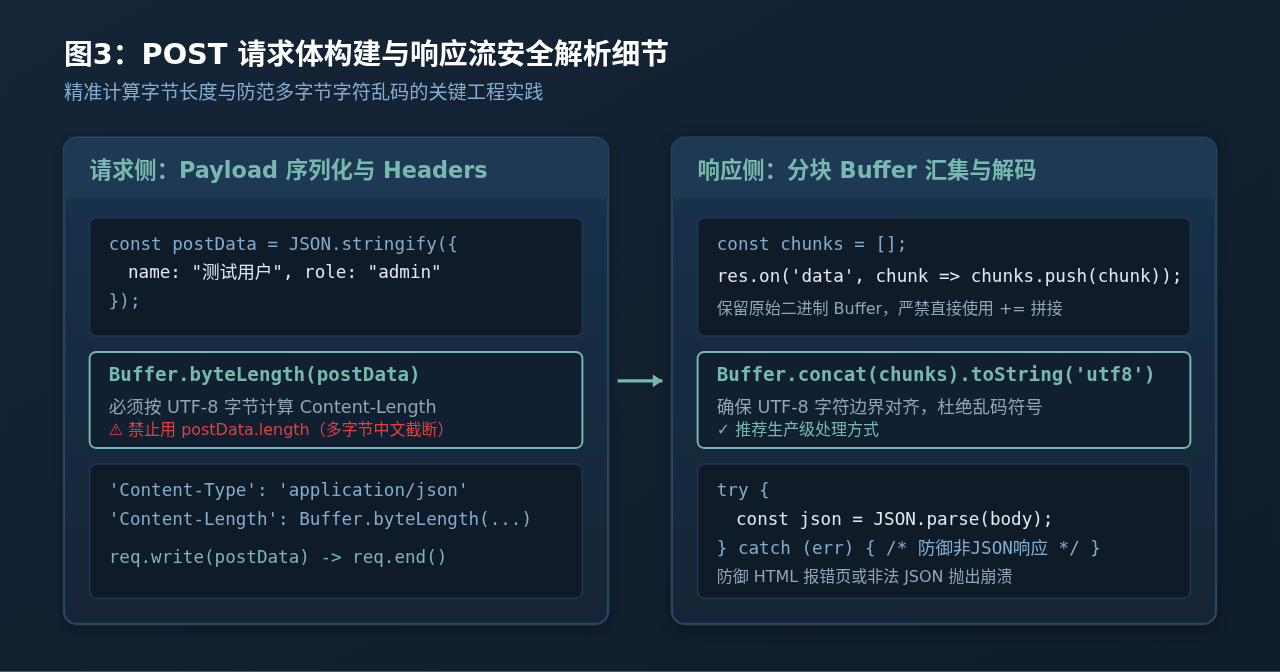
1. 为什么必须使用 Buffer.byteLength() 计算 Content-Length?
在传输包含中文字符或特殊符号的字符串时,JavaScript 原生字符串的 str.length 返回的是UTF-16 字符数,而 HTTP 协议规范中的 Content-Length 必须严格表示报文主体的字节数(Bytes)。
例如,字符串 "用户" 的 "用户".length 值为 2,但经过 UTF-8 编码后实际占用 6 个字节。如果错误地将 "用户".length 填入 Content-Length 头,目标服务端在读取到第 2 个字节后就会判定请求体结束,导致数据遭到严重截断,服务端甚至会报出 Unexpected end of JSON input 的解析错误。因此,务必使用 Buffer.byteLength(payload, 'utf8')。
2. 完整的 POST 请求示例(提交 JSON 数据)
const http = require('http');

// 准备需要提交的对象数据
const payload = JSON.stringify({
  username: 'antigravity_dev',
  action: 'create_record',
  timestamp: Date.now()
});

// 严格计算 UTF-8 字节长度
const payloadByteLength = Buffer.byteLength(payload, 'utf8');

const postOptions = {
  hostname: '127.0.0.1',
  port: 3000,
  path: '/api/v1/records',
  method: 'POST',
  headers: {
    'Content-Type': 'application/json; charset=utf-8',
    'Content-Length': payloadByteLength,
    'Accept': 'application/json'
  }
};

const req = http.request(postOptions, (res) => {
  console.log(`[POST] 响应状态: ${res.statusCode}`);

  const responseChunks = [];
  res.on('data', (chunk) => {
    responseChunks.push(chunk);
  });

  res.on('end', () => {
    const responseText = Buffer.concat(responseChunks).toString('utf-8');
    if (res.statusCode >= 200 && res.statusCode < 300) {
      console.log('提交成功,服务端返回:', JSON.parse(responseText));
    } else {
      console.error(`提交被拒绝 [${res.statusCode}]:`, responseText);
    }
  });
});

// 监听网络异常
req.on('error', (err) => {
  console.error('[POST] 请求失败:', err.message);
});

// 关键步骤:通过 req.write 写入请求体,最后调用 req.end() 完成发送
req.write(payload);
req.end();
四、流式响应处理与健壮的数据拼接
初学者在处理 res.on('data') 时,常习惯使用字符串累加:let body = ''; res.on('data', chunk => body += chunk);。在绝大多数简单英文字符测试中这能正常运行,但在高并发或网络拥塞场景下,这是一个隐藏极深的 Bug。
一个中文字符在 UTF-8 编码下占 3 个字节。当 TCP 数据包在某个字节中间发生切分时,第一个 chunk 可能只包含中文字符的前 2 个字节,第二个 chunk 包含剩余的 1 个字节。如果直接使用 body += chunk,JavaScript 隐式将未完成的字节转换为字符串,会导致该字符直接被转为乱码字符 ,且在后续拼接中无法复原。
生产环境的推荐做法是:
- 使用数组暂存未解码的二进制
Buffer块:const chunks = []; res.on('data', chunk => chunks.push(chunk)); - 在
res.on('end')中一次性调用Buffer.concat(chunks).toString('utf-8')完成对齐与解码。 - 或者在监听数据前显式指定可读流编码:
res.setEncoding('utf8'),此时 Node.js 内部的StringDecoder会自动处理跨 Chunk 的多字节字符边界。
五、超时控制、异常监听与生产防护
在实际生产环境中,网络抖动、DNS 故障或服务端死锁不可避免。如果未妥善配置超时与异常捕获,Node.js 应用程序可能会遭遇连接无限制挂起、内存泄漏甚至主进程崩溃。
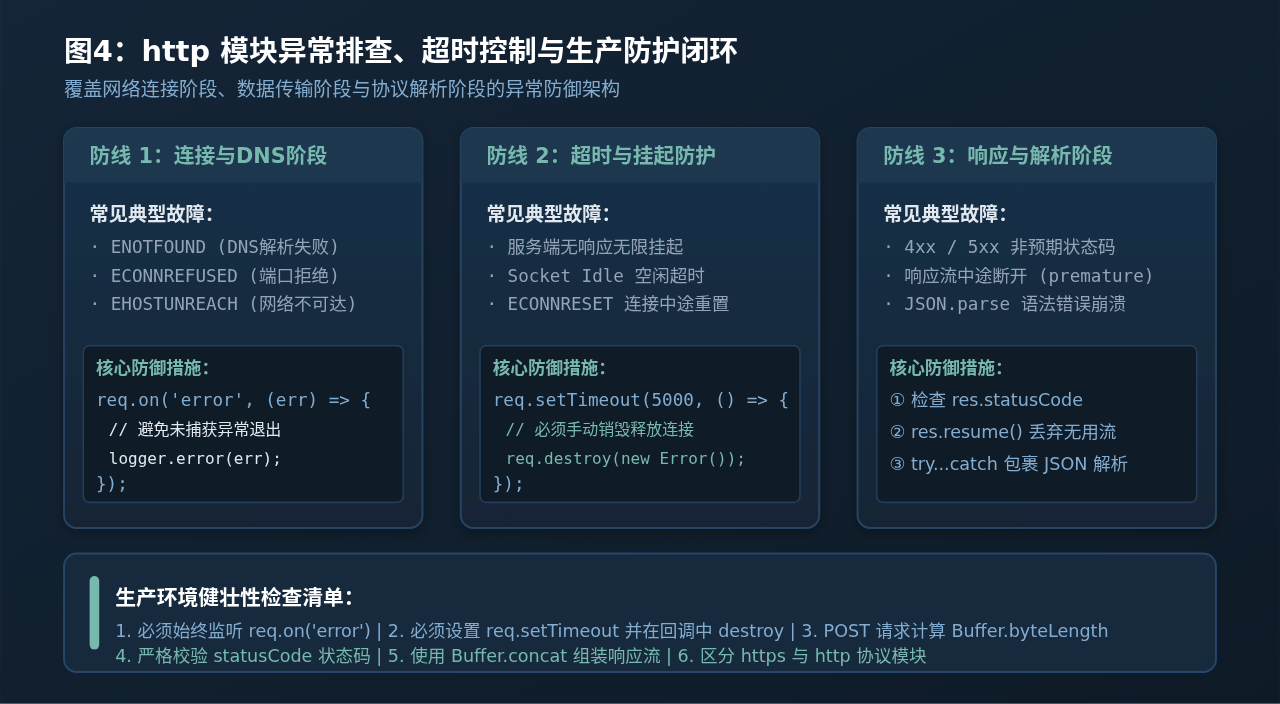
1. 套接字超时与主动销毁
Node.js 中通过 req.setTimeout(timeoutMs) 设置的是底层 Socket 的空闲超时时间。特别需要注意的是:触发 timeout 事件并不会自动终止请求,Node.js 仅通知开发者发生了超时。开发者必须在回调中显式调用 req.destroy() 销毁连接,否则请求将继续等待,导致句柄泄漏。
const req = http.request(options, (res) => {
  // 正常响应逻辑
});

// 设置 5000 毫秒套接字超时
req.setTimeout(5000, () => {
  console.error('请求超时,主动中断连接...');
  // 必须显式调用 destroy,传入错误对象会直接触发 req 的 error 事件
  req.destroy(new Error('Request timeout after 5000ms'));
});

// 必须监听 error 事件,防止未捕获异常导致 Node.js 进程退出
req.on('error', (err) => {
  if (err.code === 'ECONNRESET') {
    console.error('连接被服务器主动重置');
  } else if (err.code === 'ENOTFOUND') {
    console.error('域名无法解析,请检查 DNS 配置');
  } else {
    console.error('发生网络错误:', err.message);
  }
});

req.end();
六、技术对比与工程选型建议
在现代 Node.js 生态中,开发者拥有多种发起 HTTP 请求的工具。了解原生 http 模块的定位有助于在不同场景做出合理决策:
| 对比维度 | 原生 http / https 模块 | 内置 fetch API (Node 18+) | 第三方库 (如 Axios) |
|---|---|---|---|
| 外部依赖 | 0 依赖(Node.js 内置核心库) | 0 依赖(全局内置) | 需要安装 npm 依赖包 |
| 编程模型 | 基于事件与流(Stream / Event) | 基于 Promise / async-await | 基于 Promise / 拦截器 |
| HTTPS 支持 | 需显式引入 require('https') |
自动识别协议 | 自动识别协议 |
| 底层控制力 | 极高(可精确控制 Socket、分块与 Agent) | 中等(标准 Web API) | 中等(高度封装) |
| 适用场景 | 无依赖脚本、微服务底层代理、流式管道转发 | 现代常规业务开发、全栈代码同构 | 复杂企业应用、统一拦截鉴权 |
http 模块仅支持明文 http:// 协议。如果目标地址为 https://,直接引入 const https = require('https'); 即可。两者的 API 设计(https.request 与 https.get)完全一致,https 模块额外提供了 rejectUnauthorized、ca、cert 等 SSL/TLS 证书相关的配置项。
七、总结
使用 Node.js 原生 http 模块发起 HTTP 请求虽然在代码量上不如高层封装库简洁,但它揭示了网络通信在底层的真实运作机理。通过掌握 ClientRequest 的发送控制、IncomingMessage 的分块汇集、Buffer.byteLength 的准确核算,以及 setTimeout 配合 destroy() 的主动容灾,开发者不仅能够在零外部依赖的环境中实现高稳定性的网络通信,也能为后续理解反向代理、API 网关和流式传输服务打下扎实的底层基础。
Web开发必学JavaScript,Python在后端和数据领域的学习门槛对比
2026-11-18 15:53:57
服务端怎么配置CORS头允许JS跨域访问
2026-11-18 11:11:20
怎么搭建本地JavaScript运行环境:Node.js安装与浏览器控制台使用
2026-11-16 18:13:36
JavaScript局域网传输:WebRTC、WebSocket与Socket选型指南
2026-11-16 15:05:00
Node.js官网下载地址在哪里?怎么获取正版安装包
2026-11-13 22:22:25