Web开发必学JavaScript,Python在后端和数据领域的学习门槛对比
深入对比Web开发中JavaScript的不可替代性,以及Python在后端服务与数据科学领域的真实学习门槛、并发心智模型与技术选型路径。
一、为什么 Web 开发必学 JavaScript:浏览器的原生垄断与交互闭环
很多初学者常有一个疑问:“既然 Python 功能强大且语法简单,我能否只学 Python 来完成整套网站开发?”答案是在现代 Web 架构中,客户端交互层无法脱离 JavaScript 独立存在。
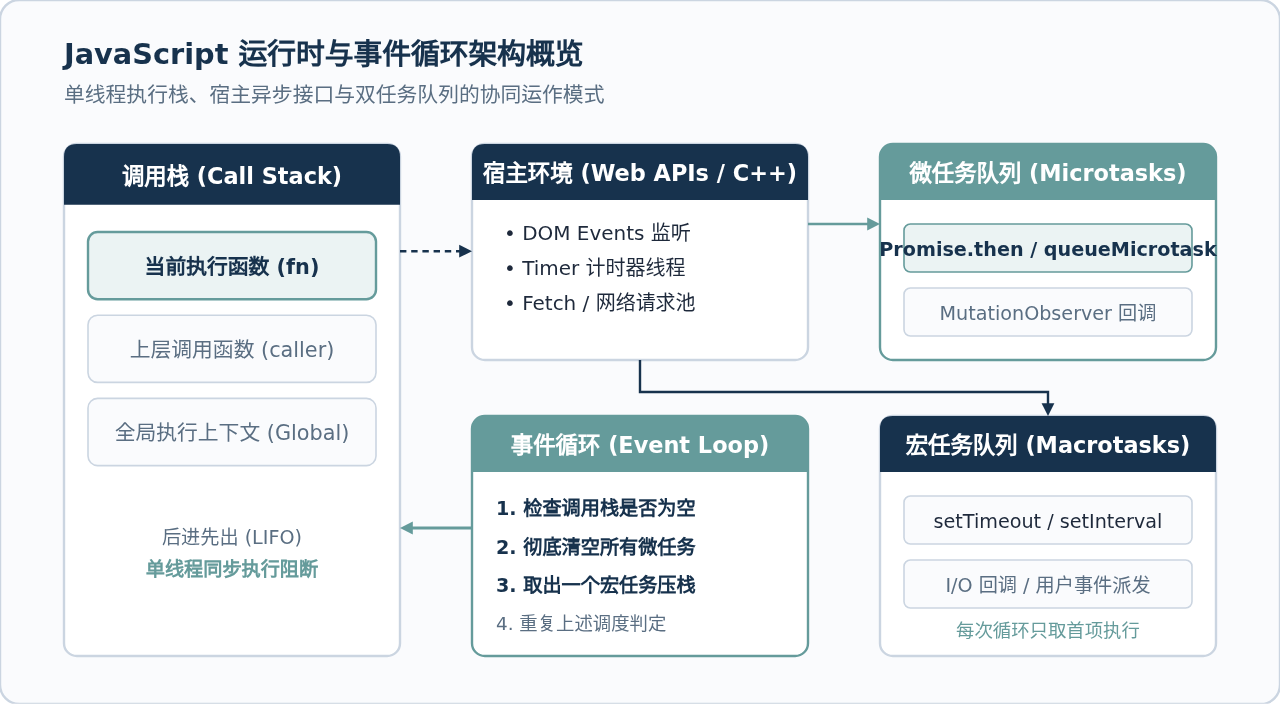
现代 Web 浏览器的运行原理决定了这一限制。浏览器内核(如 Chrome 的 Blink、Safari 的 WebKit、Firefox 的 Gecko)在解析 HTML 生成文档对象模型(DOM)树、解析 CSS 生成规则树(CSSOM)后,唯一内置且原生支持执行的编程脚本语言就是 JavaScript。无论是页面元素的动态挂载、CSS 类名的实时切换、用户点击与滚动事件的监听,还是通过 Fetch API 在不刷新页面的情况下与后台进行异步数据交换,全部依赖浏览器内部的 JavaScript 引擎(如 V8、SpiderMonkey)来调度和驱动。
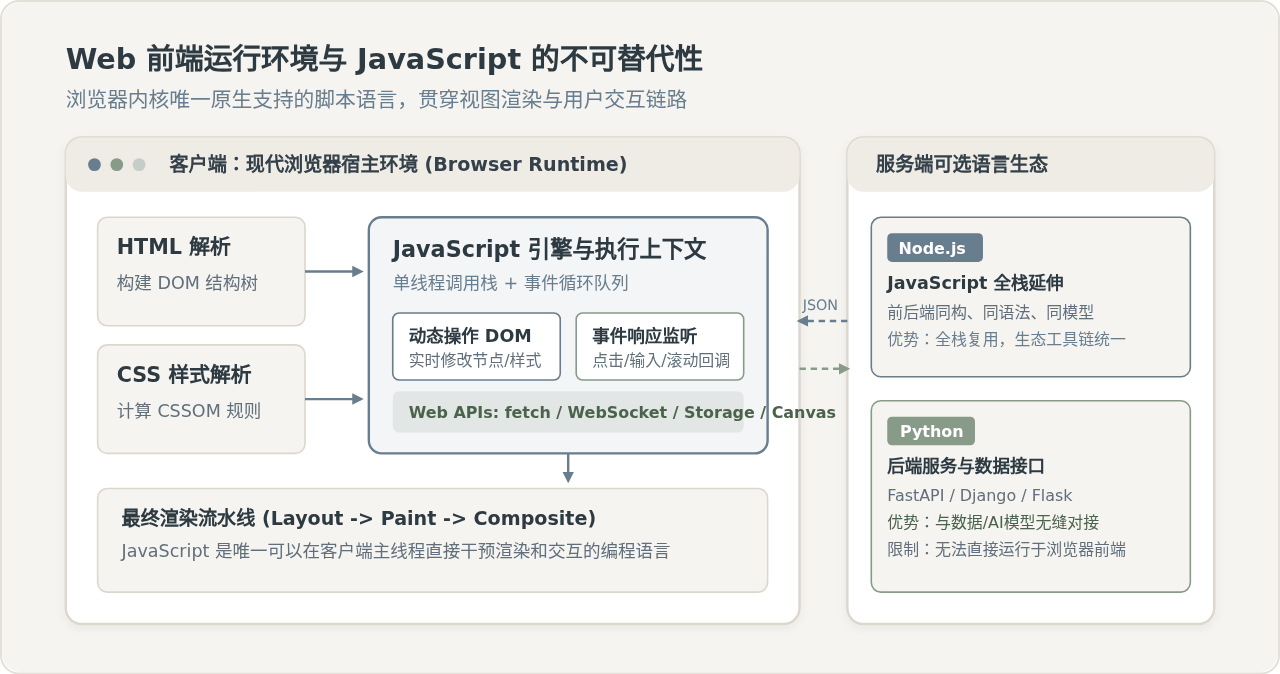
虽然近年来出现了 WebAssembly(Wasm)技术,允许将 Rust、C++ 或 Go 编译为二进制在浏览器中高效运行,但 WebAssembly 并不直接提供对 DOM 的完备操作接口,仍然需要借助 JavaScript 胶水代码进行宿主交互。而类似 PyScript 等在浏览器中运行 Python 的尝试,本质上是在 WebAssembly 之上打包了一个庞大的 CPython 运行时,其首屏加载体积通常达数兆字节,启动延迟明显,无法胜任生产环境的高响应度交互需求。
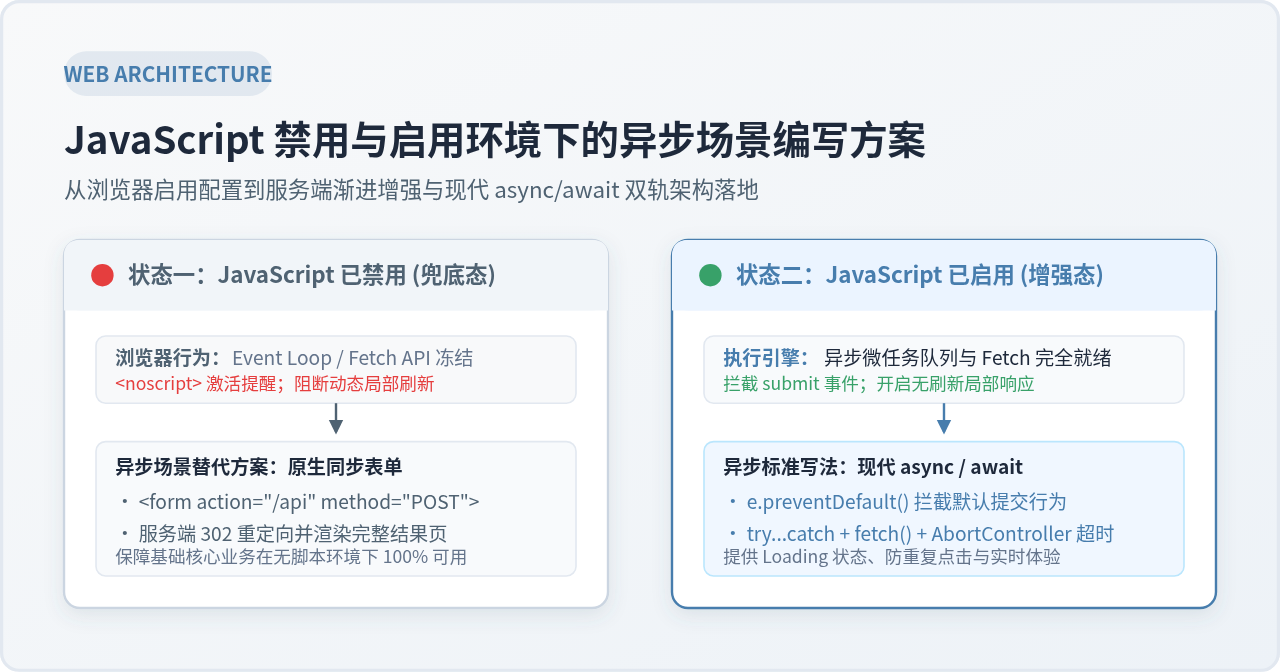
对于学习者而言,掌握 JavaScript 不仅是记忆变量与函数语法,更关键在于建立“事件驱动”与“异步 I/O”的心智模型。下面的原生 JavaScript 示例演示了前端最核心的“监听事件 - 触发请求 - 更新 DOM”闭环:
// 浏览器客户端原生 JavaScript:事件监听与异步数据渲染
const submitBtn = document.getElementById('fetch-btn');
const resultBox = document.getElementById('result-display');

submitBtn.addEventListener('click', async () => {
  resultBox.textContent = '正在加载数据...';
  try {
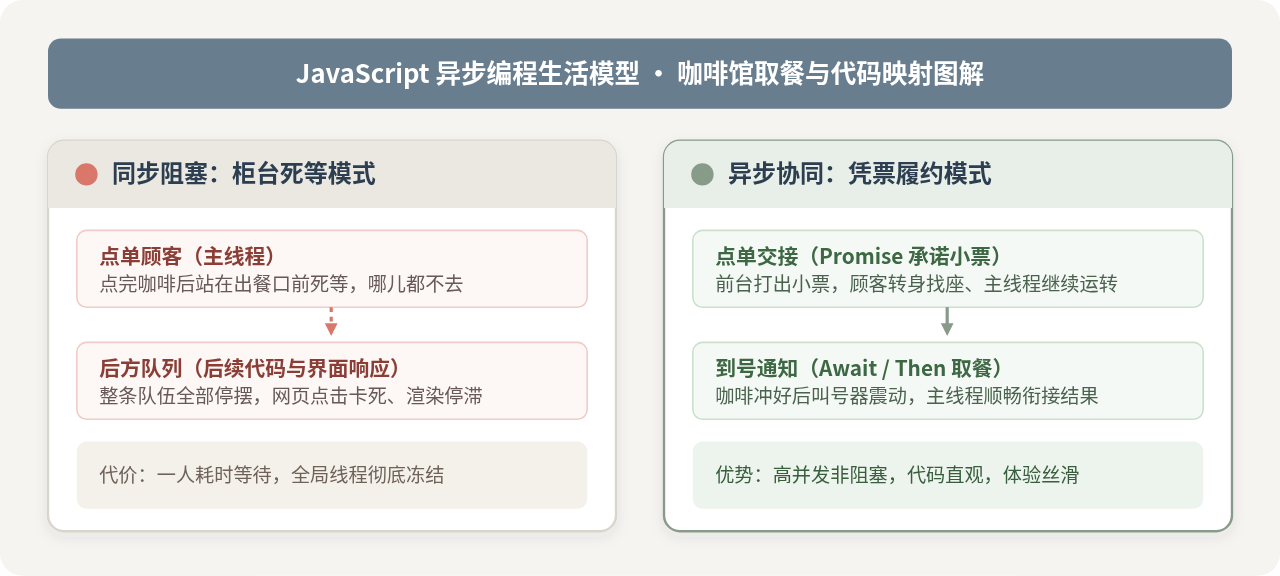
    // 异步发起网络请求,不阻塞浏览器主线程渲染
    const response = await fetch('/api/v1/metrics');
    if (!response.ok) {
      throw new Error(`HTTP 错误: ${response.status}`);
    }
    const data = await response.json();
    // 直接修改 DOM 树呈现结果
    resultBox.textContent = `计算指标: ${data.score},状态: ${data.status}`;
  } catch (err) {
    resultBox.textContent = `请求失败: ${err.message}`;
  }
});
此外,随着 Node.js 的普及,JavaScript 延伸到了服务端开发。这意味着学会一套 JavaScript / TypeScript 语言体系,开发者便能无缝打通从浏览器前端(React/Vue)、服务端接口(NestJS/Express)到全栈框架(Next.js)的整个技术链,这构成了前端工程师极其稳固的生态壁垒。
二、Python 在后端开发中的学习门槛:语法平缓与并发架构的双重性
与 JavaScript 在前端的唯一性不同,后端开发在语言选择上完全开放:Java、Go、Node.js、Python、PHP 均可承担服务端逻辑。在这一领域,Python 的表现呈现出鲜明的双重特征:语法入门极其平缓,但应对高并发与系统架构时存在特定的深层门槛。
1. 为什么说 Python 后端上手速度极快
Python 的语法设计追求“只有一种显而易见的方式完成任务”,摒弃了复杂的类样板和花括号。使用现代的 FastAPI 或 Flask 框架,初学者往往在数小时内就能启动并运行一个合法的 RESTful API 服务:
# Python 后端示例:使用 FastAPI 构建类型安全的异步接口
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(title="业务指标服务")

# 利用 Pydantic 进行请求体验证,自动完成类型校验与文档生成
class MetricQuery(BaseModel):
    user_id: int
    category: str

@app.post("/api/v1/metrics")
async def calculate_metrics(query: MetricQuery):
    if query.user_id <= 0:
        raise HTTPException(status_code=400, detail="非法的用户标识")

    # 模拟异步数据库查询
    score = 95.5 if query.category == "premium" else 72.0
    return {"score": score, "status": "active"}
借助 Pydantic 的类型注解,Python 后端不仅具备自动数据校验功能,还能直接生成 OpenAPI/Swagger 交互文档。对于个人项目、中小型企业业务后台、内部管理系统或 AI 服务的 API 包装层,Python 的交付效率几乎难寻对手。
2. Python 后端的深层技术门槛
然而,当业务规模扩展、并发量提升时,Python 后端开发者必须跨越以下几道系统级门槛:
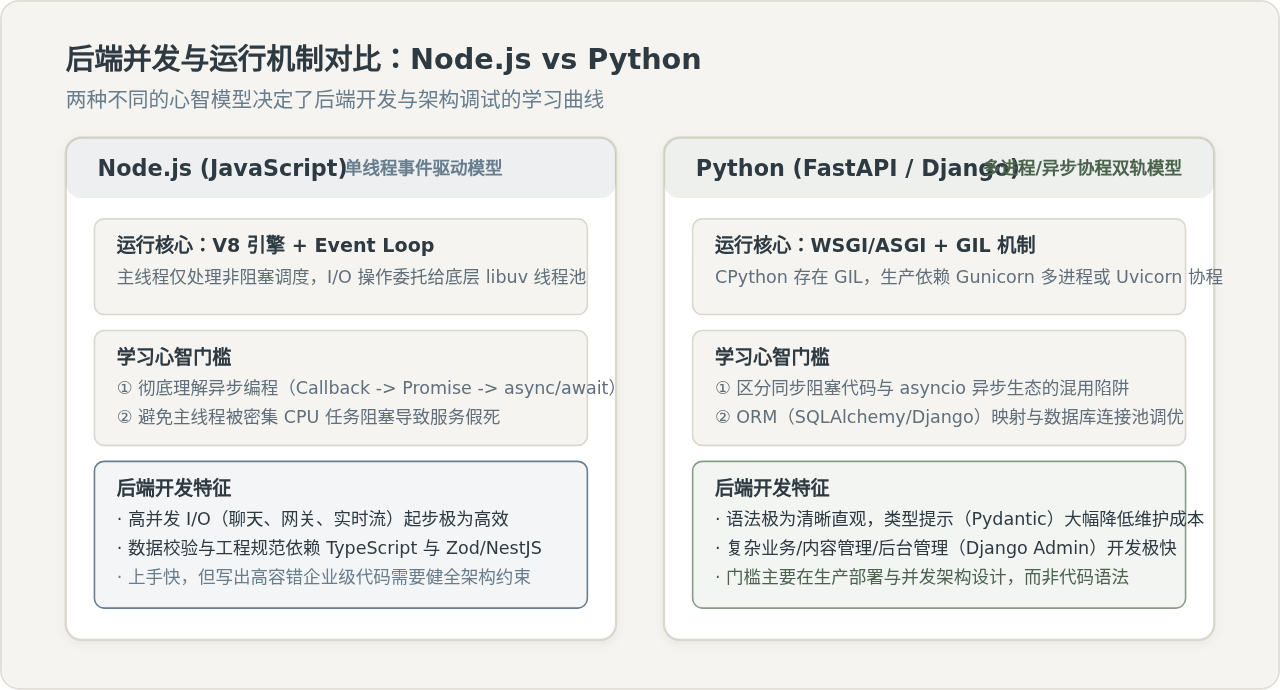
- GIL(全局解释器锁)与多进程架构:CPython 原生解释器存在 GIL 限制,纯 Python 多线程无法利用多核 CPU 执行并行计算。在生产部署中,开发者必须深入理解 WSGI/ASGI 规范,通过 Gunicorn 等进程管理器配置多个独立工作进程(Worker),并配置反向代理(如 Nginx)来负载均衡。
- 同步阻塞与协程异步的混用陷阱:FastAPI 提供了
async def支持,但如果开发者在协程函数中调用了传统的同步阻塞库(如未适配异步的数据库驱动或文件读写),会直接卡死该进程的单线程事件循环,导致接口吞吐量骤降。理解何时使用asyncio.run_in_executor将阻塞任务抛入线程池,是后端进阶的关键分水岭。 - ORM 与复杂查询优化:在 Django ORM 或 SQLAlchemy 中,初学者极易写出经典的
N+1查询问题。理解预加载机制(select_related/prefetch_related)与连接池配置,是跨过后端门槛的必修内容。
三、Python 在数据领域的真实门槛:从语法舒适区到领域壁垒
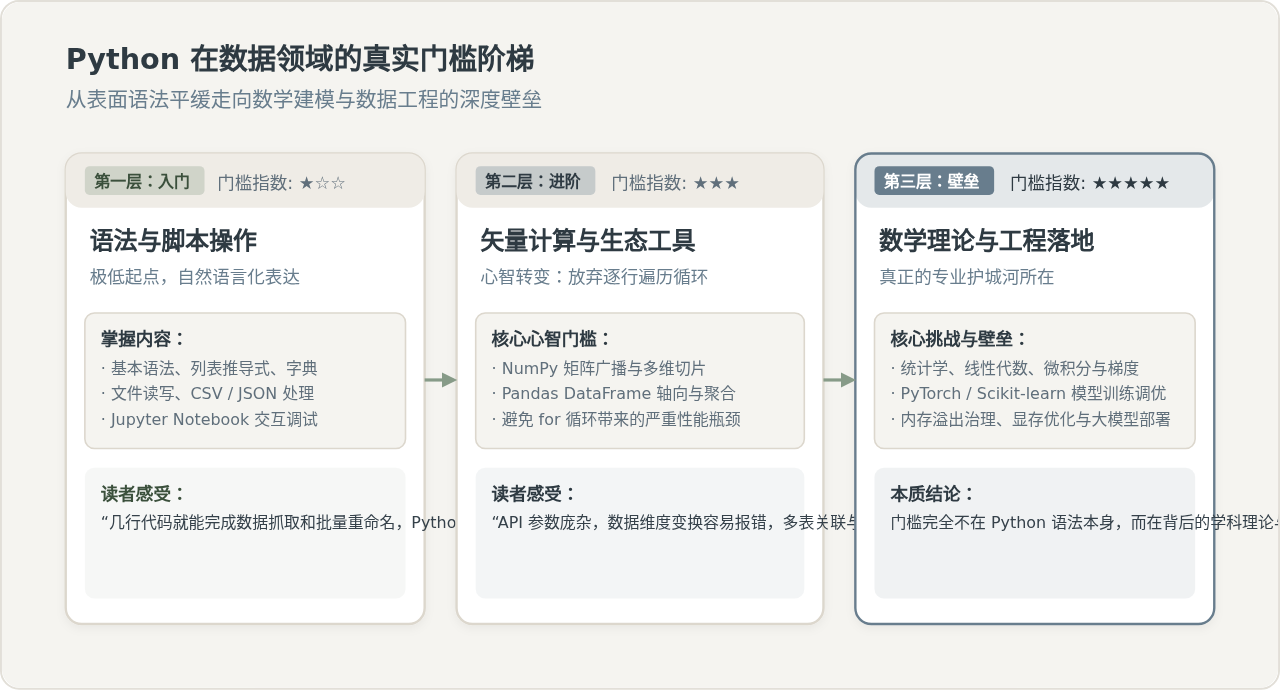
在数据分析、机器学习与人工智能领域,Python 毫无悬念是当今全球事实上的第一通用语言。很多非计算机专业背景的学习者因为“Python 简单”而涌入数据领域,但往往会在学习两到三个月后遭遇难以逾越的高墙。这种现象的原因在于:数据领域的门槛从来不是 Python 语法,而是数学理论、矢量化计算思维与数据工程实践。
1. 第一阶段:语法与基础脚本(门槛极低)
在这一阶段,学习者使用 Python 内置的 list、dict、列表推导式以及文件读写模块,配合交互式的 Jupyter Notebook,能够轻松完成本地 CSV 解析、文本清洗或数据抓取脚本。此时代码通常符合直觉的顺序思维,依靠简单的 for 循环即可获得立竿见影的成果。
2. 第二阶段:矢量化运算与生态 API(中等门槛)
一旦面对十万级或百万级数据记录,原生的 for 循环会带来灾难性的运行延迟。学习者必须彻底颠覆命令式编程习惯,建立矢量化(Vectorized)与广播(Broadcasting)计算思维。
# 数据处理思维转变:原生循环 vs NumPy/Pandas 矢量化
import numpy as np
import pandas as pd

# 场景:根据特征 A 与特征 B 计算归一化加权得分
df = pd.DataFrame({
    'feature_a': np.random.rand(500000),
    'feature_b': np.random.rand(500000)
})

# ❌ 初学者容易写出的低效逐行迭代(耗时数秒)
# scores = [a * 0.7 + b * 0.3 for a, b in zip(df['feature_a'], df['feature_b'])]

# ✔️ 矢量化批量运算:底层 C 语言连续内存块并行指令执行(耗时毫秒级)
df['score'] = df['feature_a'] * 0.7 + df['feature_b'] * 0.3

# 复杂条件分组与窗口聚合(需要熟练掌握索引对齐机制)
df['tier'] = np.where(df['score'] > 0.5, 'High', 'Standard')
在这一阶段,门槛体现为 Pandas 和 NumPy 庞杂的 API 体系。处理多层索引(MultiIndex)、轴向变形(stack/unstack)、透视表与合并连接(merge/join)时,若对底层连续内存布局与索引对齐缺乏理解,极易写出产生副本、引发内存告警或静默计算错误的代码。
3. 第三阶段:数学建模与工程落地(深度壁垒)
进入机器学习(Scikit-learn)与深度学习(PyTorch)阶段后,Python 代码退化为单纯的“调用壳”。真正的专业壁垒全面浮现:
- 数学与统计学底蕴:理解损失函数收敛原理依赖微积分梯度概念;处理高维特征降维与注意力权重矩阵依赖线性代数(特征值、SVD 分解、张量乘法);评估模型置信度与假设检验需要扎实的概率论基础。缺乏数学储备的学习者往往只能照抄参数,面对过拟合或梯度消失一筹莫展。
- 系统工程与性能调优:在工业级场景下,模型训练与推理面临严格的资源约束。如何进行分布式多卡训练、如何通过数据管道(如 PyTorch DataLoader)避免 GPU 算力等待、如何排查 Python 进程内存未释放以及量化部署(ONNX, TensorRT),属于严肃的系统工程领域。
model.fit(X, y) 仅需两行 Python 代码,但能够准确解释特征共线性、处理数据倾斜与泄漏、量化模型泛化能力并稳定部署到微服务容器中,需要完整的工科学科素养。切勿将“语法容易看懂”误判为“领域门槛低”。
四、系统对比:核心维度与心智模型对照
为了让不同背景的读者建立全局视野,下表在统一的评估条件下,对 JavaScript 在 Web 领域与 Python 在后端及数据领域的关键特征进行了系统对照:
| 对比维度 | Web 开发:JavaScript / TypeScript | 后端开发:Python (FastAPI / Django) | 数据科学:Python (NumPy / PyTorch) |
|---|---|---|---|
| 运行时宿主 | 现代浏览器(V8 等)及 Node.js / Deno | CPython 解释器 + WSGI/ASGI 服务器 | CPython + 底层 C/C++/CUDA 加速库 |
| 语法起步门槛 | 中等(需理解作用域、异步与对象模型) | 极低(语义贴近伪代码,开箱即用) | 极低(单脚本交互调试非常顺手) |
| 核心心智模型 | 事件循环队列、DOM 树响应、组件状态驱动 | 请求生命周期、ORM 关系映射、中间件链路 | 高维矩阵张量、矢量化运算、数学损失优化 |
| 依赖与环境管理 | 统一标准(npm/pnpm + package.json) |
需要虚拟环境隔离(venv/poetry) |
深度依赖二进制轮子(conda/pip) |
| 进阶核心壁垒 | 前端工程化架构、首屏渲染优化、大型状态管理 | 高并发下 GIL 规避、异步阻塞混用排查、分库分表 | 高等数学理论、算法机理、海量数据吞吐调优 |
| 跨端不可替代性 | 极高(浏览器端唯一原生支持,全生态霸权) | 中等(后端可选技术栈众多) | 极高(全球科研与开源 AI 事实标准) |
五、目标驱动的选型与学习路径决策
面对两门语言各自的优势与门槛特征,学习者不应空泛地争论“哪个语言更有前途”,而应以实际交付的目标软件产品形态为导向制定学习规划。
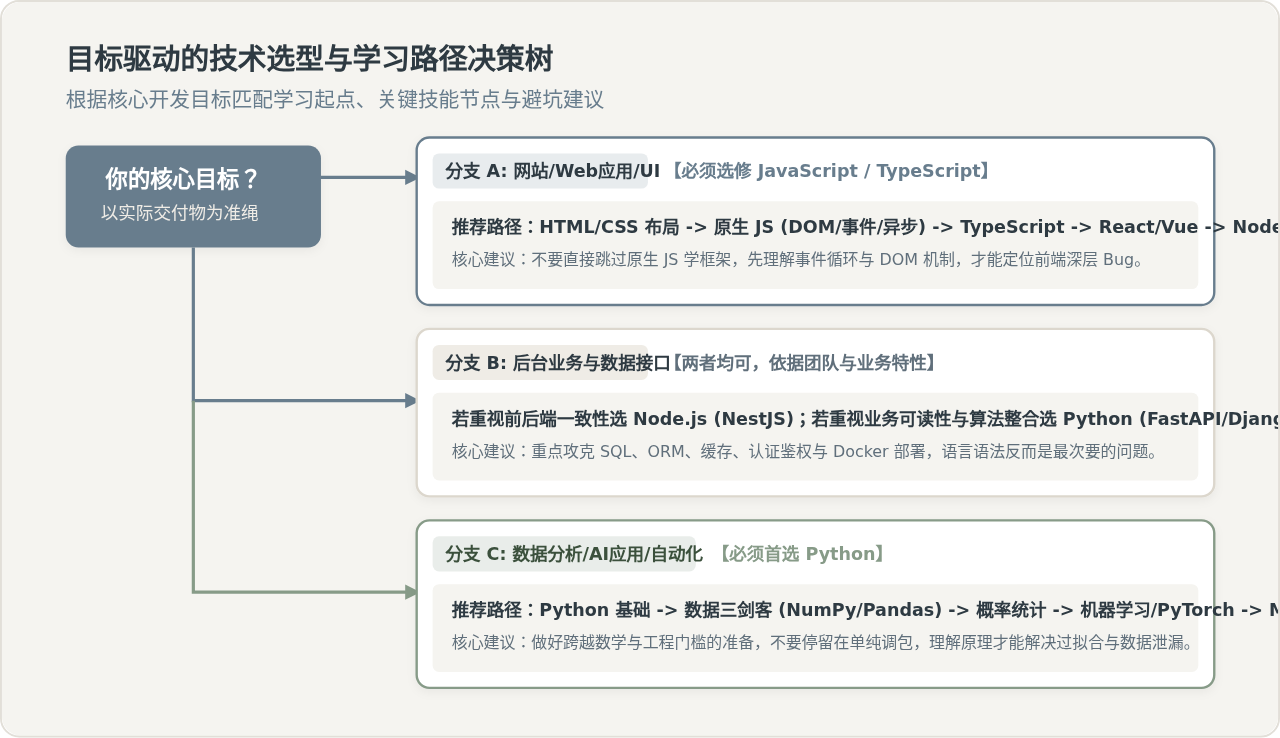
场景 1:如果你的目标是打造用户看得见、摸得着的 Web 界面或完整 SaaS 产品
路线规划:必须将 JavaScript / TypeScript 作为绝对主线。
- 第一阶段:夯实 HTML5 语义化标签与 CSS 弹性盒/网格布局,紧接着深度学习原生 JavaScript 的核心语法、原型机制、DOM API 和事件流。
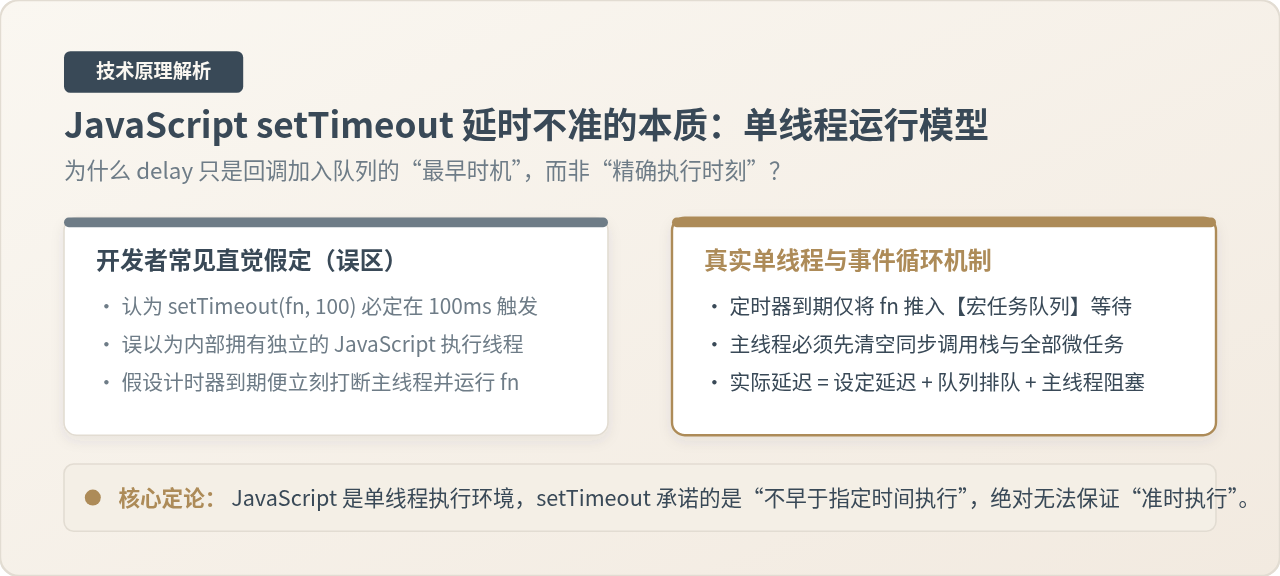
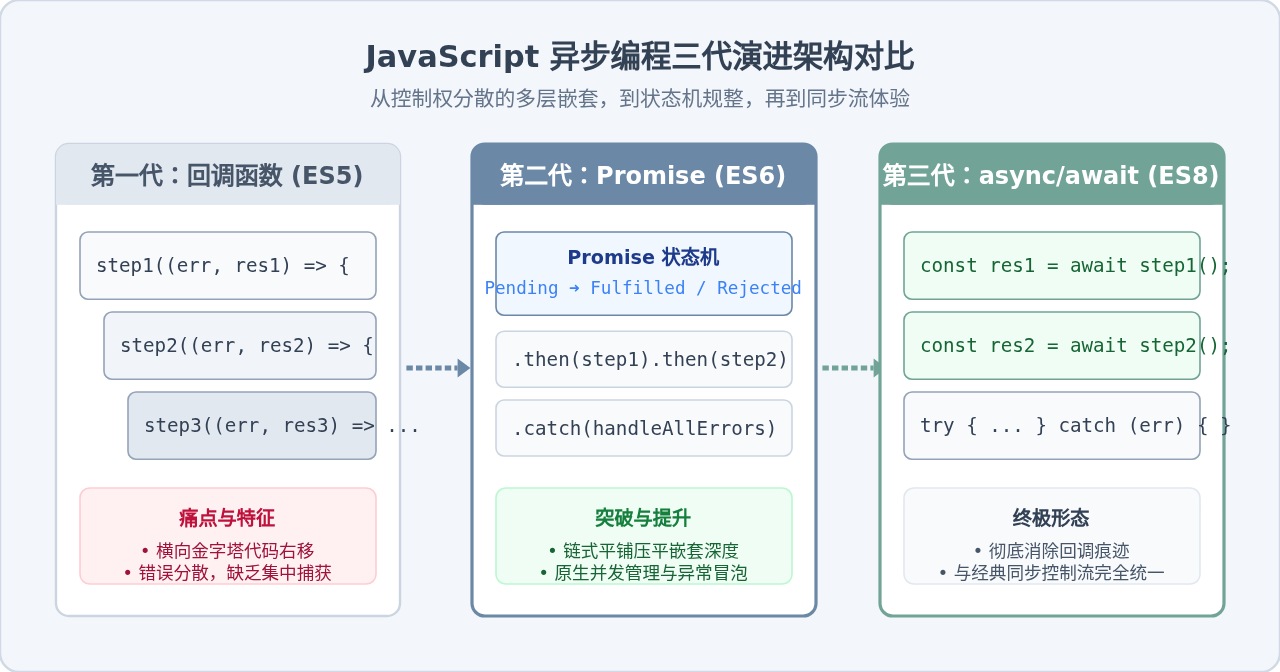
- 第二阶段:彻底理解单线程异步机制(Promise、async/await 与微任务队列),掌握现代前端打包工具基础。
- 第三阶段:引入 TypeScript 构建大型项目的类型安全屏障,并深入掌握主流现代前端框架(如 React 或 Vue 3)。
- 第四阶段:通过 Node.js(NestJS 或 Next.js 全栈服务端渲染)打通前后端同构链路,成为具备独立交付完整 Web 应用能力的全栈工程师。
场景 2:如果你的目标是企业内部业务接口、微服务后台或内容管理平台
路线规划:若团队倾向于前后端使用同一种语言降本增效,Node.js 优势显著;若更注重业务代码的可读性、敏捷性以及与后台数据/自动化脚本的无缝集成,Python (FastAPI / Django) 是极佳切入点。
- 建议从 FastAPI 入手,利用其现代类型提示规范养成强类型编程习惯。
- 尽早接触 SQL 原生知识,切勿过度依赖 ORM 的黑盒封装。
- 在进入实战阶段时,主动学习 Docker 容器化打包、Nginx 反向代理配置以及 Gunicorn 多进程调优,提前化解生产环境的运维门槛。
场景 3:如果你的目标是商业智能报表、数据挖掘、深度学习或大模型应用
路线规划:毫无疑问必须首选 Python,但要做好长周期的知识积累准备。
- 用 1 至 2 周快速完成 Python 基础语法的通读与脚本编写练习。
- 将重心迅速转向 NumPy 与 Pandas,强迫自己丢掉逐行循环的编程习惯,完全使用矩阵切片、布尔索引与内置矢量函数解决数据清洗问题。
- 同步补充应用统计学(假设检验、A/B 测试、线性回归)与线性代数基础知识,理解主流机器学习模型的数学推导过程。
- 进阶阶段结合 PyTorch 进行深度神经网络训练,并掌握模型轻量化、部署服务封装与数据管道调优工程技能。
六、总结
归结起来,编程语言的学习门槛并非单纯取决于语法规则的多寡:“Web 开发必学 JavaScript”体现的是运行环境垄断所带来的强约束——只要世界还需要在浏览器中呈现交互式内容,JavaScript 就是前端开发者必须跨过并且深度精通的技术地基;而“Python 在后端和数据领域的门槛”则体现了现代软件工程的知识分层——它用最优雅的语法降低了初学者推开技术大门的阻力,却把真正的专业挑战留在了系统高并发架构调优与数学算法理论的深水区。
根据你的核心交付目标,选择相匹配的技能主干,避开虚假的低门槛诱惑,在对应的心智模型中持续实践,才是最高效的学习路径。
服务端怎么配置CORS头允许JS跨域访问
2026-11-18 11:11:20
怎么搭建本地JavaScript运行环境:Node.js安装与浏览器控制台使用
2026-11-16 18:13:36
JavaScript局域网传输:WebRTC、WebSocket与Socket选型指南
2026-11-16 15:05:00
Node.js官网下载地址在哪里?怎么获取正版安装包
2026-11-13 22:22:25
怎么使用Node.js命令行批量格式化项目中的JS文件
2026-11-13 20:22:02