为什么JS禁止复制容易被绕过?前端防护的局限性分析
深入剖析JavaScript禁止复制的技术原理、四种典型绕过路径,并从客户端执行权倒置、渲染管线公开性以及防御边界三个维度,系统分析前端防护的固有局限性与合理的工程应对策略。
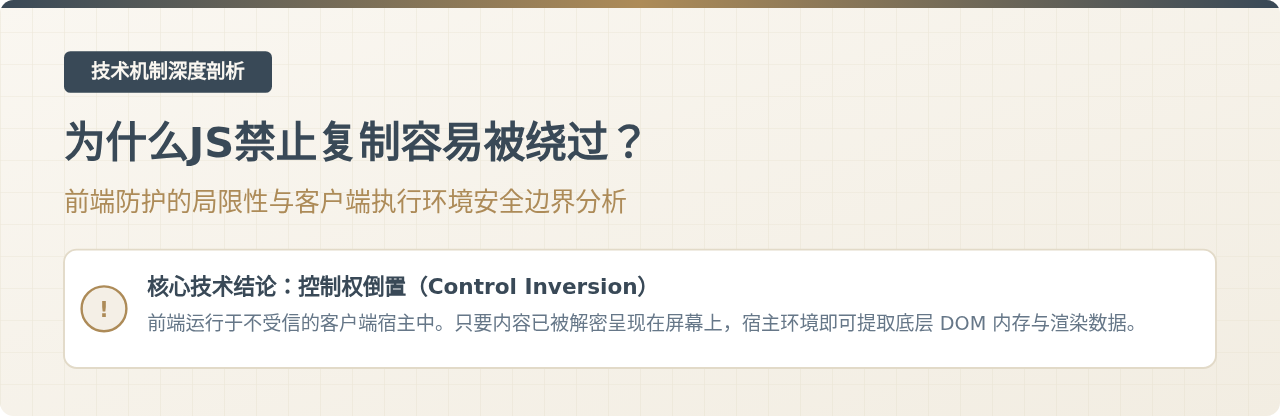
很多网站为了保护原创文本,会在网页中注入脚本拦截复制、禁用右键或限制文字选取。然而,稍有经验的技术人员往往只需按下快捷键或打开开发者工具,就能在几秒钟内将其完整绕过。JS 禁止复制之所以极其脆弱,核心原因在于“控制权倒置”——前端代码的运行宿主是用户本地的浏览器,而不是网站的受信任服务器。只要内容已经呈现在用户的屏幕上,其原始数据就必然已经解密并常驻于本地内存中,而整个渲染管线与事件系统的最高权限完全属于客户端用户。本文将从前端拦截机制、常见绕过步骤、架构局限性三个维度深入分析该问题,并阐述内容保护的合理工程边界。
一、常见的 JS 禁止复制实现原理
要理解禁止复制为何容易被瓦解,首先需要明确前端开发者通常是如何在页面中施加限制的。在现有的 Web 技术标准下,开发者无法直接阻断操作系统级别的剪贴板,只能通过监听 DOM 事件或覆盖样式来打断用户的正常复制流程。目前主流的防护代码通常由以下四种机制组合而成:
1. 拦截剪贴板与上下文事件
浏览器在用户执行复制操作时,会按顺序触发特定的 DOM 事件。前端脚本可以通过 addEventListener 捕获这些事件,并调用 event.preventDefault() 或直接返回 false,从而取消浏览器的默认写入行为:
// 监听并拦截复制、剪切及右键菜单事件
document.addEventListener('copy', function (e) {
  e.preventDefault();
  alert('本站内容禁止复制!');
});

document.addEventListener('cut', function (e) {
  e.preventDefault();
});

document.addEventListener('contextmenu', function (e) {
  e.preventDefault(); // 禁用鼠标右键菜单
});
2. 限制光标文本选区
复制操作的前提通常是“先选中文本”。网站可以通过监听 selectstart 事件,或者在全局 CSS 中添加 user-select: none 样式,使鼠标无法在页面元素上产生高亮选区:
/* 通过 CSS 阻止鼠标选中文本 */
body, article {
  -webkit-user-select: none;
  -moz-user-select: none;
  -ms-user-select: none;
  user-select: none;
}
3. 剪贴板内容篡改与污染
部分内容平台并不直接阻止复制动作,而是利用 Clipboard API 修改写入剪贴板的数据,强行追加版权声明或将原本复制的内容替换为空字符:
document.addEventListener('copy', function (e) {
  const selection = window.getSelection().toString();
  const copyright = '\n\n著作权归作者所有。商业转载请联系作者获得授权。';
  e.clipboardData.setData('text/plain', selection + copyright);
  e.preventDefault();
});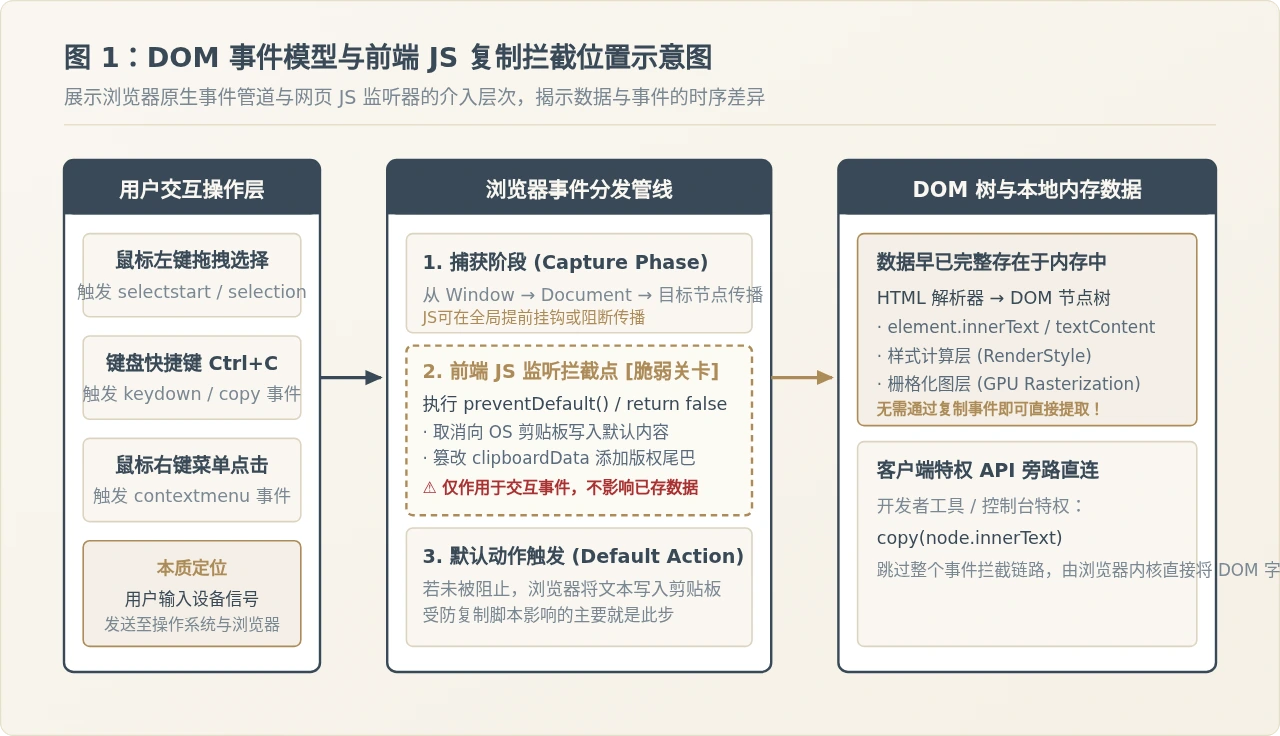
如上图所示,网页中注入的所有防御逻辑,都位于浏览器的“事件分发管线”中。这带来了一个根本性的事实:页面的文本数据早已在 DOM 树和渲染引擎中就绪,防复制脚本仅仅是在用户与系统剪贴板之间充当了一道脆弱的“交通岗亭”。只要绕过或切断这个岗亭,数据本身即可被自由读取。
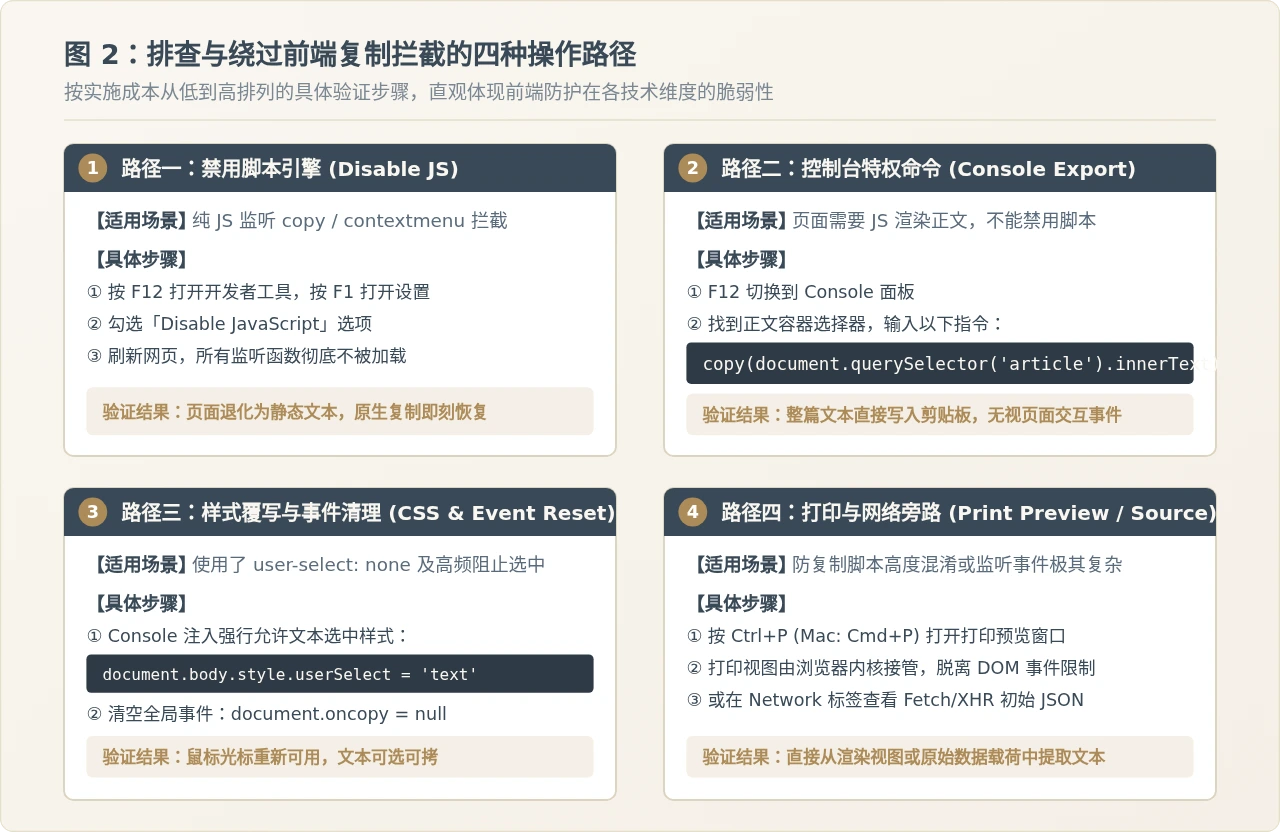
二、绕过 JS 禁止复制的四种典型操作路径
正是由于防护逻辑完全暴露在客户端,任何具备基础浏览器知识的用户都可以利用现成的工具进行调试和旁路提取。以下是四种常见的绕过步骤与验证方法:
-
路径一:直接禁用浏览器 JavaScript 引擎
如果目标网站属于传统的服务端渲染(SSR)页面,文章正文在初始 HTML 中就已经完整加载,那么最彻底的方法就是让所有防复制脚本根本不执行:
- 在页面中按下
F12打开浏览器开发者工具(DevTools)。 - 在 DevTools 窗口内按
F1(或点击右上角齿轮图标)进入设置面板(Settings)。 - 在偏好设置中找到“Preferences” → “Debugger”,勾选 “Disable JavaScript”。
- 刷新网页。此时页面由于没有 JavaScript 运行,所有
copy和selectstart监听器全部失效,文本恢复原生随意选中与复制状态。
- 在页面中按下
-
路径二:通过 DevTools 控制台直接提取 DOM 文本
在单页应用(SPA)中,若禁用 JS 会导致页面无法正常渲染,则可以采用控制台提权读取:
- 按
F12切换至 Console(控制台) 标签页。 - 利用浏览器专为开发者提供的
copy()特权命令,直接将指定 DOM 节点的纯文本抽取并写入系统剪贴板,彻底避开任何鼠标和键盘事件:
// 选取正文容器,将文本直接注入剪贴板(无需手动选区或触发UI事件)
copy(document.querySelector('article').innerText);
执行后按下
Ctrl + V(Mac 上为Cmd + V),即可在任意编辑器中粘贴完整的纯净正文。 - 按
-
路径三:覆盖 CSS 样式与重写事件处理器
如果网页通过样式限制了光标高亮,可以通过在控制台注入高优先级样式或清除事件监听:
- 打开控制台,运行以下两行代码重置选区样式并解绑全局监听:
// 强制重置 user-select 样式
document.body.style.userSelect = 'text';
document.querySelectorAll('*').forEach(el => el.style.userSelect = 'text');

// 移除原型链或全局钩子
document.oncopy = null;
document.onselectstart = null;
document.oncontextmenu = null;
完成执行后,鼠标拖拽选择与右键菜单立即恢复正常。
-
路径四:利用打印预览或网络请求旁路获取
如果页面脚本经过深度混淆或动态定时重绑定监听器,还可以跳过 DOM 交互层,直接进入浏览器其他子系统:
- 按下
Ctrl + P(Mac 为Cmd + P)调出浏览器的原生打印预览面板。浏览器在生成打印排版时,不会执行页面的交互事件监听,用户可以直接在预览界面的文档视图中正常拖拽选区并复制文本。 - 或者在 DevTools 的 Network(网络) 面板中,检查文章内容接口返回的原始 JSON 响应,直接复制其中的数据字段。
- 按下
三、前端防护手段与失效根因对照
为了更清晰地对比各种前端手段的实际效果,我们将常见的防复制机制与其绕过难度、体验影响整理为如下矩阵:
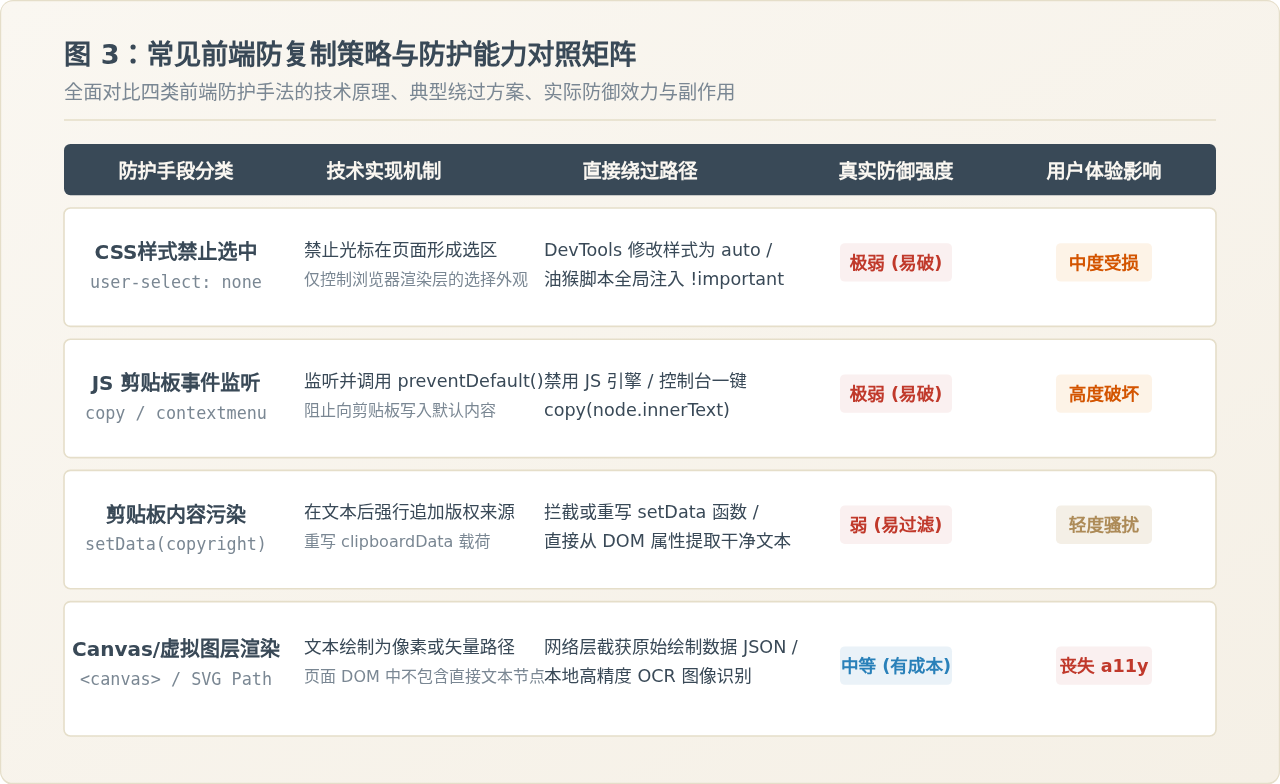
过度使用 user-select: none 或禁用右键,不仅无法防住技术人员,还会导致正常的读者无法复制专有名词、无法使用划词翻译插件、无法使用无障碍屏幕阅读器,从而引发用户的反感甚至流失。
四、为什么前端无法建立真正的“安全边界”?
从更底层的计算机体系结构与 Web 架构来看,JS 禁止复制容易被绕过并不是某一段代码写得好不好的问题,而是受制于 Web 前端的三大固有局限性:
1. 控制权倒置与零信任宿主(Host Superiority)
在传统的服务端程序中,服务器硬件、操作系统和运行时环境都由开发者掌控,外部用户无法窥探其内存或随意修改执行流程。然而在 Web 前端,这一关系发生了彻底的倒置:客户端代码是运行在用户所有的硬件和浏览器之上的。浏览器是用户的“代理人(User Agent)”,它提供了断点调试、代码重写、变量监视和环境隔离等一切特权。因此,在客户端架构中,前端代码对运行环境没有任何主导权,任何所谓的防御逻辑都处于随时可被改写的透明状态。
2. 内容呈现的物理悖论:可见即可读
前端界面的终极任务是“让用户能够阅读内容”。为了让人眼在显示器上看到汉字,计算机必须经历一套确定的数据链路:网络传输加密数据 → 浏览器解密为文本流 → HTML 树构建 → 样式计算与文本排版 → GPU 光栅化渲染成像素。这就构成了一个不可调和的矛盾:只要用户能在屏幕上看到文字,该文字在内存中就已经完成了明文解码。既然内存中已经存在明文,宿主浏览器、调试工具或操作系统截图 OCR 工具就必定能够读取它。
3. 混淆与对抗的边际成本极不对称
有的开发者试图通过复杂的技术增加复制难度,例如将文字打碎混排在不同的绝对定位 <span> 中、利用伪元素 ::after 的 content 属性插入文本、甚至用 Canvas 画布直接绘制字形。然而,这些对抗手段带来的开发与维护成本呈指数级上升,且会带来致命的副作用:搜索引擎爬虫(SEO)无法索引正文、页面加载性能暴跌、屏幕阅读器完全失灵。而攻击者只需写几行脚本遍历样式或直接调用本地 OCR 识别,即可在几十毫秒内化解数周的防护研发投入。
五、内容保护的合理工程边界与防御架构
既然前端禁止复制无法形成绝对的安全防线,是否意味着网站完全不需要做任何防护?答案是否定的。关键在于明确前端防护的定位边界,并采用分层防御架构:
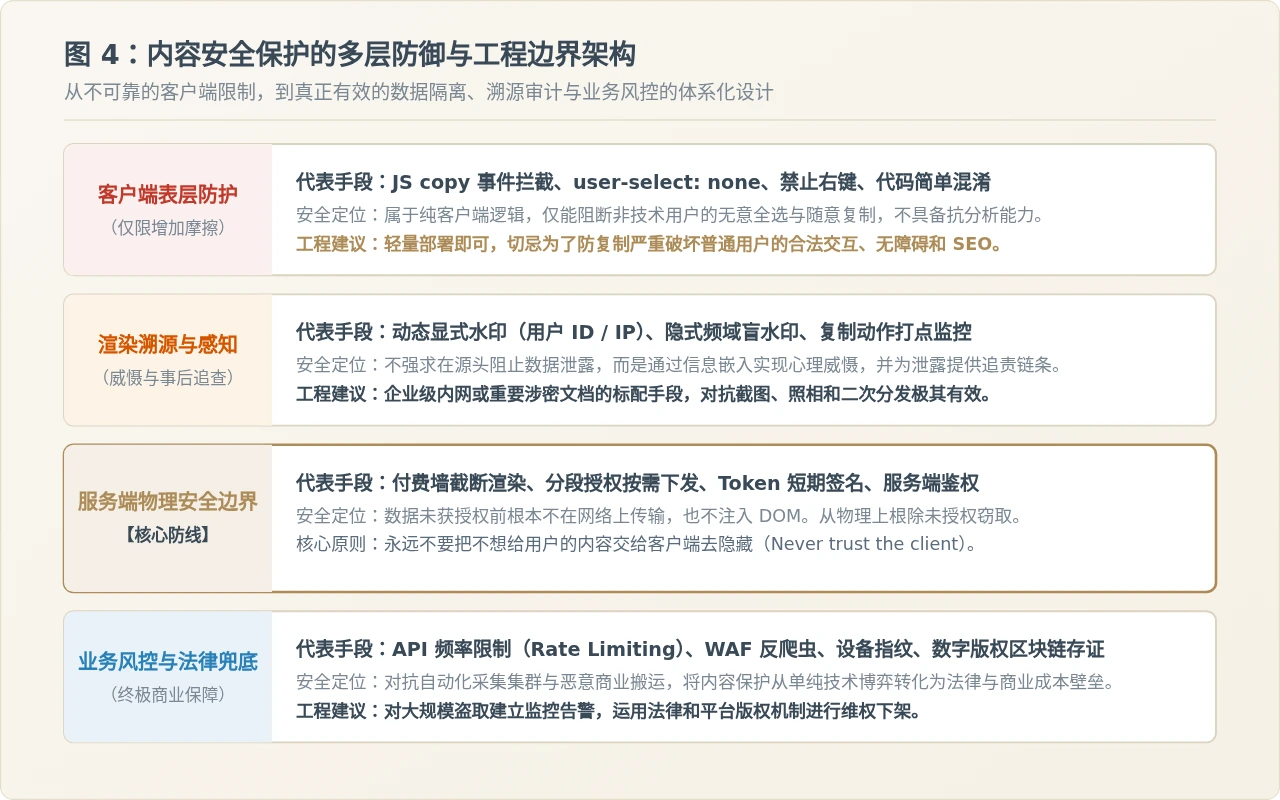
在现代软件工程实践中,有效的内容保护应当遵循以下分层原则:
- 将前端限制定位为“防君子不防小人”的减速带:轻度的复制拦截(例如简单的版权提示或限制误触)可以阻止大量非技术用户的随手全选与无意识搬运。但切勿在此耗费过多精力,更不可使用破坏基础可用性的极端手法。
- 服务端物理截断(真正的核心防线):对于付费内容、会员专享文章,绝不能“将全文全部下载到前端再用 CSS 遮罩隐藏”。必须在服务端进行内容鉴权,未付费用户仅下发试读段落,从物理根源上避免未授权内容进入客户端内存。
- 建立动态追踪与溯源机制:在正文中动态渲染带有当前登录用户 ID 或 IP 地址的隐式/显式数字水印。这种做法不强行阻止复制,但能对恶意截图、盗版扩散形成极强的心理威慑,并在发生泄露时提供可信的追责依据。
- 网络层与业务风控:通过 API 频率限制(Rate Limiting)、WAF 防爬规则及异常行为分析,拦截大规模自动化爬虫集群,保护网站的整体数据资产。
移动端浏览器JS禁止复制失效的兼容性问题解决
2026-11-17 20:09:10
JS脚本语言与Java编译型语言的核心区别
2026-11-17 19:19:50
主流js导出word库对比:docx.js、html-docx-js与mammoth.js选型指南
2026-11-17 17:41:40
JavaScript在指定位置插入HTML片段的四种方式
2026-11-17 12:37:40
JavaScript单选按钮点击事件未触发的常见原因及解决
2026-11-17 12:30:06