JS创建div时怎么安全地设置文本内容防止XSS
在JavaScript中动态创建div元素时,如何通过textContent或createTextNode安全设置用户文本内容,避免innerHTML带来的XSS跨站脚本注入风险与实现原理详解。
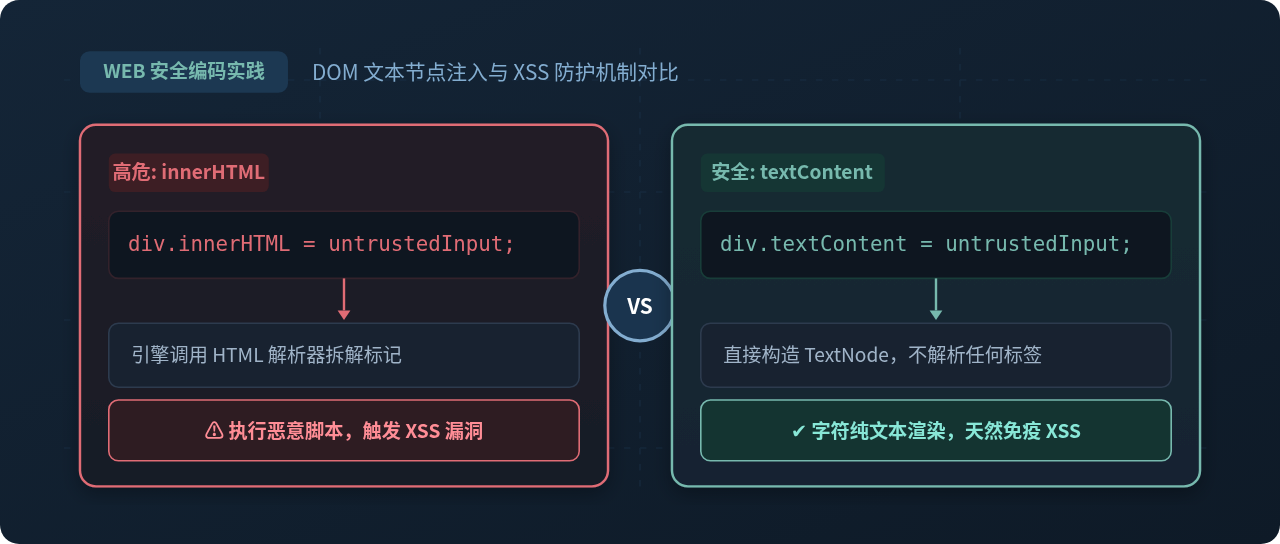
假设你在开发一个留言板或网页即时聊天组件,用户在输入框中输入自己的昵称并点击发送,前端 JavaScript 需要实时在页面列表中创建一个新的 <div> 容器,并将该昵称渲染展示出来。如果在这个环节直接把用户输入的字符串赋值给 div.innerHTML,当恶意用户输入形如 <img src=x onerror="alert(1)"> 的文本时,浏览器会将其作为真实 HTML 标记解析并立即执行脚本,导致典型的 DOM 型跨站脚本(DOM-based XSS)漏洞。安全设置文本内容的核心解法是:直接使用 div.textContent = userInput,或者通过 document.createTextNode(userInput) 创建独立的文本节点。 这两类原生 API 会将输入内容无条件作为纯字符流挂载至 DOM 树的底层文本节点中,彻底跳过浏览器的 HTML 标记解析器,从语法根源阻断脚本的执行路径。
一、为什么 innerHTML 会带来严重的 XSS 隐患?
在 DOM 标准中,innerHTML 是一个用于读取或设置元素内部 HTML 标记序列的属性。当脚本向 div.innerHTML 赋予一个字符串时,浏览器引擎并不会把它当作普通的“字”来看待,而是会立即启动内部的 HTML 解析器(HTML Parser)。
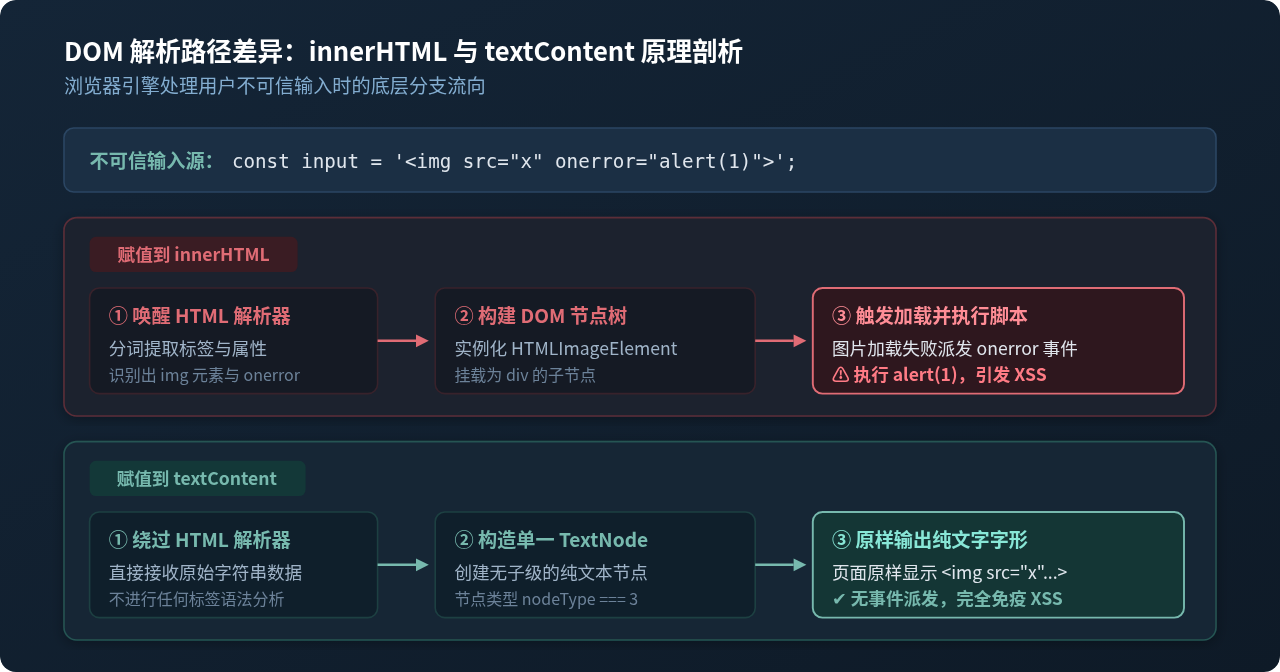
HTML 解析器会对传入的字符串执行词法分析(Lexing)与语法分词(Tokenization)。如果字符串中包含了 <、> 等字符,解析器便会构造对应的 DOM 元素节点树。例如输入的内容是 <img src="invalid" onerror="sendUserCookie()">:
- 解析器首先识别出
<img>标签,并实例化一个HTMLImageElement节点挂入div的子节点列表中; - 随后解析器提取其属性,识别出
onerror事件处理函数; - 当浏览器尝试加载无效的图片地址时,立即触发图片加载错误事件,进而毫无阻碍地执行
onerror中包含的恶意 JavaScript 代码。
攻击者不仅可以利用此类脚本弹窗干扰,还可以悄悄窃取当前用户的 document.cookie、读取局部存储中的身份 Token,甚至伪造当前用户的身份向后台发起非法请求。因此,只要待插入的数据来自用户输入、URL 查询参数、后端未脱敏接口或第三方存储,就绝不能直接写入 innerHTML。
二、安全设置纯文本的标准实现方案
为了保证动态创建的 div 绝对免受 XSS 威胁,核心原则是将外部数据限定在“纯文本数据”边界内,不给浏览器任何触发 HTML 解析器的机会。原生 DOM 提供了清晰且高性能的解决方案。
方案 1(最推荐):使用 element.textContent
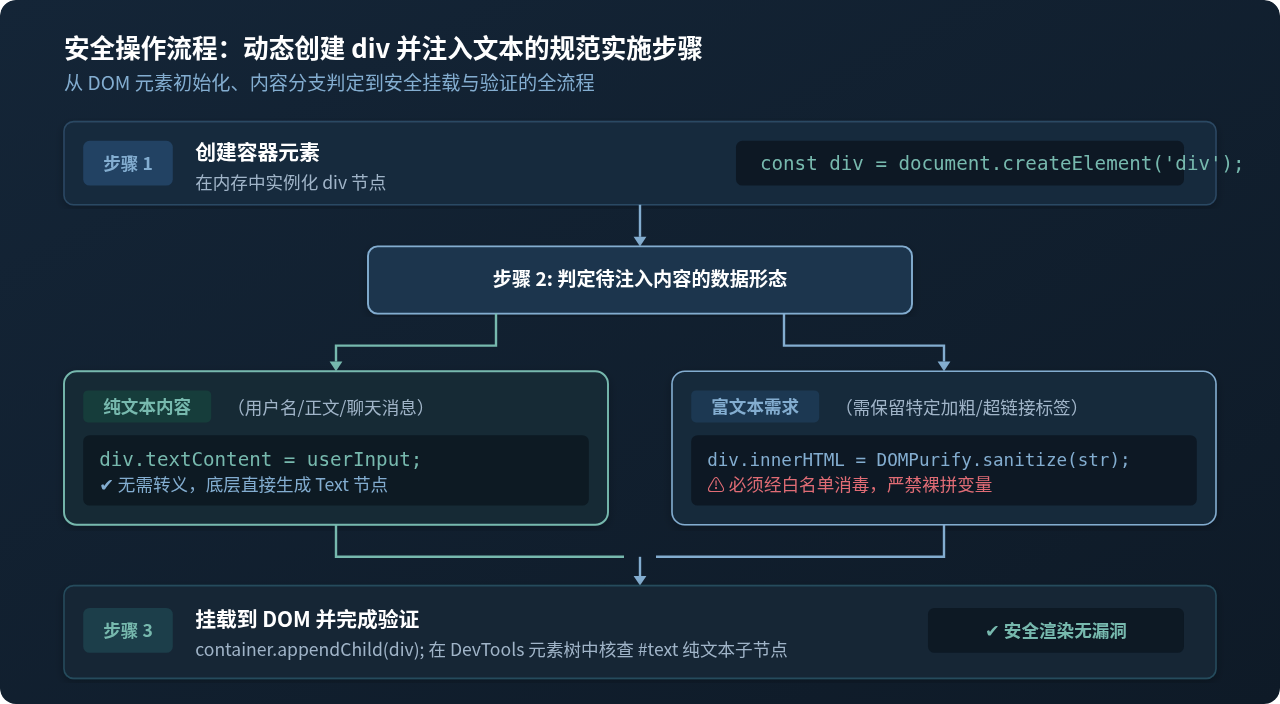
在标准的 DOM 树结构中,textContent 是定义在基础 Node 接口上的属性。向 div.textContent 赋值时,浏览器会清空当前 div 内部所有的现有子节点,并在其内部创建一个包含指定纯文本内容的单个 Text 节点。即使文本中包含大量 <script>、<img> 或 <iframe> 标记,它们也只会被视为 Unicode 字符本身,原样输出在屏幕上,绝对不会被转换为可执行的 DOM 元素。
// 1. 在内存中创建新的 div 元素
const messageDiv = document.createElement('div');

// 2. 模拟从外部表单或接口获取的不可信用户输入
const untrustedInput = '<img src="x" onerror="alert(document.cookie)">';

// 3. 安全设置纯文本内容:直接赋值给 textContent
messageDiv.textContent = untrustedInput;

// 4. 将配置好的元素挂载到页面的容器中
document.getElementById('chat-container').appendChild(messageDiv);
该方案不仅语法精炼、执行性能极高(避免了复杂字符串的语法树拆解),而且现代所有主流浏览器全面支持,是处理纯文本动态展示的行业标准首选。
方案 2:使用 document.createTextNode 显式创建文本节点
如果你希望在 DOM 构建流程中保持纯粹的节点组合模型,可以使用工厂方法 document.createTextNode()。这种做法在概念上更加直观地揭示了 DOM 树的本质:DOM 树是由不同类型的 Node 组成的层级树,div 是元素节点(nodeType === 1),而包裹文字的是文本节点(nodeType === 3)。
// 1. 创建容器 div 元素
const messageDiv = document.createElement('div');

// 2. 将不可信输入显式包装为独立的 TextNode
const textNode = document.createTextNode(untrustedInput);

// 3. 作为子节点追加到 div 中
messageDiv.appendChild(textNode);

// 4. 挂载到宿主文档树
document.getElementById('chat-container').appendChild(messageDiv);
显式创建文本节点与赋值 textContent 在底层安全机制上完全一致,同样绝不调用 HTML 解析器。当你需要在一个 div 中连续追加多个混合格式的子节点(例如前置一个图标元素,紧接着追加用户名纯文本)时,createTextNode 提供了非常精准的节点追加控制能力。
方案 3:关于 element.innerText 的适用性与差异说明
部分初学者会混淆 textContent 与 innerText。innerText 同样不会解析 HTML 标记,因而用它设置文本内容同样能够免疫 XSS。但 innerText 并非纯粹的 DOM 抽象,它依赖于浏览器的视觉渲染树(Render Tree):
- 性能开销较大:给
innerText赋值或读取时,浏览器为了计算文本样式与换行,通常会触发页面的样式重算与重排(Reflow/Layout); - 对隐藏元素的感知差异:当元素处于未挂载状态或应用了
display: none样式时,innerText的行为可能与页面展示逻辑发生耦合; - 空白符转换:
innerText会将多余的换行符或空格做规范化合并,而textContent则严格保留字符串中的所有字符。
因此在仅为了安全写入文本的常规需求中,推荐优先选用执行效率更高、行为更纯粹的 textContent。
三、核心 DOM 文本 API 特性与安全性对照
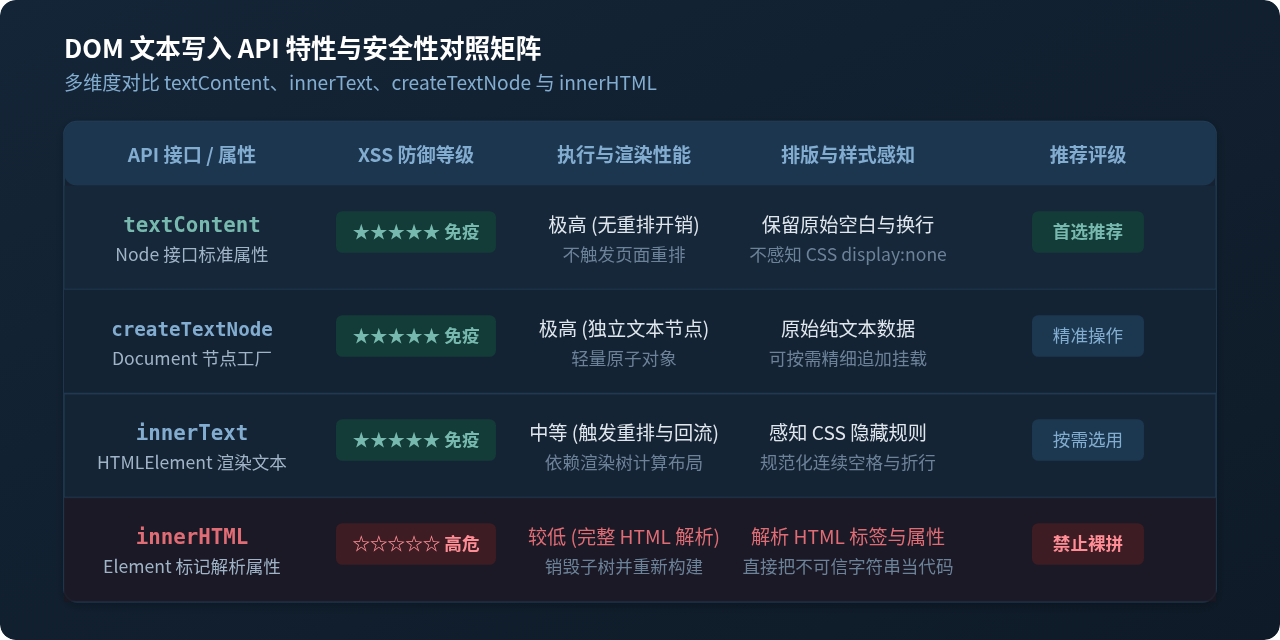
为了在团队协作与日常开发中明确选型依据,下表总结了常见的文本操作 API 在安全性、性能与排版行为上的综合表现:
| API / 属性 | XSS 防御能力 | 底层工作机制 | 重排性能开销 | 样式与空白感知 |
|---|---|---|---|---|
element.textContent |
完全免疫(安全) | 直接将字符写入 TextNode,绕过 HTML 解析器 | 极低(无布局计算开销) | 保留原始换行与连续空白,不感知 CSS |
document.createTextNode |
完全免疫(安全) | 创建独立的纯文本原子节点对象 | 极低(标准轻量节点) | 保留原始字符数据,需显式 appendChild |
element.innerText |
完全免疫(安全) | 依赖渲染树提取或应用可见文本内容 | 中等(触发样式重算与重排) | 遵循 CSS 换行与隐藏规则(忽略隐藏节点) |
element.innerHTML |
高危(未过滤易遭攻破) | 启动完整 HTML 解析器拆解标记与属性 | 较高(重构子 DOM 树) | 将字符串作为 HTML 标记解析执行 |
四、场景延伸:如果确需支持安全富文本,该如何处理?
在实际业务中,我们有时不仅要显示纯文字,还希望允许用户输入少量被许可的格式化内容,例如简单的 <b> 加粗排版或合法的超链接 <a>。此时既不能盲目使用纯文本屏蔽所有标签,也不能放任未经检查的字符串直接写入 innerHTML。
1. 引入工业级白名单清洗库(DOMPurify)
切勿尝试自行编写正则表达式去匹配过滤 <script> 标签。XSS 载荷的多样性极高(大小写混淆、属性事件混淆、畸形标签、编码绕过等),自研正则几乎必然存在漏网之鱼。行业标准做法是引入经过广泛攻防验证的开源清洗库,例如 DOMPurify:
// 引入 DOMPurify 后的安全富文本渲染流程
const richDiv = document.createElement('div');

// 模拟包含恶意脚本但夹杂正常加粗标签的用户输入
const rawInput = '<b>欢迎光临!</b><img src=x onerror="alert(1)">';

// 经由 DOMPurify 白名单清洗,危险属性和标签会被自动剥离
const cleanHTML = DOMPurify.sanitize(rawInput);

// 安全注入清洗后的内容
richDiv.innerHTML = cleanHTML;
document.getElementById('content-area').appendChild(richDiv);
DOMPurify 会在浏览器内存中把字符串解析为 DOM 树片段,逐个遍历节点与属性,仅保留白名单中的安全元素(如 <b>、<i>、<span>),彻底剥离 onerror、onclick 等事件处理器以及 javascript: 伪协议。
2. 原生组件化结构拆解构建
如果格式需求非常固定(例如仅仅是“头像 + 用户名 + 文本消息”),完全不需要使用富文本解析,而是可以借助纯 DOM 方法拼装多个子元素:
function createMessageCard(avatarUrl, userNameText, messageContentText) {
  const container = document.createElement('div');
  container.className = 'message-card';

  // 安全设置头像:使用 setAttribute 或直接属性赋值,确保来源为标准图片链接
  const img = document.createElement('img');
  img.src = avatarUrl;
  container.appendChild(img);

  // 安全设置用户名:纯文本一律用 textContent
  const nameEl = document.createElement('span');
  nameEl.className = 'user-name';
  nameEl.textContent = userNameText;
  container.appendChild(nameEl);

  // 安全设置正文
  const bodyEl = document.createElement('p');
  bodyEl.textContent = messageContentText;
  container.appendChild(bodyEl);

  return container;
}
通过清晰的 DOM 组件化拆分,各部分职责明确,所有不可信的文本内容均被紧紧收敛在 textContent 之中,既保证了排版弹性,又拥有最高级别的安全性。
五、防范 DOM 型 XSS 的进阶注意事项与防御全景
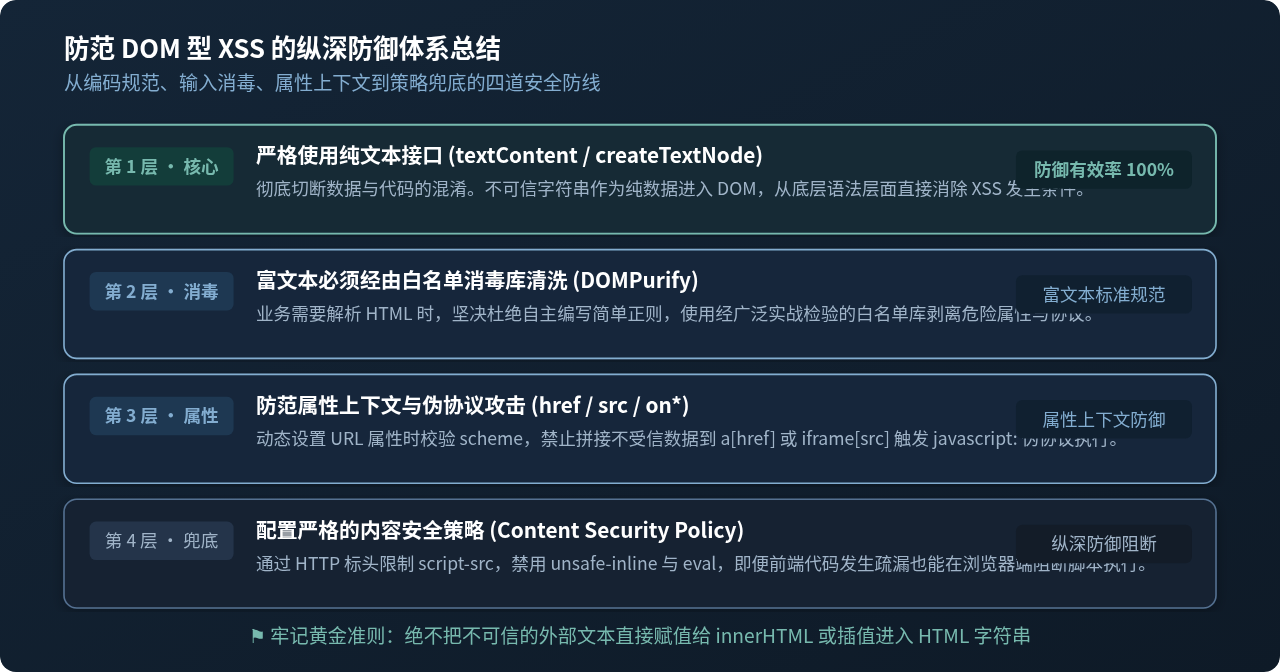
虽然为 div 设置纯文本使用 textContent 已经杜绝了文本节点层面的 XSS,但在实际项目中,还要注意以下两种容易被忽视的隐蔽漏洞形式:
- 防范属性层面的伪协议注入:如果你在创建
div时,同时动态为其添加链接或自定义属性(例如const a = document.createElement('a'); a.href = userUrl;),若userUrl的值为javascript:alert(1),即使用户名用了textContent,当点击链接时仍然会触发脚本执行。因此动态设置 URL 类属性时,必须严格校验协议头是否属于http:或https:。 - 警惕从 textContent 取出后的二次模板字符串拼接:有的开发者先使用
tempDiv.textContent = userInput尝试“转义”,随后又写出container.innerHTML = `<div>${tempDiv.innerHTML}</div>`。这种重复混合使用的逻辑容易因理解偏差埋下二次解析的安全盲区,坚决建议统一在最终挂载节点上直接使用安全方法。 - 配置内容安全策略(CSP)兜底:在 Web 服务的 HTTP 响应头中配置严格的
Content-Security-Policy: default-src 'self'; script-src 'self';,禁止页面执行任何未授权的内联脚本(inline script)与eval,为前端应用构建纵深防御兜底网。
六、验证与结果确认方法
在编写完代码后,可以通过以下简单测试用例在本地浏览器控制台中直接验证安全性:
// 在浏览器 DevTools Console 中执行验证
const testDiv = document.createElement('div');
const xssPayload = '<img src="x" onerror="console.error(\'XSS VULNERABLE\')"><script>console.error(\'XSS\')</script>';

// 采用安全赋值
testDiv.textContent = xssPayload;
document.body.appendChild(testDiv);

// 结果验证核对:
// 1. 控制台不会出现任何红色的 "XSS VULNERABLE" 报错,说明未触发事件;
// 2. 页面上如实把 "<img src=...>" 作为可见字形完整渲染在屏幕上;
// 3. 打开 Elements 面板展开 testDiv,可以看到其内部仅有一个纯文本节点 #text,而没有 img 或 script 子标签。
通过养成“涉及外部输入的文本填充一律走 textContent,涉及标记渲染一律先消毒”的编码本能,即可在开发阶段从根源上杜绝 DOM 型 XSS 隐患的产生。
利用ES6+新特性重构JavaScript网站代码的设计技巧
2026-11-16 13:24:03
JavaScript三元运算符嵌套使用的规范与可读性优化
2026-11-16 13:19:29
VS Code 1.145.3安全维护怎么避免混淆Stable、Insiders和平台安装包
2026-11-16 10:07:52
Node.js适合做什么不适合做什么:IO密集型与CPU密集型的界限
2026-11-12 22:43:33
JS循环拼接大量字符串为何推荐用array.join
2026-11-12 14:28:46