

Node.js主要应用场景有哪些:Web后端、API与前端工程化工具
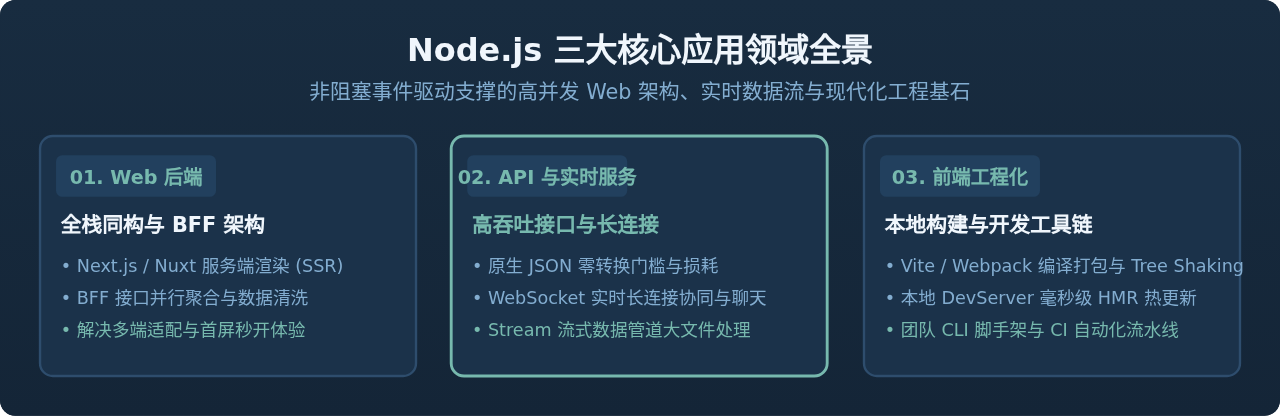
全面解析Node.js的三大核心应用场景:Web后端与BFF服务层、高并发API与实时通信、前端工程化工具链。通过深入浅出的原理剖析、架构配图与实践代码,厘清技术优势与选型边界。
一、Node.js 的底层能力支撑:为什么它能横跨多领域?
要理解 Node.js 的落地场景,必须先明确它在计算机系统中的本质定位。Node.js 并不是一门新的编程语言,而是基于 Google Chrome V8 引擎构建的开源、跨平台 JavaScript 运行时环境(Runtime Environment)。在此之前,JavaScript 只能受限在浏览器沙箱内操作 DOM;Node.js 的出现,赋予了 JavaScript 自由访问本地操作系统底层、读写文件系统、管理网络套接字(Socket)以及监听端口的能力。
真正决定 Node.js 适用场景的,是其独特的底层并发机制:单线程事件驱动(Event-Driven)与非阻塞 I/O(Non-blocking I/O)。在传统的基于多线程并发模型的服务器(如传统的 Apache HTTP Server 或早期的 Java Servlet 容器)中,每当有一个客户端发起网络请求或文件读写,服务器就需要分配一个专属线程去承接。当该请求需要查询耗时 200 毫秒的数据库时,该线程必须原地阻塞等待,期间内存与 CPU 上下文切换开销持续消耗。如果同时涌入 5000 个长连接,系统的线程栈内存将迅速耗尽。
Node.js 则采用了完全相反的设计思路:由单一主线程执行 V8 引擎解析出的 JavaScript 代码,当遇到网络请求、数据库查询、磁盘读写等耗时 I/O 操作时,主线程不会停下来等待,而是立刻将任务下沉派发给底层的 libuv 异步事件库和操作系统内核(利用 Linux 的 epoll、macOS 的 kqueue 或 Windows 的 IOCP)。当底层 I/O 准备就绪时,再将对应的回调函数加入就绪队列,由事件循环(Event Loop)在主线程空闲时有序取出执行。
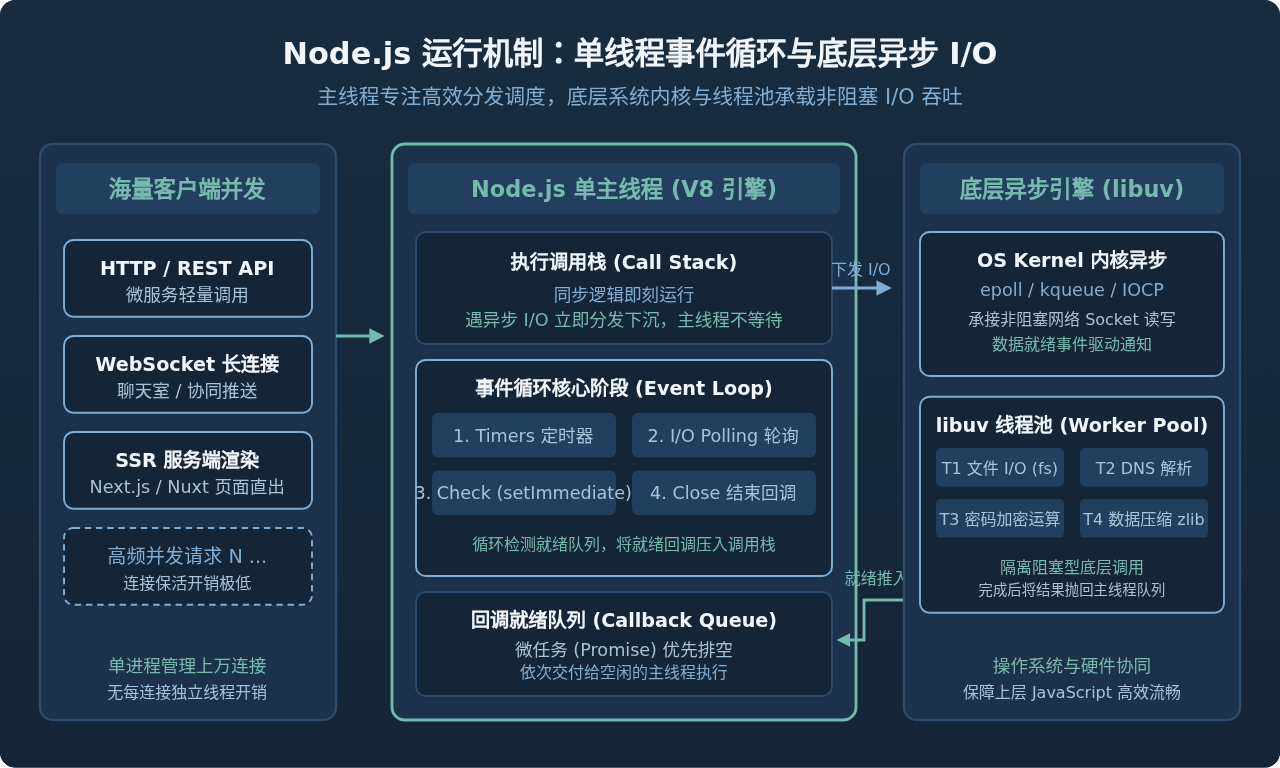
这种机制造就了 Node.js 最核心的技术特质:以极小的内存占用与极低的调度成本,轻松维持数万并发连接与高频 I/O 吞吐。这一特性直接决定了它在接下来三大场景中的统治力。
二、应用场景一:Web 后端与 BFF 服务层
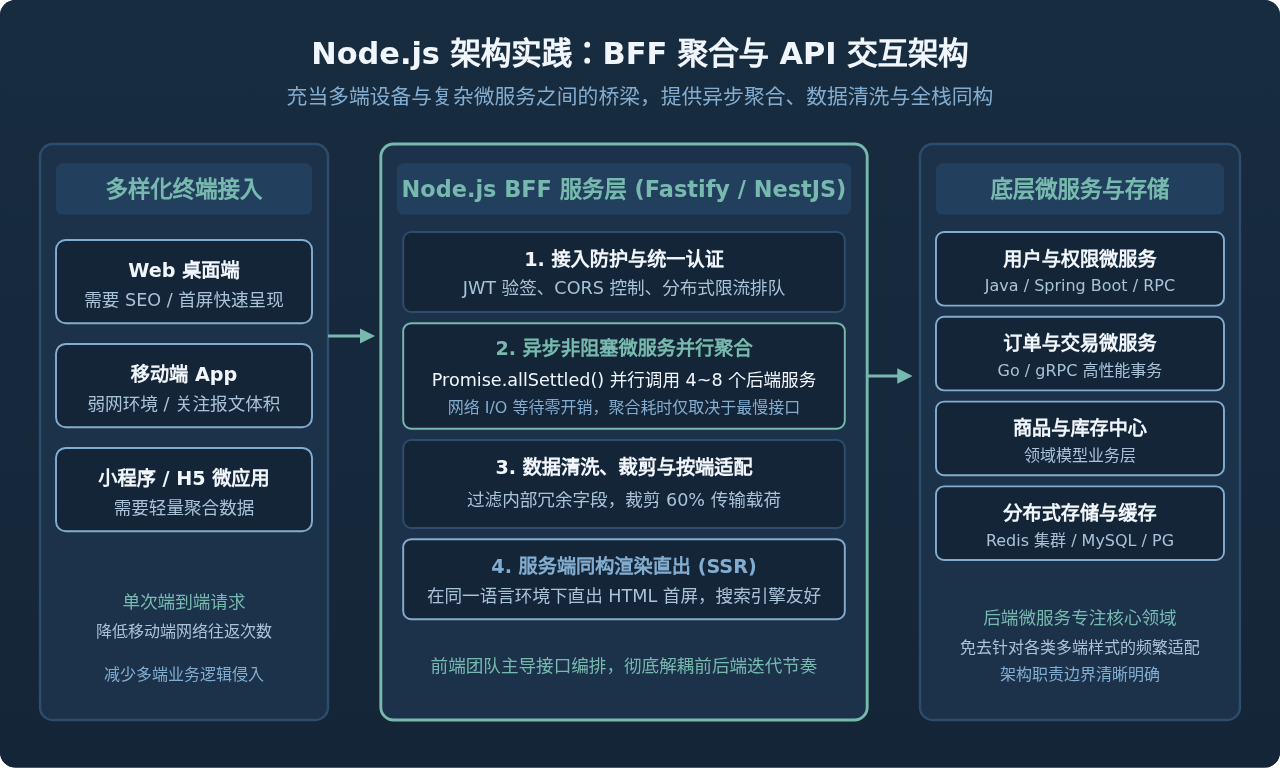
在现代 Web 应用架构中,Node.js 并没有盲目去替代承载重度复杂金融交易或大数据计算的 Java / Go 底层核心,而是在前端用户界面与企业底层微服务之间,开辟了最具战略价值的生态位——BFF(Backend For Frontend)中间聚合层与同构 SSR 服务。
1. 服务端渲染(SSR)与前后端同构(Isomorphic Web)
在单页应用(SPA)盛行的背景下,浏览器端纯客户端渲染存在两个天然痛点:首屏加载时间长(必须等大体积 JS 资源下载、解析并执行后页面才出现内容)以及搜索引擎爬虫索引困难(不利于 SEO)。
借助 Node.js,Next.js(React 生态)与 Nuxt(Vue 生态)等框架实现了“前后端同构”:同一套页面组件代码,既能在 Node.js 服务端提前运行渲染成完整的 HTML 静态字符串直接推送给浏览器,实现首屏毫秒级直出;又能由浏览器在后台下载轻量 JS 完成客户端激活(Hydration),无缝承接后续流畅的单页交互体验。这种前后端零语言壁垒的同构渲染能力,只有 Node.js 能原生且低成本地完成。
2. BFF 模式:微服务接口聚合与数据清洗
在大型企业架构中,底层通常拆分了数十个专门的微服务(用户服务、商品服务、积分服务、订单服务等)。如果让手机端 App、微信小程序或 Web 浏览器直接分别请求这些底层微服务,会面临灾难性的网络延迟:移动端弱网环境下需要发起 6~10 次 HTTP 请求,且每个底层接口返回的 JSON 都带有大量数据库原始字段,导致带宽被冗余数据严重吞噬。
引入 Node.js 作为 BFF 层后,前端团队可以直接掌管该服务:
- 并发异步聚合:利用 Node.js 强大的
Promise.all或异步流,向底层微服务并行发起多路非阻塞调用,网络等待时间重叠,总耗时仅取决于响应最慢的一个微服务。 - 数据深度裁剪与按端定制:清洗并剔除冗余和敏感字段,将原本 200KB 的复杂报文精简压缩为移动端仅需的 15KB 定制结构。
- 权限与防护统一收拢:负责统一的 Token / JWT 验签、限流防刷与跨域(CORS)配置。
3. 典型 BFF 并发聚合实现示例
下面是一个标准的 Node.js(基于原生现代 ES 规范)BFF 聚合接口实现。它通过并行异步非阻塞请求合并底层“用户信息”与“订单列表”,并带有安全容灾回退:
// bff-aggregator.mjs: Node.js BFF 数据聚合服务示例
import http from 'node:http';

const USER_SERVICE_URL = 'http://internal-user-svc:8081/api/v1/user/';
const ORDER_SERVICE_URL = 'http://internal-order-svc:8082/api/v1/orders?userId=';

// 封装带超时控制的非阻塞网络请求
async function fetchWithTimeout(url, timeoutMs = 800) {
  const controller = new AbortController();
  const timer = setTimeout(() => controller.abort(), timeoutMs);
  try {
    const res = await fetch(url, { signal: controller.signal });
    if (!res.ok) throw new Error(`HTTP error: ${res.status}`);
    return await res.json();
  } finally {
    clearTimeout(timer);
  }
}

const server = http.createServer(async (req, res) => {
  if (req.method === 'GET' && req.url.startsWith('/api/dashboard/')) {
    const userId = req.url.split('/')[3];
    res.setHeader('Content-Type', 'application/json; charset=utf-8');

    try {
      // 并行请求底层微服务:总网络等待耗时为两者最大值,而非两者之和
      const [userResult, ordersResult] = await Promise.allSettled([
        fetchWithTimeout(`${USER_SERVICE_URL}${userId}`),
        fetchWithTimeout(`${ORDER_SERVICE_URL}${userId}`)
      ]);

      // 数据清洗与按端脱敏裁剪
      const responsePayload = {
        code: 200,
        data: {
          user: userResult.status === 'fulfilled'
            ? { id: userResult.value.id, nickname: userResult.value.name, avatar: userResult.value.avatarUrl }
            : { id: userId, nickname: '未知用户', avatar: '' },
          orders: ordersResult.status === 'fulfilled'
            ? ordersResult.value.list.slice(0, 5).map(o => ({ orderNo: o.id, amount: o.totalCent / 100, status: o.state }))
            : [],
          degraded: ordersResult.status === 'rejected' // 标记是否存在降级
        }
      };

      res.writeHead(200);
      res.end(JSON.stringify(responsePayload));
    } catch (error) {
      res.writeHead(500);
      res.end(JSON.stringify({ code: 500, message: 'BFF Gateway Error' }));
    }
  } else {
    res.writeHead(404);
    res.end(JSON.stringify({ code: 404, message: 'Not Found' }));
  }
});

server.listen(3000, () => {
  console.log('[BFF Server] Running on http://localhost:3000');
});
AbortController 与 Promise.allSettled)。切忌让没有超时控制的悬垂请求堆积在事件循环队列中,避免下游微服务故障扩散导致 Node.js 内存耗尽。
三、应用场景二:高效 API 接口与实时通信服务
第二大经典应用场景是高吞吐 RESTful / GraphQL API 接口与 WebSocket 实时推送系统。在这些场景中,系统的性能瓶颈通常不是复杂的数学计算,而是频繁的网络 I/O 交换与大量并发连接保活。
1. 原生 JSON 契约与零开销序列化
现代 Web 与移动应用的基础数据交互格式几乎全部采用 JSON。在传统的强类型编译型语言中,处理 JSON 通常需要依赖反射或额外的反序列化映射库,产生对象转换开销与类型映射损耗。而在 Node.js 环境中,JSON 本就是 JavaScript 的天然子集,JSON.parse() 和 JSON.stringify() 均通过 V8 引擎底层 C++ 高度优化,能够以极其简洁的代码完成复杂报文解析、字段过滤与数据透传。
2. WebSocket 长连接与实时协作服务
实时应用(如多人在线协同文档、白板画板、即时通讯聊天室、金融大盘实时报价、游戏匹配大厅)要求成千上万个客户端与服务器保持长久的 TCP/WebSocket 连接,并在有事件发生时毫秒级广播推送。
在基于多线程模型的框架下,为每个闲置连接维持一个线程会浪费数 MB 的栈内存;而 Node.js 仅依靠一个主事件循环,配合底层 Linux epoll 事件通知,单台 2 核 4G 的基础服务器便可轻松维持 3 万至 5 万个并发长连接,连接空闲时的内存消耗极低。当消息产生时,以非阻塞广播形式迅速推送到目标 Socket 缓冲区,具有无可比拟的轻量级与吞吐优势。
3. 大文件流式传输(Streaming)与管道处理
在处理文件上传下载、日志管道转发或音视频切片传输时,如果将一个 2GB 的大文件一次性读取到内存中,会导致 Node.js 堆内存(V8 默认上限通常在 2GB~4GB)瞬间溢出(Heap Out of Memory)。
Node.js 的核心模块 stream 提供了强大的流式分块处理机制。通过 pipeline,数据以 64KB 左右的缓冲块(Chunks)在生产者与消费者之间流转,并具备背压(Backpressure)机制:如果消费者处理慢,管道会自动暂缓上游读取,使得内存占用自始至终稳定在几 MB 级别。
// stream-pipeline.mjs: 使用 Node.js Stream 管道实现大文件流式压缩与下载
import http from 'node:http';
import fs from 'node:fs';
import zlib from 'node:zlib';
import { pipeline } from 'node:stream';

const server = http.createServer((req, res) => {
  if (req.url === '/download/report.csv.gz') {
    const sourceFilePath = './data/large_report.csv';

    // 检查文件是否存在
    if (!fs.existsSync(sourceFilePath)) {
      res.writeHead(404, { 'Content-Type': 'text/plain' });
      return res.end('File Not Found');
    }

    // 设置下载与压缩响应头
    res.writeHead(200, {
      'Content-Type': 'application/gzip',
      'Content-Disposition': 'attachment; filename="report.csv.gz"'
    });

    // 建立流式处理管道:磁盘读取流 -> Gzip 实时压缩流 -> HTTP 响应写入流
    const readStream = fs.createReadStream(sourceFilePath);
    const gzipStream = zlib.createGzip();

    pipeline(readStream, gzipStream, res, (err) => {
      if (err) {
        console.error('[Stream Error] 管道处理异常:', err.message);
        if (!res.headersSent) {
          res.writeHead(500, { 'Content-Type': 'text/plain' });
          res.end('Server Stream Error');
        }
      } else {
        console.log('[Stream Success] 文件流式压缩传输完成');
      }
    });
  } else {
    res.writeHead(200, { 'Content-Type': 'text/plain' });
    res.end('Node.js Streaming Service Active');
  }
});

server.listen(4000, () => {
  console.log('[Stream Service] Listening on http://localhost:4000');
});
fast-json-stringify),在路由解析和报文序列化上比传统方案快 2~3 倍。
四、应用场景三:前端工程化工具链与本地自动化
如果说在 Web 后端与 API 领域 Node.js 是一款优秀的“选修课”,那么在现代前端工程化领域,Node.js 则是绝对不可或缺的“必修课”与行业基石。当今任何一个前端项目(无论使用 Vue、React、Svelte 还是原生开发),其研发、编译、打包、测试与持续集成的全生命周期,全部运行在 Node.js 环境之上。
1. 构建与打包工具的宿主环境(Vite / Webpack / Rollup)
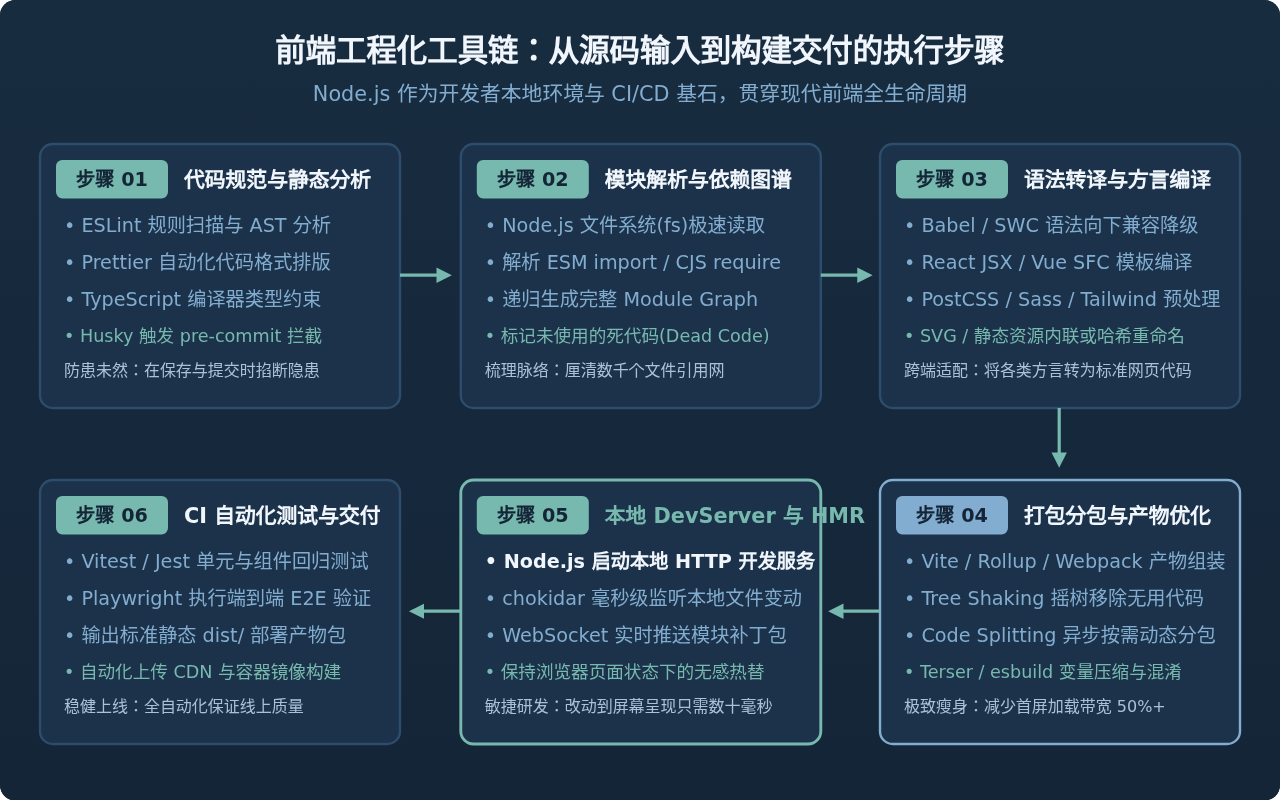
现代前端开发早已告别了手工编写单一 HTML/CSS 并通过浏览器打开的原始时代。开发者在日常工作中使用的是 TypeScript 静态类型系统、React JSX / Vue 单文件组件(SFC)、Tailwind CSS 原子化样式以及最新的 ECMAScript 语法。浏览器根本无法直接识别这些方言文件。
前端构建工具(如 Vite、Webpack、Rollup、Turbopack)必须借助 Node.js 提供的高性能文件系统 I/O、路径解析和模块依赖分析能力,递归遍历所有源码文件,建立完整的模块依赖图谱(Module Graph),并将它们快速转译、混淆、按需拆包(Code Splitting)和摇树优化(Tree Shaking),最终输出能够被各类浏览器兼容的静态生产资产包。
2. 本地敏捷开发服务与模块热替换(HMR)
在开发阶段,Node.js 充当了本地开发服务器的角色。通过内置的 HTTP 模块与第三方文件系统监听库(如 chokidar),Node.js 会实时监控本地源代码文件的细微变动:
- 开发者在编辑器中保存一段代码;
- Node.js 本地服务在几毫秒内捕获文件修改事件;
- 针对该特定模块进行极速增量编译,计算出代码差异补丁包(HMR Patch);
- 通过本地维持的 WebSocket 长连接,将补丁包实时推送到浏览器端;
- 浏览器页面在不刷新页面、保留当前填写表单或组件状态的情况下,无缝完成 UI 热更新。
这种极致的研发反馈循环,大幅提升了开发者的编码体验与团队迭代效率。
3. 团队 CLI 脚手架与 CI/CD 自动化脚本
大型研发团队通常需要统一工程标准。通过 Node.js 开发命令行工具(CLI),团队可以将复杂的初始化配置、代码规范校验与部署动作收敛为一个简单的终端命令(如 my-team create-project):
- 工程初始化:通过 CLI 交互式向导选择业务模板,自动拉取仓库、替换环境变量并安装依赖;
- 代码质量门禁:在提交代码前由 Husky 触发基于 Node.js 的
lint-staged,调用 ESLint 与 Prettier 确保入库代码符合统一规范; - 自动化集成流水线:在 Jenkins、GitHub Actions 或 GitLab CI 中,Node.js 自动化执行单元测试(Vitest / Jest)和端到端浏览器自动化验证(Playwright),构建出无误的容器资产镜像。
4. 实用示例:50 行代码实现本地构建与资源报告脚本
下面是一个完全无需外部依赖的纯 Node.js 原生脚本,展示了工程化工具如何读取本地文件、解析依赖大小并生成产物报告:
// build-analyzer.mjs: 简易工程化产物分析脚本(纯 Node.js 原生 API)
import fs from 'node:fs';
import path from 'node:path';

function scanAssets(dirPath) {
  const entries = fs.readdirSync(dirPath, { withFileTypes: true });
  let totalBytes = 0;
  const fileReport = [];

  for (const entry of entries) {
    const fullPath = path.join(dirPath, entry.name);
    if (entry.isDirectory()) {
      const sub = scanAssets(fullPath);
      totalBytes += sub.totalBytes;
      fileReport.push(...sub.fileReport);
    } else if (entry.isFile()) {
      const stat = fs.statSync(fullPath);
      totalBytes += stat.size;
      fileReport.push({
        fileName: path.relative(process.cwd(), fullPath),
        sizeKb: (stat.size / 1024).toFixed(2),
        ext: path.extname(entry.name)
      });
    }
  }
  return { totalBytes, fileReport };
}

// 执行扫描示例(假定扫描 dist 目录,若不存在则降级扫描当前目录)
const targetDir = fs.existsSync('./dist') ? './dist' : './';
console.log(`[Build Tool] 正在分析目录: ${targetDir} ...`);

const result = scanAssets(targetDir);
console.log('\n----- 静态产物构建报告 -----');
console.table(result.fileReport.slice(0, 10)); // 展示前 10 个核心文件
console.log(`总资产体积: ${(result.totalBytes / 1024 / 1024).toFixed(2)} MB`);
console.log('----------------------------\n');
五、场景选型决策与边界避坑指南
任何技术都有其物理极限与最佳适用场景。Node.js 的单主线程事件驱动模型在 I/O 密集型场景下表现惊艳,但在遇到重度计算场景时则必须保持审慎。
1. 选型决策:什么时候该用 Node.js?什么时候不该用?
| 业务与场景类型 | 是否推荐使用 Node.js | 核心收益与底层逻辑 | 注意点与架构替代方案 |
|---|---|---|---|
| BFF 接口聚合与前端网关 | 强烈推荐(首选) | 多路异步非阻塞调用,接口等待时间重叠;前端自主编排,沟通成本归零。 | 必须配置各微服务的超时阻断与熔断机制。 |
| 服务端渲染(SSR / SSG) | 强烈推荐(行业标准) | 组件层与浏览器端 100% 同构,兼顾首屏渲染速度与搜索引擎 SEO。 | 合理规划页面级与组件级缓存(Redis / CDN)。 |
| 即时通信与协作长连接 | 强烈推荐(首选) | 单机轻松维持数万并发 Socket,连接保活内存极低,原生 JSON 解析快。 | 多实例部署需结合 Redis Pub/Sub 实现跨节点广播。 |
| 前端构建与团队 CLI 工具 | 强烈推荐(事实标准) | 团队研发心智统一,无需安装额外语言环境;npm 庞大生态直接复用。 | 大型重度打包可选用基于 Rust/Go 编写的底层工具(如 Turbopack/esbuild)。 |
| 重度音视频转码与编解码 | 不推荐(直接主线程) | 长时间高负荷占用 CPU 会完全卡死主线程事件循环,导致所有网络请求超时雪崩。 | 应下沉至专门的 C++/Go/Rust 独立进程,或调用 FFmpeg 子进程。 |
| 复杂科学计算与大矩阵运算 | 不推荐(直接主线程) | V8 的数字运算与内存模型非面向张量科学计算设计,执行效率不及 C/C++/Python。 | 采用专用 Python/C++ 微服务,通过 gRPC 供 Node.js 调度。 |
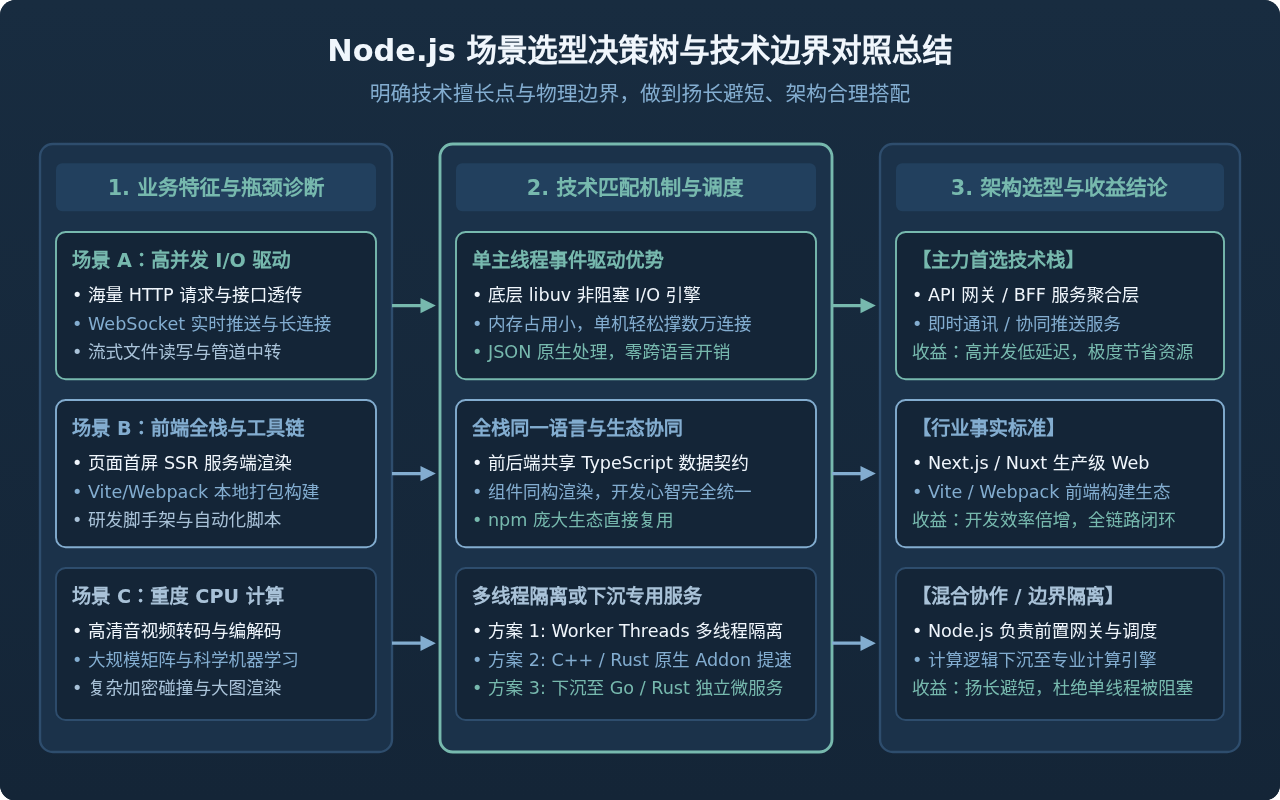
2. 遇到必须在 Node.js 中处理计算任务的补救方案
如果业务架构主体为 Node.js,但其中偶发包含部分轻度计算逻辑(如图片压缩、密码加密哈希计算、海量 Excel 报表导出),有以下三种规范的处理路径:
- 使用 Node.js 原生
worker_threads模块:将耗费 CPU 的计算任务派发到后台工作线程中执行,计算完成后通过线程间通信(MessageChannel)将结果返还主线程,杜绝主事件循环卡顿。 - 采用 C++ / Rust 原生插件(Addon / N-API):借助
napi-rs用 Rust 编写高性能计算模块并编译为.node二进制包,在享受 Node.js 易用性的同时压榨硬件极限性能。 - 微服务下沉:通过轻量 RPC 或消息队列,将计算请求解耦并派发至专门部署的专用计算集群中。
六、总结
回顾 Node.js 的核心应用版图,其成功并非因为“能让前端写后端”这句简单的口号,而是源自于其在高并发 I/O 密集型架构中无可替代的运行效率与研发生产力:
- 在 Web 后端领域:它以 BFF 聚合与 SSR 同构为切入点,有效解耦了多端展现与底层领域微服务,带来了首屏秒开的卓越体验;
- 在 API 与实时通信领域:它依托单线程非阻塞事件循环与流式管道机制,成为海量长连接、即时聊天与数据中转的首选基础设施;
- 在前端工程化领域:它承载了从静态类型检查、本地 DevServer 毫秒级热重载到打包编译与 CI/CD 自动化的全套现代研发标准。
在实际工程选型中,清晰理解“I/O 密集用其长,计算密集避其短”的底层分界线,就能在纷繁复杂的技术方案中准确发挥 Node.js 的最大价值,构建出轻量、敏捷且极具扩展性的现代数字化系统。
Docker Desktop 4.99.0发布:修复代理连接泄漏与WSL启动故障
2026-11-10 15:59:07
用js给select设置默认值做广告素材的批量测试方案
2026-11-07 18:12:28
不用安装软件怎么测试JavaScript代码?浏览器控制台使用技巧
2026-11-06 23:56:51
JS在线运行工具怎么引入第三方库?CDN与npm依赖添加教程
2026-11-06 08:35:09
Docker 部署 Wiki.js 完整教程:从安装到初始化配置
2026-11-04 10:36:31







