jshex字符串转Uint8Array.fromHexES2026
深入讲解 JavaScript 中使用原生的 Uint8Array.fromHex() 将十六进制(Hex)字符串高效转换为 Uint8Array 字节数组的规范标准、执行原理、异常防御机制与全平台实战应用。
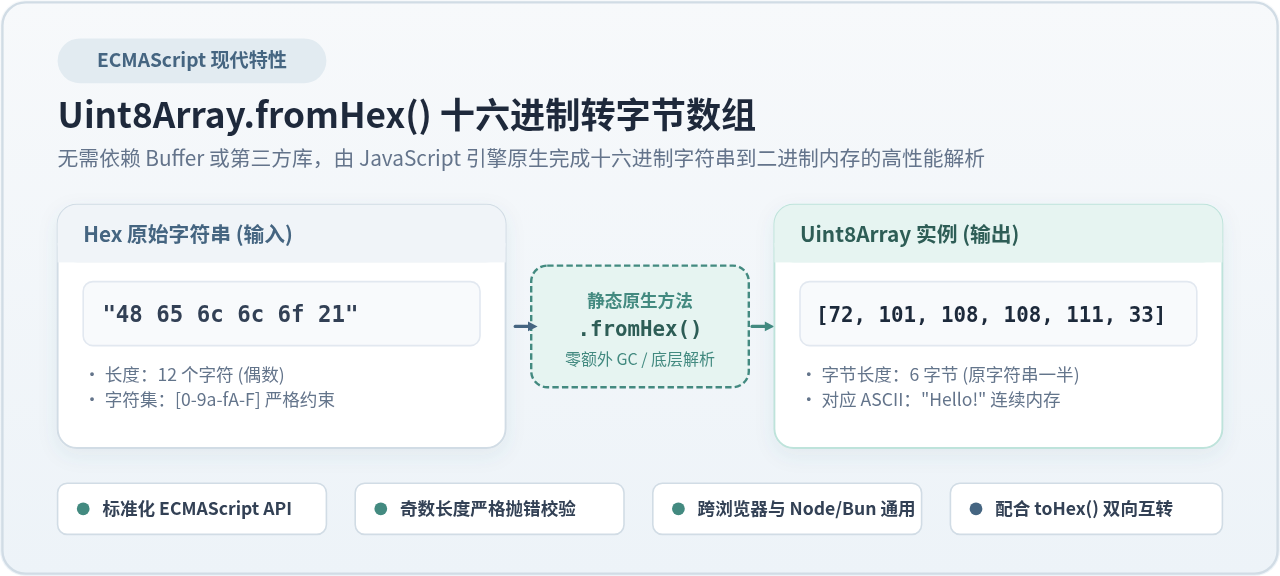
Uint8Array.fromHex(string),开发者能够直接、高效地将十六进制(Hex)字符串解析为底层的 Uint8Array 二进制字节数组。该方法由 JavaScript 引擎底层用 C++ 实现,不仅具备严密的格式合法性校验,且无需在 JavaScript 层面产生任何中间数组或字符串碎片,彻底替代了过去依赖 Node.js 专有 Buffer、正则切片或手写循环解析的繁琐方案。
一、认识 Uint8Array.fromHex() 核心语法与规范要求
在 Web 加密 API(SubtleCrypto)、网络协议封包(WebSocket/WebTransport)、文件格式解析(Magic Number 校验)以及区块链与智能合约交互等场景中,十六进制表示法与内存中的连续二进制字节流互转是极高频的需求。长久以来,JavaScript 语言标准库一直缺少原生的 Hex 互转能力,直到该项规范在现代 ECMAScript 中正式落地。
Uint8Array.fromHex() 是挂载于 Uint8Array 构造函数上的静态方法。其语法定义极为简明:
// 核心语法结构
const uint8Array = Uint8Array.fromHex(hexString);
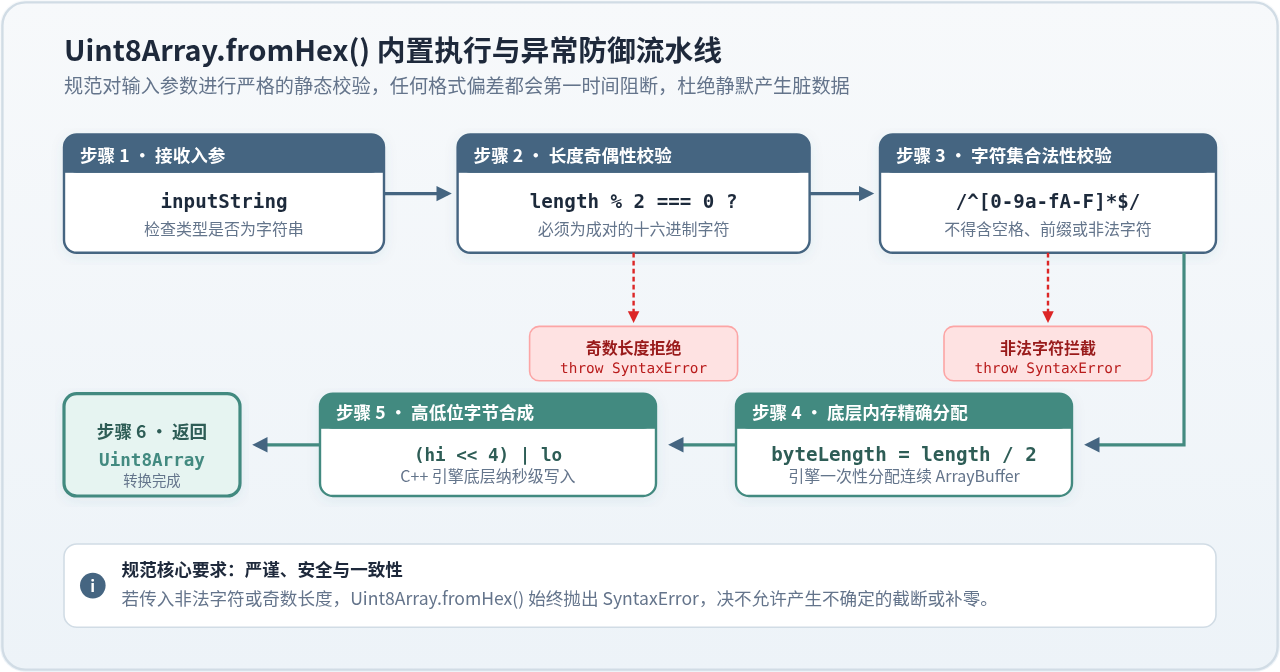
该静态方法在执行时遵循以下严苛的规范约束:
- 输入类型约束:参数必须为字符串类型。如果传入非字符串且无法正常强制转换的对象,将抛出
TypeError。 - 长度严格偶数性:输入的十六进制字符串长度必须为偶数(
hexString.length % 2 === 0)。因为十六进制中每两个字符共同编码一个 8 位无符号字节(0x00 至 0xFF),如果长度为奇数,说明缺少半字节,引擎会立即抛出SyntaxError。 - 字符集合法性:字符串必须严格仅由十六进制字符组成,即
[0-9a-fA-F]。不包含任何空格、破折号,更不得包含"0x"前缀。一旦遇到任何非十六进制字符,同样抛出SyntaxError。 - 大小写无感知:字符不区分大小写,
"4a"与"4A"解析行为完全一致,且支持大小写交替混合出现。 - 对称输出方法:与
Uint8Array.fromHex()对称,规范在原型链上同步新增了Uint8Array.prototype.toHex()方法,用于将Uint8Array实例快速转回标准小写十六进制字符串。
二、基础操作步骤与多场景实战示例
在支持新特性的现代执行环境(如最新版本的 Chrome、Edge、Node.js、Bun 或 Deno)中,使用 Uint8Array.fromHex() 进行数据转换非常直观。以下通过四个典型场景演示具体的代码编写方式。
1. 基础转换与字符大小写兼容
最常规的转换只需直接传入标准 Hex 串。即使字符串中夹杂大写字符,也无需手动调用 toLowerCase(),引擎内部会自动进行统一映射:
// 1. 标准小写 Hex 字符串转换
const bytes1 = Uint8Array.fromHex("e4bda0e5a5bd");
console.log(bytes1);
// 输出: Uint8Array(6) [ 228, 189, 160, 229, 165, 189 ]

// 通过 TextDecoder 查看 UTF-8 还原文本
console.log(new TextDecoder().decode(bytes1));
// 输出: "你好"

// 2. 大小写混合输入验证
const bytes2 = Uint8Array.fromHex("48656C6C6F"); // "Hello" 的混合大小写形式
console.log(bytes2);
// 输出: Uint8Array(5) [ 72, 101, 108, 108, 111 ]
2. 双向互转:fromHex 与 toHex 闭环
在网络数据包或本地缓存序列化中,经常需要在二进制与 Hex 字符串之间双向流转:
// 原始数据
const originalHex = "deadbeef01020304";

// 字符串转字节数组
const buffer = Uint8Array.fromHex(originalHex);
console.log("解析长度:", buffer.length); // 8 字节

// 字节数组修改(将前两个字节清零)
buffer[0] = 0x00;
buffer[1] = 0x00;

// 调用原型方法还原为 Hex 字符串
const serializedHex = buffer.toHex();
console.log("修改后 Hex:", serializedHex);
// 输出: "0000beef01020304" (均为小写格式)
3. 实战应用:解析 SHA-256 哈希字符串为验签字节流
在 Web Crypto 验签或文件指纹校验中,服务端通常提供 Hex 格式的 Hash 摘要,而 crypto.subtle.verify() 必须接收 ArrayBuffer 或 Uint8Array:
// 示例:64 字符 SHA-256 摘要
const sha256Hex = "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855";

// 直接转为 32 字节二进制
const hashBytes = Uint8Array.fromHex(sha256Hex);
console.log("哈希字节数:", hashBytes.byteLength); // 32

// 直接将底层 buffer 传入加密 API 使用
// await crypto.subtle.verify("HMAC", key, signature, hashBytes.buffer);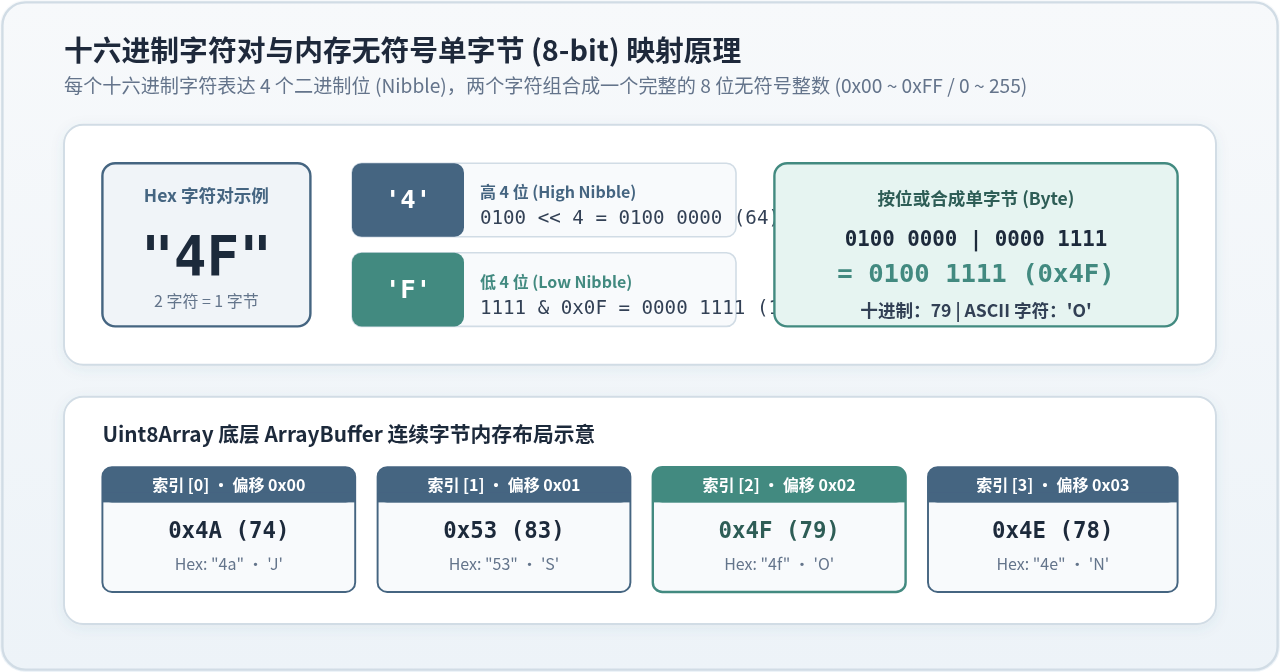
三、底层转换原理与位级映射解析
要真正理解 Uint8Array.fromHex() 的运行机制,需要从计算机底层的二进制编码谈起。计算机中 1 字节(Byte)由 8 个二进制位(bits)组成,取值区间为十进制 0 ~ 255。
十六进制的基数是 16,恰好等于 2^4。这意味着一个十六进制字符恰好可以完整表达 4 个二进制位(称为半字节,Nibble)。例如:
- 字符
'4'对应数值 4,其二进制为0100; - 字符
'F'对应数值 15,其二进制为1111。
当我们将这两个字符组合成 "4F" 时,高位字符 '4' 被放入字节的高 4 位,低位字符 'F' 被放入字节的低 4 位。在底层 C++ 实现或底层位运算中,其合成过程如下:
// 概念位运算实现过程
const hi = 4;   // 字符 '4' 解析出的数值
const lo = 15;  // 字符 'F' 解析出的数值

// 高位左移 4 位并与低位进行按位或运算
const byteValue = (hi << 4) | lo;
// 二进制: (0100 0000) | (0000 1111) = 0100 1111
// 十进制结果: 79 (0x4F),对应 ASCII 字符 'O'
因为是两两字符严格映射为一字节,所以 Uint8Array.fromHex() 生成的 Uint8Array 其底层 ArrayBuffer 长度精准等于 input.length / 2。整个过程无需动态扩容,内存利用率达到 100%。
四、异常处理与工程级安全封装
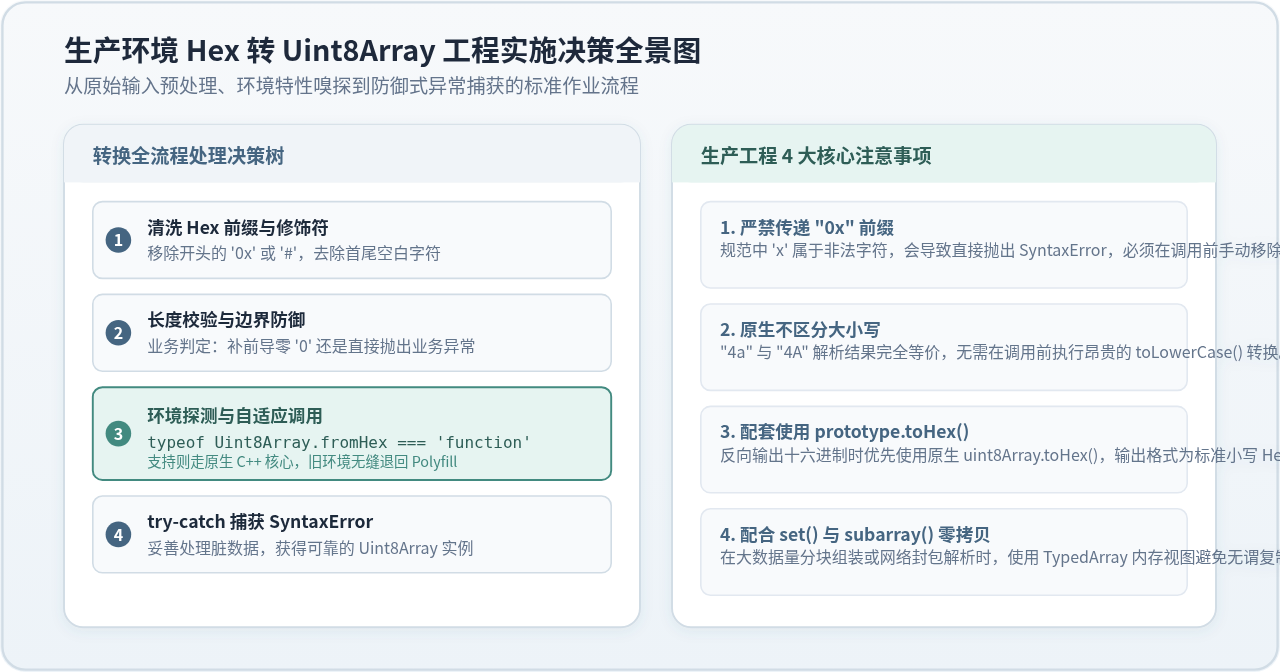
由于 Uint8Array.fromHex() 具备强类型和格式强校验特性,生产环境代码必须做好防御性编码,处理业务数据中可能出现的脏数据或格式变种。
- 带有
0x或#前缀:传入"0x1234"会抛出SyntaxError,因为字母x属于非法字符。 - 奇数位字符:传入
"abc"会抛出SyntaxError: Uint8Array.fromHex: invalid hex string length。 - 包含空格或换行:如
"12 34 56"同样会触发SyntaxError。
为了在复杂的业务数据源中稳健运行,建议在工程中采用如下所示的安全包装函数:
/**
 * 健壮的 Hex 字符串转 Uint8Array 封装
 * @param {string} hex 原始输入的十六进制字符串
 * @param {boolean} [padOdd=false] 遇到奇数位时是否自动在前端补零
 * @returns {Uint8Array} 转换后的字节数组
 */
function safeFromHex(hex, padOdd = false) {
  if (typeof hex !== "string") {
    throw new TypeError("入参必须为字符串类型");
  }

  // 1. 过滤常见的前缀 (0x 或 #) 并去除首尾空白字符
  let cleaned = hex.trim();
  if (cleaned.startsWith("0x") || cleaned.startsWith("0X")) {
    cleaned = cleaned.slice(2);
  } else if (cleaned.startsWith("#")) {
    cleaned = cleaned.slice(1);
  }

  // 2. 移除所有内部空白符号(某些 Hex 格式带空格排版)
  cleaned = cleaned.replace(/\s+/g, "");

  // 3. 奇数位自动补齐防御(按业务需要)
  if (cleaned.length % 2 !== 0) {
    if (padOdd) {
      cleaned = "0" + cleaned;
    } else {
      throw new SyntaxError(`Hex 字符串长度为奇数 (${cleaned.length}),无法整除为字节`);
    }
  }

  // 4. 调用原生方法转换并捕获底层异常
  try {
    return Uint8Array.fromHex(cleaned);
  } catch (err) {
    throw new SyntaxError(`Hex 转换失败: 包含非十六进制非法字符 [${cleaned}]`);
  }
}

// 验证封装函数:
console.log(safeFromHex("0x48656c6c6f")); // 正常去除 0x,返回 Uint8Array(5)
console.log(safeFromHex("48 65 6c 6c 6f")); // 正常去除空格,返回 Uint8Array(5)
console.log(safeFromHex("F", true)); // 自动补齐为 "0F",返回 Uint8Array(1) [ 15 ]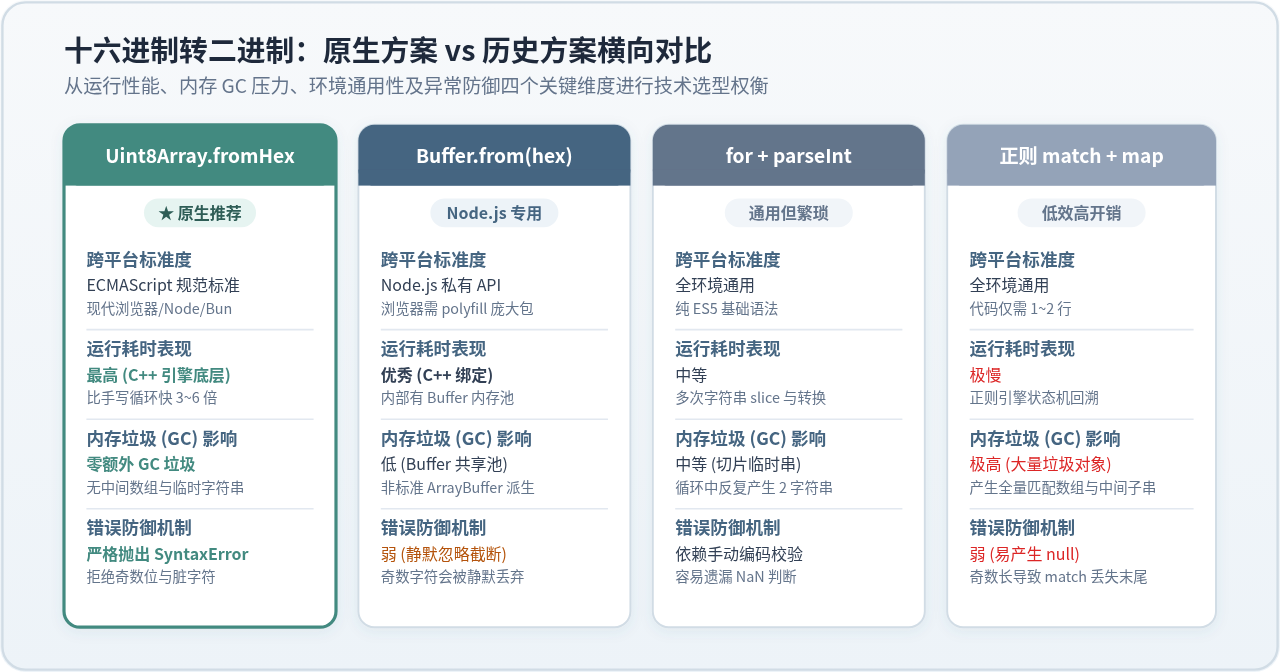
五、方案横向对比:为什么不再使用传统方式?
在 Uint8Array.fromHex() 推出之前,社区中存在多种 Hex 转字节数组的临时手段。下表详细对比了这些方案的技术差异:
| 技术方案 | 标准性与环境 | 执行性能 | GC 垃圾回收开销 | 边界校验安全性 |
|---|---|---|---|---|
| Uint8Array.fromHex() | ECMAScript 现代官方标准,全环境支持 | 极快(底层 C++ 直解,零多余开销) | 零额外垃圾,仅创建目标实例 | 极高,严格抛出 SyntaxError |
| Buffer.from(hex, 'hex') | Node.js 专有,浏览器需依赖庞大垫片 | 快(基于内部共享内存池) | 低,但在浏览器垫片中开销大 | 较差,遇到奇数位静默吞掉末位字符 |
| for 循环 + parseInt | 全环境可用,属于传统老方案 | 中等(频繁切片和函数调用) | 中等,每次循环创建 2 字符临时子串 | 依赖开发者手动实现完备检验 |
| 正则 match + map | 代码仅需 1~2 行,全环境可用 | 极慢(正则回溯与数组迭代) | 极高,产生临时匹配数组与海量子串 | 差,空串返回 null 容易引发崩溃 |
从性能基准来看,处理 1MB 大小的十六进制字符串时,Uint8Array.fromHex() 的吞吐速度通常是正则切片方案的 10 倍以上,且完全避免了 V8 引擎次级垃圾回收器(Scavenger)的频繁触发。
六、环境嗅探与向后兼容 Polyfill 实现
如果应用需要运行在尚未全面跟进该规范的旧版本浏览器或早期 Node.js 环境中,可以通过以下轻量且规范对齐的 Polyfill 方案进行降级:
// 规范级高性能 Polyfill 实现
if (typeof Uint8Array.fromHex !== "function") {
  // 预建 0-255 字符查找表(避免重复 parseInt,实现 O(1) 字符映射)
  const hexLookup = new Map();
  for (let i = 0; i < 16; i++) {
    const charLower = i.toString(16);
    const charUpper = charLower.toUpperCase();
    hexLookup.set(charLower, i);
    hexLookup.set(charUpper, i);
  }

  Uint8Array.fromHex = function fromHex(string) {
    if (typeof string !== "string") {
      throw new TypeError("Uint8Array.fromHex: 参数必须为字符串");
    }

    const len = string.length;
    // 严格检查奇数长度
    if (len % 2 !== 0) {
      throw new SyntaxError("Uint8Array.fromHex: 十六进制字符串长度必须为偶数");
    }

    const outLength = len / 2;
    const result = new Uint8Array(outLength);

    for (let i = 0; i < len; i += 2) {
      const hiChar = string[i];
      const loChar = string[i + 1];

      const hi = hexLookup.get(hiChar);
      const lo = hexLookup.get(loChar);

      // 非法字符检查
      if (hi === undefined || lo === undefined) {
        throw new SyntaxError(`Uint8Array.fromHex: 发现非法十六进制字符 "${hiChar}${loChar}"`);
      }

      result[i / 2] = (hi << 4) | lo;
    }

    return result;
  };
}

// 原型方法 toHex 对应 Polyfill
if (typeof Uint8Array.prototype.toHex !== "function") {
  const byteToHex = Array.from({ length: 256 }, (_, i) =>
    i.toString(16).padStart(2, "0")
  );

  Uint8Array.prototype.toHex = function toHex() {
    let hex = "";
    for (let i = 0; i < this.length; i++) {
      hex += byteToHex[this[i]];
    }
    return hex;
  };
}
七、总结与最佳实践准则
Uint8Array.fromHex() 为 JavaScript 在二进制数据处理领域补齐了长久以来的原生基础设施短板。在实际工程项目中,建议遵循以下最佳实践:
- 弃用非标依赖:在跨平台的前端项目、SDK 与新启动的 Node.js/Bun 微服务中,全面使用
Uint8Array.fromHex()替换过去的Buffer转换或第三方转换包。 - 防御性去前缀:不要假设外部接口或输入源绝对纯净,针对带有
0x、#或带有空格格式化的 Hex 串,在调用前完成轻量字符串清洗。 - 利用类型化视图实现零拷贝:对于复杂二进制报文解析,将
Uint8Array.fromHex()得到的字节数组直接配合DataView、Uint16Array或通过.subarray()切片读取,避免多次申请内存。 - 规范对齐的错误处理:业务代码应将
SyntaxError视作非法数据输入的第一道安全防线,善用异常拦截机制,避免由于脏数据导致下游解析逻辑产生静默逻辑漏洞。
JavaScript负数四舍五入取整的逻辑与注意事项
2026-11-13 22:36:53
JS中Boolean()构造函数与!!操作符转换字符串的区别
2026-11-13 22:33:00
为什么JavaScript被称为脚本语言而非编译型语言
2026-11-13 22:18:40
js字符串转数组每个元素转浮点数parseFloat
2026-11-13 21:24:51
js字符串转数组UTF-8编码TextEncoder
2026-11-13 19:49:55