js字符串转数组UTF-8编码TextEncoder
详细讲解在JavaScript中使用TextEncoder将字符串转换为UTF-8编码字节数组的标准方法,包括encode与encodeInto用法、UTF-8底层变长编码机制、Uint8Array与普通数组转换及边界排查。
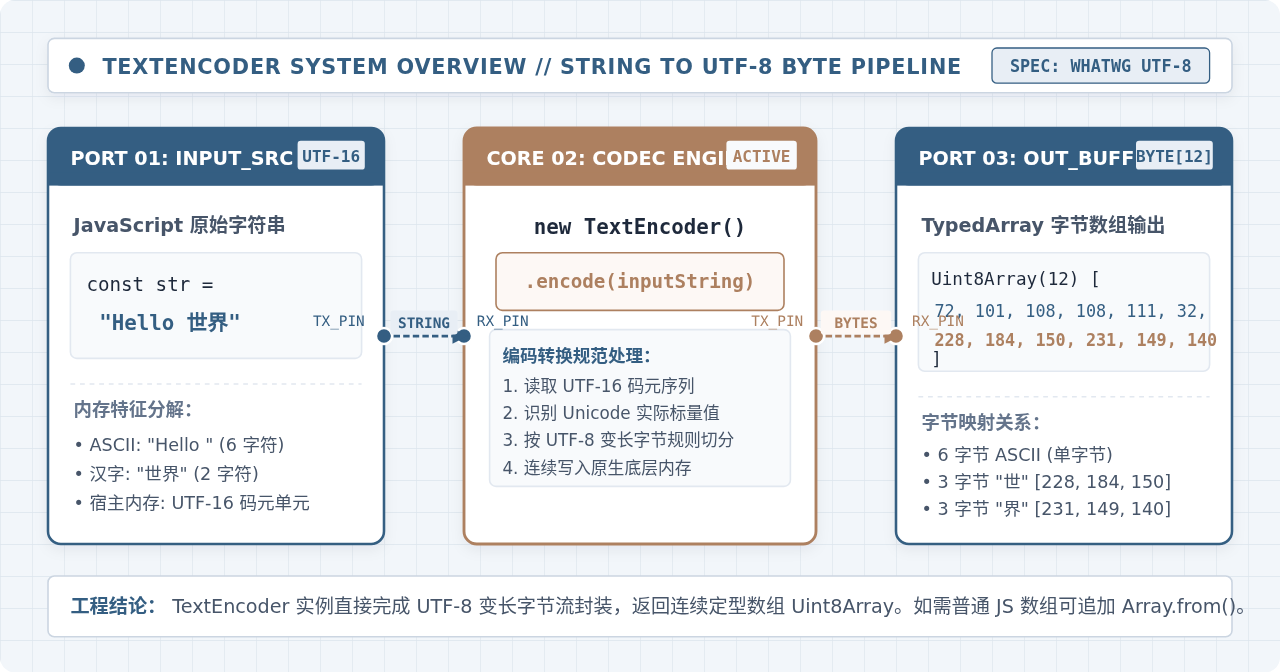
TextEncoder。通过 new TextEncoder().encode(str) 可以直接将任意 JavaScript 字符串编码为 Uint8Array 字节数组;如果业务需要普通的 JavaScript 数字数组(number[]),则可通过 Array.from() 或展开运算符进一步展开。
一、极速上手:核心 API 与基础转换范式
在 TextEncoder 成为标准之前,JavaScript 开发者通常需要借助 encodeURIComponent 配合正则替换与 charCodeAt,或者引入体积可观的第三方库来计算 UTF-8 字节。这不仅代码冗长,而且由于在脚本层频繁进行字符分割与数字运算,性能十分低下。
现代标准环境提供了原生的 TextEncoder 接口。它在 C++ 引擎底层直接执行字符解析与内存写入,操作简明且执行速度极快。
1. 最简编码示例(获取 Uint8Array)
// 1. 创建 TextEncoder 实例
const encoder = new TextEncoder();

// 2. 执行编码:传入字符串,返回 UTF-8 编码的 Uint8Array
const text = "Hello 世界";
const uint8Array = encoder.encode(text);

// 3. 查看输出结果
console.log(uint8Array);
console.log("字节长度:", uint8Array.length);字节长度: 12
从输出可以看出,原始字符串 "Hello 世界" 共有 8 个字符(6 个英文字符及空格,2 个汉字),但转换后的字节数组长度为 12。这是因为在 UTF-8 编码中,ASCII 字符各占 1 个字节,而常用汉字各占 3 个字节(6 + 2 * 3 = 12)。
2. 将 Uint8Array 转换为普通数字数组(Array<number>)
TextEncoder.prototype.encode() 返回的是一个类型化数组(Uint8Array)。类型化数组具备绝大多数数组的只读方法(如 .slice()、.find()、.forEach()),但若下游函数或第三方库严格要求普通 JavaScript 数组(例如调用了 .push()、.pop() 或使用了不支持 TypedArray 的老旧序列化库),则需要执行转换:
// 方式 A:推荐使用 Array.from(),语义清晰且内存分配可预测
const standardArrayA = Array.from(uint8Array);

// 方式 B:使用 ES6 展开运算符(适用于中小型数组)
const standardArrayB = [...uint8Array];

console.log(standardArrayA);二、底层原理:JavaScript 字符串与 UTF-8 变长字节映射
理解 TextEncoder 的转换结果,必须明确 JavaScript 引擎内部的字符串表达机制以及 UTF-8 编码的比特分布规则。
JavaScript 语言规范规定,字符串在运行时本质上是由 16 位码元(UTF-16 Code Units)构成的序列。普通英文字符和绝大多数汉字位于基本多语言平面(BMP,码点范围 U+0000 ~ U+FFFF),各占用 1 个 16 位码元;而 Emoji 表情和生僻增补字符(如 🚀、𠮷)超出此范围,在 UTF-16 中必须使用 2 个 16 位码元组成的“代理对”(Surrogate Pair)表示。
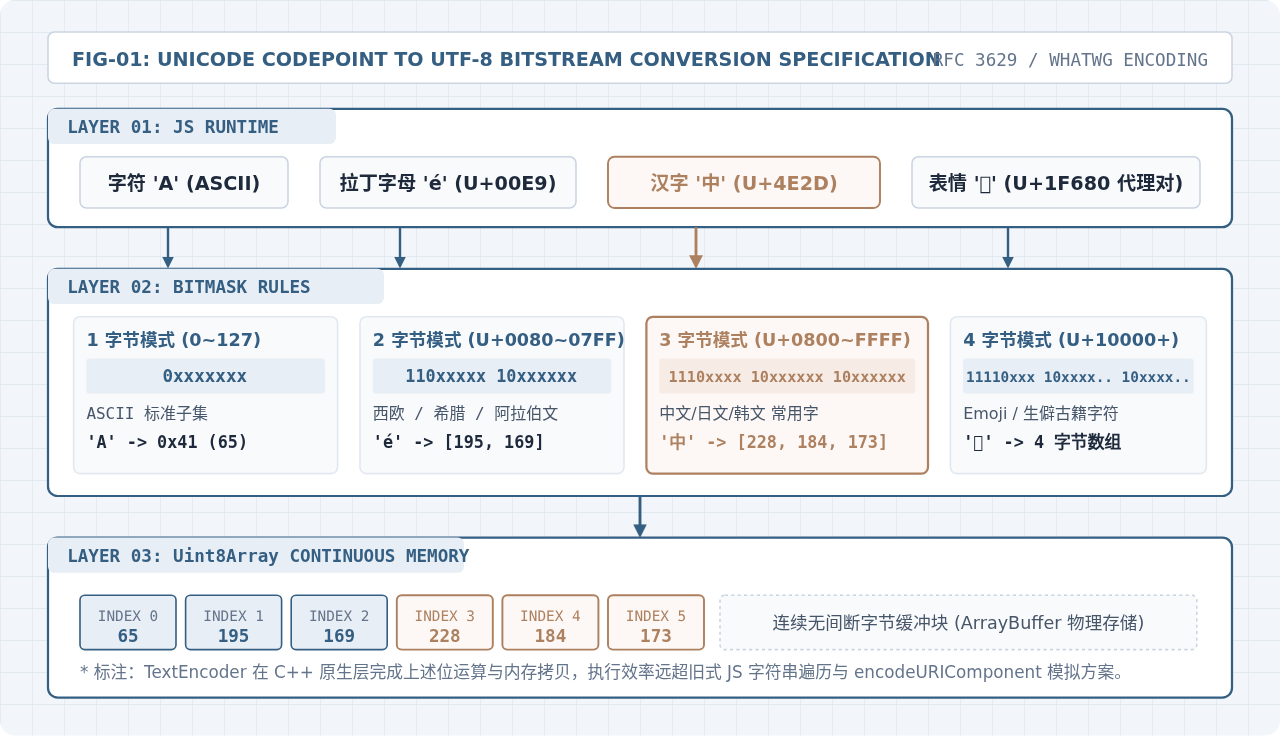
而 UTF-8 是一种针对 Unicode 的可变长度字符编码。它将每个 Unicode 标量值编码为 1 至 4 个字节,具体规则如下:
- 1 字节(U+0000 ~ U+007F):前缀为
0xxxxxxx,与 ASCII 完全一致,兼容所有传统英文文本。 - 2 字节(U+0080 ~ U+07FF):前缀为
110xxxxx 10xxxxxx,主要覆盖拉美语系变音字母、希腊字母、希伯来语等。 - 3 字节(U+0800 ~ U+FFFF):前缀为
1110xxxx 10xxxxxx 10xxxxxx,包含中文、日文、韩文(CJK)绝大部分日常汉字与字符。例如汉字“中”(Unicode 码点U+4E2D),经位运算拆分后得到 3 个字节:0xE4 0xB8 0xAD,对应十进制即[228, 184, 173]。 - 4 字节(U+10000 ~ U+10FFFF):前缀为
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx,包含 Emoji、特殊符号及生僻历史文字。例如🚀(U+1F680)编码后占用 4 个字节:[240, 159, 154, 128]。
传统的 JavaScript 转换方案需要使用 JS 代码循环调用
charCodeAt 或 codePointAt,并手工进行数十次位移(>>)和按位与(&)计算,每次操作都会触发解释器或 JIT 编译器的类型检查。而 TextEncoder.prototype.encode() 在浏览器内核底层使用 SIMD 优化的 C++ 代码直接扫描内存并批量写入,避免了中间变量的反复创建。
三、操作步骤与高吞吐优化:encode() 与 encodeInto()
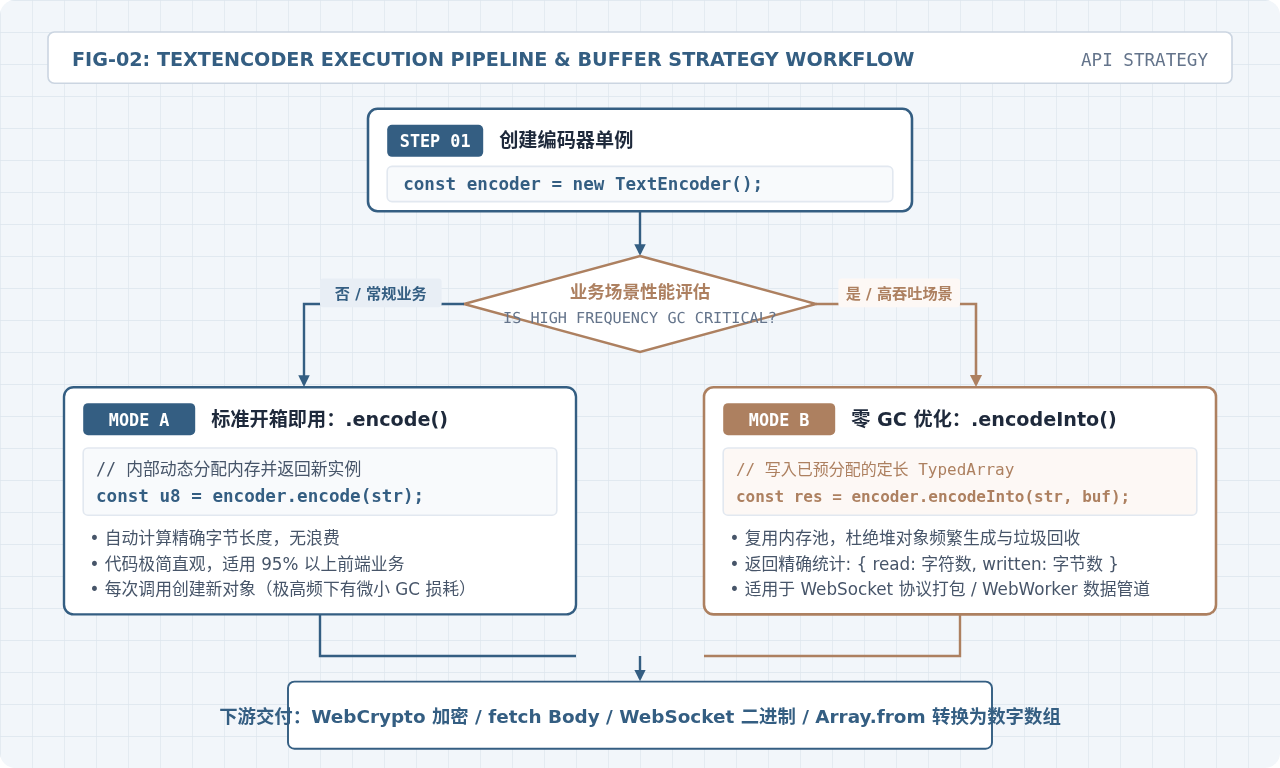
在实际项目开发中,依据数据规模和执行频率的不同,TextEncoder 提供了两套互补的转换路径:开箱即用的 encode() 与 零垃圾回收(Zero-GC)的 encodeInto()。
1. 路径 A:常规业务下的 encode() 模式
该模式适用于 95% 以上的前端交互或轻量数据请求场景。每次调用 encoder.encode(input),引擎都会:
- 扫描目标字符串,精确计算出所需的 UTF-8 字节总数;
- 在堆内存中动态分配一块恰好符合大小的
ArrayBuffer; - 将字节写入该缓冲区,并封装为新的
Uint8Array实例返回。
这种方式最简单可靠,调用者无需提前计算或预估目标缓冲区的长度,也不存在越界风险。
2. 路径 B:高吞吐场景下的 encodeInto() 模式
在实时 WebSocket 通信、音视频帧元数据打标签、高频 WebWorker 消息通道或向 WebAssembly 线性内存传递数据时,如果每秒调用成千上万次 encode(),频繁创建和废弃 Uint8Array 实例会导致浏览器垃圾回收器(Garbage Collector)频繁介入,造成可感知的帧率波动或延迟。
针对这一场景,WHATWG 规范引入了 encodeInto(source, destination) 方法,允许开发者将字符串直接编码到预先分配好的现有 Uint8Array 缓冲区中,实现内存复用:
const encoder = new TextEncoder();

// 1. 预先分配一块足够大的重用缓冲区(例如 1024 字节池)
const reusableBuffer = new Uint8Array(1024);

// 2. 需要编码的目标字符串
const message = "高频消息推送: Ping!";

// 3. 执行 encodeInto,直接将结果写入 reusableBuffer
const result = encoder.encodeInto(message, reusableBuffer);

console.log(result);
// 获取实际写入的数据切片(创建轻量视图,无需深拷贝内存)
const actualBytes = reusableBuffer.subarray(0, result.written);
console.log("实际写入字节数:", actualBytes.length);实际写入字节数: 24
encodeInto 的返回值是一个包含两个属性的对象:
read:本次编码成功读取并处理的 UTF-16 码元数量。written:实际向目标destination缓冲区写入的 UTF-8 字节数量。
如果目标缓冲区的剩余容量不足以容纳全部字符串编码后的字节,
encodeInto 会在缓冲区填满后安全停止,并返回已处理的 read 与 written,不会越界报错。为了确保单次写入完整,预分配缓冲区的最大安全尺寸为 str.length * 3 字节(纯常用文本)或 str.length * 4 字节(可能含 Emoji 的富文本)。
四、数组类型辨析:Uint8Array、ArrayBuffer 与普通 Array 的拓扑关系
许多初学者在得到 Uint8Array 后,第一反应是立即将其转换为普通的 JavaScript 数组(number[])。然而,这种类型转换在绝大多数工程场景中是多余且昂贵的。深入理解三者的内存结构,能够避免不必要的性能浪费。
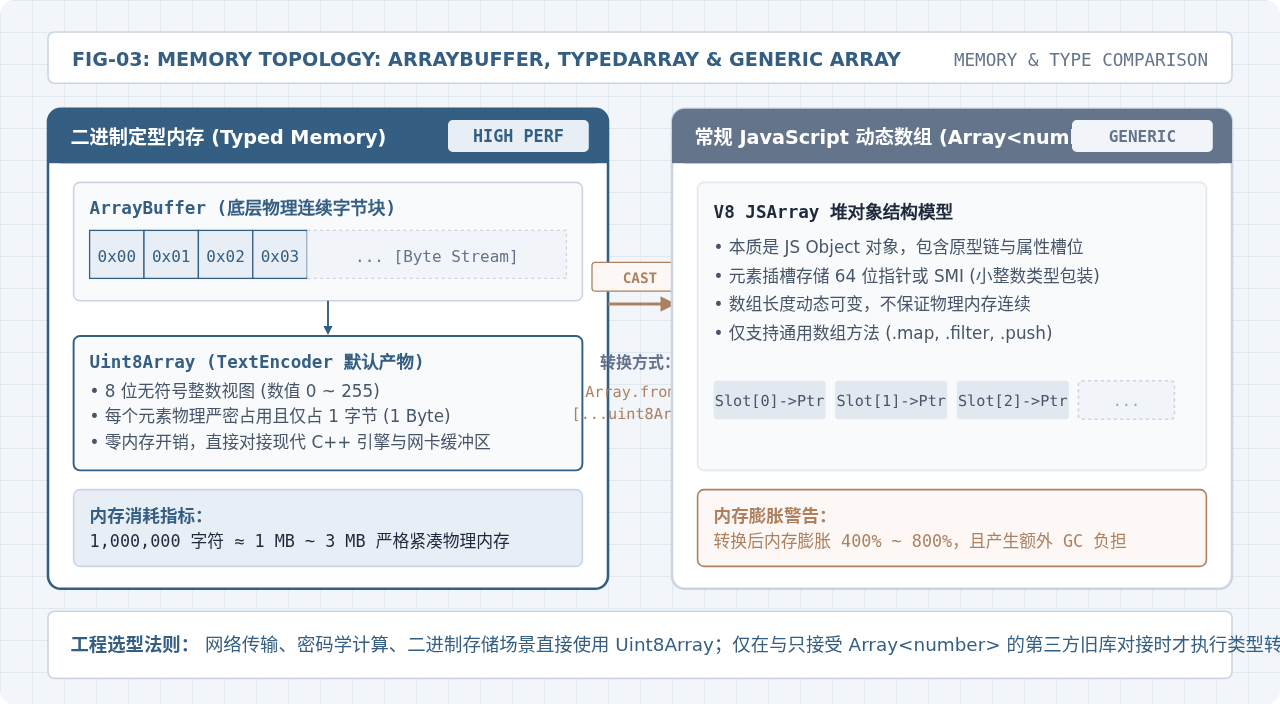
1. 三种数据结构的内存模型对比
| 特性维度 | ArrayBuffer | Uint8Array | 普通 JavaScript Array |
|---|---|---|---|
| 本质定位 | 连续二进制字节的原生堆外/线性内存块 | 针对二进制内存的有类型视图(TypedArray) | JavaScript 堆对象(基于属性槽位与哈希表) |
| 单元素内存开销 | 1 字节 | 严格 1 字节(0~255) | 通常 4 ~ 8 字节(存储指针或类型标签) |
| 内存连续性 | 绝对物理连续 | 绝对物理连续 | 由引擎托管,扩容可能碎片化 |
| 硬件/底层交互 | 支持(作为传输载体) | 直接对接网卡、WebCrypto、GPU、Wasm | 不可直接传递,底层必须二次序列化 |
2. 转换选型决策原则
-
保持使用 Uint8Array(强烈推荐):
当你的数据用于网络请求体(
fetch(url, { body: uint8Array }))、WebSocket 二进制帧发送(ws.send(uint8Array))、文件存储(new Blob([uint8Array]))、哈希与加密(crypto.subtle.digest('SHA-256', uint8Array))或 WebAssembly 内存写入时,请直接使用 Uint8Array。现代 Web API 原生对齐 TypedArray,转换为普通数组反而会导致引擎再次进行反向转换。 -
转换为普通 Array<number>(按需使用):
仅当调用的第三方纯算法库明确在 TypeScript 类型或参数断言中只接受
Array<number>,或者需要对数组使用.splice()、.unshift()等会改变数组物理长度的方法时,才使用Array.from(uint8Array)进行转换。
五、边界场景与排查避坑指南
TextEncoder 的行为高度标准化,但在处理非标准字符串、特殊编码格式及环境依赖时,仍有几个关键边界需要掌握。
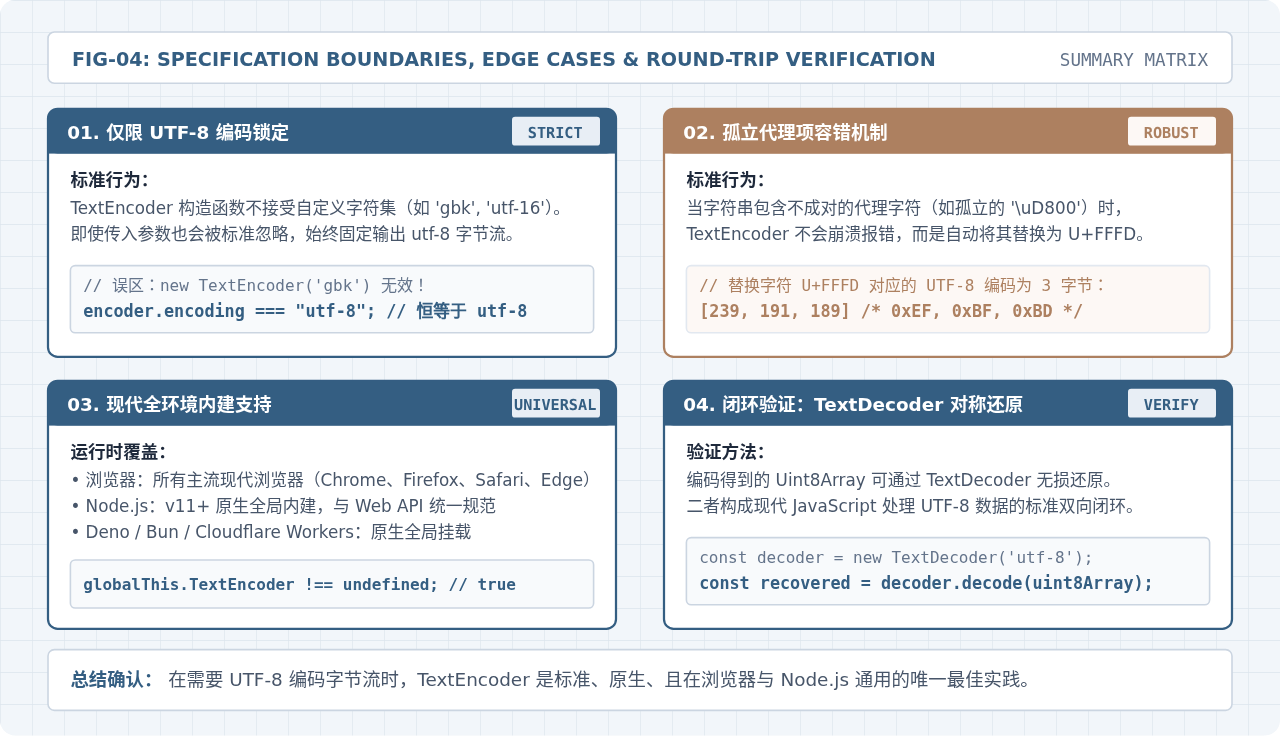
1. 陷阱一:试图指定非 UTF-8 编码
许多开发者误以为可以像 new TextDecoder('gbk') 那样向 TextEncoder 传递参数来编码 GBK 或 UTF-16:
// 错误认识:认为可以传参编码 GBK
const encoder = new TextEncoder("gbk"); // 参数会被完全忽略!
console.log(encoder.encoding); // 输出依然是 "utf-8"
规范说明:WHATWG 编码规范明确规定,TextEncoder 只支持且永久固定为 UTF-8 编码。其构造函数不接收任何编码参数(或者传参被静默忽略),其 .encoding 属性只读且恒为 "utf-8"。如果业务必须输出 GBK、Big5 或 ISO-8859-1,必须引入专门的编码库(如 iconv-lite 或自定义转换字典)。
2. 陷阱二:孤立代理项(Lone Surrogates)的安全降级
当 JavaScript 字符串被意外截断或由不规范的外部数据源生成时,可能包含不配对的 UTF-16 代理码元(例如单个高位代理 \uD800):
// 包含不成对的孤立高位代理码元
const brokenStr = "错误字符:\uD800结束";
const encoded = new TextEncoder().encode(brokenStr);

console.log(encoded);
遇到畸形的孤立代理项时,TextEncoder 不会抛出异常。按照 Unicode 规范,它会自动将无法匹配的孤立代理项替换为标准“替换字符” U+FFFD(显示为问号字符 )。该字符在 UTF-8 下编码为固定的 3 个字节:0xEF, 0xBF, 0xBD(十进制 [239, 191, 189])。这种容错机制确保了数据流管道不会因为单个坏字符而中断崩溃。
3. 陷阱三:Node.js 与浏览器环境的统一
在早期 Node.js 版本中,开发者习惯使用 Buffer.from(str, 'utf-8')。而在现代 Node.js(从 Node.js 11+ 起,包括所有维护中的 LTS 版本)中,TextEncoder 和 TextDecoder 已经作为全局对象内建支持,挂载在 globalThis 下:
// 无需 require('util'),无论在 Chrome、Safari 还是 Node.js、Bun、Deno 均可直接运行
const bytes = new TextEncoder().encode("跨环境通用代码");
在编写同构库(Universal/Isomorphic Library)时,优先采用 TextEncoder 可以彻底摆脱对 Node.js 专属 Buffer 对象的依赖,使代码无需任何打包垫片(Polyfill)即可无缝在浏览器、服务端和边缘计算运行时中通行。
4. 对称验证:通过 TextDecoder 校验还原
要验证编码生成的字节数组是否完整无损,最直接的方法是使用其对称接口 TextDecoder 进行闭环解码测试:
const original = "TextEncoder 测试字符串 🌟";

// 编码为 Uint8Array
const encodedBytes = new TextEncoder().encode(original);

// 对称解码回字符串
const decodedString = new TextDecoder("utf-8").decode(encodedBytes);

console.log("还原成功:", original === decodedString);六、总结与关键实践速查
使用 TextEncoder 进行 JavaScript 字符串转 UTF-8 数组是现代 Web 标准体系下的唯一官方标准。在实际运用中牢记以下四项核心结论:
- 标准写法:调用
new TextEncoder().encode(str)即可产出标准的Uint8Array字节数组。 - 转普通数组:若非必须请保持
Uint8Array;确需常规数字数组时,使用Array.from(uint8Array)是最优选择。 - 性能极客:高频海量编码场景选用
encoder.encodeInto(str, reusableBuffer),杜绝频繁 GC 内存抖动。 - 字符特性:UTF-8 是变长编码,英文占 1 字节,中文常用汉字占 3 字节,Emoji 占 4 字节,数组长度不等于字符串的
.length。
js字符串转数组处理带音标字符
2026-11-13 18:39:19
js字符串转数组2026用哪个ES版本最稳
2026-11-13 16:59:02
解决JS日期格式化中的时区偏差与Invalid Date问题
2026-11-13 16:13:19
js字符串转字节数组atob和Uint8Array
2026-11-13 16:01:55
js字符串全局匹配g标志转数组
2026-11-13 15:54:12