js字符串转数组处理带音标字符
深入解析在JavaScript中将包含变音符号与音标字符的字符串转换为数组时的常见拆分缺陷,剖析Unicode字形簇原理,并提供Intl.Segmenter与正则匹配等完整解决方案。
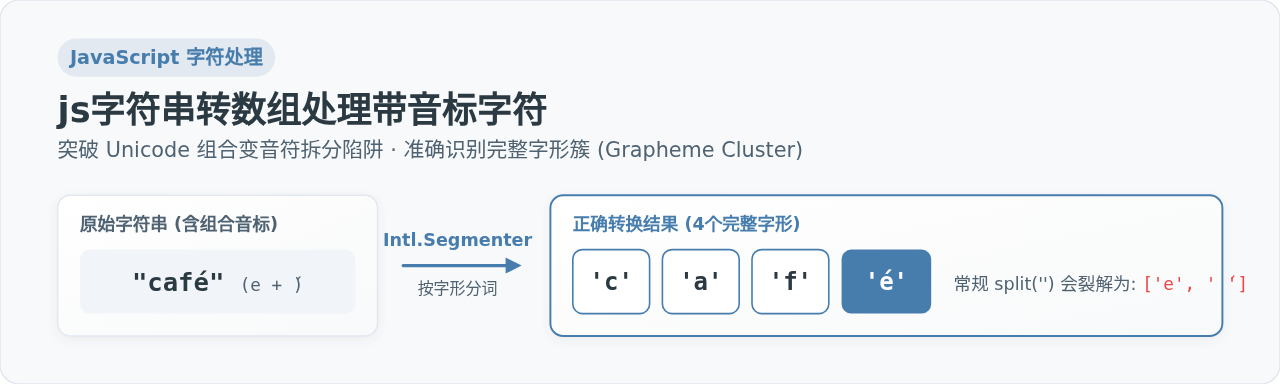
café、西班牙语的 año、德语的 über 或汉语拼音 hǎochī)转换为字符数组时,使用常规的 str.split('') 或扩展运算符 [...str] 往往会将附着的音标剥离成独立的无依附字符(如 ['e', '́'])。解决这一问题的核心在于识别 Unicode 中的“字形簇”(Grapheme Cluster),现代标准首选使用 Intl.Segmenter,在兼容旧环境时则配合 Unicode 规范化 str.normalize('NFC') 或属性正则进行安全提取。
一、为什么带音标字符在拆分时容易“解体”
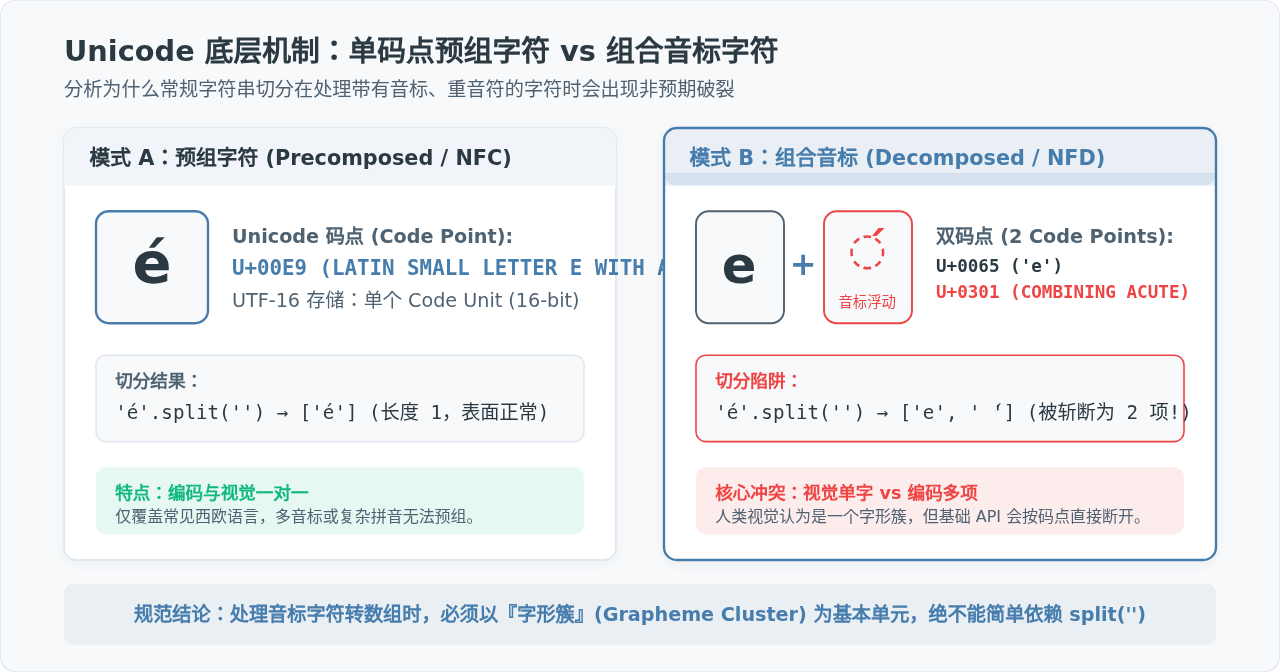
在深入具体代码之前,需要明确音标字符在底层编码中的实际存储方式。在 Unicode 规范中,带音标的字符通常有两种编码形态:
- 预组字符(Precomposed Character / NFC 形式):由单一 Unicode 码点直接代表带音标的字符。例如字母
é,其码点为U+00E9。在内存中,它占用一个单独的 16 位代码单元(Code Unit)。 - 组合音标序列(Combining Character Sequence / NFD 形式):由一个基础字母后追加一个或多个不可见的“组合变音符号”(Combining Diacritical Mark)构成。例如同样的视觉字符
é,可以由基础拉丁字母e(U+0065)与浮动尖音符◌́(U+0301)前后拼接而成。
在屏幕显示时,文本渲染引擎会自动将组合音标叠加在前面的基础字母上方,使人类视觉感知为一个完整的字符。然而,JavaScript 传统的字符串方法在底层只关注底层二进制编码:
str.split(''):以 UTF-16 代码单元(Code Unit)为边界进行硬切割,遇到组合音标时会直接从中间切开。[...str]或Array.from(str):以 Unicode 码点(Code Point)进行迭代,虽然能正确识别 Emoji 等由代理对组成的 32 位字符,但组合音标本身就是一个独立的合法码点(如U+0301),因此依然会被切断成两项。
二、四种常见转数组方式的执行表现对比
为了直观展示不同方法对带音标字符的处理差异,我们以包含 NFD 组合音标的字符串 "café"(屏幕渲染为 café)为例进行测试:
// 模拟来自文件输入或系统剪贴板的 NFD 组合字符串
const text = "cafe\u0301";

// 1. 常规 split 切割
console.log(text.split(''));
// 示例输出: ['c', 'a', 'f', 'e', '́'] -> 数组长度为 5(音标剥离)

// 2. 扩展运算符展开
console.log([...text]);
// 示例输出: ['c', 'a', 'f', 'e', '́'] -> 数组长度为 5(同样分离)

// 3. 规范化为 NFC 后展开
console.log([...text.normalize('NFC')]);
// 示例输出: ['c', 'a', 'f', 'é'] -> 数组长度为 4(成功合并常见音标)

// 4. 使用现代 Intl.Segmenter
const segmenter = new Intl.Segmenter('und', { granularity: 'grapheme' });
const result = Array.from(segmenter.segment(text), s => s.segment);
console.log(result);
// 示例输出: ['c', 'a', 'f', 'é'] -> 数组长度为 4(严格保留完整字形)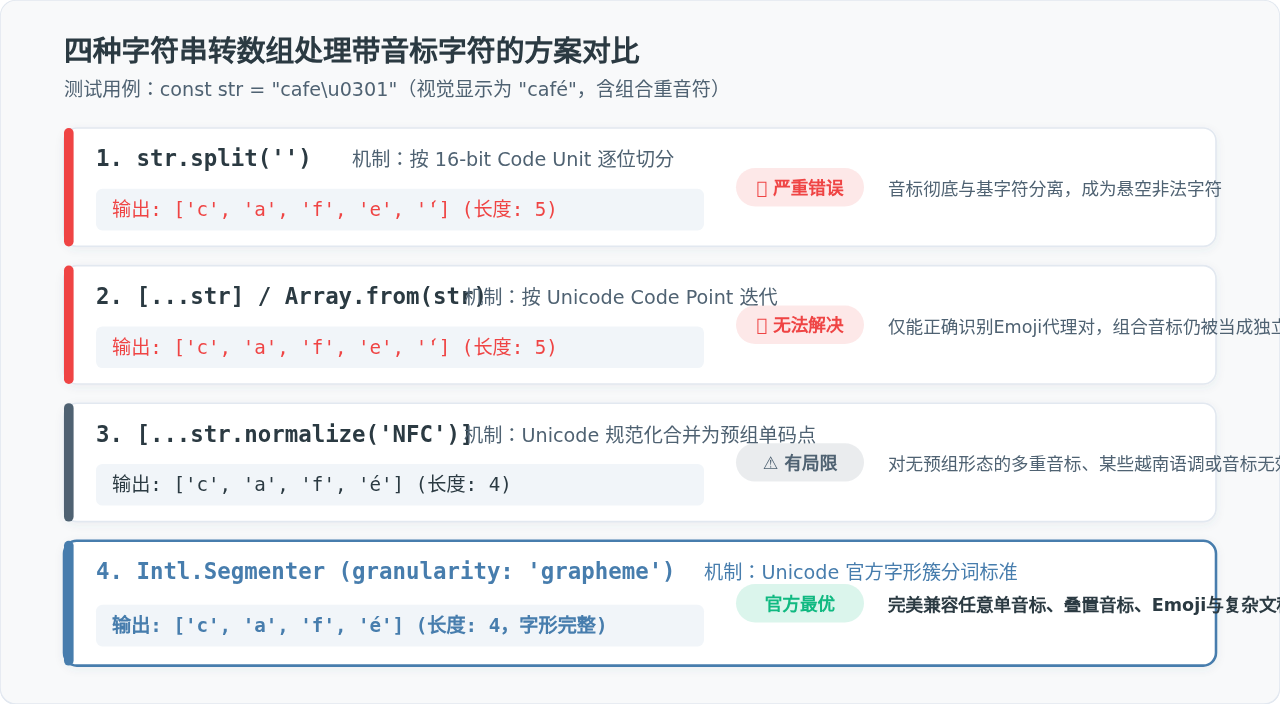
通过上方测试可以清晰看出:单纯使用 split('') 或 [...text] 会直接产生脏数据。孤立的音标项 '́' 在随后的遍历、截取、反转或索引访问中都会引发严重的排版错位和逻辑错误。
三、标准解决方案:使用 Intl.Segmenter 按字形簇拆分
ECMAScript 2022 正式引入了 Intl.Segmenter API。这是目前最符合 Unicode 标准、也是最优雅的原生解决方案。它可以根据人类视觉感知中的“字形簇”(Grapheme Cluster)对字符串进行语义分词。
1. 完整实现代码
/**
 * 将带音标、变音符或复杂符号的字符串安全转换为字符数组
 * @param {string} input 目标字符串
 * @returns {string[]} 视觉字形数组
 */
function splitGraphemes(input) {
  if (typeof input !== 'string') {
    return [];
  }

  // 1. 创建分词器,指定语种为 'und'(通用不限定),粒度为 'grapheme'(字形簇)
  const segmenter = new Intl.Segmenter('und', { granularity: 'grapheme' });

  // 2. 执行分词并直接提取每个字形片段的字符串
  const segments = segmenter.segment(input);
  return Array.from(segments, item => item.segment);
}

// 验证用例 1:带单音标德语/法语词汇
const deWord = "sch\u0075\u0308n"; // schön 的分解写法
console.log(splitGraphemes(deWord));
// 示例输出: ['s', 'c', 'h', 'ü', 'n'] (长度 5,音标完好)

// 验证用例 2:汉语拼音声调符号
const pinyin = "h\u01CEoch\u012B"; // hǎochī
console.log(splitGraphemes(pinyin));
// 示例输出: ['h', 'ǎ', 'o', 'c', 'h', 'ī'] (长度 6)

// 验证用例 3:多层叠置音标(越南语)
const viWord = "ti\u1EBFng"; // tiếng
console.log(splitGraphemes(viWord));
// 示例输出: ['t', 'i', 'ế', 'n', 'g'] (长度 5)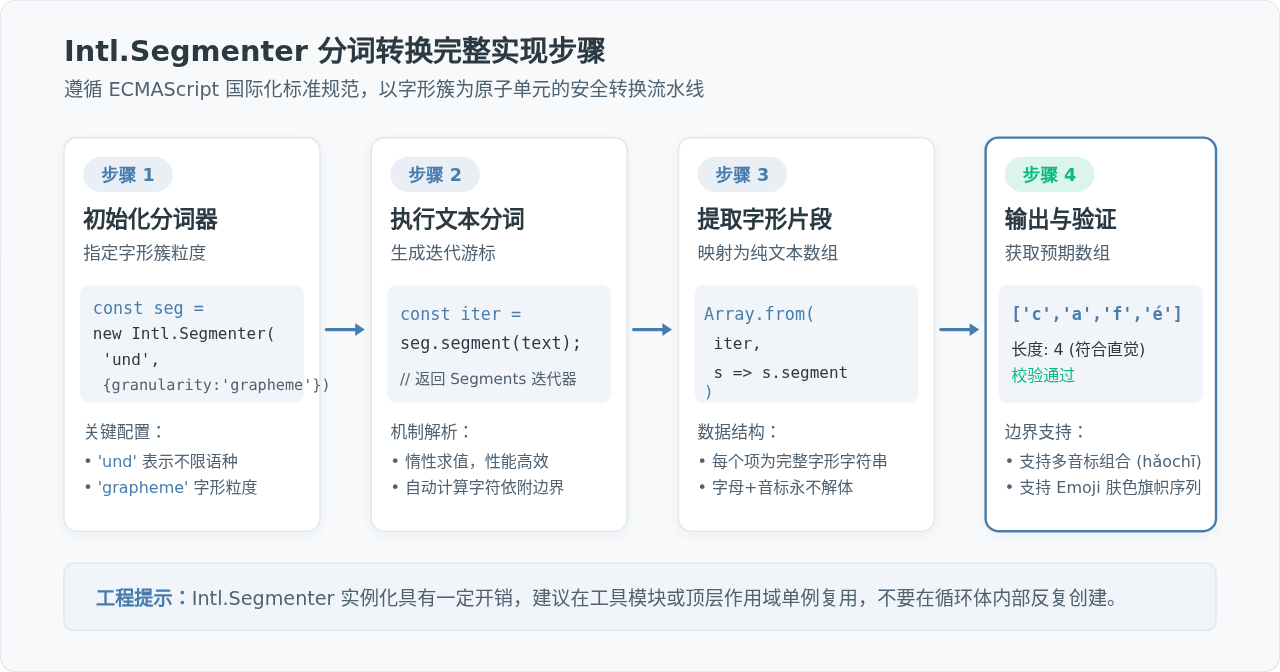
2. 操作要点与参数说明
- 语言标识
'und':表示未指定具体语言(Undefined Locale)。在大多数文本处理场景中,字形簇的边界规则适用于全球通用 Unicode 文本,无需指定特定国家代码。 - 分词粒度
granularity: 'grapheme':必须明确设为'grapheme',这样才能确保将字母、声调、附加符以及后续可能出现的 Emoji 序列作为一个完整的字形项对待。若设置为'word'或'sentence'则会变为词级或句子级分词。 - 性能优化建议:
new Intl.Segmenter的实例化过程涉及国际化规则表的装载,开销相对普通函数调用略高。在处理大量字符串时,应当在模块顶部单例保存该实例,避免在循环体内重复实例化。
四、兼容旧环境的备选实现方案
如果在 Node.js 16 以下旧版本或老旧客户端浏览器中运行,且无法使用 Polyfill 时,可以采用以下两种替代方式:
方案一:先进行 NFC 规范化,再执行展开
Unicode 提供了 String.prototype.normalize() 方法。传入 'NFC'(Normalization Form Canonical Composition)可以将组合型的基础字母与变音符压缩成单个 Unicode 预组码点:
function splitByNfc(str) {
  if (!str) return [];
  // 将 NFD 组合音标合并为 NFC 单码点预组字符
  return [...str.normalize('NFC')];
}

// 测试
const sample = "cafe\u0301";
console.log(splitByNfc(sample));
// 示例输出: ['c', 'a', 'f', 'é']normalize('NFC') 无法将其合并,后续展开仍会拆分。
方案二:基于 Unicode 属性转义字符的正则表达式
在支持 ES2018 正则扩展的环境中,可以使用 Unicode 属性转义字符 \p{M}(Mark,表示组合修饰符号)与 \P{M}(Non-Mark,表示非修饰的基础字符):
function splitByUnicodeRegex(str) {
  if (!str) return [];
  // 匹配:1个非修饰字符 + 0个或多个连续附加的组合修饰符
  const matches = str.match(/\P{M}\p{M}*/gu);
  return matches || [];
}

// 测试叠加音标
const complexTone = "o\u0302\u0301"; // o + 扬抑符 + 尖音符
console.log(splitByUnicodeRegex(complexTone));
// 示例输出: ['ố'] (两个音标均被完整保留在同一个元素内)
五、工程落地选型与常见问题排查
在实际项目落地时,应当根据目标运行环境及数据来源建立清晰的选型标准:
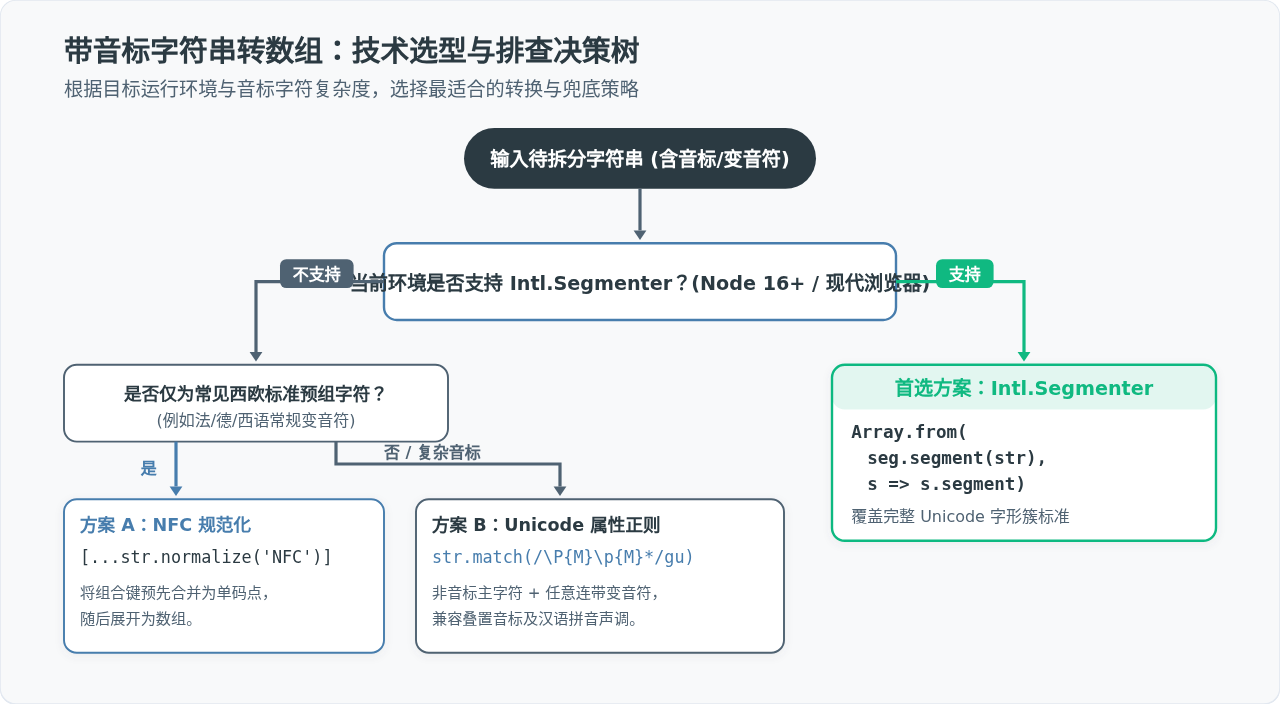
| 方案名称 | 适用环境 | 支持字符类型 | 实现复杂度 | 推荐度 |
|---|---|---|---|---|
Intl.Segmenter |
Node.js 16+ / 现代浏览器 | 全量音标、多重修饰符、Emoji簇 | 极简(原生官方标准) | ⭐⭐⭐⭐⭐ 首选 |
str.normalize('NFC') |
所有支持 ES6 的环境 | 仅限有标准预组码点的常见西欧字符 | 极简 | ⭐⭐⭐ 兼容兜底 |
Unicode 属性正则 |
ES2018+ 正则支持环境 | 各类复杂音标、叠置音标、汉语拼音 | 中等(需处理空匹配边界) | ⭐⭐⭐⭐ 无Segmenter时的优选 |
str.split('') |
所有环境 | 仅能处理纯 ASCII 或已完全预组的单字符 | 极简 | ❌ 禁止在涉音标场景使用 |
常见排查陷阱:操作系统对音标编码的默认差异
在开发跨平台应用或处理用户文件上传时,需要特别警惕操作系统的默认编码倾向:
- macOS 文件系统与键盘输入:历史上的 HFS+ 以及 macOS 输入法倾向于输出 NFD 形式(即字符被物理拆分为字母 + 组合音标)。即便用户输入了
café,在底层实际存储的往往是长度为 5 的分解序列。 - Windows 与 Web 浏览器:绝大多数 Web 表单与 Windows 文本系统倾向于输出 NFC 形式(长度为 4)。
因此,在将前端用户输入的文本转为数组前,无论后续使用哪种方案,在数据入口处预先调用一次 str.normalize('NFC'),再通过 Intl.Segmenter 转为数组,是保障多平台字符一致性与数据健壮性的最佳工程实践。
js字符串转数组2026用哪个ES版本最稳
2026-11-13 16:59:02
解决JS日期格式化中的时区偏差与Invalid Date问题
2026-11-13 16:13:19
js字符串转字节数组atob和Uint8Array
2026-11-13 16:01:55
js字符串全局匹配g标志转数组
2026-11-13 15:54:12
怎么将逗号分隔字符串转换为JS字符串数组
2026-11-13 13:43:38