js字符串转字节数组atob和Uint8Array
深入讲解JavaScript中使用atob和Uint8Array将Base64字符串转换为字节数组的标准方法、底层机制、多字节中文边界及现代API演进。
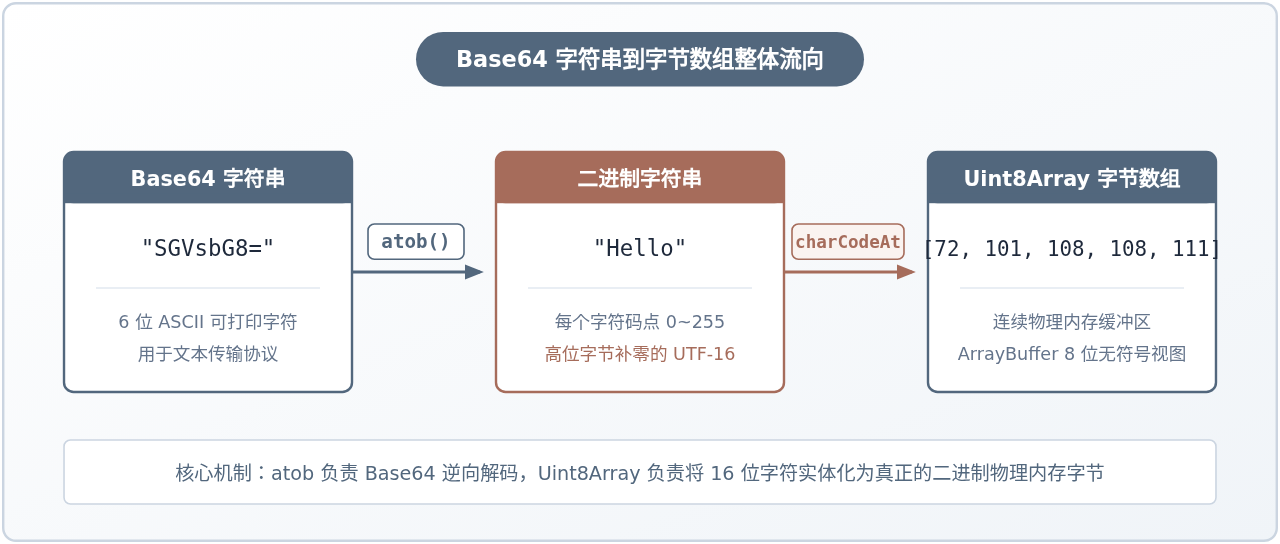
atob() 将 Base64 字符串解码为单字节“二进制字符串”,随后实例化一个与该字符串等长的 Uint8Array 内存缓冲区,并通过循环调用 charCodeAt() 提取字符码点依次填入数组。
一、标准转换实现与核心步骤
在很多开发场景中,服务端下发的文件、音频或加密密钥是以 Base64 字符串传输的。而在浏览器端使用 Canvas、Web Crypto API、Blob 或 Fetch 进行二进制操作时,必须传入以 ArrayBuffer 或 TypedArray 为代表的原始字节。
下面是将 Base64 字符串转为 Uint8Array 的经典标准实现,逻辑严密、兼容所有主流浏览器与 Node.js 现代环境:
/**
 * 将 Base64 字符串转换为 Uint8Array 字节数组
 * @param {string} base64Str - 标准或合法的 Base64 编码字符串
 * @returns {Uint8Array} 解码后的二进制字节数组
 */
function base64ToUint8Array(base64Str) {
  // 1. 调用 atob 解码为单字节二进制字符串
  const binaryString = atob(base64Str);
  const len = binaryString.length;

  // 2. 预先分配定长无符号 8 位数组
  const bytes = new Uint8Array(len);

  // 3. 逐字符读取码点并写入字节数组
  for (let i = 0; i < len; i++) {
    bytes[i] = binaryString.charCodeAt(i);
  }

  return bytes;
}

// 示例验证:
const base64Data = "SGVsbG8gV29ybGQ="; // 对应文本 "Hello World"
const byteArray = base64ToUint8Array(base64Data);
console.log(byteArray);
// 输出: Uint8Array(11) [72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100]
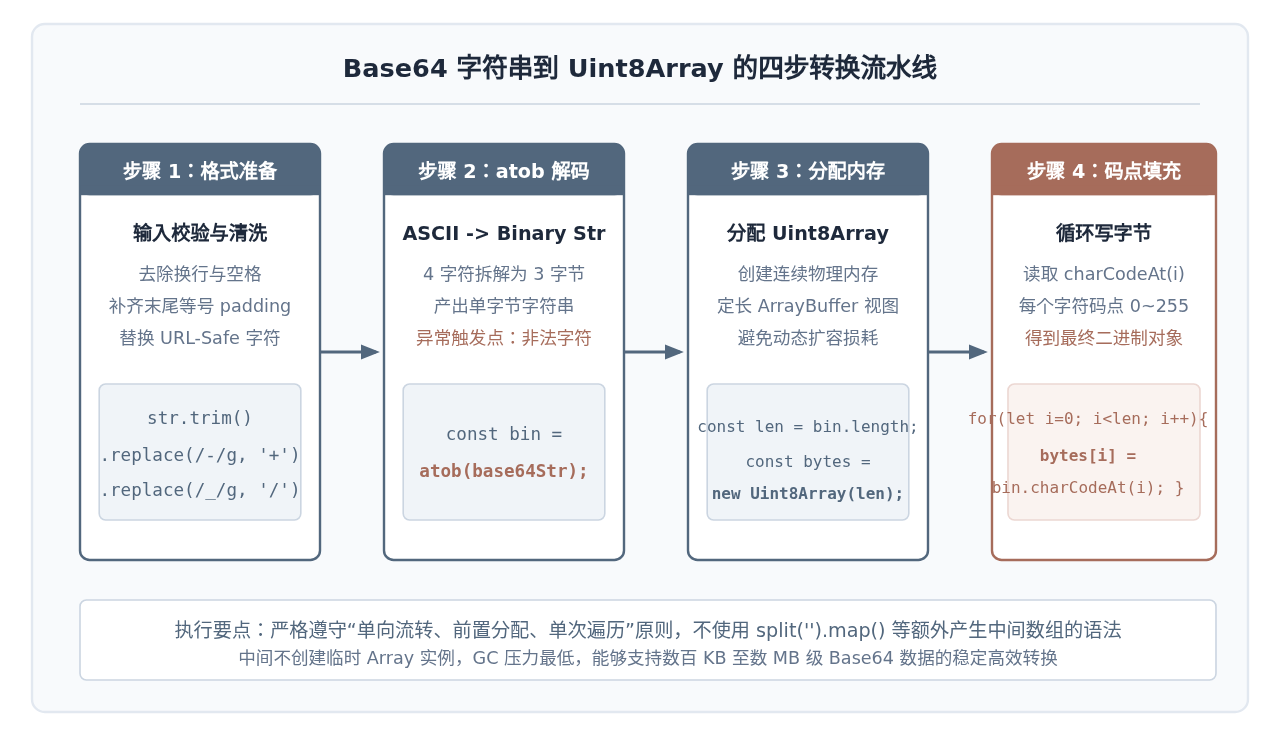
这段代码分为四个清晰的操作环节,每个环节都有明确的职责分工与执行约束:
- 输入解码(atob):
window.atob()(ASCII to Binary)负责解析 Base64 码表,把 4 个一组的 Base64 字符(每个携带 6 比特信息)还原为 3 个字节的数据。返回的结果是一个由这些字节组成的字符串。 - 定长内存申请(new Uint8Array):
Uint8Array必须指定固定长度。使用binaryString.length一次性在堆内存中开辟一段连续的ArrayBuffer,避免了普通数组动态扩容的额外性能开销。 - 码点截取(charCodeAt):通过
binaryString.charCodeAt(i)拿到该字符在当前位置上的数值(范围在 0 到 255 之间)。 - 内存写入:赋值语句
bytes[i] = ...直接把整数写入底层物理字节,形成最终的类型化字节数组。
二、深层机制:为什么不能一步到位?
初学者常常感到疑惑:既然 atob() 已经被称为“解码”,为什么它不能直接返回 Uint8Array,而偏偏要返回一个“二进制字符串”?为什么我们还要写一个 for 循环去提取码点?
1. 历史 API 规范与“二进制字符串”本质
atob 和 btoa 是网景浏览器(Netscape)在二十多年前制定的老旧规范,其名称源自 Unix 时代的 ASCII to Binary 与 Binary to ASCII。在那个时代,ECMAScript 规范中根本没有 ArrayBuffer 或 Uint8Array 这类底层二进制类型(TypedArray 是在 2011 年随 WebGL 1.0 规范才正式引入浏览器的)。
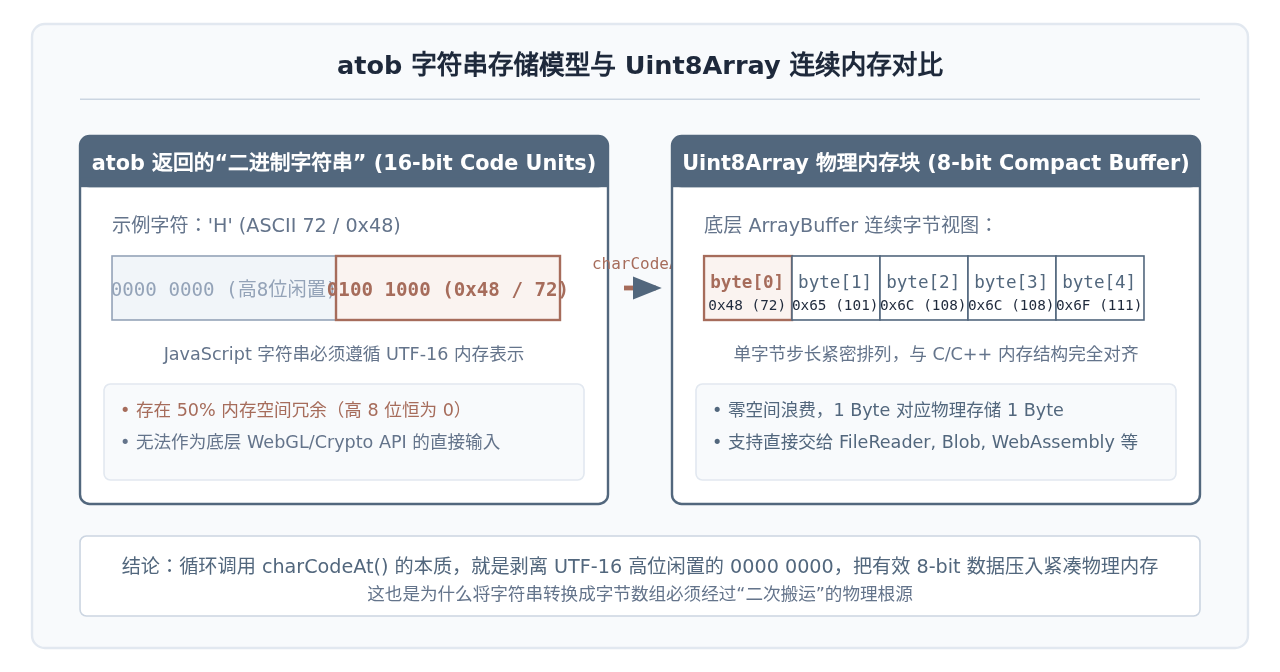
当时浏览器处理二进制数据的唯一手段,就是借用字符串(String)作为载体。在 JavaScript 内部,字符串使用 16 位的 UTF-16 编码单元(Code Unit)存储。atob() 解码出来的所谓“二进制字符串”,并不是真正的字节流,而是一个每个字符码点都在 0x00 ~ 0xFF(即 0 到 255)区间的特殊 JavaScript 字符串。
在 V8 等现代 JS 引擎中,一个常规 JavaScript 字符串中的字符哪怕数值小于 256,它本质上也是由字符串对象包装的只读序列;而
Uint8Array 是直接映射到一段连续物理内存(ArrayBuffer)上的视图。两者在内存模型、可变性及底层硬件接口交互上完全不同。
三、实际应用中的核心陷阱与边界处理
在真实业务工程中,直接调用未做防护的 atob() 极易触发运行时异常。最典型的两类报错是:URL-Safe 字符未转义导致抛错,以及混淆“多字节中文”与“Base64 字符串”导致的字符越界。
1. URL-Safe Base64 与缺失 Padding(等号)
在 Web API 路由传参或 JWT(JSON Web Token)中,标准 Base64 字符集中的 + 和 / 会被替换为 URL 安全字符 - 和 _,并且通常会剔除末尾的填充符 =。
原生的 atob() 极为严格:遇到 - 或 _,或者字符总长度不是 4 的整倍数时,会直接抛出:
DOMException: Failed to execute 'atob' on 'Window': The string to be decoded is not correctly encoded.
因此,在调用 atob() 前,必须将 URL-Safe 字符替换回标准 Base64 码表,并自动计算末尾补齐 =:
function normalizeBase64(base64Str) {
  // 1. 去除空白字符
  let str = base64Str.trim();

  // 2. 将 URL-Safe 的 '-' 和 '_' 替换回 '+' 和 '/'
  str = str.replace(/-/g, '+').replace(/_/g, '/');

  // 3. 计算长度模 4 补齐 '='
  const pad = str.length % 4;
  if (pad === 2) {
    str += '==';
  } else if (pad === 3) {
    str += '=';
  } else if (pad === 1) {
    throw new Error('非法的 Base64 字符串长度(模 4 余 1 无效)');
  }

  return str;
}
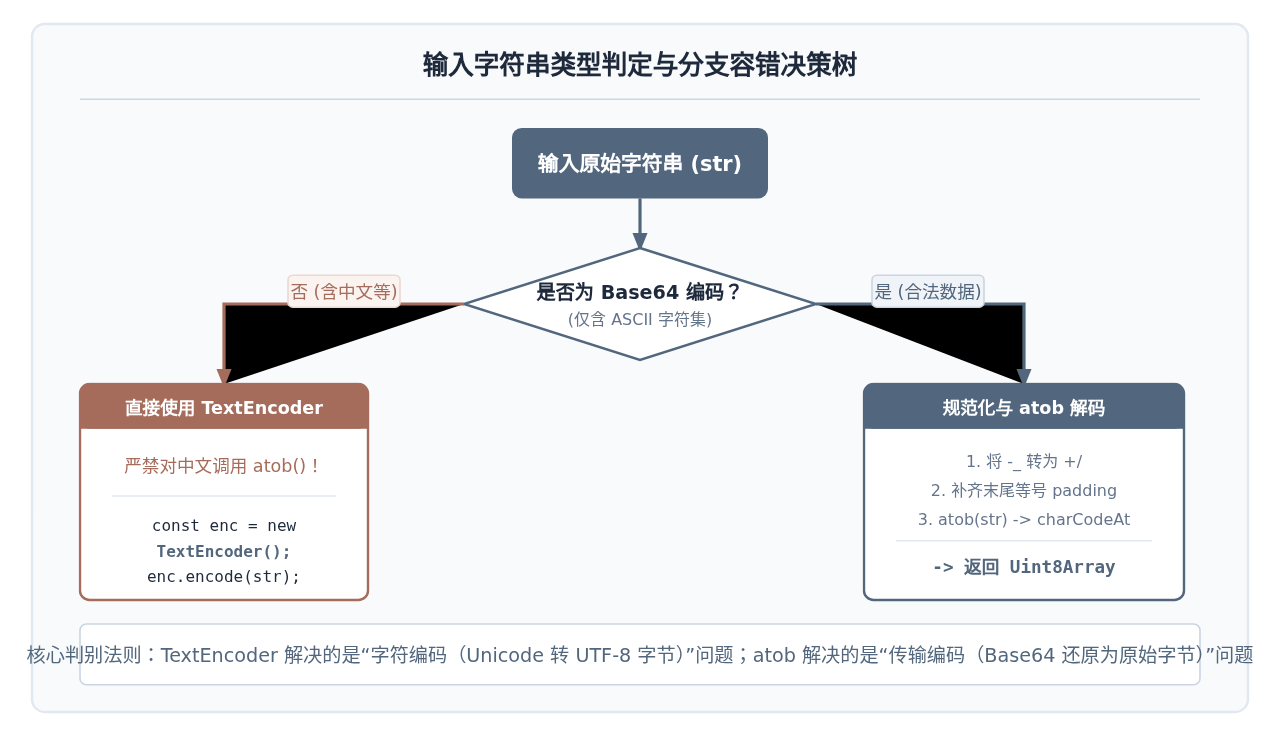
2. 中文等多字节 UTF-8 字符串与 atob 的边界混淆
许多开发者遇到的另一个常见错误是:直接把一段包含中文的普通字符串(如 "你好世界")尝试通过 atob 转成字节数组。
必须理清这个概念分水岭:
- 输入是普通中文字符串:根本不应该使用
atob!应该使用浏览器现代原生的new TextEncoder().encode(str),它会直接将 UTF-8 文本编码为Uint8Array。 - 输入是经 Base64 编码的 UTF-8 字符串:当解码后拿到的
Uint8Array实际包含 UTF-8 字节时,如果需要还原为中文文本,必须使用new TextDecoder().decode(bytes),切忌直接在 JS 字符串中强行拼接,否则会导致汉字乱码。
四、现代规范演进与替代方案对比
随着 ECMAScript 标准以及现代浏览器、Node.js 运行时的演进,以往必须手写 atob() + 循环 charCodeAt() 的样板代码,正在被更高效、更安全的现代官方原生 API 所取代。
1. 现代原生提案:Uint8Array.fromBase64
TC39 已经正式通过了 Uint8Array to/from Base64 规范(在 Chrome 127+、Safari 18.2+ 以及 Node.js 22+ 中已原生支持)。它允许开发者直接调用静态方法完成转换,底层直接由 C++ 完成字节搬运,性能比手写 JS 循环高出数倍:
// 现代浏览器与 Node.js 22+ 原生写法:
const bytes = Uint8Array.fromBase64("SGVsbG8gV29ybGQ=", {
  alphabet: "base64url" // 原生直接支持 'base64' 或 'base64url'
});
console.log(bytes); // Uint8Array [72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100]
2. Node.js 服务端方案:Buffer
在 Node.js 服务端环境中,Buffer 本身就是 Uint8Array 的子类。直接调用 Buffer.from(str, 'base64') 即可,完全不需要在 Node 环境中模拟浏览器 atob:
// Node.js 环境原生最佳实践:
const nodeBuffer = Buffer.from("SGVsbG8gV29ybGQ=", 'base64');
// nodeBuffer 直接继承自 Uint8Array,可作为 TypedArray 直接使用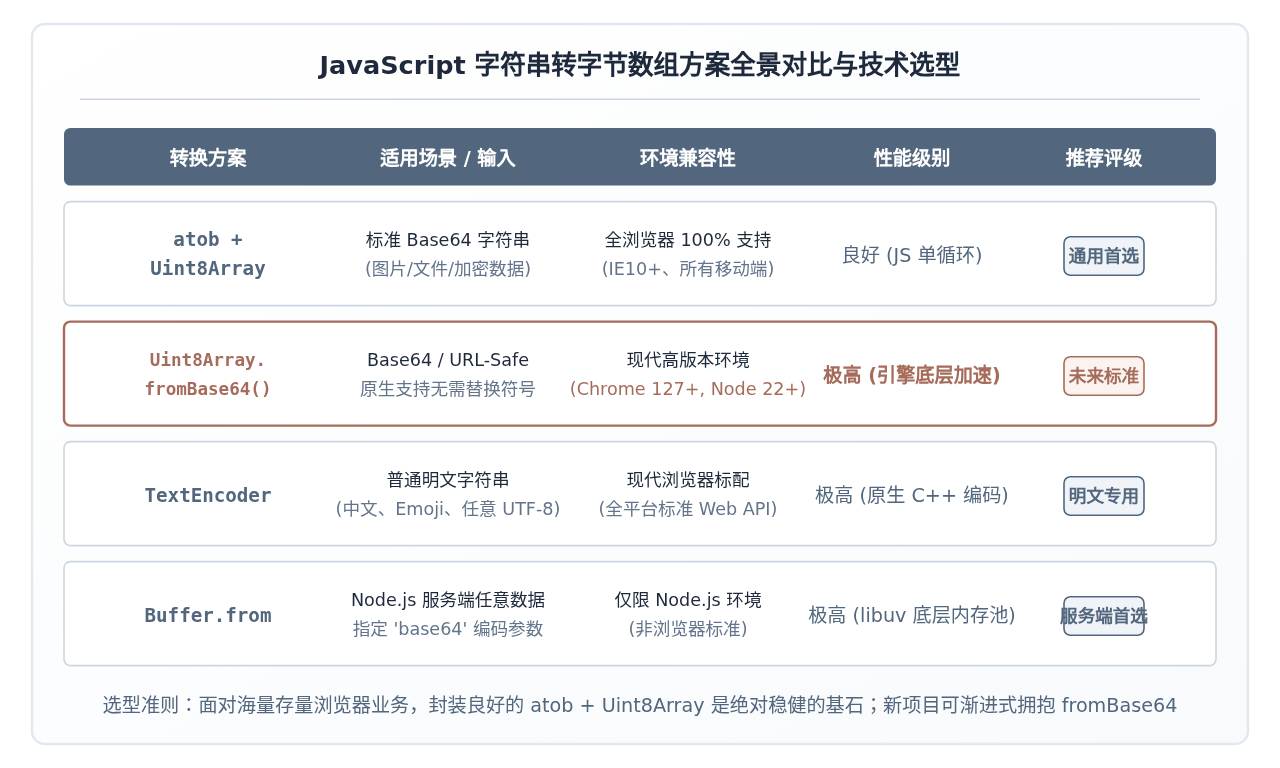
五、生产级健壮封装与完整代码
结合前文对于 URL-Safe 字符替换、Padding 自动补齐、现代原生特性检测(Feature Detection)及回退兼容的分析,在生产项目中推荐使用如下健壮的完整封装:
/**
 * 生产级安全 Base64 转 Uint8Array 工具函数
 * @param {string} input - Base64 字符串(支持标准 Base64 或 URL-Safe Base64)
 * @returns {Uint8Array}
 */
function safeBase64ToUint8Array(input) {
  if (typeof input !== 'string') {
    throw new TypeError('期望传入字符串参数');
  }

  // 1. 如果环境支持现代官方 Uint8Array.fromBase64,优先使用底层加速
  if (typeof Uint8Array.fromBase64 === 'function') {
    try {
      return Uint8Array.fromBase64(input.trim(), { alphabet: 'base64url' });
    } catch {
      // 若包含非标准 URL-Safe 字符则静默走兼容回退
    }
  }

  // 2. 清洗字符并规范化 URL-Safe 字符
  let base64 = input.trim().replace(/-/g, '+').replace(/_/g, '/');

  // 3. 自动补全末尾缺失的 '=' padding
  const mod = base64.length % 4;
  if (mod === 2) {
    base64 += '==';
  } else if (mod === 3) {
    base64 += '=';
  } else if (mod === 1) {
    throw new Error('无效的 Base64 字符串长度');
  }

  // 4. 调用 atob 解码为二进制字符串
  const binaryString = atob(base64);
  const len = binaryString.length;

  // 5. 分配定长 TypedArray 缓冲区并填入字节
  const bytes = new Uint8Array(len);
  for (let i = 0; i < len; i++) {
    bytes[i] = binaryString.charCodeAt(i);
  }

  return bytes;
}

// ================= 完整测试用例 =================
// 测试用例 1: 标准 Base64 (对应 "Hello World")
const t1 = safeBase64ToUint8Array("SGVsbG8gV29ybGQ=");
console.log("测试 1 (标准):", t1);

// 测试用例 2: URL-Safe Base64 且省略等号
const t2 = safeBase64ToUint8Array("SGVsbG8gV29ybGQ");
console.log("测试 2 (URL-Safe):", t2);

// 测试用例 3: 结合 TextDecoder 还原原始文本
const decoder = new TextDecoder();
console.log("还原文本:", decoder.decode(t1)); // 输出: "Hello World"
通过这一套封装,既能在支持现代特性的高版本引擎中享受原生 C++ 带来的极致性能,又能在老旧环境以及各类小程序、移动端 WebView 中稳定回退,真正做到了对输入格式宽容、对底层内存精准掌控。
解决JS日期格式化中的时区偏差与Invalid Date问题
2026-11-13 16:13:19
js字符串全局匹配g标志转数组
2026-11-13 15:54:12
怎么将逗号分隔字符串转换为JS字符串数组
2026-11-13 13:43:38
js字符串怎么用match转数组/.exec
2026-11-13 12:46:02
js字符串转数组Array.from和[...str]处理Unicode区别
2026-11-13 12:04:20