js字符串转数组Array.from和[...str]处理Unicode区别
深入对比 JavaScript 中 Array.from 与 [...str] 将字符串转为数组时的 Unicode 处理机制,从 UTF-16 码元、码点到字形簇,解析两者的异同与实践选型。
图示:Array.from 与 [...str] 字符转数组核心机制总览
Array.from(str) 与 [...str] 在处理 Unicode 字符时没有任何区别。两者都遵循 ECMAScript 的字符串迭代协议(String.prototype[Symbol.iterator]),能够自动识别 UTF-16 代理对(Surrogate Pairs),将生僻字和常规 Emoji 按完整的 Unicode 码点(Code Point)切分,彻底避免了 str.split('') 造成的乱码截断。它们真正的差异在于配套功能、边界容错与底层降级机制,而非对 Unicode 码点的解析能力。
一、为什么传统 split('') 处理 Unicode 会出现乱码?
在深入对比 Array.from 与 [...str] 之前,需要先弄清 JavaScript 字符串的底层存储机制。
JavaScript 早期采用了 UCS-2 编码,随后扩展为 UTF-16。在 UTF-16 规范中,基本多语言平面(BMP,码点范围 U+0000 至 U+FFFF)内的普通字符占用 16 位(即 1 个码元 / Code Unit)。然而,超出该范围的辅助平面字符(如生僻汉字“𠮷”、常见 Emoji 表情“😀”)需要占用 32 位,由一对 16 位的高位代理项(High Surrogate)与低位代理项(Low Surrogate)拼合表示。
传统的 str.split('') 方法是严格基于 16 位码元(Code Unit) 进行机械切分的:
const str = '𠮷';
console.log(str.length); // 示例输出:2(占用两个 UTF-16 码元)

// 传统 split('') 会强行将代理对从中间剪开
const splitArr = str.split('');
console.log(splitArr);
// 示例输出:['\uD842', '\uDFB7'](两个无法独立显示的半字孤立代理项)
当一对代理项被切散后,两半各自失去了有效字符意义,直接输出到页面或控制台就会显示为问号乱码()或无效空白。
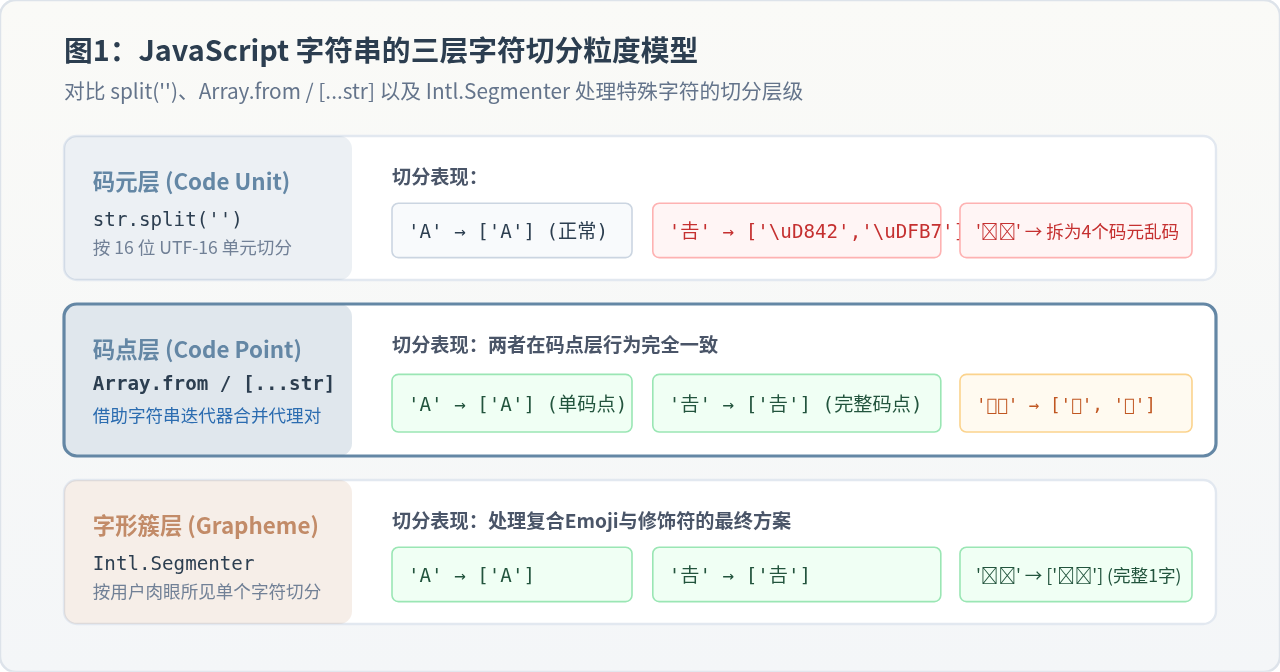
图1:JavaScript 字符串的三层字符切分粒度模型
二、Array.from 与 [...str] 处理 Unicode 码点的共性机制
为了解决传统方法拆散代理对的问题,ES6(ECMAScript 2015)为字符串内置了迭代协议(即 String.prototype[Symbol.iterator])。
无论是调用 Array.from(str) 还是展开运算符 [...str],它们的内部执行逻辑都是请求并消费字符串的原生迭代器。该迭代器在遍历字符串时,会自动检测当前位置是否为高位代理(0xD800 到 0xDBFF):如果是,它会连同后继的低位代理(0xDC00 到 0xDFFF)合并读取,作为一个完整的 Unicode 码点(Code Point) 产出。
const text = 'A𠮷B😀';

// 方式一:Array.from
const fromArr = Array.from(text);
console.log(fromArr);
// 示例输出:['A', '𠮷', 'B', '😀']

// 方式二:[...str] 展开语法
const spreadArr = [...text];
console.log(spreadArr);
// 示例输出:['A', '𠮷', 'B', '😀']

console.log(fromArr.length);   // 示例输出:4
console.log(spreadArr.length); // 示例输出:4
可以看到,无论生僻字“𠮷”还是 Emoji“😀”,两者都得到了正确完整的保留,产出的数组长度也是直观认知的 4,而非 text.length 返回的 6。
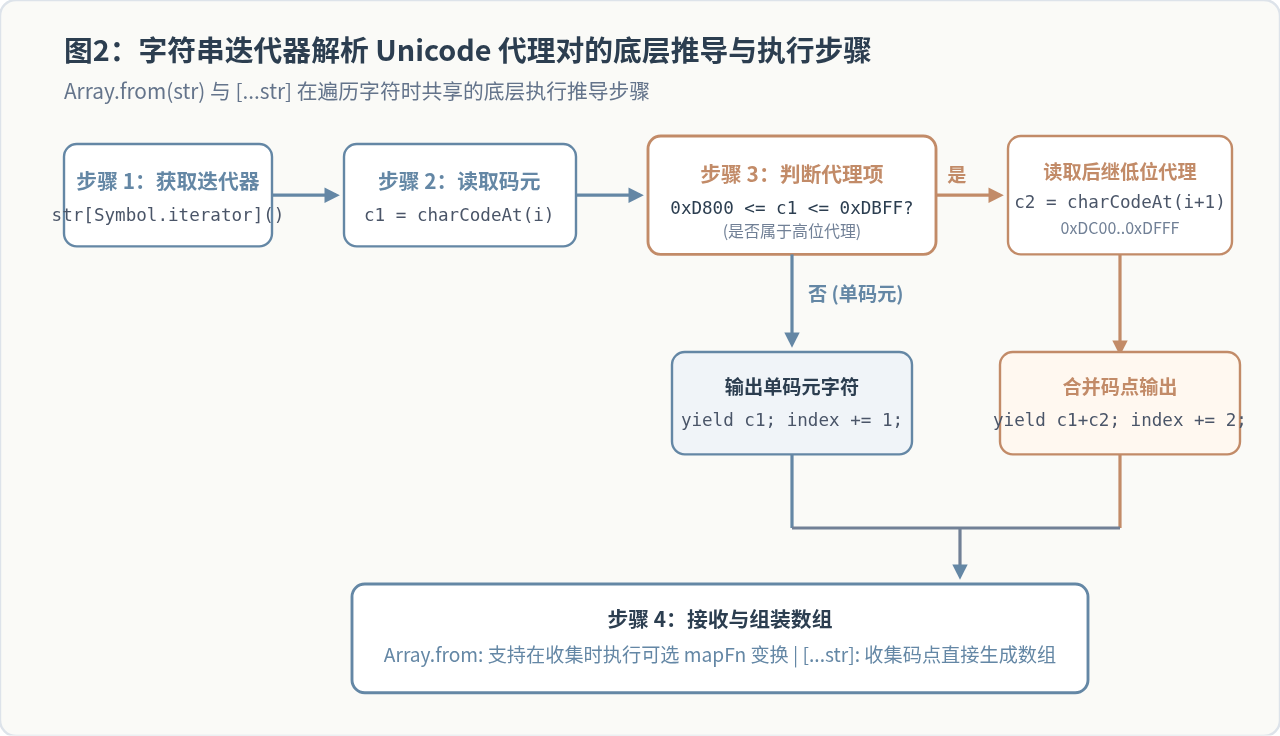
图2:字符串迭代器解析 Unicode 代理对的底层推导与执行步骤
三、两者皆无法完美解决的边界:复合字形簇(Grapheme Clusters)
许多初学者误以为 Array.from 或 [...str] 已经能完美处理所有日常看到的“字符”,但事实并非如此。Unicode 的复杂度不仅限于码点,还存在用户感知字形簇(User-perceived Character / Grapheme Cluster):
- 肤色修饰符(Emoji Modifiers):例如“👍🏽”是由大拇指“👍”(
U+1F44D)与肤色修饰符“🏽”(U+1F3FD)两个独立码点组合而成。 - 零宽连字序列(ZWJ Sequences):例如“👨👩👧👦”(家庭)是由男人、女人、女孩、男孩 4 个 Emoji 加上 3 个零宽度连接符(
U+200D)共 7 个码点拼接而成。 - 组合用附加符号(Combining Marks):例如带有重音符的“é”,在某些输入源中是“e”(
U+0065)后紧跟组合抑扬符“́”(U+0301)。
对于这类字符,Array.from 和 [...str] 依然会将其切开,因为两者的极限就是“Unicode 码点”,无法识别更高维度的字形簇:
const thumbsUp = '👍🏽';
console.log([...thumbsUp]);
// 示例输出:['👍', '🏽'](被拆为基础表情与独立肤色色块)
const family = '👨👩👧👦';
console.log(Array.from(family));
// 示例输出:['👨', '', '👩', '', '👧', '', '👦'](被拆为 7 个元素,包含看不见的 ZWJ)Intl.Segmenter:
const segmenter = new Intl.Segmenter('zh', { granularity: 'grapheme' });
const trueChars = [...segmenter.segment('👨👩👧👦👍🏽')].map(s => s.segment);
console.log(trueChars); // 示例输出:['👨👩👧👦', '👍🏽'](完整保留字形簇)四、Array.from 与 [...str] 的真实区别与边界异同
既然在 Unicode 码点解析上完全一致,那么这两者在实际编程中的差异究竟在哪里?主要体现在以下三个方面:
1. 内置映射转换参数(mapFn)
Array.from 允许传入第二个参数作为映射函数,其执行时机是在迭代读取每个 Unicode 码点的同时直接进行变换,不会产生中间数组;而 [...str] 必须先完整解构成中间数组,再调用 .map()。
const raw = 'abc𠮷';

// 推荐:Array.from 单次遍历完成码点提取与转换
const upper1 = Array.from(raw, char => char.toUpperCase());

// [...str] 需要分配一个包含中间元素的数组,再执行一次遍历
const upper2 = [...raw].map(char => char.toUpperCase());
2. 对缺失或受损迭代器的降级行为(类数组回退)
这是两者最深层的语法差异:
[...str]是纯粹的展开语法,它强制要求目标对象具备[Symbol.iterator]属性。如果该属性被篡改或删除,会直接抛出TypeError: str is not iterable。Array.from(obj)兼顾了“可迭代对象(Iterable)”与“类数组对象(Array-like)”。如果字符串的迭代器被删除,Array.from不会报错,而是降级采用length属性配合数字下标索引访问。而下标访问str[i]是读取 16 位码元的,因此降级后的Array.from会退化为split('')的表现!
// 极端场景验证:临时篡改字符串迭代器
const originalIter = String.prototype[Symbol.iterator];
delete String.prototype[Symbol.iterator];

const testStr = '𠮷';

try {
  console.log([...testStr]);
} catch (err) {
  console.log(err.message); // 示例输出:testStr is not iterable
}

// Array.from 回退到按索引读取类数组,退化为码元切分:
console.log(Array.from(testStr));
// 示例输出:['\uD842', '\uDFB7']

// 恢复原生迭代器
String.prototype[Symbol.iterator] = originalIter;
3. 语法语义与执行性能
在日常业务开发中:
[...str]属于语法级(Syntax-level)操作,书写极其简洁直观。现代 V8 引擎针对字符串展开做了专门的快速路径优化(Fast Path),在纯解构场景下性能略优于函数调用的Array.from。Array.from是内置对象方法,意图明确,支持thisArg绑定上下文,更适合配合函数式编程使用。
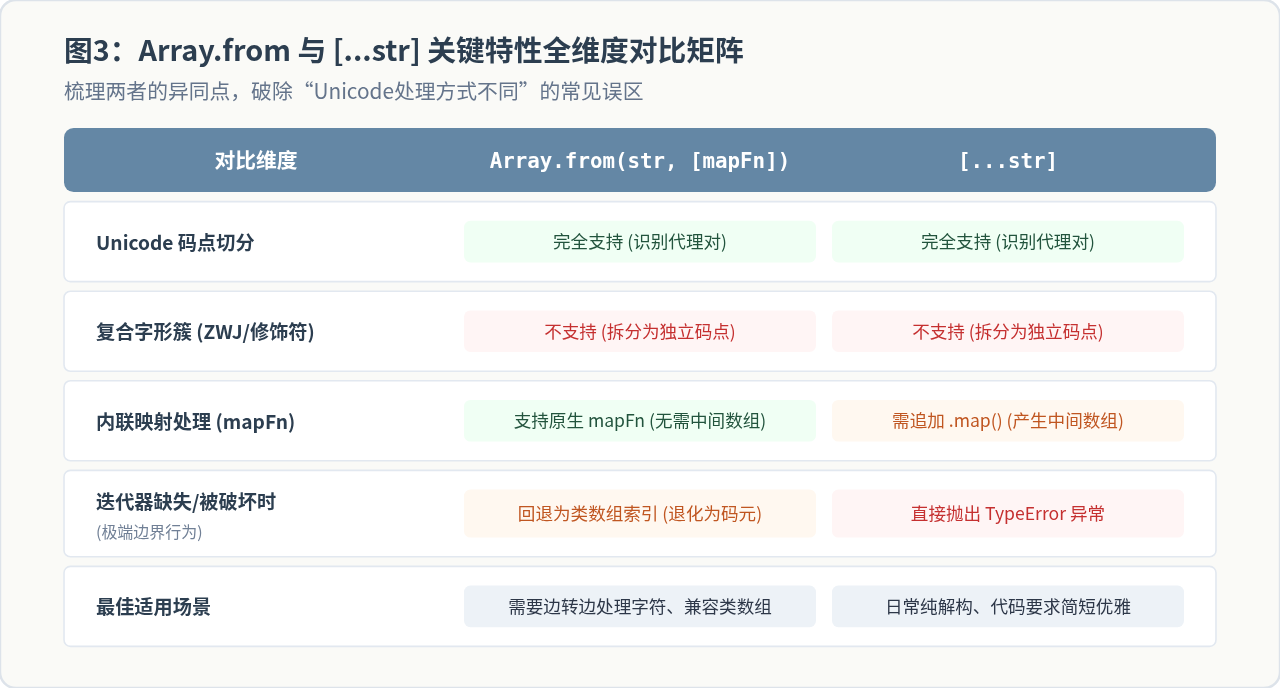
图3:Array.from 与 [...str] 关键特性全维度对比矩阵
五、综合选型总结与决策建议
为了在实际开发中写出既严谨又高效的代码,可以参考以下选型规则:
- 常规字符串转数组(代码简洁优先):首选
[...str]。它完全支持代理对码点解析,语法简练,易读性高。 - 转数组同时需要清洗、映射或计算(性能与内存优先):首选
Array.from(str, mapFn)。单步完成码点切分与映射,避免了先展开再.map()的两次遍历和临时数组开销。 - 涉及文本统计、高精度字数限制、复合表情与多语言音标排版:不能仅依赖
Array.from或[...str],必须引入Intl.Segmenter按granularity: 'grapheme'提取字形簇,避免用户输入的表情符号被撕裂。 - 严格禁止在生产环境中使用
str.split(''):除非确定字符串仅包含 ASCII 字母数字,否则split('')必定在遇到生僻字或表情时产生截断乱码。
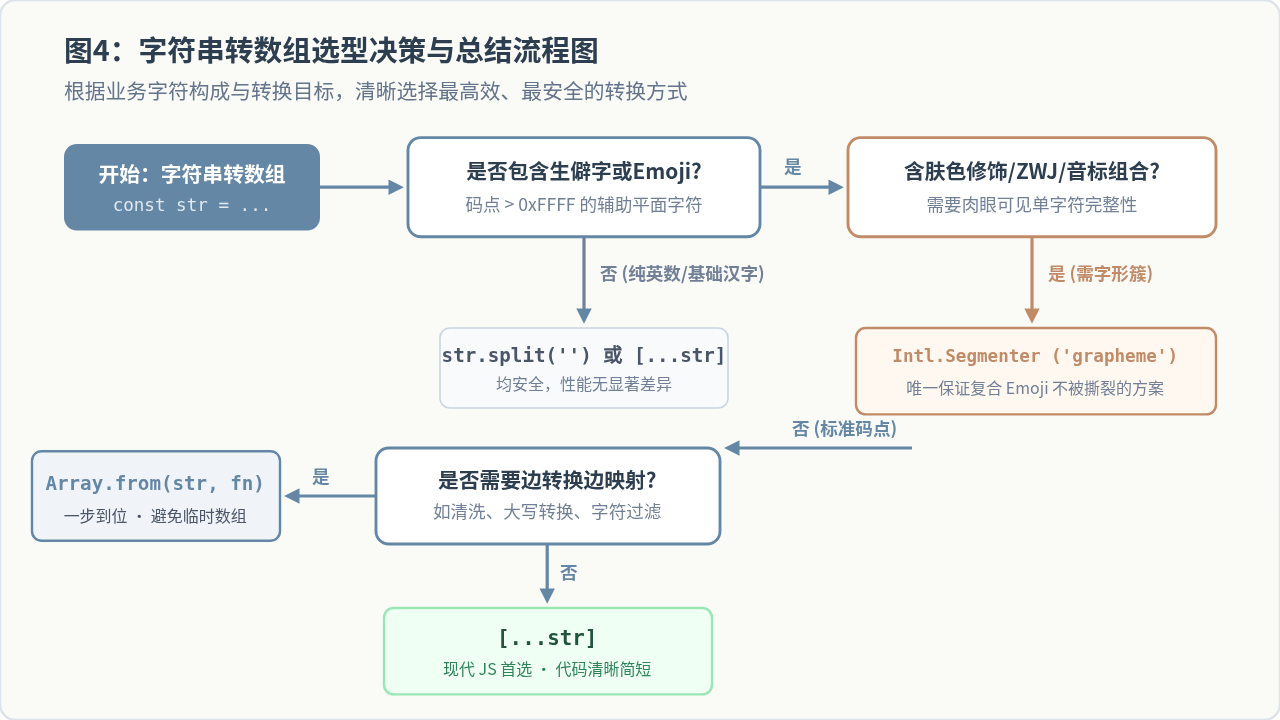
图4:字符串转数组选型决策与全景总结流程图
js字符串怎么用match转数组/.exec
2026-11-13 12:46:02
angular字符串转数组管道pipe
2026-11-13 09:03:45
js字符串怎么转数组Array.from方法
2026-11-13 08:52:16
JavaScript运行时动态为对象添加方法
2026-11-12 17:15:39
JS中Math.round与toFixed实现四舍五入的区别
2026-11-11 15:39:38