js字符串转数组后顺序错乱原因
深入解析JavaScript中字符串转数组后出现顺序错乱的真实原因。从Unicode代理对与Emoji代码单元截断、对象整数键自动升序遍历规范,到异步并发竞态与默认sort字典序,全面梳理技术根因并提供生产级保序解决方案。
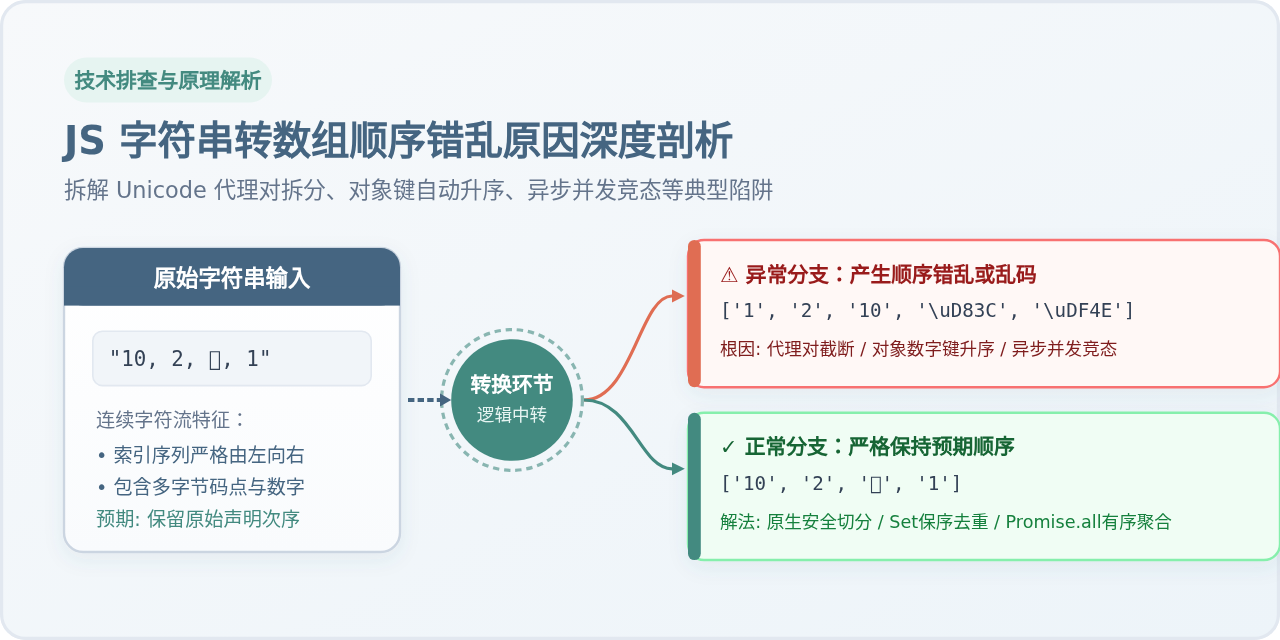
在 JavaScript 规范中,无论是调用原生 String.prototype.split()、Array.from(str) 还是展开运算符 [...str],其底层执行逻辑都是严格按照字符串由左至右的物理索引依次读取并切分的,语言本身绝不会对数组元素进行随机打乱。开发者在实际业务中遇到的“字符串转数组后顺序错乱”,并非原生切分 API 失效,而是由于 Unicode 代理对拆分破坏了字符结构、中途经由对象键(Object Key)中转触发了整数键自动升序遍历、切分后在异步并发回调中无序推入数组,或是误触了默认字典序排序。明确这几项核心机制,就能从源头彻底根治顺序错乱问题。
一、排查主线:确定顺序错乱的真实发生环节
排查字符串转数组错乱问题时,首先需要破除一个常见误区:“是不是 split() 在处理大量数据或特定字符时产生了随机性?”结论非常明确:原生切分方法是确定性的纯函数,内存中生成的数组初始索引永远与原字符串出现的先后次序完全吻合。
导致“最终看到的数组乱序”的真实代码节点,往往隐藏在切分操作的上下文或伴随处理中。依照下列诊断流程,可以在数分钟内精确定位错乱源头:
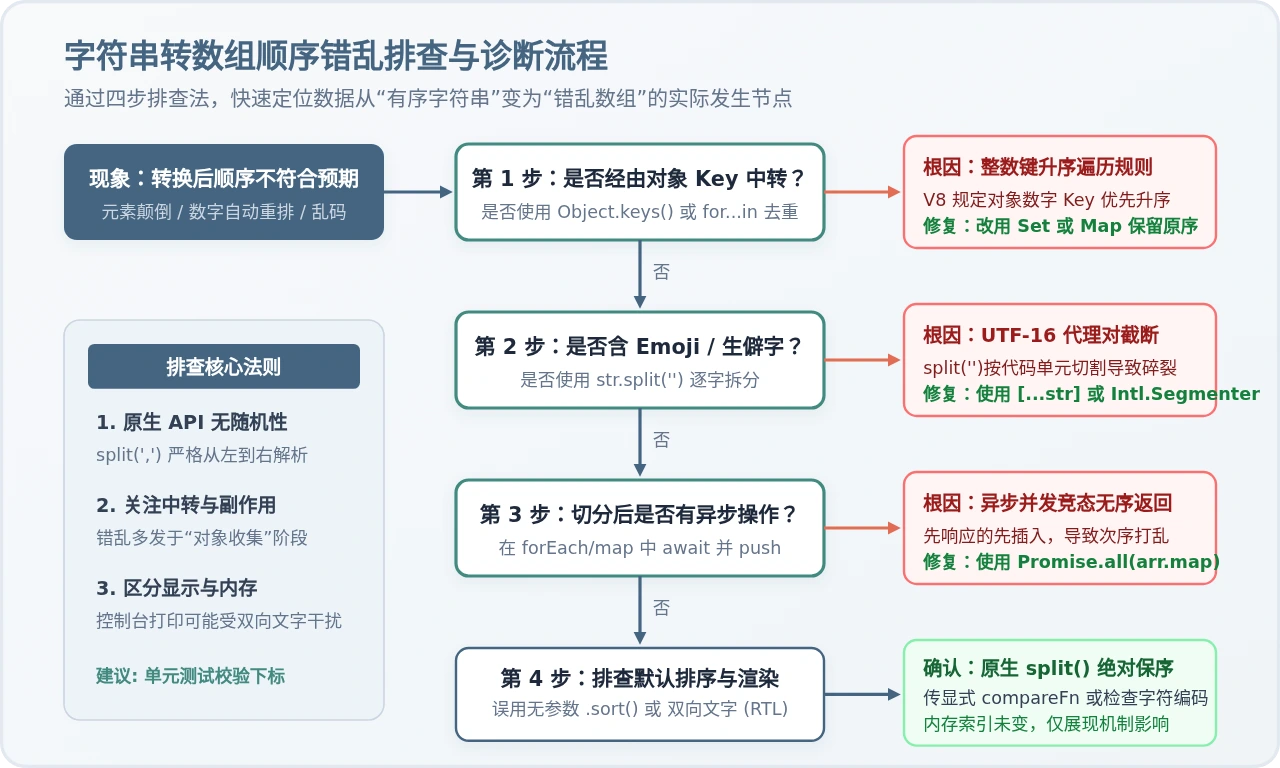
按照图 1 所示的排查路径,我们可以将所有造成错乱的场景归结为四大核心原因,接下来我们将逐个深入分析其底层机理与标准解决方案。
二、原因一:Unicode 与多字节字符的 UTF-16 拆分陷阱
当字符串中包含 Emoji 表情(如 🍎、👨👩👧👦)或者罕见生僻字(如 “𠮷”)时,如果使用 str.split('') 进行逐字符切分,极易观察到字符被截断成无法识别的乱码、长度翻倍,或者在后续执行 reverse()、排序与截取操作时出现元素颠倒。
1. 为什么 split('') 会拆散字符?
JavaScript 的字符串底层采用 UTF-16 编码存储。在 UTF-16 中,绝大多数常用字符(即基本多语言平面 BMP,码点范围 U+0000 至 U+FFFF)占用 1 个 16 位的代码单元(Code Unit)。
而 Emoji、古代生僻字属于增补平面(Astral Planes,码点大于 U+FFFF),它们必须通过两个 16 位的代码单元组合表示,这两个单元分别被称为高位代理(High Surrogate,范围 0xD800–0xDBFF)和低位代理(Low Surrogate,范围 0xDC00–0xDFFF)。
String.prototype.split('') 的工作原理是盲目地按照 UTF-16 代码单元进行切割。它并不理解 Unicode 码点的完整概念,因此会将原本成对的高低代理拆分成两个独立的非法孤立项。
// 示例:生僻字与 Emoji 的 split('') 陷阱
const str = "中𠮷🍎";

console.log(str.length);
// 示例输出: 5 ('中'占1位,'𠮷'占2位,'🍎'占2位)

const arr = str.split('');
console.log(arr);
// 示例输出: ['中', '\uD842', '\uDFB7', '\uD83C', '\uDF4E']
// 原本 3 个字符被切成了 5 个元素,代理对被硬生生切开!

// 如果此时对数组执行逆序操作:
console.log(arr.reverse().join(''));
// 示例输出: 乱码!低位代理跑到高位代理前面,组合彻底损坏。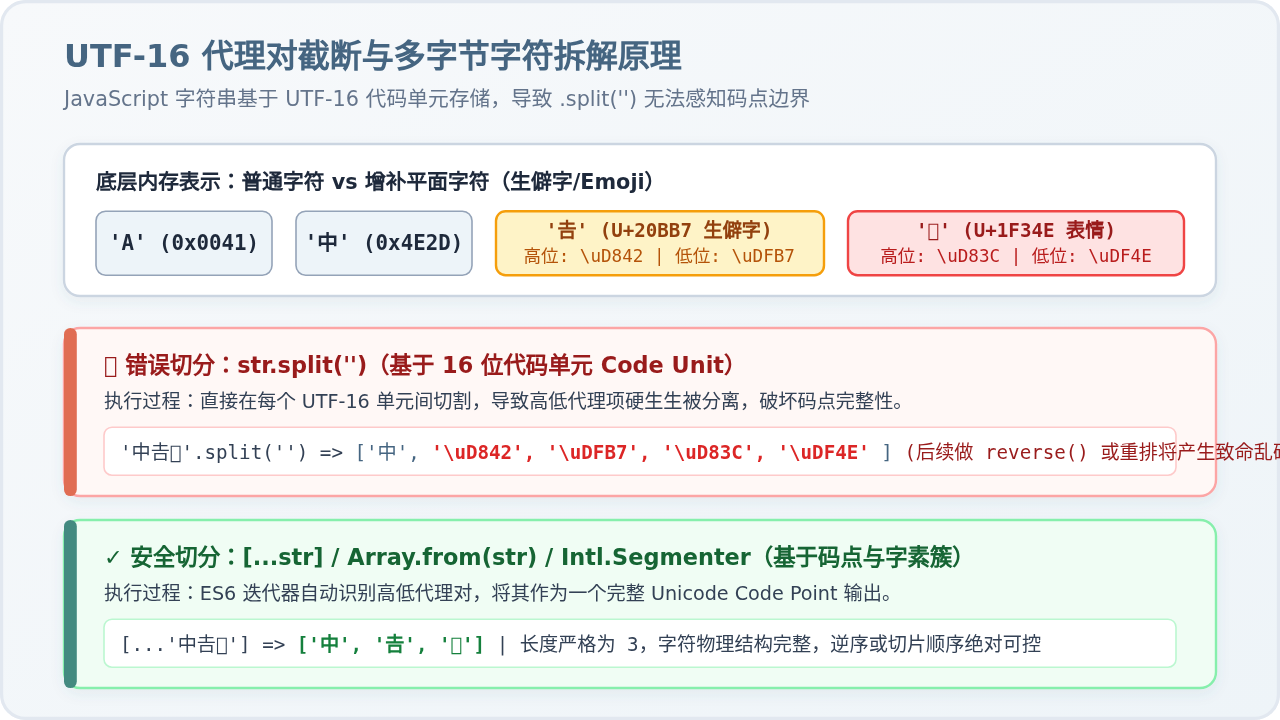
2. 安全的字符串逐字切分方案
若需要完整保留字符本身的语义和顺序,应使用能够识别 Unicode 码点(Code Point)或字素簇(Grapheme Cluster)的原生 API:
-
展开运算符
[...str]或Array.from(str): ES6 为字符串部署了迭代器接口(Symbol.iterator),迭代器在遍历时会自动识别成对的高低代理项,将其作为一个完整的 Code Point 返回。const safeArr = [...str]; console.log(safeArr); // 示例输出: ['中', '𠮷', '🍎'] (长度为 3,字符完整保序) -
复合字符使用
Intl.Segmenter: 对于由多个码点通过零宽连接符(\u200D)拼合的复合 Emoji(例如 👨👩👧👦 实际上由 4 个独立小人 Emoji 和 3 个连接符组成),即便是[...str]也会将其拆成单独的成员。此时应使用现代国际化文本分割器:const familyStr = "👨👩👧👦"; const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" }); const segments = Array.from(segmenter.segment(familyStr), s => s.segment); console.log(segments); // 示例输出: ['👨👩👧👦'] (完整保留为一个用户视角的完整字素)
三、原因二:经由对象键(Object Keys)中转引发的整数升序重排
在实际项目开发中,这是引起“字符串转数组后顺序完全错乱”的最普遍罪魁祸首。
很多开发者在通过 str.split(',') 将以逗号隔开的 ID 或数值串转为数组后,为了去除重复项或者构建查询索引,习惯性地将数组元素作为键挂载到普通 JavaScript 对象 {} 上,然后再通过 Object.keys() 重新取回数组。这时,原本的顺序往往被彻底打乱。
1. ECMAScript 规范中的对象属性遍历顺序
在 ECMAScript 2015 (ES6) 及其后续规范(详见规范第 9.1.12 节 [[OwnPropertyKeys]] 定义)中,明确规定了对象自有属性的遍历与枚举次序:
-
整数索引键(Integer Indices):所有可以转换为 32 位无符号整数(非负整数,范围
0到2^32 - 2)的属性名,必须严格按照数值大小升序排列优先遍历,与代码写入属性的实际先后次序完全无关! - 普通字符串键(String Keys):无法转换为非负整数的字符串属性名,才严格按照属性被创建或插入的时间次序依次遍历。
- Symbol 键:最后按照创建的插入时间次序遍历。
由于 Object.keys()、for...in、Object.values() 以及 JSON.stringify() 均严格遵循这一规范,如果字符串切分后的子串包含数字,一旦借由普通对象 key 中转,数字部分必然被强制按数值从小到大重新洗牌!
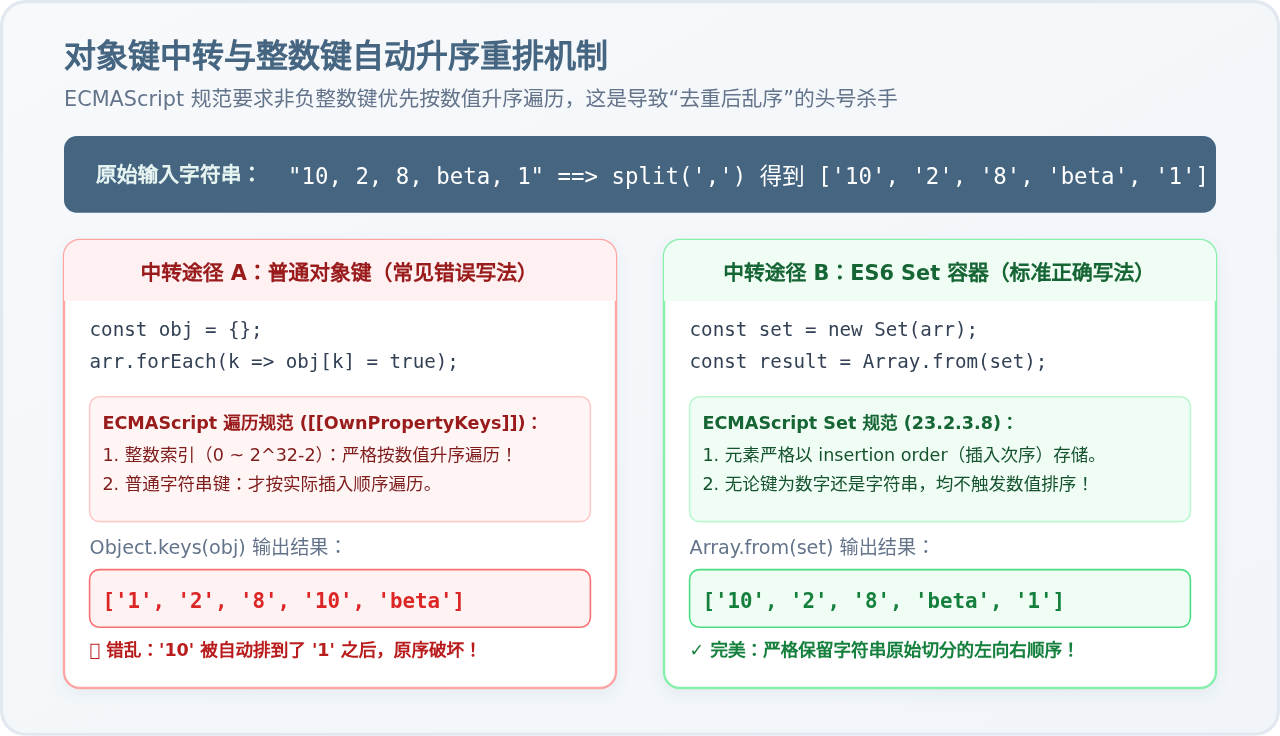
2. 典型错误代码复现
假设业务服务端返回了一个经过特定规则排序的 ID 列表字符串 "10,2,8,beta,1":
// ❌ 错误示范:使用普通对象去重导致顺序错乱
const rawStr = "10,2,8,beta,1";
const initialArr = rawStr.split(',');

// 开发者为了去重,将值放入对象中转
const mapObj = {};
initialArr.forEach(item => {
  mapObj[item] = true;
});

// 通过 Object.keys 重新获取去重后的数组
const scrambledArr = Object.keys(mapObj);

console.log(scrambledArr);
// 示例输出: ['1', '2', '8', '10', 'beta']
// 错乱产生:原本排在第1位的 '10' 被自动排到了第4位,'1' 窜到了最前面!3. 正确解决方案:使用保序容器 Set 或数组 filter
ES6 规范明确规定:Set 与 Map 容器内部的迭代器严格保证按照元素插入的先后时间顺序(Insertion Order)进行遍历,绝不会对数值键进行额外重排。
// ✓ 正确方案 A:使用 Set 保留切分后的原始顺序去重
const rawStr = "10,2,8,beta,1";
const orderedArr = [...new Set(rawStr.split(','))];

console.log(orderedArr);
// 示例输出: ['10', '2', '8', 'beta', '1'] (严格保持原序!)

// ✓ 正确方案 B:在旧环境下使用 filter 保序去重
const filteredArr = rawStr.split(',').filter((val, idx, self) => self.indexOf(val) === idx);
console.log(filteredArr);
// 示例输出: ['10', '2', '8', 'beta', '1']
四、原因三:切分后的异步并发处理未保序
在批量处理业务(如将一批按顺序排列的用户 ID 字符串转换并调用接口查询详情)时,异步请求的并发竞态是造成结果数组顺序错乱的另一大主因。
1. 常见的并发竞态陷阱
很多开发者将字符串按分隔符切分成数组后,直接在 forEach 中调用 async/await 并把结果 push 到目标数组中:
// ❌ 错误示范:在 forEach 中并发 push 导致乱序
const idsStr = "userA,userB,userC,userD";
const idList = idsStr.split(',');
const finalResult = [];

// 模拟不同耗时的网络请求
async function fetchUserDetail(id) {
  const delay = Math.random() * 200; // 网络延迟各不相同
  await new Promise(r => setTimeout(r, delay));
  return { id, data: "ok" };
}

// 错误写法:forEach 不会等待 async 回调完成
idList.forEach(async (id) => {
  const user = await fetchUserDetail(id);
  finalResult.push(user); // 哪个请求先响应,哪个就先被 push 进去!
});
由于各个异步网络请求或 I/O 任务返回的耗时不可控,先完成的 Promise 总是优先触发微任务并执行 push,最终 finalResult 中的数据顺序完全随机。
2. 解决方案:使用 Promise.all 保证下标对齐
Promise.all 内部拥有严格的保序机制:其返回的最终结果数组,各元素的索引位置严格与传入的 Promise 数组入参一一对应,与异步操作实际完成的快慢完全无关。
// ✓ 正确方案:使用 map 映射为 Promise 数组,并结合 Promise.all
async function loadUserData() {
  const idsStr = "userA,userB,userC,userD";
  const idList = idsStr.split(',');

  // 将每个元素映射为一个异步 Promise
  const promises = idList.map(id => fetchUserDetail(id));

  // Promise.all 确保输出数组的顺序与 idList 严格一致
  const finalOrderedResult = await Promise.all(promises);

  console.log(finalOrderedResult.map(u => u.id));
  // 示例输出: ['userA', 'userB', 'userC', 'userD'] (绝对保序)
}
五、原因四:默认字典序排序与文本双向渲染假象
除了上述三种结构与时序层面的成因外,还有两类容易被忽略的细节会给开发者造成“数组顺序被打乱”的错觉:
1. 切分后误用无参数的 Array.prototype.sort()
切分字符串后,如果开发者意图对数字数组进行排序,直接书写了 arr.sort(),会导致顺序严重“反常”。
const str = "10,2,30,5";
const numArr = str.split(',');

numArr.sort();
console.log(numArr);
// 示例输出: ['10', '2', '30', '5'] (并非按数值大小排序!)
原因在于:JavaScript 原生 sort() 在未提供比对函数时,会将所有元素转换为字符串,并按照每个字符的 UTF-16 代码单元字典序逐位比对。字符 "1" 的编码排在 "2" 前面,因此 "10" 自然排在 "2" 前面。正确做法是显式传入比对函数:numArr.sort((a, b) => Number(a) - Number(b))。
2. 双向文本(BiDi / RTL)带来的视觉反转假象
当字符串中夹杂希伯来语、阿拉伯语等从右至左(RTL)书写的字符时,浏览器的控制台或文本渲染引擎会应用 Unicode 双向文本排版算法(Unicode Bidirectional Algorithm)。
此时,数组在内存中的实际索引(arr[0]、arr[1])与切分前完全一致且顺序正确,但在控制台被格式化打印为单行时,文字显示方向被 RTL 控制字符影响,视觉上呈现出从右向左的逆序假象。可以通过检查 arr[0] 的实际值,或对各项逐一下标打印(console.table(arr))来验证真实内存顺序。
六、总结与避坑速查表
梳理 JavaScript 字符串转数组的整个生命周期,原生切分动作本身不会产生随机重排。发生顺序错乱的根本原因集中在:UTF-16 代码单元边界割裂、普通对象数字键升序规则介入、并发异步任务无序注入,以及默认字典序排序的副作用。
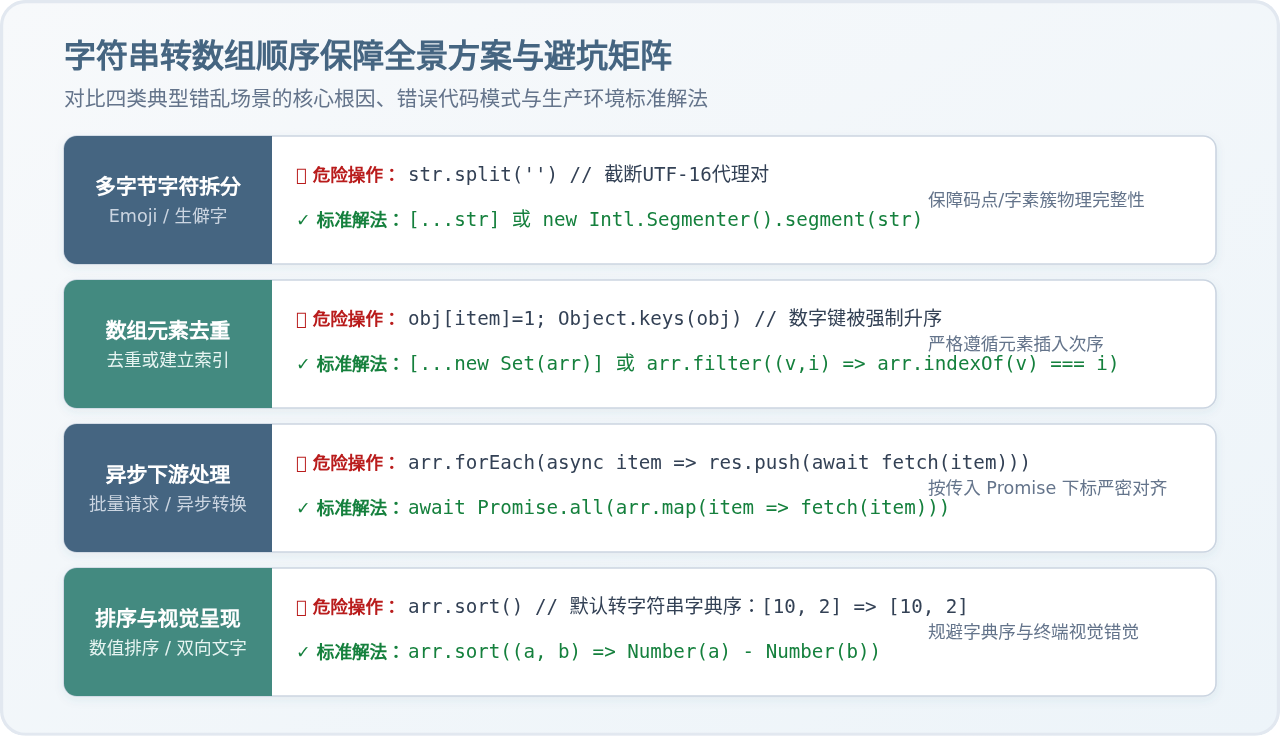
| 业务场景 | 错乱高发操作(危险) | 标准保序方案(推荐) | 底层保序原理 |
|---|---|---|---|
| 包含 Emoji / 生僻字的逐字符拆解 | str.split('') |
[...str] 或 Intl.Segmenter |
按 Unicode 码点或完整字素切分,避免 UTF-16 高低代理被切断。 |
| 切分后元素去重或建立索引 | obj[item] = 1; Object.keys(obj) |
[...new Set(arr)] |
Set 规范强制维持元素插入时间序;规避对象数字键自动升序规则。 |
| 切分后发起批量异步请求 | arr.forEach(async => res.push()) |
await Promise.all(arr.map(...)) |
Promise.all 严密保持结果下标与入参 Promise 数组顺序对齐。 |
| 切分后的数值大小排序 | arr.sort() |
arr.sort((a, b) => a - b) |
传入明确的数值比较器,规避默认基于 UTF-16 代码单元的字典序比较。 |
在日常开发中,只要在逐字拆解时优先选用 ES6 迭代器或 Intl.Segmenter、在去重中转时坚持使用 Set、在异步批处理中善用 Promise.all,就能确保从字符串到数组的全流程保持确定且可靠的原始次序。
js字符串转数组JSON.parseUnexpectedtoken报错
2026-11-13 22:55:06
js字符串转数组空字符串返回空数组吗
2026-11-13 21:53:02
react字符串怎么转数组渲染列表map
2026-11-13 20:18:10
JS中文数组排序乱序怎么办?localeCompare()正确用法
2026-11-13 19:16:42
js字符串转数组ES2026Uint8Array.fromBase64新API
2026-11-13 14:02:44