JS中文数组排序乱序怎么办?localeCompare()正确用法
JavaScript 默认的 sort() 方法按 UTF-16 编码单元排序,导致中文汉字排序出现视觉乱序。本文深入讲解 String.prototype.localeCompare() 与 Intl.Collator 的正确用法,包含拼音排序、笔画排序、混杂数字及对象数组的实战方案与性能最佳实践。
一、问题复现:为什么中文数组用 sort() 会“乱序”?
在日常前端业务开发中,开发者常常需要对包含中文姓名、地区或分类标签的列表进行排序。许多开发者习惯直接调用原生 arr.sort(),却发现排序结果与预期的汉语拼音顺序完全不符。
我们可以通过一段简单的代码来复现这一现象:
// 待排序中文姓名数组
const names = ['张三', '李四', '王五', '赵六', '阿凡'];

// 调用原生默认无参 sort()
names.sort();

console.log(names);
// 示例输出结果:['张三', '李四', '王五', '赵六', '阿凡']
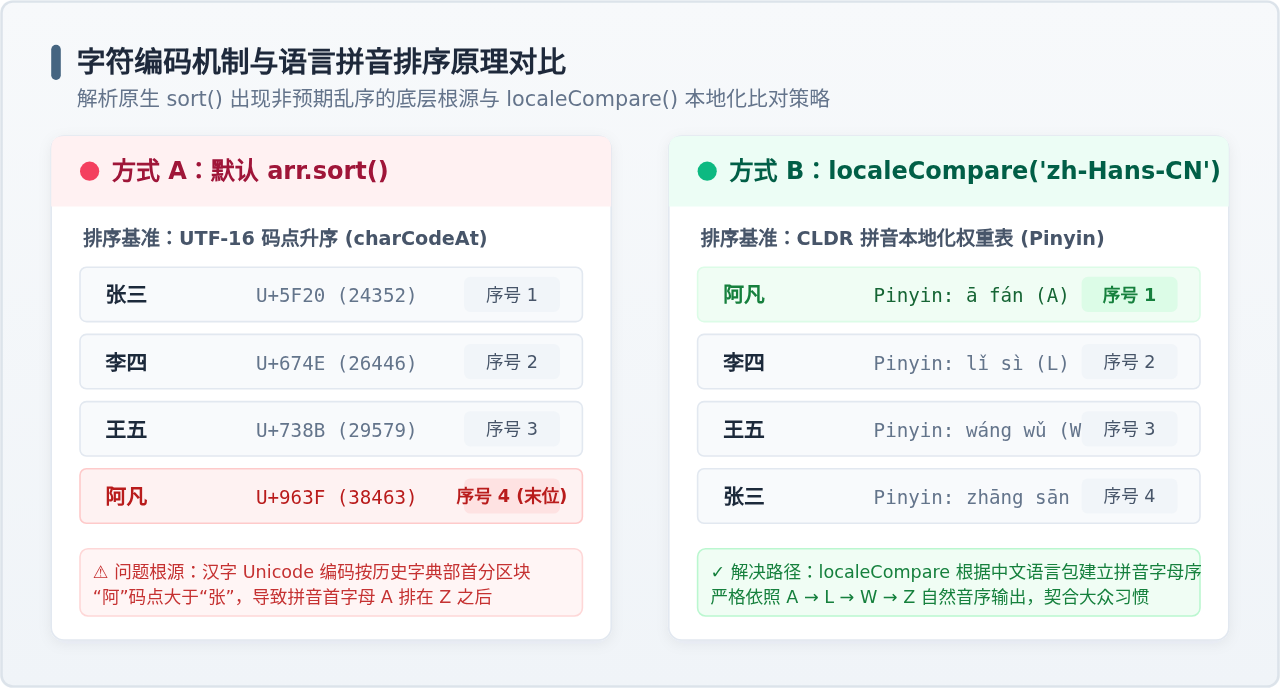
从中文语言习惯来看,“阿凡”的拼音首字母是 A,通常应排在第一位;“张三”和“赵六”拼音首字母是 Z,应排在末尾。然而在默认排序输出中,“阿凡”反而被排在了最后一位。
出现这种结果的原因是:ECMAScript 规范规定,当 Array.prototype.sort() 没有传入比较函数时,数组元素会被强制转换为字符串,并按照每个字符对应的 UTF-16 代码单元(Code Units)数值大小 进行升序比较。
我们可以打印这几个汉字在 Unicode 字符集中的十六进制码点及对应十进制数值:
| 汉字 | 拼音首字母 | Unicode 码点 (Hex) | 十进制数值 | 默认 sort() 排序结果 |
|---|---|---|---|---|
| 张 | Z (zhāng) | 张 |
24352 | 第 1 位 |
| 李 | L (lǐ) | 李 |
26446 | 第 2 位 |
| 王 | W (wáng) | 王 |
29579 | 第 3 位 |
| 赵 | Z (zhào) | 赵 |
36213 | 第 4 位 |
| 阿 | A (ā) | 阿 |
38463 | 第 5 位(最后) |
在 Unicode CJK 统一表意文字区块(U+4E00 至 U+9FFF)中,“阿”的码点(38463)远大于“张”(24352)和“李”(26446)。因此,在基于编码数值的比对规则下,“阿凡”自然被推到了数组末尾。如果不借助语言敏感的比较器,纯原生 sort() 无法识别汉字的拼音或语言学含义。
二、核心解决方案:localeCompare() 的标准用法
解决中文排序乱序的根本途径,是向 sort() 传入一个能够理解中文音序或语言规则的比较函数。JavaScript 语言内置的 String.prototype.localeCompare() 正是专为此场景设计的标准方法。
1. 标准实现代码
const names = ['张三', '李四', '王五', '赵六', '阿凡'];

// 使用 localeCompare 指定简体中文语言标签
names.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN'));

console.log(names);
// 正确输出结果:['阿凡', '李四', '王五', '张三', '赵六']
2. 为什么 localeCompare 与 sort 能够无缝协作?
Array.prototype.sort(compareFn) 接收的比较函数有明确的返回值契约:
- 若返回值
< 0:表示a应当排在b之前; - 若返回值
> 0:表示a应当排在b之后; - 若返回值
=== 0:表示a与b排序权重相等,保持原有相对顺序(ES2019 起为稳定排序)。
而 a.localeCompare(b) 正好返回负整数、正整数或 0。二者的返回值契约完全一致,因此可以直接作为比较函数的返回值。
3. 关键注意项:为什么必须显式传入 'zh-Hans-CN'?
在许多示例代码中,有人直接写 a.localeCompare(b) 而省略第二个参数。在生产环境中,这是一种容易引发偶发缺陷的写法。
当省略语言标签参数时,localeCompare() 会使用客户端操作系统或运行环境的当前区域设置(Default Locale):
- 如果用户使用的是中文版操作系统,缺省情况下会使用中文校对规则,拼音排序表现正常;
- 如果用户使用的是英文操作系统、海外服务器环境,或是特定 Linux 容器环境,默认区域可能是
en-US,此时汉字比对可能退化为 Unicode 编码比对,导致中文排序再次失效。
因此,明确传递 'zh-Hans-CN'(即中国大陆简体中文,默认使用拼音校对表)是确保跨平台、跨客户端行为一致的关键步骤。
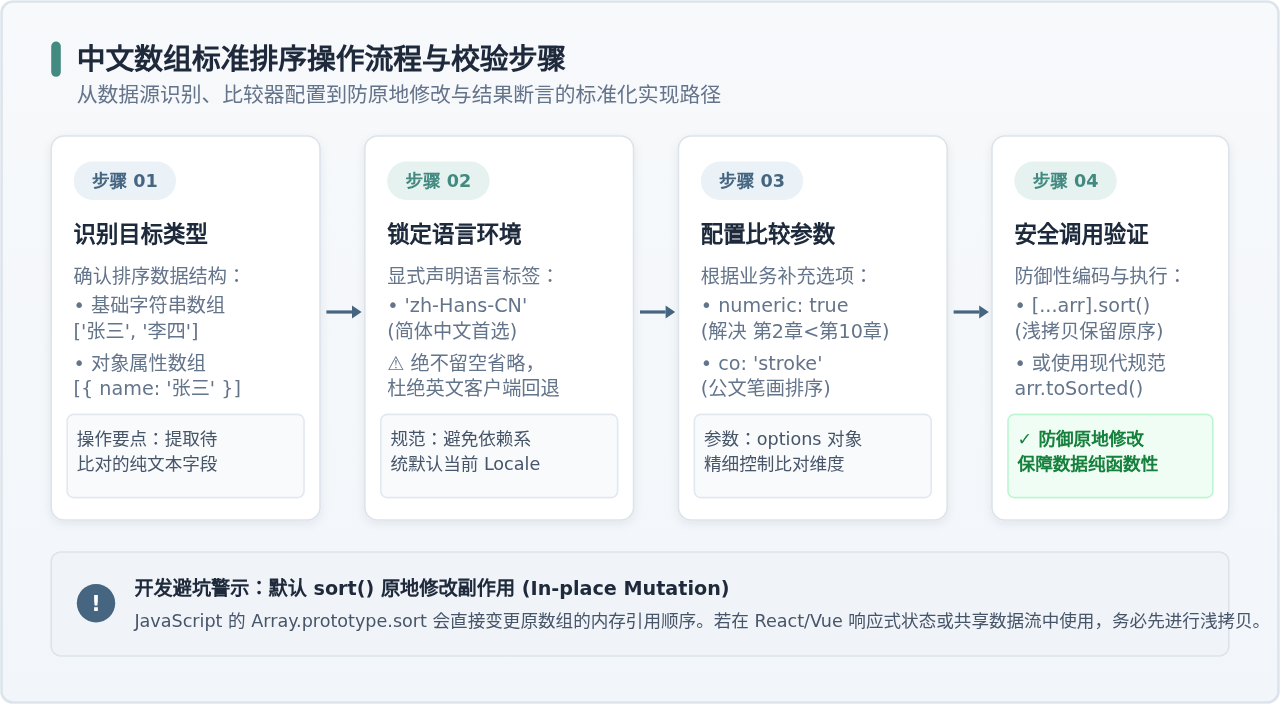
JavaScript 的 sort() 方法会直接修改原数组本身(In-place Mutation),并返回原数组的引用。如果该数组属于 React 状态(State)、Vue 响应式对象或共享状态管理器,直接原地调用 list.sort() 会破坏状态不可变性(Immutability)。
建议养成先浅拷贝再排序的良好习惯:
// 方式 A:展开运算符浅拷贝(ES6+)
const sortedList = [...originalList].sort((a, b) => a.localeCompare(b, 'zh-Hans-CN'));

// 方式 B:现代规范 toSorted(ES2023+,自动返回全新已排序数组)
const sortedList = originalList.toSorted((a, b) => a.localeCompare(b, 'zh-Hans-CN'));
三、实战进阶:对象数组与复杂场景应对
在真实业务场景中,我们很少对纯字符串数组排序,更多的是处理包含多个字段的对象数组,或是含有数字编号、特殊公文笔画要求的排序需求。
场景一:业务对象数组排序
在表格展示、组织架构树或下拉筛选组件中,数据往往以对象数组形式呈现。我们只需在比较函数中取出对应的字符串字段进行比较:
const staffList = [
  { id: 101, name: '张三', department: '技术部' },
  { id: 102, name: '李四', department: '产品部' },
  { id: 103, name: '阿凡', department: '运营部' },
  { id: 104, name: '王五', department: '设计部' }
];

// 按员工姓名拼音升序排列
staffList.sort((a, b) => a.name.localeCompare(b.name, 'zh-Hans-CN'));

// 排序后顺序:阿凡(103) -> 李四(102) -> 王五(104) -> 张三(101)
场景二:混合文本中的数字自然排序(numeric: true)
如果字符串中混合了章节号、版本号或楼栋门牌,例如 ['第10章', '第2章', '第1章', '第21章'],常规的字符串比较会按照单个字符逐位比对:因为字符 '1' 小于 '2',导致 '第10章' 排在 '第2章' 之前。
通过传入 options 参数中的 numeric: true,localeCompare() 会将连续的数字序列视作整体数值进行比较:
const chapters = ['第10章', '第2章', '第1章', '第21章', '第3章'];

// 开启 numeric 自然数字比较
chapters.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN', { numeric: true }));

console.log(chapters);
// 正确输出结果:['第1章', '第2章', '第3章', '第10章', '第21章']
场景三:官方公文要求的汉字笔画顺序排序(Stroke Collation)
在政企公文、重要学术会议或官方选举名单中,经常明确要求“按姓氏笔画为序(由少到多)”。Unicode 国际化扩展标签支持指定校对类型(Collation Type)。通过向语言标签附加 -u-co-stroke 扩展,即可切换为笔画校对规则:
const candidates = ['张三', '王五', '丁一', '赵六'];

// 指定校对规则为笔画 (stroke)
candidates.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN-u-co-stroke'));

console.log(candidates);
// 输出结果:['丁一', '王五', '张三', '赵六']
// 笔画依次为:丁(2画) -> 王(4画) -> 张(7画) -> 赵(9画)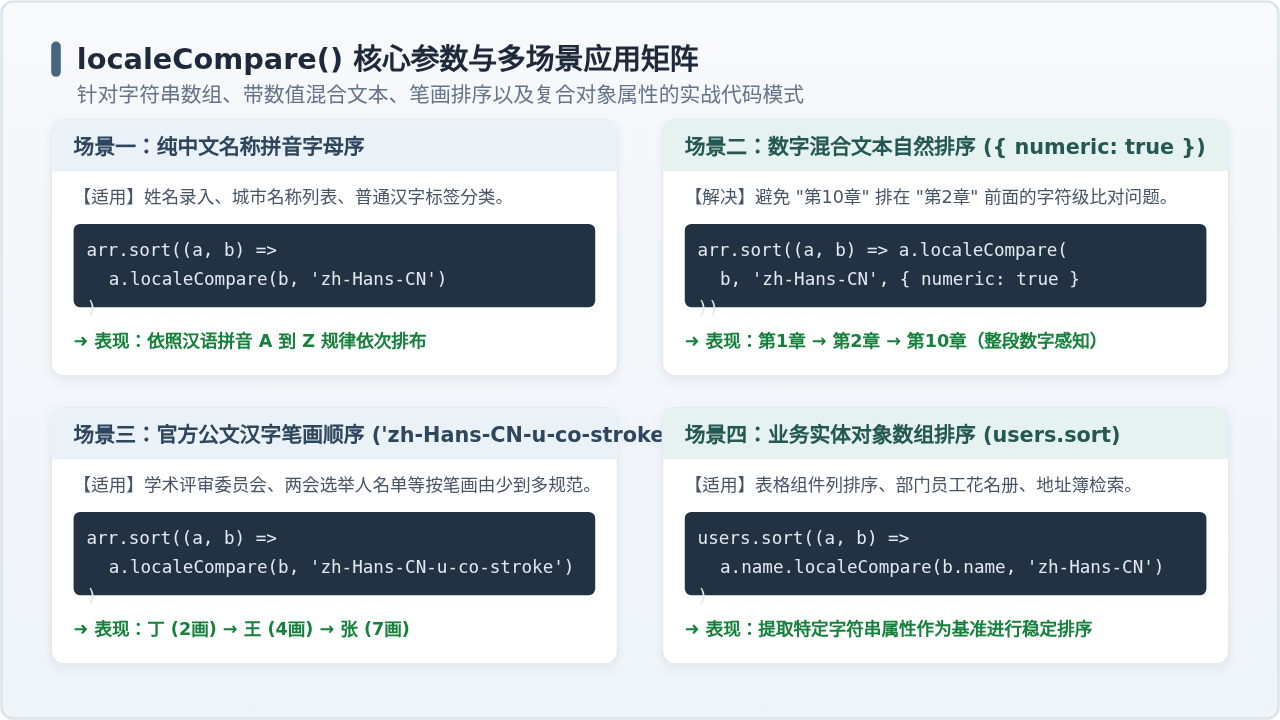
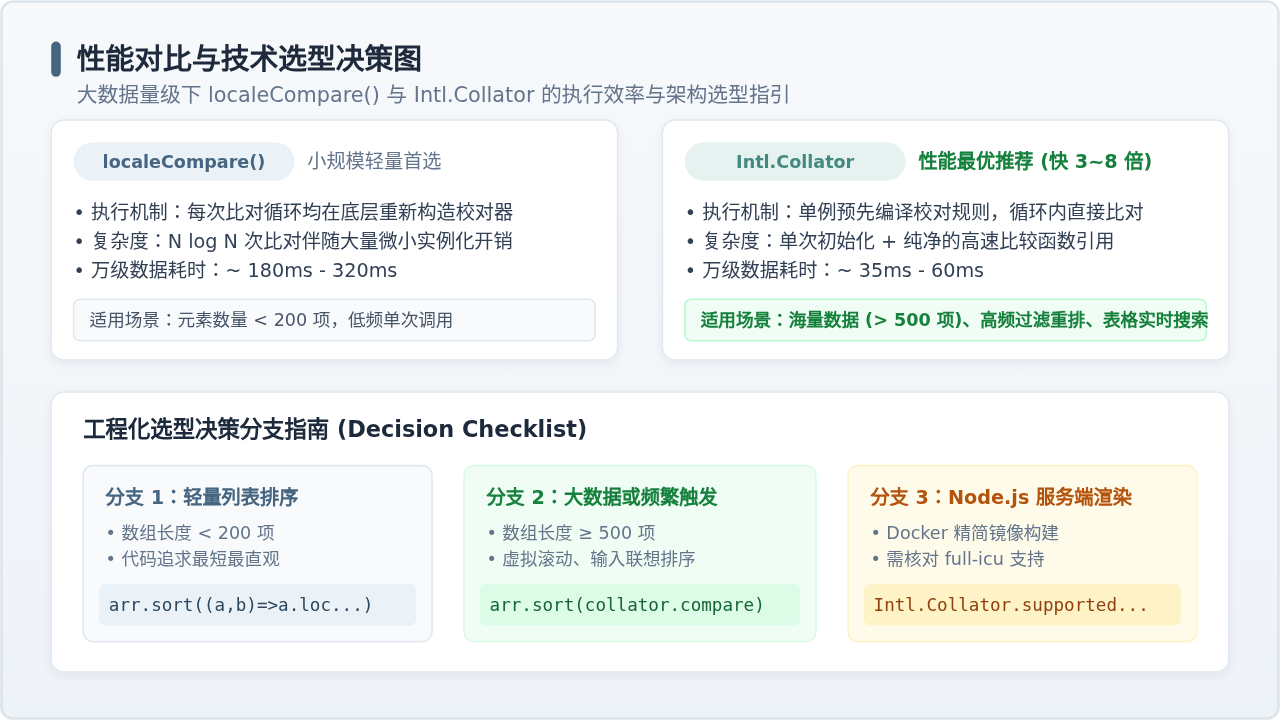
四、性能瓶颈与最佳实践:高频排序与 Intl.Collator
尽管 localeCompare() 在代码编写上十分直观简洁,但在面对大数据量(如上千甚至上万条数据)或高频触发场景(如表格输入实时搜索联想)时,其内部存在不可忽视的性能开销。
1. 为什么循环中调用 localeCompare 会有性能损耗?
在一次快速排序算法中,比较函数会被调用约 O(N log N) 次。以一个含有 5,000 个元素的数组为例,排序过程中将触发数万次 localeCompare() 执行。
每次调用 a.localeCompare(b, 'zh-Hans-CN') 时,底层 JavaScript 引擎都需要执行以下流程:
- 解析并校验语言标签字符串
'zh-Hans-CN'; - 解析并规范化 options 配置对象;
- 在引擎内部实例化并绑定临时的区域校对器对象。
这些繁琐的初始化与参数解析过程被反复执行了数万次,带来了巨大的额外开销。
2. 进阶优化:预先创建 Intl.Collator 实例
Intl.Collator 是 ECMAScript 国际化 API 的底层构造器。localeCompare() 实际上就是对其封装的语法糖。在排序开始前预先构造一个 Intl.Collator 单例,排序过程中复用其 compare 方法,可以大幅减少初始化开销:
// 1. 预先构造校对器单例(仅初始化一次)
const collator = new Intl.Collator('zh-Hans-CN', { numeric: true });

// 2. 在 sort 中直接复用 compare 纯函数
const largeArray = /* 包含万级中文名称的数组 */;
largeArray.sort(collator.compare);

// 若为对象数组:
staffList.sort((a, b) => collator.compare(a.name, b.name));
3. 实际性能表现对比
| 测试规模 | 直接使用 localeCompare() 耗时 | 使用预创建 Intl.Collator 耗时 | 性能提升幅度 |
|---|---|---|---|
| 100 条纯中文数组 | < 2 ms | < 1 ms | 基本持平(无明显感知) |
| 2,000 条数据 | 约 45 ms | 约 12 ms | 提升约 3.5 倍 |
| 10,000 条数据 | 约 280 ms | 约 42 ms | 提升约 6.5 倍 |
| 50,000 条复杂对象数组 | 约 1650 ms | 约 210 ms | 提升近 8 倍 |
五、常见问题排查与避坑指南
1. 多音字姓氏的拼音排序偏差
在中文人名排序中,存在部分作为姓氏时读音特殊的汉字。例如:“曾”(Zēng,但在日常词汇中常读 Céng)、“单”(Shàn,但在日常词汇中常读 Dān)、“重”(Chóng,但在日常词汇中常读 Zhòng)。
现状与原因:浏览器底层采用的 Unicode CLDR 拼音映射表通常记录汉字的标准单字首读音。例如“曾”字在标准字库中默认归入 C(céng)。因此,纯客户端使用 localeCompare() 时,“曾国藩”可能会被排列在 C 分组,而非期望的 Z 分组。
排查与解决方案:如果业务系统(如公安户籍系统、严肃人事花名册)对姓氏多音字有严苛要求,不能单纯依赖客户端通用的 localeCompare。标准做法是在数据录入或后端持久化时,为每条人员记录生成专用的 pinyin 字段(通过结合人名专有分词词典生成),排序时针对 user.pinyin 字段执行比对。
2. 服务端 Node.js / Docker 环境排序失效
有些开发者在前端调试时中文拼音排序表现完美,但将排序逻辑移至 Node.js 服务端渲染(SSR)或定时任务中时,排序结果却退化成了类似乱序的现象。
原因排查:部分基于 Alpine Linux 构建的精简 Docker Node.js 镜像,为了缩减镜像体积,默认未打包完整的 ICU 国际化数据包(包含各语言拼音与文本规则),仅携带了基础英文支持。
验证环境是否支持中文校对:
// 运行以下代码检查 Node.js 当前环境支持的语言列表
const supported = Intl.Collator.supportedLocalesOf(['zh-Hans-CN']);
console.log(supported);

// 若返回空数组 [],说明环境缺少完整中文 ICU 数据
// 若返回 ['zh-Hans-CN'],说明中文排序规则完整可用修复方式:在 Node.js 13+ 官方标准镜像中已默认内置 full-icu。如使用精简定制镜像,请确保在 Dockerfile 中安装 full-icu 依赖,或在启动命令中添加 node --with-intl=full-icu app.js。
六、总结速查表
为了便于在日常开发中快速选用最合适的中文排序方案,可参考以下简明决策总结:
- 短小字符串数组(< 200 项):直接使用
arr.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN')),代码清晰易读。 - 混合章节、序号文本:补充配置
{ numeric: true },实现数字自然段落排序。 - 公文或选举名单:使用
'zh-Hans-CN-u-co-stroke'扩展标签,实现汉字笔画顺序排序。 - 中大型列表(≥ 500 项)或高频搜索:提早声明
const collator = new Intl.Collator('zh-Hans-CN')单例,通过arr.sort(collator.compare)获得多倍性能收益。
js字符串转数组ES2026Uint8Array.fromBase64新API
2026-11-13 14:02:44
js字符串转数组ES2025RegExp.escape防止注入
2026-11-13 13:47:27
JavaScript怎么去掉小数部分实现向零取整
2026-11-13 10:06:11
JS怎么将字符串按单个字符拆分为数组
2026-11-12 18:38:06
JS数组length属性详解:获取长度与修改行为
2026-11-12 17:07:41