JS怎么将字符串按单个字符拆分为数组
全面讲解在 JavaScript 中将字符串按单个字符拆分为数组的四种实用方法:split('')、扩展运算符 [...str]、Array.from() 与 Intl.Segmenter。深入分析 UTF-16 编码单元、Unicode 代理对与复合 Emoji 字形簇的底层机制,提供清晰的选型决策与避坑指南。
str.split('')、ES6 语法糖扩展运算符 [...str]、标准工厂方法 Array.from(str),以及现代国际化 API Intl.Segmenter。如果待处理文本仅包含基础英文字母与常规汉字,split('') 执行速度最快;但若涉及 Emoji 表情或生僻字,使用 [...str] 或 Array.from(str) 可以避免字符被腰斩为乱码;而面对组合 Emoji(如肤色修饰符、职业组合等),则必须借助 Intl.Segmenter 实现完整的字形簇识别。
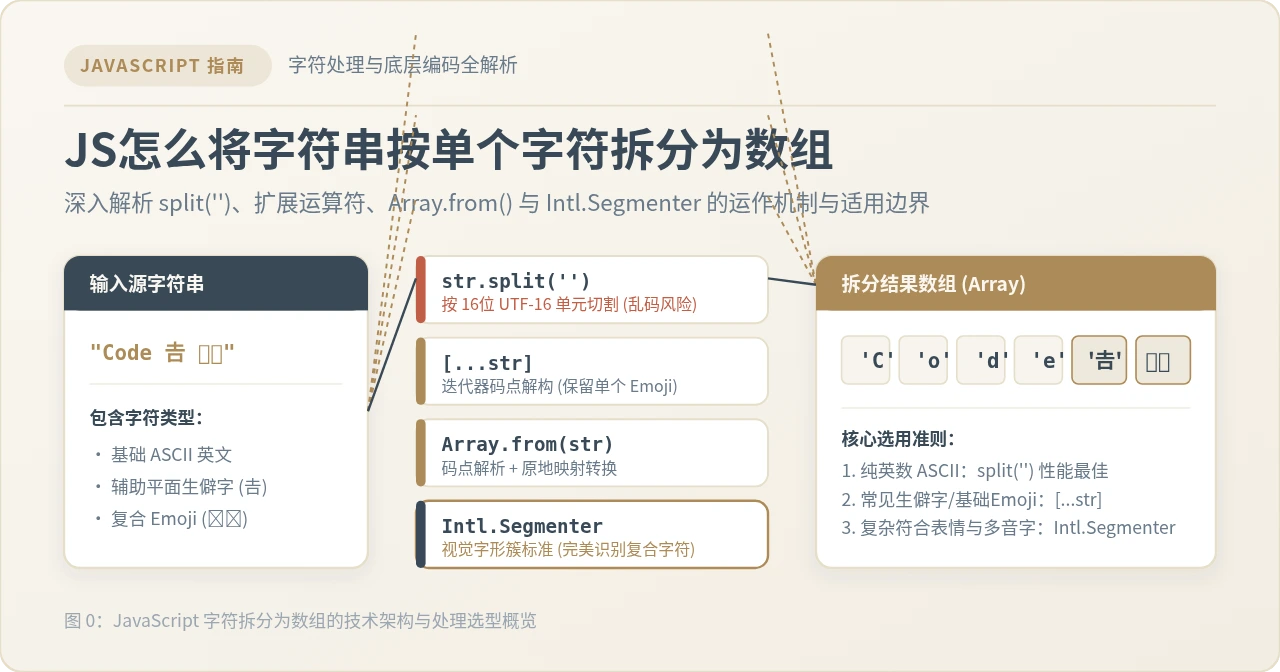
图 0:JavaScript 字符拆解技术全景与方法概览
一、基础方案:使用 split('') 快速分割
String.prototype.split() 是 JavaScript 中历史最悠久、使用最广泛的字符串切分方法。当传入空字符串 "" 作为分隔参数时,引擎会将输入文本按字符位置逐一切片,并组装成一个全新的数组。
1. 基本语法与代码示例
// 基础英文字符串拆分
const word = "JavaScript";
const chars = word.split("");
console.log(chars);
// 示例输出: ['J', 'a', 'v', 'a', 'S', 'c', 'r', 'i', 'p', 't']

// 包含常规汉字的字符串拆分
const greeting = "你好世界";
const chineseChars = greeting.split("");
console.log(chineseChars);
// 示例输出: ['你', '好', '世', '界']
2. 运行机制与优势
split('') 直接在底层 C++ 层面依据 16 位 UTF-16 编码单元执行内存扫描与截取,中间不经过复杂的迭代器调用,因此在处理大规模纯 ASCII 文本(如日志解析、序列号提取)时,具有极高的吞吐性能,且能够向下兼容所有老旧版本的浏览器和运行时。
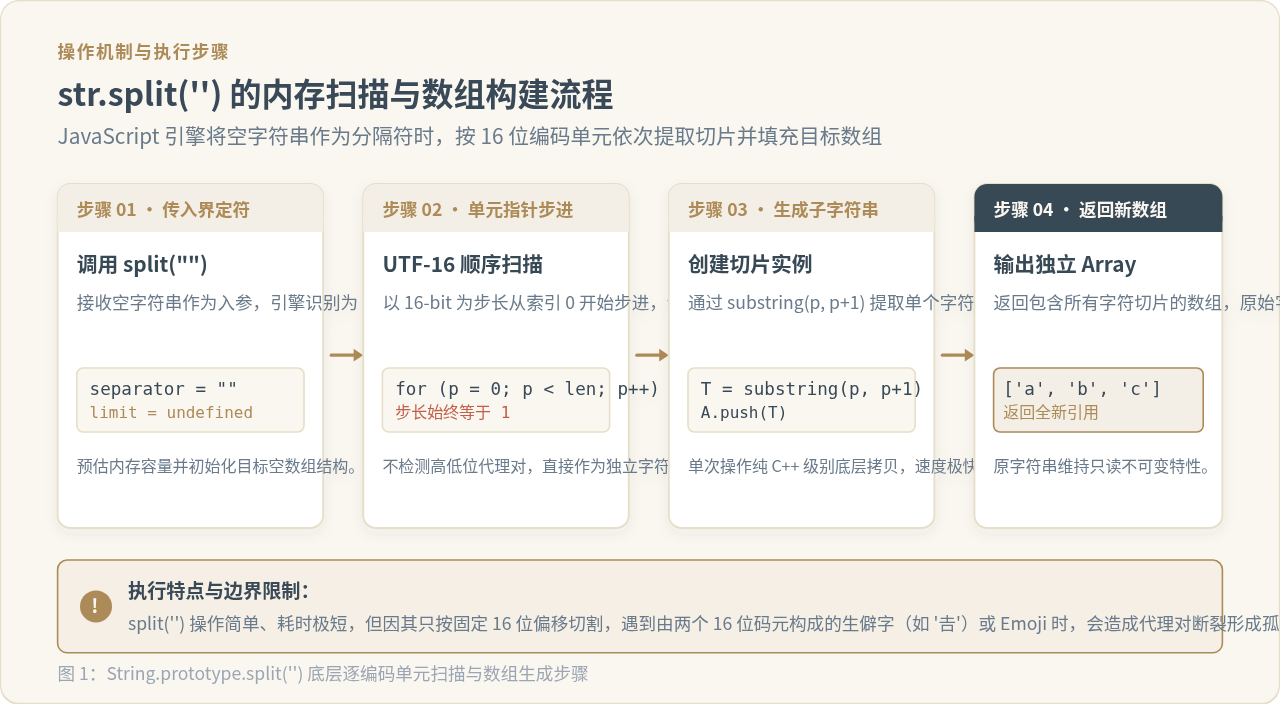
图 1:String.prototype.split('') 内存切分与数组构建四步流程
二、Unicode 陷阱:为什么 split('') 会拆坏 Emoji 与生僻字
很多开发者在日常业务中发现,使用 split('') 处理用户输入的昵称、留言时,偶尔会出现“乱码”或字符数量不匹配的问题。其根本原因在于 JavaScript 的字符串底层编码规范。
1. UTF-16 编码单元与代理对(Surrogate Pair)
JavaScript 诞生于 Unicode 仅有 65,536 个码位(基本多语言平面 BMP)的时代,因此内部采用 16 位(2 字节)的 UTF-16 编码单元来存储字符。然而,随着 Unicode 的扩充,成千上万的生僻字(如“𠮷”)以及数千个 Emoji 表情被分配到了辅助平面(SMP)。
为了用 16 位单元表示这些超出范围的字符,UTF-16 采用了“代理对”机制:即使用一个高位代理单元(0xD800 - 0xDBFF)加上一个低位代理单元(0xDC00 - 0xDFFF),总共 4 个字节来表示一个完整的字符。
2. 错误表现示例
// 示例 1: 辅助平面生僻字 "𠮷"(吉的异体字)
const rareWord = "𠮷";
console.log(rareWord.length);
// 示例输出: 2 (由于占两个 16位单元,length 返回 2)

const splitRare = rareWord.split("");
console.log(splitRare);
// 示例输出: ['\uD842', '\uDFB7']
// 代理对被机械切开,得到两个单独的孤立代理项,在控制台显示为乱码或菱形问号

// 示例 2: 单个基础 Emoji "😊"
const smiley = "😊";
console.log(smiley.split(""));
// 示例输出: ['\uD83D', '\uDE0A'] (同样被拆裂成了两个非法片段)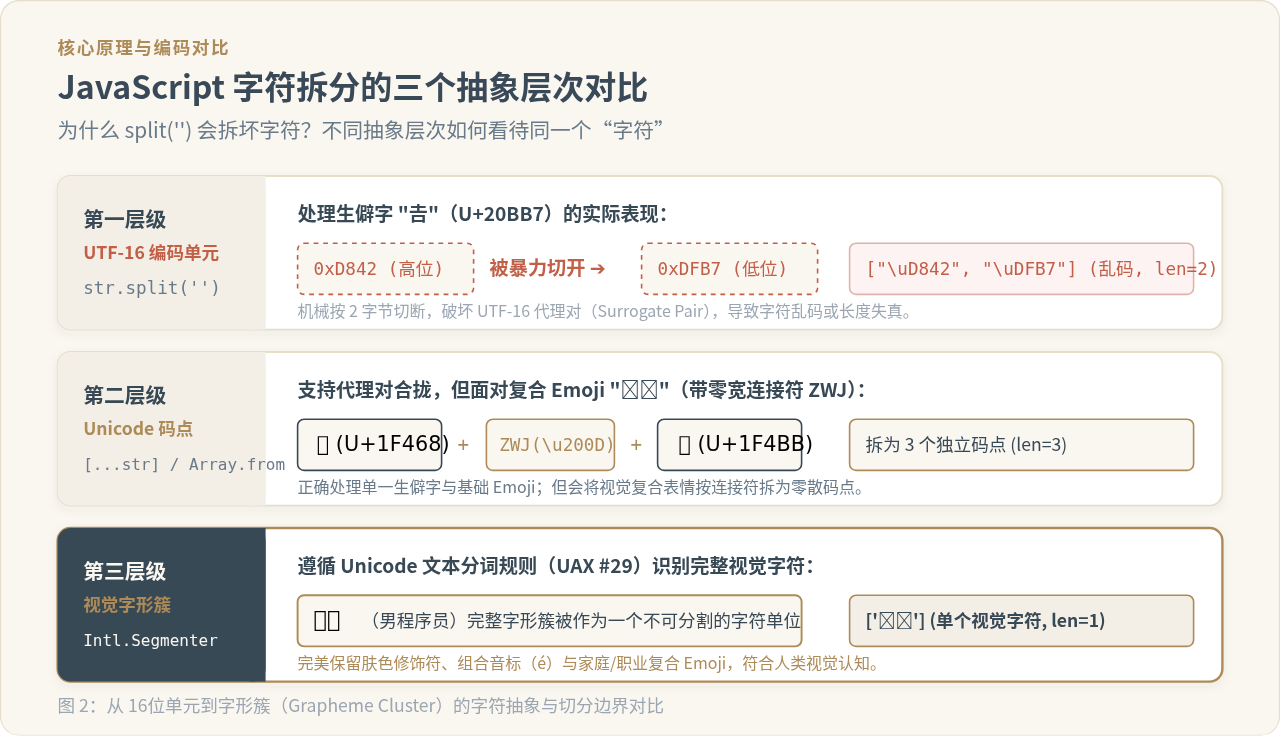
图 2:底层 UTF-16 编码单元、规范 Unicode 码点与视觉字形簇的切分原理对比
三、现代规范推荐:扩展运算符 [...str] 与 Array.from()
从 ECMAScript 2015 (ES6) 开始,JavaScript 为字符串添加了默认的迭代器实现(String.prototype[Symbol.iterator])。该迭代器是以 Unicode 码点(Code Point) 为最小遍历粒度的,能够自动识别并合并代理对。
1. 扩展运算符语法糖 [...str]
扩展运算符是日常书写最为简明的方式,语义清晰且无需调用冗长的方法名:
const text = "Hi 𠮷 😊!";
const charArray = [...text];
console.log(charArray);
// 示例输出: ['H', 'i', ' ', '𠮷', ' ', '😊', '!']
console.log(charArray.length);
// 示例输出: 7 (生僻字 '𠮷' 与表情 '😊' 各自完整占据 1 个数组元素)
2. 标准方法 Array.from() 与边拆边转换
Array.from(str) 同样使用字符串内置的码点迭代器。不仅如此,它还支持传入第二个参数 mapFn,允许在将字符拆入数组的同时执行映射操作,避免先拆出数组再调用 .map() 所带来的二次遍历开销。
// 场景 1: 直接拆分
const chars = Array.from("Hello 𠮷");
console.log(chars);
// 示例输出: ['H', 'e', 'l', 'l', 'o', ' ', '𠮷']

// 场景 2: 拆分并原地映射(例如将数字字符串拆解为真正的数字数组)
const numStr = "9527";
const numList = Array.from(numStr, char => Number(char));
console.log(numList);
// 示例输出: [9, 5, 2, 7]

// 场景 3: 提取字符并获取对应的 Unicode 十六进制码点
const codePoints = Array.from("ABC𠮷", char => char.codePointAt(0).toString(16).toUpperCase());
console.log(codePoints);
// 示例输出: ['41', '42', '43', '20BB7']
图 3:ES6 字符串迭代器协议与 Array.from 映射执行管线机制
四、高阶场景:使用 Intl.Segmenter 处理复合 Emoji 与字形簇
扩展运算符与 Array.from() 虽然解决了单个生僻字与单 Emoji 的拆分问题,但在现代复杂的富文本场景中,仍然存在盲区——字形簇(Grapheme Cluster)。
1. 为什么扩展运算符仍会拆开某些 Emoji?
在 Unicode 规范中,许多视觉上的单一 Emoji 实际上是由多个 Unicode 码点组合而成的:
- 零宽连接符组合(ZWJ Sequence):如程序员表情
👨💻,由“男人(U+1F468)” + “零宽连接符(U+200D)” + “电脑(U+1F4BB)”三个独立码点组合而成; - 肤色修饰符(Fitzpatrick Modifiers):如点赞手势
👍🏽,由“基础手势(U+1F44D)” + “中等肤色修饰符(U+1F3FD)”构成; - 发音连字(Combining Diacritical Marks):如带重音的字母
é,由基础字母e与变音记号\u0301叠加构成。
const coder = "👨💻";
console.log([...coder]);
// 示例输出: ['👨', '', '💻']
// 尽管没报乱码,但原本一个视觉表情被拆成了 3 项,破坏了用户视觉字符的完整性!2. 终极解决方案:Intl.Segmenter
ECMAScript 2022 正式引入了 Intl.Segmenter 国际化分词接口。只要将粒度参数设置为 granularity: 'grapheme'(字形簇),引擎就会按照国际标准(Unicode UAX #29)精准识别用户眼中的“单字”:
// 创建字形簇分词器
const segmenter = new Intl.Segmenter("zh-Hans", { granularity: "grapheme" });
const richText = "Hi! 👨💻 👨👩👧 👍🏽 é";
// 拆分为数组
const graphemes = Array.from(segmenter.segment(richText), item => item.segment);
console.log(graphemes);
// 示例输出: ['H', 'i', '!', ' ', '👨💻', ' ', '👨👩👧', ' ', '👍🏽', ' ', 'é']Intl.Segmenter 目前已获得主流运行环境的全面支持(Chrome 87+、Edge 87+、Safari 14.1+、Firefox 125+ 以及 Node.js 16+)。在开发面向用户的字符计数器、富文本编辑器截断、文字跑马灯动画等业务时,强烈建议优先使用该方案。
五、综合选型与技术决策指南
不同的拆分方式在执行性能、字符安全度、复杂度和运行环境要求上存在显著差异。在实际项目中,应根据业务输入的数据特征做出理性选择:
| 拆分方法 | 支持层级 | 单 Emoji / 生僻字 | 复合 Emoji / 音标 | 执行性能 | 推荐使用场景 |
|---|---|---|---|---|---|
str.split('') |
16位 UTF-16 单元 | 不支持(拆为乱码) | 不支持 | 极快(原生 C++) | 纯 ASCII、数字串、基础固定长度代码 |
[...str] |
Unicode 码点 | 支持完整保留 | 拆为多个码点组件 | 快(内置迭代器) | 日常前端业务、通用字符倒序、通用校验 |
Array.from(str) |
Unicode 码点 | 支持完整保留 | 拆为多个码点组件 | 快(支持单趟映射) | 字符串拆分同时需要逐项处理或格式化 |
Intl.Segmenter |
视觉字形簇 (Grapheme) | 完美支持 | 完美支持 | 适中(规则引擎解析) | 富文本输入框限长、复杂多语言 UI、社交发帖字数统计 |
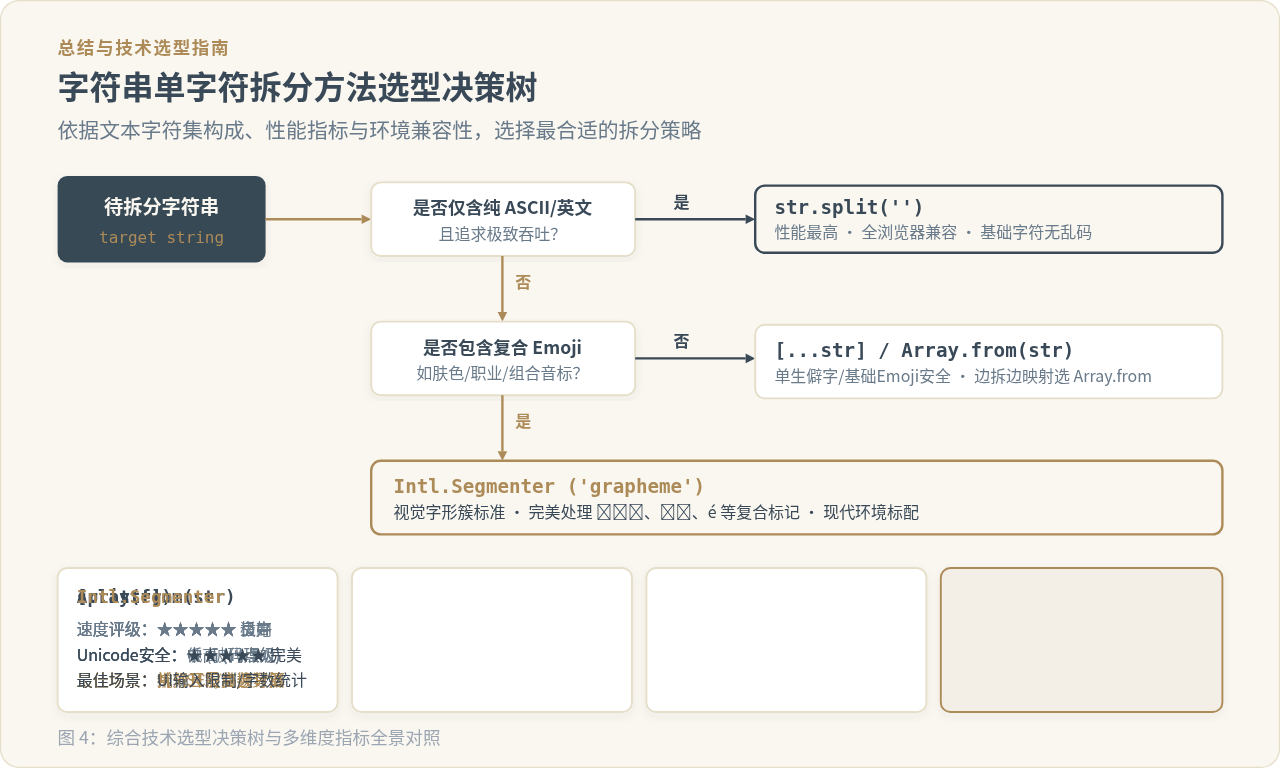
图 4:字符串单字符拆分方法选型决策树与多维度指标全景对照
六、防御性编程与常见避坑点
-
空字符串处理:
无论是
"".split("")、[...""]还是Array.from(""),当入参为空字符串时,均安全返回空数组[],不会产生运行时异常。 -
非字符串类型防护:
split('')是挂载在 String 原型链上的方法,若对null或undefined直接调用会触发TypeError;而[...value]和Array.from(value)面对非可迭代对象(如数字或普通对象)时,前者会抛错,后者则返回空数组。因此,在不确定数据源类型时,建议提前进行类型兜底,例如String(val || '')。 -
慎用正则
/./g拆分: 由于正则表达式默认的.无法匹配换行符以及超出 BMP 平面的代理对字符(除非显式开启u或s修饰符),使用正则提取字符不仅开销大而且极易漏网,通常不推荐作为首选方案。
JS数组length属性详解:获取长度与修改行为
2026-11-12 17:07:41
JavaScript中用JSON.parse将字符串转为JSON对象
2026-11-12 12:18:49
useState直接改数组为什么页面不重新渲染?
2026-11-12 12:06:03
JavaScript怎么自定义美化确认框替代原生confirm
2026-11-12 11:28:23
怎么使用JavaScript数组方法实现数据去重和扁平化?
2026-11-12 09:46:39