JS字符串转16进制:基础ASCII字符转换实现
深入讲解JavaScript中基础ASCII字符串与十六进制之间的正反向转换实现,解析charCodeAt、toString(16)与padStart(2, '0')的底层原理、定长补齐必要性、逆向解码步骤及边界限制。
在 JavaScript 中,将基础 ASCII 字符串转换为十六进制的核心在于三步:通过 charCodeAt() 获取每个字符对应的数值编码,使用 toString(16) 将该数值转为十六进制字符,再借助 padStart(2, '0') 强制补足两位定长字节。本文将具体拆解这一正向转换流水线与反向解码实现,剖析前导零对齐的必要性及 ASCII 适用边界。
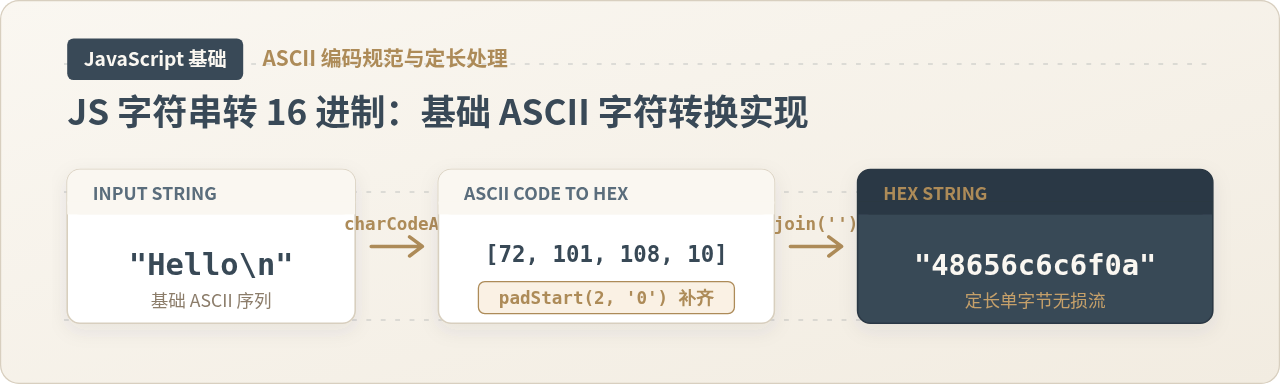
一、基础原理:字符、ASCII 码与十六进制映射
ASCII(American Standard Code for Information Interchange)标准定义了 128 个基本字符(数值范围为 0 到 127),涵盖英文大小写字母、阿拉伯数字、标点符号以及换行符、回车符等控制字符。在底层计算机存储中,每个基础 ASCII 字符正好可以用 1 个字节(8 位,即 1 Byte)容纳。
由于 1 个字节包含 8 个二进制位,其取值范围在十六进制下正好是 0x00 到 0xFF,也就是严格对应的 2 位十六进制数。在 JavaScript 中,完成字符到十六进制的转换主要依赖原生 String 和 Number 对象的两个内置方法:
String.prototype.charCodeAt(index):返回指定索引位置字符的 UTF-16 代码单元整数。对于基础 ASCII 字符,其返回值严格处于0至127之间。Number.prototype.toString(radix):接受一个基数参数(2 至 36)。当传入16时,数值将被格式化为小写的十六进制字符串。
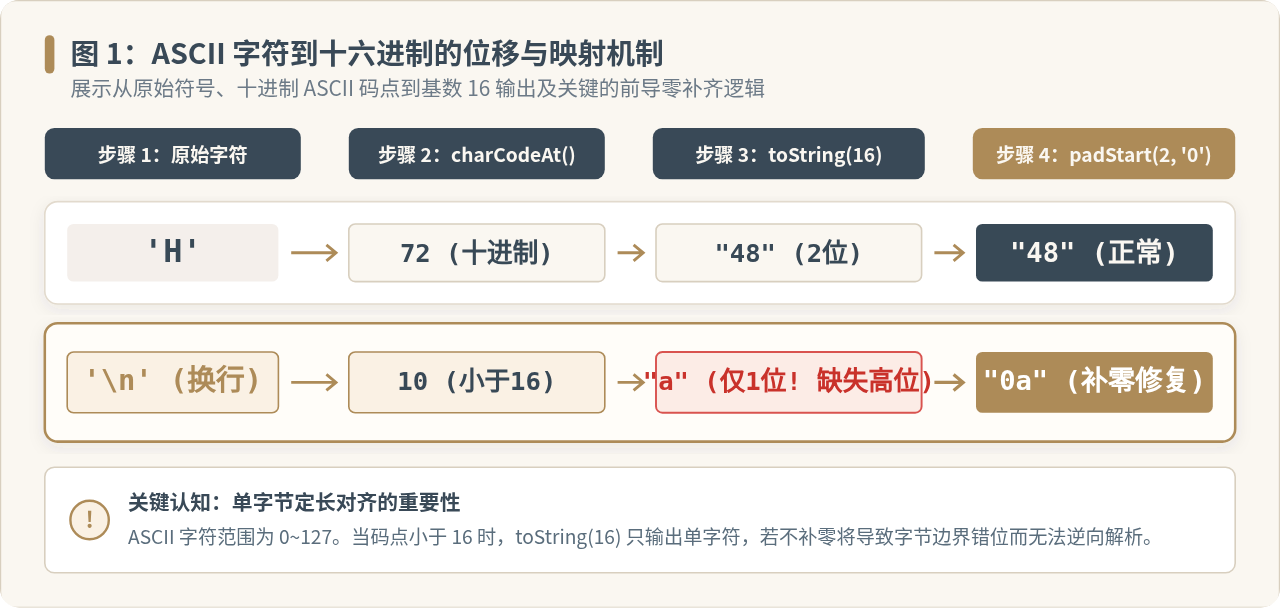
观察图 1 可以发现,对于大写字母 'H',其十进制 ASCII 码为 72,调用 (72).toString(16) 得到字符串 "48"。然而,当处理诸如换行符 '
'(ASCII 码为 10)等低位控制字符时,(10).toString(16) 仅仅返回单字符 "a"。这一位数的缺失正是后续数据乱序的根源。
二、关键实现:正向转换流水线与双位补零
在十六进制数据通信或格式存储中,数据的基本解析单元是“字节”。若不对转换结果做定长规范,单字符与双字符交错拼接在一起,会导致整个十六进制串失去明确的字节边界。
当 ASCII 码小于 16 时(范围 0 到 15),toString(16) 默认不包含高位的前导零。例如:字符 '
'(码点 10)输出 "a",字符 'A'(码点 65)输出 "41"。
如果直接拼接两者,得到的是 "a41"(长度为 3)。在逆向还原时,解码器无法获知究竟是 0x0a + 0x41 还是 0xa4 + 0x01,字节边界彻底坍缩。因此,必须通过 padStart(2, '0') 保证每一个单字节都输出为标准的 2 位十六进制符号。
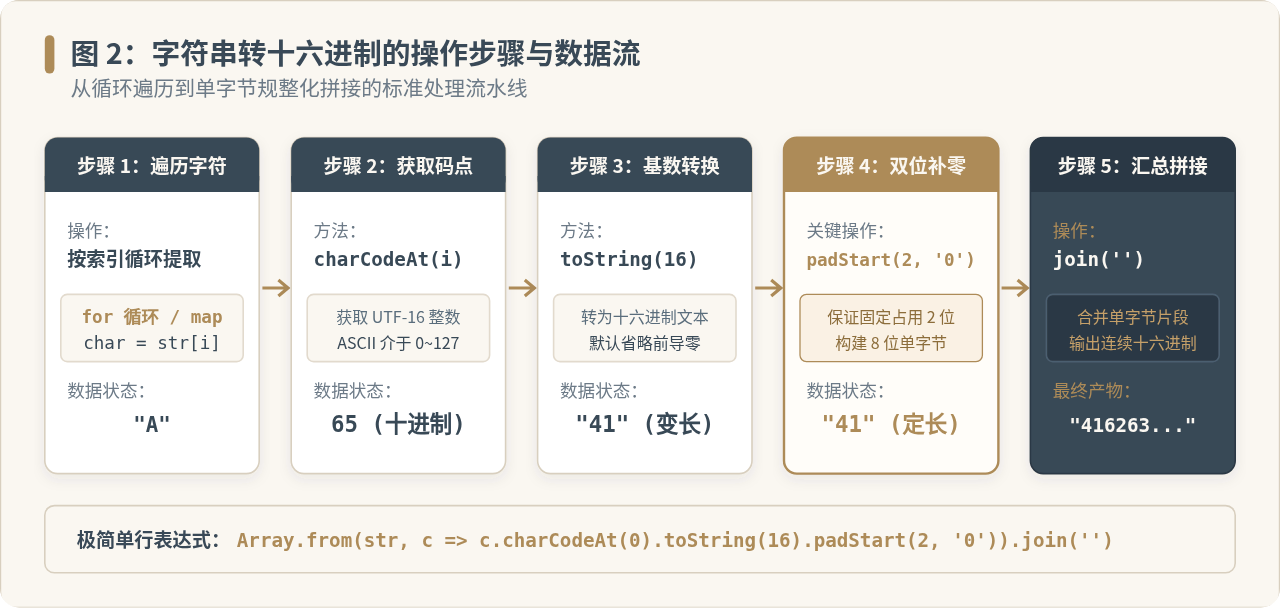
完整正向转换代码实现
下面是一个经过完整定长规整化的高可用正向转换函数,支持自定义分隔符(如需要调试排查时输出空格分隔形式):
/**
 * 将基础 ASCII 字符串转换为十六进制字符串
 * @param {string} str - 待转换的输入字符串
 * @param {string} [separator=''] - 字节间可选分隔符,默认为空
 * @returns {string} 十六进制字符串
 */
function asciiToHex(str, separator = '') {
  if (typeof str !== 'string') {
    throw new TypeError('输入参数必须为字符串');
  }

  const hexChunks = [];
  for (let i = 0; i < str.length; i++) {
    const code = str.charCodeAt(i);

    // 校验 ASCII 范围约束 (0 ~ 127)
    if (code > 127) {
      throw new RangeError(
        `字符 "${str[i]}" (码点: ${code}) 超出基础 ASCII 范围 (0~127),请使用 UTF-8 编码器`
      );
    }

    // 转换为十六进制并强制补齐为 2 位
    const byteHex = code.toString(16).padStart(2, '0');
    hexChunks.push(byteHex);
  }

  return hexChunks.join(separator);
}

// 运行示例与结果验证
const sample = "Hello
World!";
const hexResult = asciiToHex(sample);
const hexWithSpaces = asciiToHex(sample, ' ');

// 示例输出:
// hexResult:    "48656c6c6f0a576f726c6421"
// hexWithSpaces:"48 65 6c 6c 6f 0a 57 6f 72 6c 64 21"
// 注意中间换行符已被准确补齐为 "0a",而非单字符 "a"
如果追求简洁语法,现代 JavaScript 也可以直接使用数组迭代简写:
const quickAsciiToHex = str =>
  Array.from(str, c => c.charCodeAt(0).toString(16).padStart(2, '0')).join('');
三、逆向实现:十六进制还原为 ASCII 字符串
逆向解码是验证十六进制编码完整性的必要闭环。其处理过程是正向逻辑的完全对称:以 2 个字符为固定步长切片提取单字节,利用 parseInt(chunk, 16) 将十六进制转回十进制整数码点,最后通过 String.fromCharCode() 将码点重新实例化为字符。
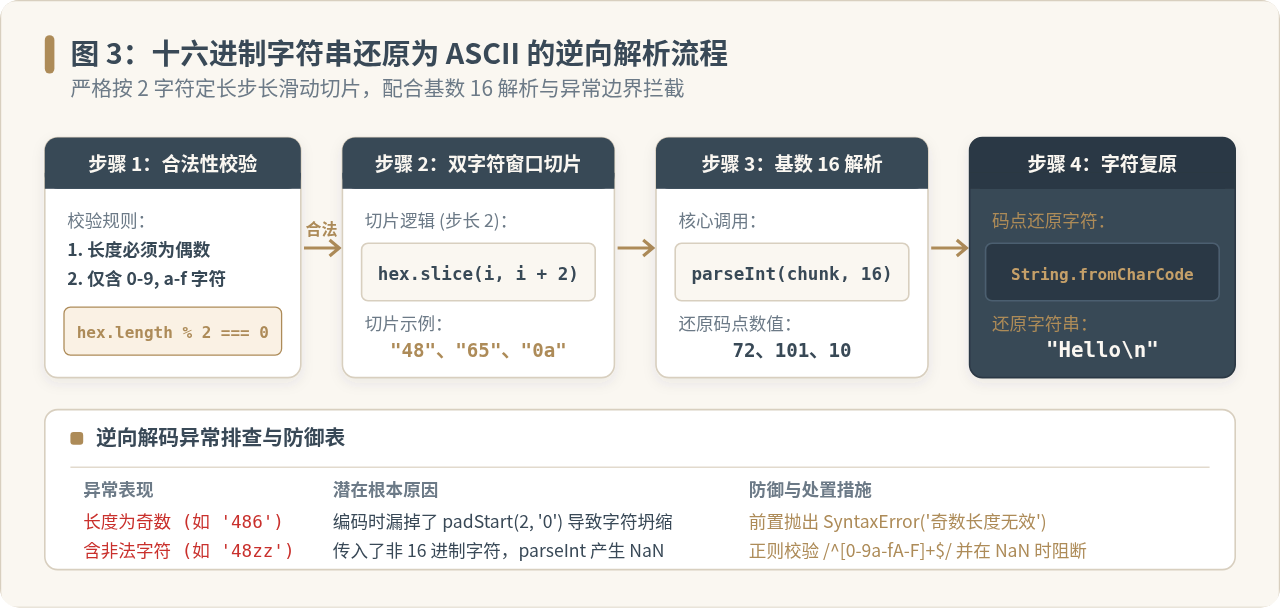
逆向解析核心步骤与防御
- 格式净化与奇数长度防御:若输入的十六进制字符串中带有空格或分隔符,先用正则剔除。无分隔符的标准十六进制字符串长度必须为偶数(每个字节占 2 个十六进制字符)。若长度为奇数,说明编码丢失了前导零或输入已被破坏,应立刻抛出错误阻止解析。
- 步长为 2 的滑动切片:使用循环
for (let i = 0; i < hex.length; i += 2),每次截取hex.slice(i, i + 2)。 - 基数 16 解析与有效性校验:调用
parseInt(chunk, 16)。如果片段包含非十六进制字符(例如"4g"),parseInt会返回NaN,需显式拦截。 - 字符实例化:将解析得到的码点传入
String.fromCharCode(code)。
/**
 * 将十六进制字符串逆向还原为基础 ASCII 字符串
 * @param {string} hexStr - 待还原的十六进制字符串
 * @returns {string} 还原后的 ASCII 字符串
 */
function hexToAscii(hexStr) {
  if (typeof hexStr !== 'string') {
    throw new TypeError('输入必须为十六进制字符串');
  }

  // 清理所有空格与常见分隔符
  const cleanHex = hexStr.replace(/[\s\-\:]/g, '');

  // 奇数长度拦截
  if (cleanHex.length % 2 !== 0) {
    throw new SyntaxError('十六进制字符串长度无效(必须为偶数)');
  }

  let result = '';
  for (let i = 0; i < cleanHex.length; i += 2) {
    const byteHex = cleanHex.slice(i, i + 2);
    const charCode = parseInt(byteHex, 16);

    // 校验数值合法性
    if (Number.isNaN(charCode)) {
      throw new SyntaxError(`检测到非法十六进制片段: "${byteHex}"`);
    }

    result += String.fromCharCode(charCode);
  }

  return result;
}

// 往返测试(Round-Trip Verification)
const rawText = "Antigravity 2026!\t\n";
const encoded = asciiToHex(rawText);
const decoded = hexToAscii(encoded);

// 验证输出:
// rawText === decoded 输出为 true
// 完整实现无损往返还原
四、边界限制与技术总结
在实施基础 ASCII 字符转换时,必须清醒认识到本方案的适用范围与边界限制。
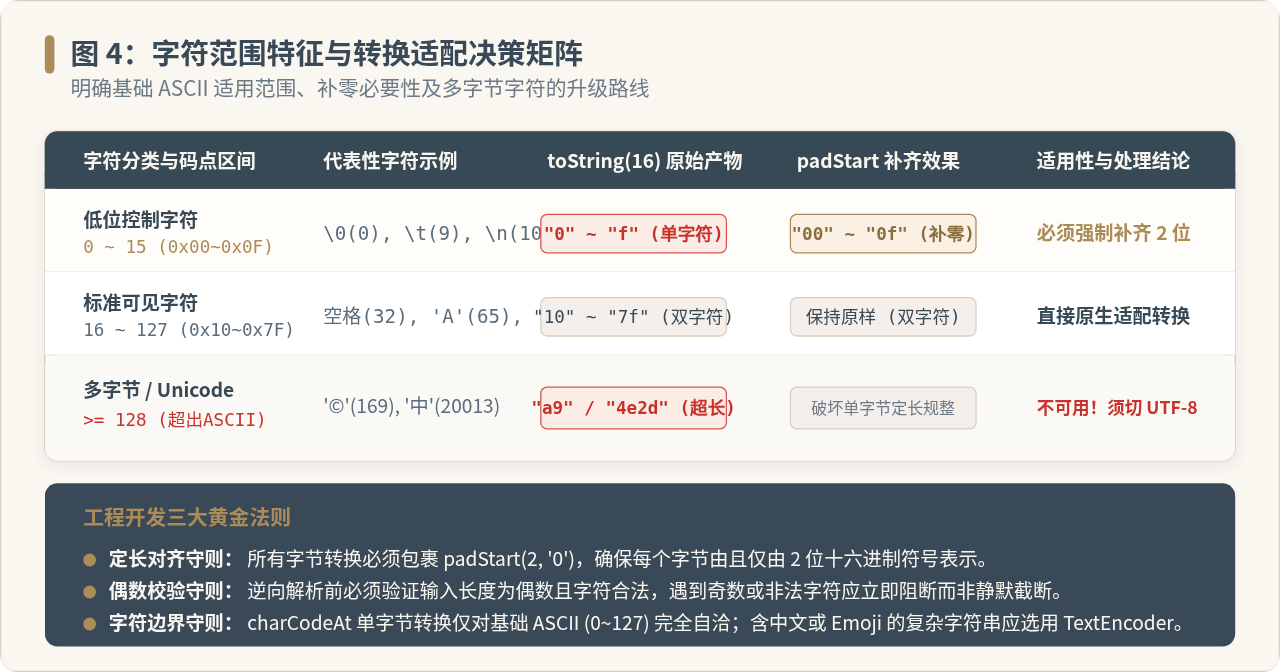
1. 为什么不能直接用于中文或多字节字符?
本文实现基于“1 字符 = 1 字节(0~127)”的 ASCII 假定。在 JavaScript 内部,字符串使用 UTF-16 编码存储:
- 对于基础 ASCII(如
'A'),其 UTF-16 码点与 ASCII 码点完全一致(65),其高 8 位全为 0,占用 1 个字节。 - 但对于中文字符(例如
'中'),'中'.charCodeAt(0)返回的值是20013(十六进制为"4e2d"),它占用了 2 个字节;而 Emoji 符号甚至占用一对代理对(Surrogate Pair,共 4 个字节)。
如果对包含中文字符的字符串直接应用单字节逻辑,charCodeAt 返回的值大于 255,toString(16) 输出 4 位十六进制数,而逆向解码器依然按照 2 字符切片,这会导致整个数据流错位截断并产生乱码。如果项目需要支持包含中文字符的任意字符串,应当切换到现代 Web 标配的 TextEncoder / TextDecoder(通过标准的 UTF-8 字节数组进行中转)。
2. 性能与大规模数据建议
在处理短文本或配置参数转换时,使用 Array.from 或循环连接字符串的性能消耗完全可以忽略不计。但如果需要处理数十兆字节级别的大型文本数据流:
- 避免在长循环中频繁使用字符串
+=拼接,优先使用预分配长度的数组再执行join(''),以减轻垃圾回收(GC)开销。 - 在 Node.js 服务端环境中,涉及二进制数据流的高频转换,建议直接利用原生的
Buffer.from(str, 'ascii').toString('hex')获得 V8 引擎底层的 C++ 级性能加速。
JS字符串转整数:parseInt与Number()的核心区别
2026-11-12 22:09:37
推荐几款安全好用的在线JavaScript代码一键格式化工具
2026-11-12 20:12:32
JS格式化HTML时怎么保留script和style标签内容
2026-11-12 08:03:48
JS格式化HTML代码出现标签嵌套错乱怎么修复
2026-11-11 14:28:11
javascript下载安装手机版怎么导出成表格文件
2026-11-08 21:31:54