js字符串提取中文转数组正则
本文详解在 JavaScript 中利用正则表达式从字符串中精准提取中文字符并转换为数组的实用方法,包含单字提取、连续词段提取、Unicode 属性转义与常见边界防范技巧。
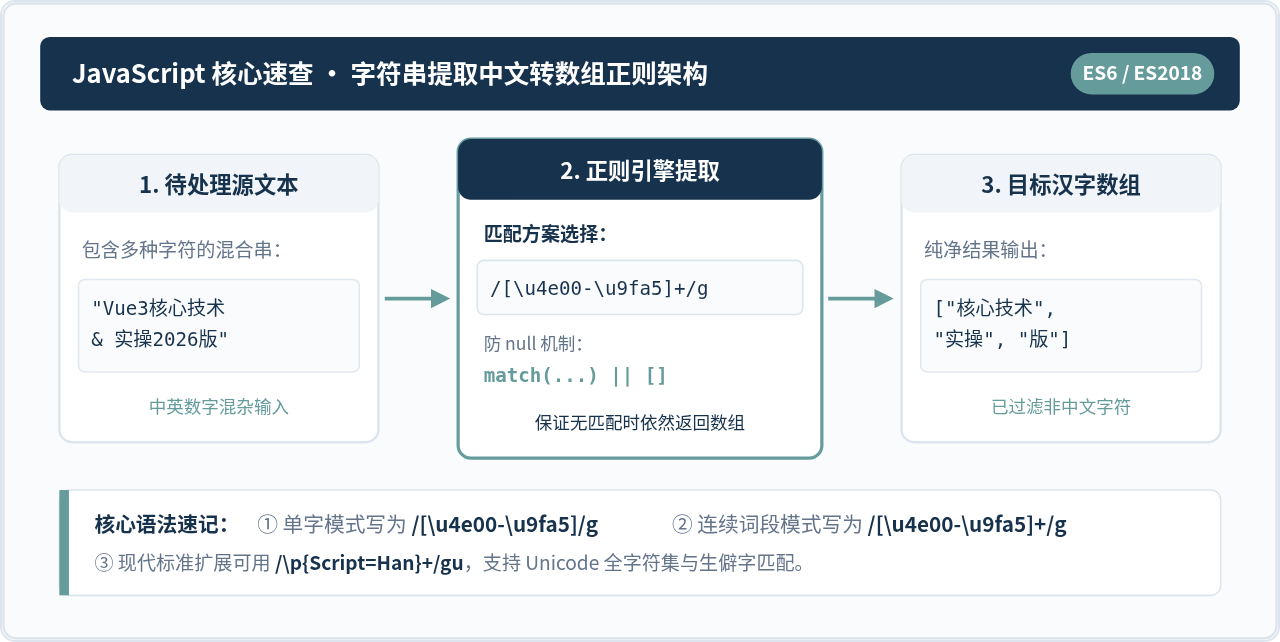
在 JavaScript 中从包含中英文、数字及特殊符号的混合字符串中提取出纯汉字并转为数组,最简洁且稳健的方案是使用 String.prototype.match() 配合汉字正则范围,并在末尾附加空数组兜底:str.match(/[\u4e00-\u9fa5]+/g) || []。
一、标准提取方案与两行基础代码
在前端业务开发中,我们经常需要处理用户输入的混合文本、清洗爬虫数据或提取特定标签。根据业务对“粒度”的要求不同,通常有两种提取场景:
- 单字提取(按字分割):把文本中的每一个汉字分别提取为独立的数组元素,适合做汉字字频统计、生字排版或单个字符校验。
- 连续词组提取(按词段组合):将连续相邻的汉字归并为一个词段元素,英文、数字或符号则作为自然分隔符,适合提炼关键词和文本清洗。
1. 提取每个独立汉字为数组项
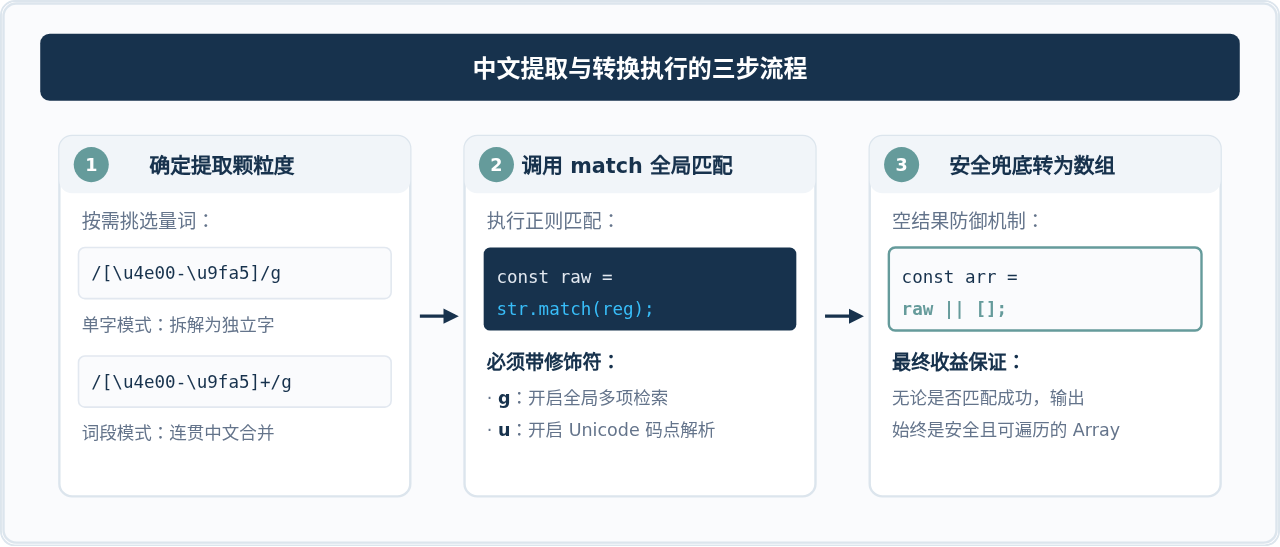
如果需要将每一个汉字逐个拆散,使用不带量词 + 的字符集正则 /[\u4e00-\u9fa5]/g:
const rawText = "2026年Hello世界!前端开发工程师。";

// 提取所有单字汉字
const charList = rawText.match(/[\u4e00-\u9fa5]/g) || [];

console.log(charList);
// 示例输出: ["年", "世", "界", "前", "端", "开", "发", "工", "程", "师"]
2. 提取连续汉字词组为数组项
如果需要保留连贯的中文短语,在字符集合后面加上贪婪量词 +(表示匹配 1 个或多个连续字符):
const rawText = "2026年Hello世界!前端开发工程师。";

// 提取连续中文字段
const wordList = rawText.match(/[\u4e00-\u9fa5]+/g) || [];

console.log(wordList);
// 示例输出: ["年", "世界", "前端开发工程师"]
JavaScript 的 String.prototype.match() 方法在未找到任何匹配项时,返回的是 null 而非空数组 []。如果直接写 rawText.match(...),一旦用户输入的是纯英文或纯数字,后续对其直接调用 .length、.map() 或 .forEach() 就会立即引发 Uncaught TypeError: Cannot read properties of null 运行时异常。
二、正则解析:深入理解 Unicode 范围与现代规范
为什么写成 [\u4e00-\u9fa5] 就能代表中文字符?这背后是 Unicode 标准对汉字的编码分配。
1. 经典区间 \u4e00 至 \u9fa5 是什么
在 Unicode 编码中,汉字属于“CJK 统一表意文字(CJK Unified Ideographs)”。其中:
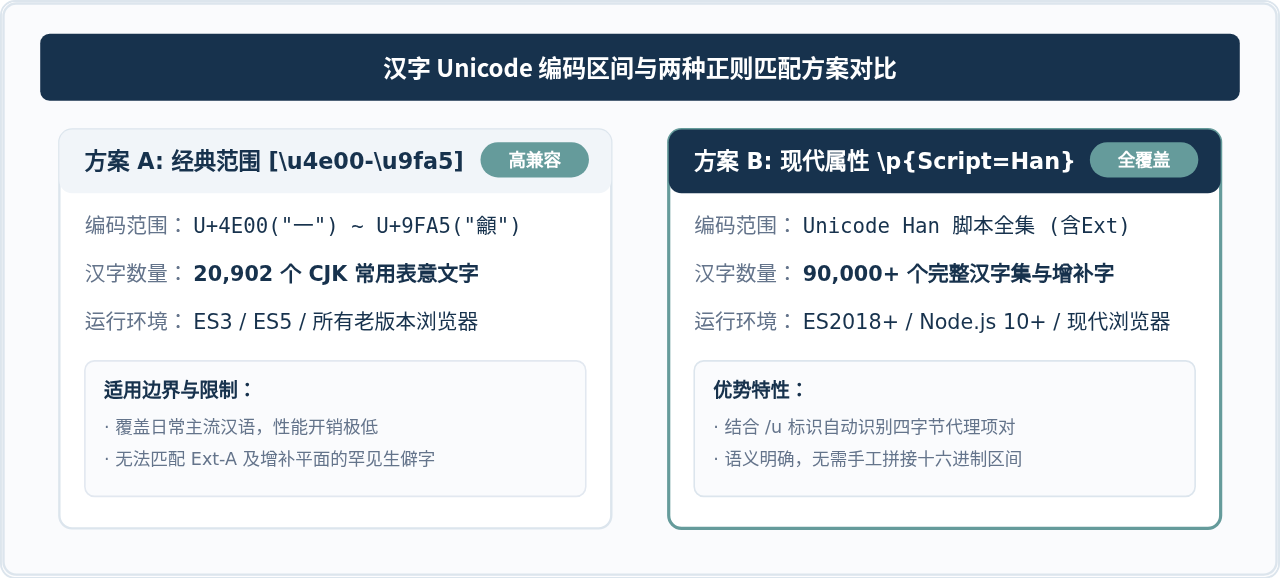
\u4e00:十六进制值0x4E00,对应十进制 19968,在字典中是汉字“一”。\u9fa5:十六进制值0x9FA5,对应十进制 40869,在 Unicode 1.0 中代表常用基本集的最后一个汉字“龥”(读音 yù)。
这两个字符之间的闭区间一共涵盖了 20,902 个常用汉字。对于日常绝大多数网站的表单输入、评论和文章内容提取,这个区间足以覆盖 99.9% 的场景。
2. 现代 JavaScript 方案:ES2018 Unicode 属性转义
随着 Unicode 标准演进,现代汉字库已扩展到扩展 A 区至 G 区,很多生僻字、古籍字(例如冷门人名、地名、医学用字)已超出 \u4e00-\u9fa5 的范围。在 ES2018(ECMAScript 2018)及以上版本中,JavaScript 原生支持了 Unicode Property Escapes(Unicode 属性转义)。
我们可以使用 \p{Script=Han}(简写为 \p{sc=Han})直接表达所有被标记为汉字的字符:
// 包含生僻字“𫖯”(码点 0x2B5AF,超出传统基本集范围)
const rareText = "汉字:赵孟𫖯书法欣赏。";

// 传统正则提取(生僻字可能被漏掉或拆成乱码代理对)
const resOld = rareText.match(/[\u4e00-\u9fa5]+/g) || [];
console.log(resOld);
// 示例输出: ["汉字", "赵孟", "书法欣赏"]  —— "𫖯" 被遗漏

// 现代 ES2018 属性转义(注意末尾必须加 u 修饰符)
const resNew = rareText.match(/\p{Script=Han}+/gu) || [];
console.log(resNew);
// 示例输出: ["汉字", "赵孟𫖯书法欣赏"] —— 完美完整提取
使用 \p{Script=Han} 时,必须在正则末尾添加 u(Unicode)标志,否则浏览器会报语法错误 Invalid regular expression: ... invalid escape。
三、常见业务场景与模式对照
在真实业务场景中,需求往往不止于“纯汉字”,还涉及是否需要保留中文标点符号、处理空格以及去重排序。
场景 1:仅提取纯汉字(过滤所有标点与外文字符)
const str = "订单编号:#2026-DX-987,收件人:李雷;状态:已发货!";
const result = str.match(/[\u4e00-\u9fa5]+/g) || [];

console.log(result);
// 示例输出: ["订单编号", "收件人", "李雷", "状态", "已发货"]
场景 2:连同中文标点符号一并提取(保留完整中文句子)
很多时候我们需要从包含 HTML 标签或代码的混合文本中抓取完整的中文段落,此时中文常用标点符号(如逗号、句号、感叹号、问号、书名号)不应被作为断词分隔符:
const mixedContent = "<p>恭喜!您的申请已通过审核,请于明日到店办理。</p><span>Error 404</span>";

// 中文常用标点区间包含:\u3002(。) \uff1f(?) \uff01(!) \uff0c(,) \u3001(、) \uff1b(;) \uff1a(:) 等
const sentenceReg = /[\u4e00-\u9fa5\u3002\uff1f\uff01\uff0c\u3001\uff1b\uff1a\u201c\u201d\u300a\u300b]+/g;
const sentences = mixedContent.match(sentenceReg) || [];

console.log(sentences);
// 示例输出: ["恭喜!您的申请已通过审核,请于明日到店办理。"]
场景 3:提取并去重(获取文本中出现过的汉字集合)
借助 ES6 的 Set 数据结构,提取出的字符数组可以极度轻便地完成去重:
const paragraph = "前端学习前端开发,坚持学习才能精进!";
const uniqueChars = [...new Set(paragraph.match(/[\u4e00-\u9fa5]/g) || [])];

console.log(uniqueChars);
// 示例输出: ["前", "端", "学", "习", "开", "发", "坚", "持", "才", "能", "精", "进"]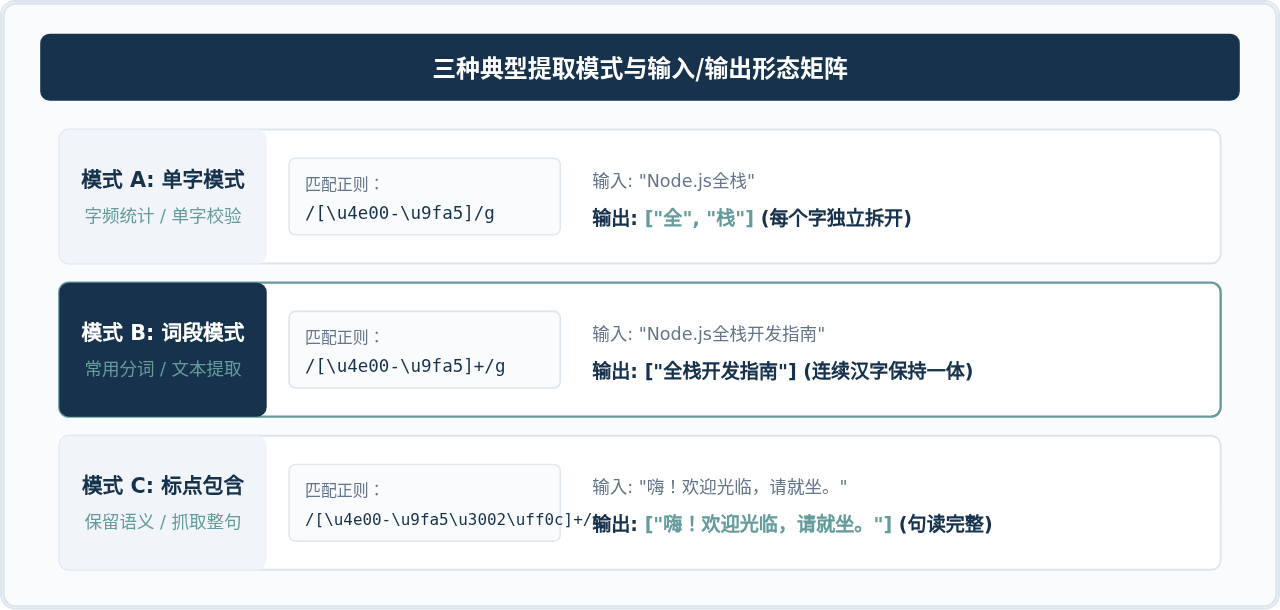
四、生产开发必须警惕的 4 个技术细节
| 潜在隐患 | 典型错误写法 | 生产推荐写法 | 产生后果与解释 |
|---|---|---|---|
| 漏写 g 修饰符 | str.match(/[\u4e00-\u9fa5]/) |
str.match(/[\u4e00-\u9fa5]/g) |
不加 g 只返回首个匹配项并附带 index、groups 等元属性,无法获取全部汉字。 |
| 未防范 null 返回值 | const list = str.match(/.../g); |
const list = str.match(/.../g) || []; |
如果文本中无汉字,match 返回 null,直接遍历会触发 TypeError 崩溃。 |
| 混淆“正则提取”与“中文分词” | 误用 /[\u4e00-\u9fa5]+/g 进行精准词性切分 |
采用原生 Intl.Segmenter 或专业分词库 |
连续汉字正则只能按非汉字截断,无法识别“北京大学”与“生活水平”中的词界。 |
| 生僻字代理项截断 | 处理冷门字时使用未开启 u 的旧正则 |
str.match(/\p{sc=Han}+/gu) || [] |
JavaScript 中辅助平面字符由两个 16 位码元构成,旧正则会将其误判为两个非法字符。 |
进阶:真正的中文自然语义分词(Intl.Segmenter)
如果你期望的不是“把夹杂在英文里的整块中文抠出来”,而是把一整句中文拆解成有实际含义的词语(例如将 "我爱北京天安门" 拆分为 ["我", "爱", "北京", "天安门"]),纯正则 /[\u4e00-\u9fa5]+/g 是做不到的,因为它会把整句话原封不动当成一个元素返回。
在现代 JavaScript 环境中,可以直接使用 ECMAScript 国际化标准 API Intl.Segmenter:
// 原生现代中文分词能力
const text = "我爱北京天安门,天安门上太阳升";
const segmenter = new Intl.Segmenter("zh-CN", { granularity: "word" });

const segments = [...segmenter.segment(text)]
  .filter(item => item.isWordLike)
  .map(item => item.segment);

console.log(segments);
// 示例输出: ["我", "爱", "北京", "天安门", "天安门", "上", "太阳", "升"]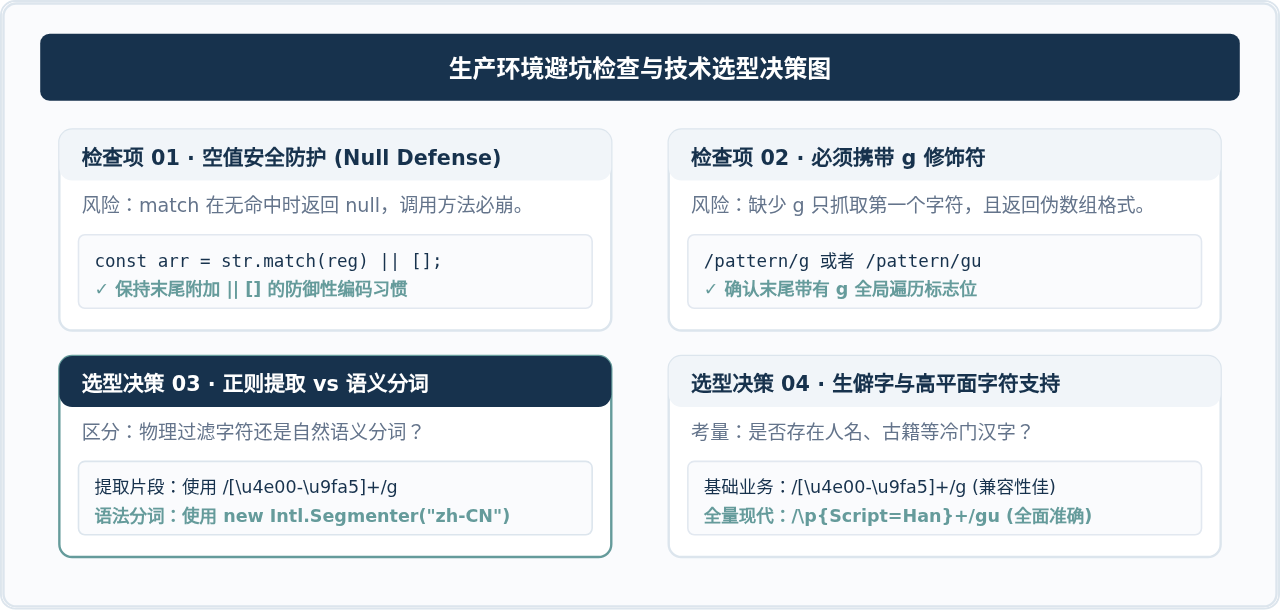
五、总结与通用提取函数封装
为了在实际项目中提高复用性并消除重复的样板代码,我们可以将上述逻辑封装成一个通用工具函数 extractChinese,同时支持“单字”与“词段”两种模式切换:
/**
 * 从字符串中提取中文字符并转为数组
 * @param {string} source - 源文本字符串
 * @param {Object} [options] - 配置项
 * @param {boolean} [options.continuous=true] - 是否保留连续汉字为词组(默认 true,若为 false 则拆分为单字)
 * @param {boolean} [options.includePunctuation=false] - 是否同时提取中文标点
 * @returns {string[]} 提取出的中文字符数组
 */
function extractChinese(source, options = {}) {
  if (typeof source !== "string" || source.length === 0) {
    return [];
  }

  const { continuous = true, includePunctuation = false } = options;

  // 基础汉字范围
  let pattern = "\\u4e00-\\u9fa5";

  // 常用中文标点范围
  if (includePunctuation) {
    pattern += "\\u3002\\uff1f\\uff01\\uff0c\\u3001\\uff1b\\uff1a\\u201c\\u201d\\u300a\\u300b";
  }

  // 组合正则与量词
  const quantifier = continuous ? "+" : "";
  const regex = new RegExp(`[${pattern}]${quantifier}`, "g");

  return source.match(regex) || [];
}

// --- 使用测试 ---
const sample = "ECMAScript 2026:现代 JavaScript 进阶!";

// 1. 连续词段模式
console.log(extractChinese(sample));
// 输出: ["现代", "进阶"]

// 2. 单字拆分模式
console.log(extractChinese(sample, { continuous: false }));
// 输出: ["现", "代", "进", "阶"]

// 3. 包含中文标点模式
console.log(extractChinese(sample, { includePunctuation: true }));
// 输出: [":现代", "进阶!"]
无论面对哪种需求,牢记核心原则:明确定位提取粒度、规范添加 g 修饰符、永远对 match 结果添加 || [] 防御,即可在任何 JavaScript 环境中写出高效且健壮的中文提取代码。
JS中split、扩展运算符与Array.from转换字符串的区别
2026-11-12 20:53:33
WebSocket发送UTF-8文本:JS字符串转二进制流实践
2026-11-12 19:59:38
JS数组哪些方法会修改原数组?mutator与accessor方法区别解析
2026-11-12 17:59:14
JavaScript怎么用for循环向JSON数组动态添加对象
2026-11-12 16:10:29
JS处理大数或特殊值(NaN、Infinity)向下取整的结果
2026-11-12 15:59:04