JS数组哪些方法会修改原数组?mutator与accessor方法区别解析
深入解析JavaScript原生数组的Mutator修改器方法与Accessor访问器方法区别。详细梳理9个会改变原数组的原生方法、不修改原数组的经典与ES2023替代方案,以及在React与现代开发中的避坑实践。
一、核心概念:什么是 Mutator 方法与 Accessor 方法?
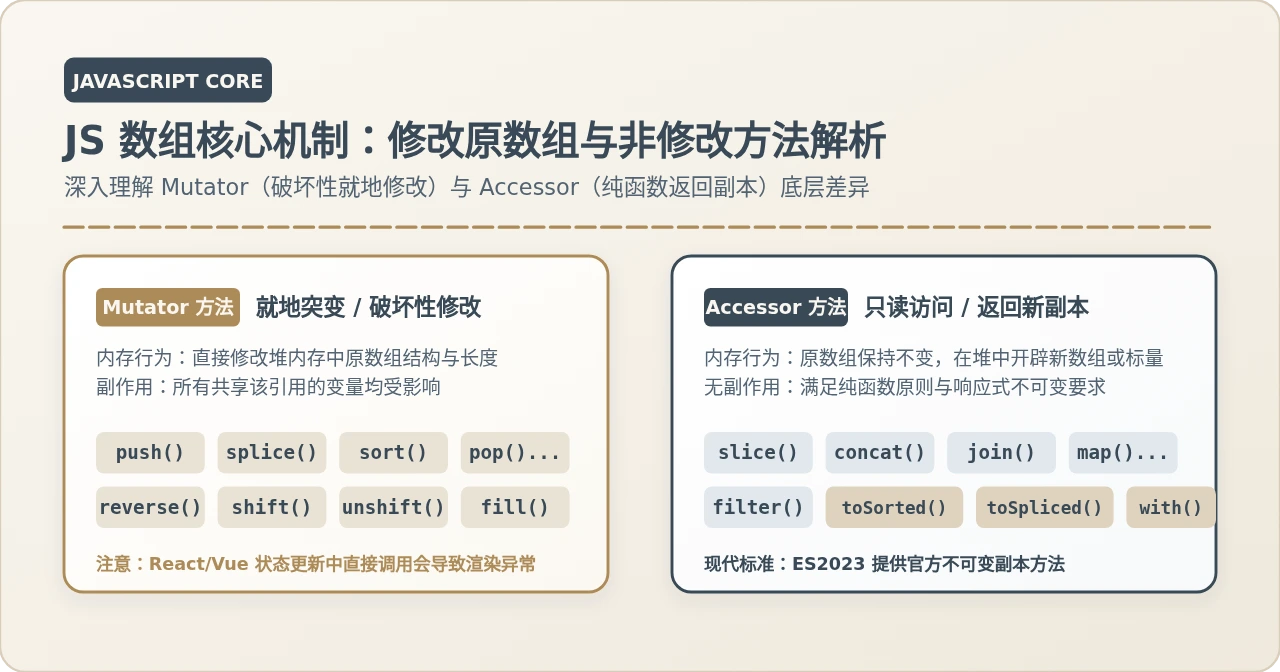
在 ECMAScript 规范与编程语言常识中,数组属于引用类型(Reference Type)。变量名本身只在栈内存(Stack)中存放着一个指向堆内存(Heap)数据块的内存地址。这种内存结构决定了数组的方法调用存在两种截然不同的行为模式:
- Mutator 方法(突变器/修改器):直接在原数组所占用的堆内存空间中改动数据。无论是追加元素、删除项、改变排列次序还是重写索引,方法执行后原有内存区域的内容立即被改变。因此,任何指向该数组的变量别名都会察觉到变动,这种行为被称为副作用(Side Effects)。
- Accessor 方法(访问器):只读取原数组中的数据,进行特定的转换、计算、切片或拼接,最后将结果作为一个全新的数据结构(新数组或标量值)返回,绝不改写原数组的任何元素或其长度。
为了更清晰地理解这两种方法在底层执行时的差异,我们通过图1来观察两者在堆栈内存中的指针与数据流向:
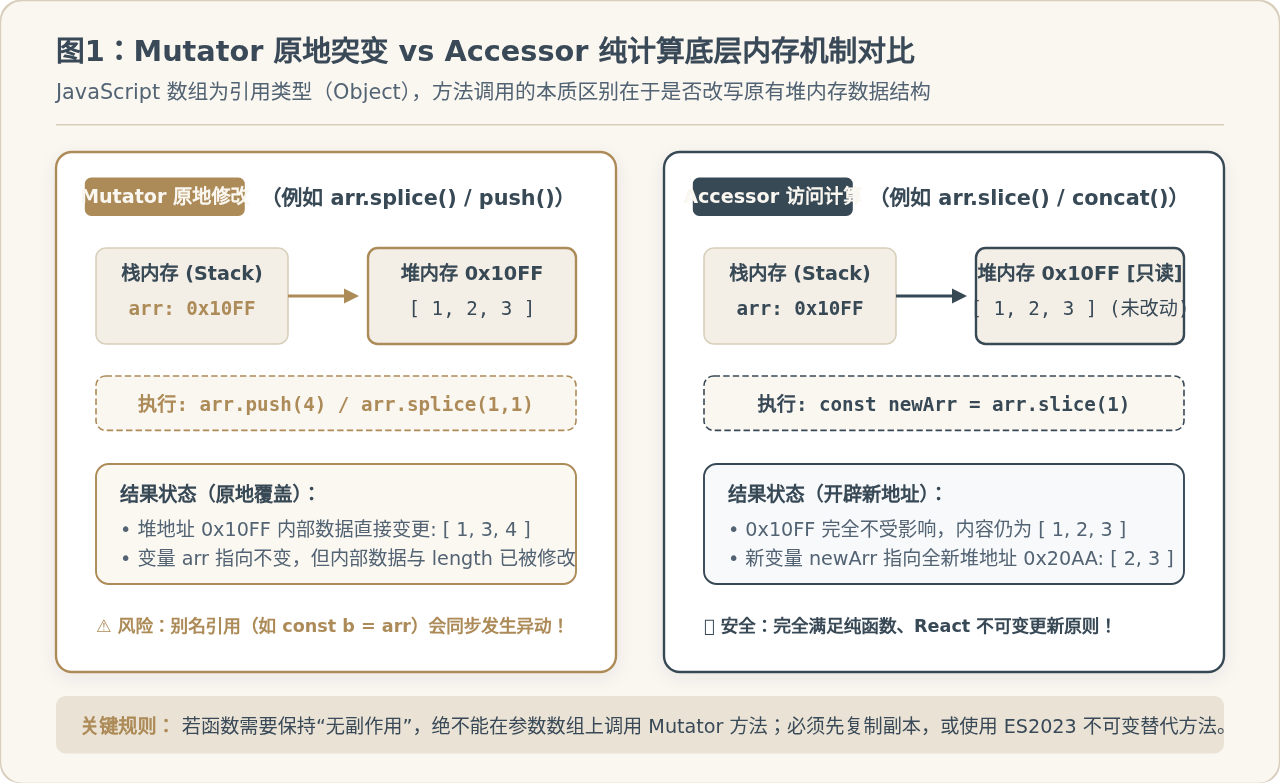
从图1中可以看出,当变量 arr 指向堆地址 0x10FF 时,调用 Mutator 方法会就地改写堆内的数据。如果代码中存在诸如 const shadow = arr; 这样的赋值,那么 shadow 的内容也会在不知不觉中被修改。相反,Accessor 方法(如 slice)会新建一个独立的堆地址 0x20AA,原有的 0x10FF 完好无损。
二、会修改原数组的 9 个 Mutator 方法深度解析
在 ECMAScript 规范的经典定义中,原生 Array.prototype 上共有 9 个典型的 Mutator 方法。记住这 9 个方法可以帮助我们在审查代码时迅速识别潜在的原地修改风险。
1. 端点增删:push()、pop()、unshift()、shift()
这四个方法用于在数组的两端插入或移除元素。需要特别注意:这四个方法的返回值往往不是数组本身,而是操作产生的数值或被移除的项。
push(...items):在数组末尾追加一个或多个元素,修改原数组,返回修改后的数组新长度(length)。pop():移除数组的最后一个元素,修改原数组,返回被移除的那一个元素(若数组为空则返回undefined)。unshift(...items):在数组开头插入一个或多个元素,所有已有元素索引后移,修改原数组,返回修改后的数组新长度(length)。shift():移除数组的第一个元素,后续元素索引前移,修改原数组,返回被移除的那一个元素。
const list = ['apple', 'banana'];

// push 返回的是新长度 3,而不是数组
const newLen = list.push('orange');
console.log(newLen); // 示例输出: 3
console.log(list);   // 示例输出: ['apple', 'banana', 'orange'] (原数组被改写)

// pop 返回被删除的末尾项
const removedItem = list.pop();
console.log(removedItem); // 示例输出: 'orange'
console.log(list);        // 示例输出: ['apple', 'banana']
2. 万能结构剪接:splice()
splice() 是 JavaScript 数组中功能最全面、破坏性最强的修改器方法。它可以在指定索引处同时完成“删除旧项”和“插入新项”。
- 语法:
arr.splice(start, deleteCount, ...items) - 行为:从
start索引开始,删除deleteCount个元素,并在该位置插入items。原数组被原地改变。 - 返回值:返回一个包含所有被删除元素的新数组(如果没有删除元素,则返回空数组
[])。
const fruits = ['apple', 'banana', 'peach', 'pear'];

// 从索引 1 开始,删除 2 个元素,并在该位置插入 'kiwi' 和 'mango'
const deleted = fruits.splice(1, 2, 'kiwi', 'mango');

console.log(deleted); // 示例输出: ['banana', 'peach'] (返回被删除项)
console.log(fruits); // 示例输出: ['apple', 'kiwi', 'mango', 'pear'] (原数组已被改写)splice 包含字母 p(可联想为 Pluck 拔出/插入),会修改原数组;slice 没有字母 p(可联想为 Slice 切片只读),不修改原数组,仅返回截取的浅拷贝副本。
3. 顺序重排:sort() 与 reverse()
sort() 和 reverse() 也是典型的原地修改方法。它们在执行完毕后,返回的是原数组本身的引用(即 arr.sort() === arr 为 true)。
reverse():原地颠倒数组中元素的顺序,返回被翻转的原数组。sort(compareFn):对数组元素进行就地排序。如果省略比较函数compareFn,默认会将所有元素转换为字符串,并按照 UTF-16 码元顺序升序排序。
const nums = [10, 2, 5, 1];

// 默认排序陷阱:按字符串字典序排,'10' 排在 '2' 前面
nums.sort();
console.log(nums); // 示例输出: [1, 10, 2, 5] (原数组被修改,且结果并非数值大小序)

// 正确做法:提供数值比较函数
nums.sort((a, b) => a - b);
console.log(nums); // 示例输出: [1, 2, 5, 10]
4. 批量操作:fill() 与 copyWithin()
这两个方法在日常业务逻辑中较少使用,但在底层数据结构或 TypedArray/Canvas 处理中很常见:
fill(value, start, end):用一个固定值填充数组中从start到end索引的所有位置,修改原数组并返回该数组。copyWithin(target, start, end):浅复制数组中某一部分序列,并覆盖粘贴到同一数组的target位置,数组长度不变,返回被修改后的原数组。
const tags = ['a', 'b', 'c', 'd'];
tags.fill('x', 1, 3);
console.log(tags); // 示例输出: ['a', 'x', 'x', 'd'] (原数组被改写)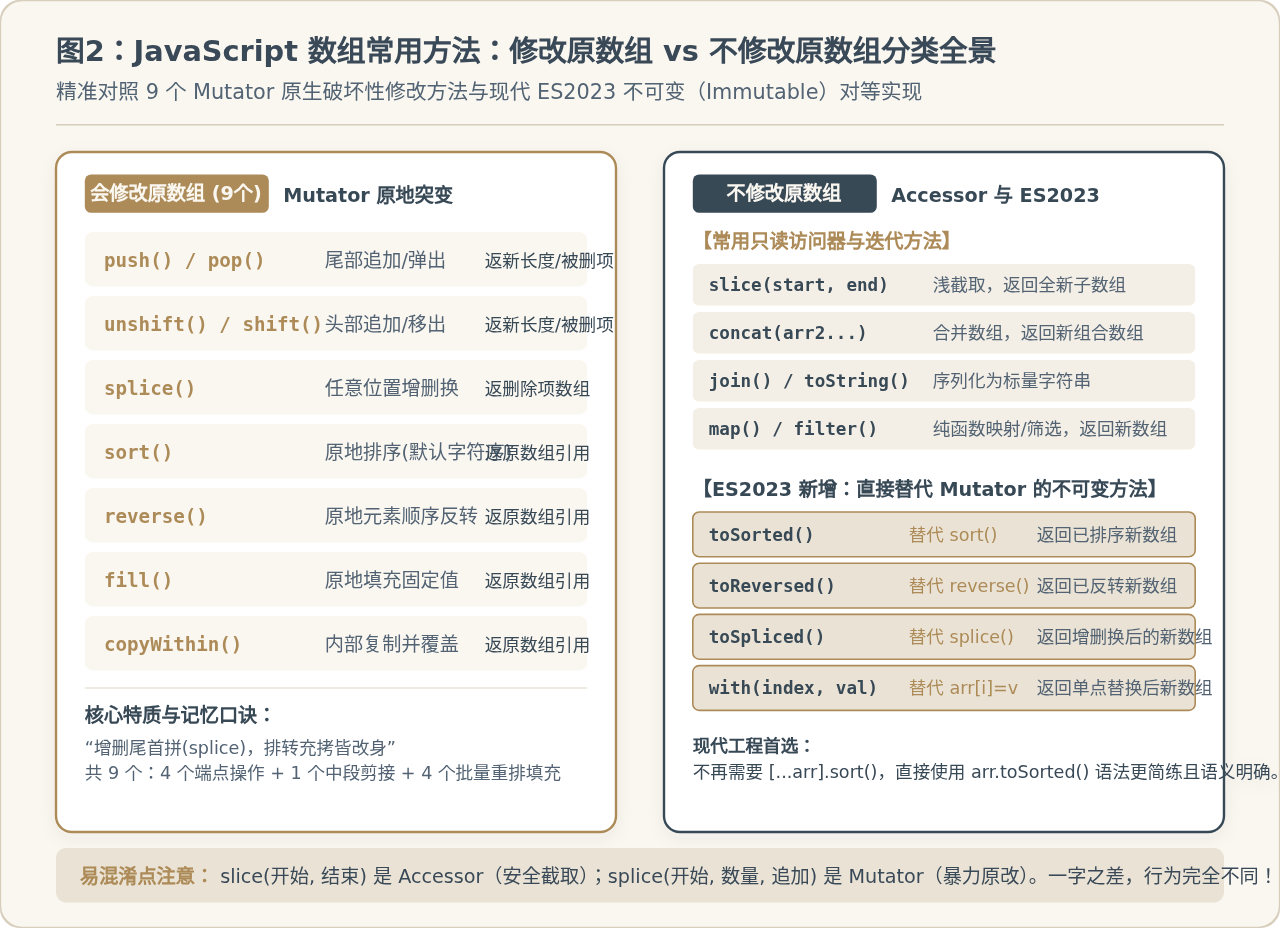
三、不修改原数组的常用方法:Accessor 访问器与迭代方法
了解了 9 个突变修改器之后,剩下的绝大多数原生方法都属于不修改原数组的范畴。它们保证了调用的安全性。
1. 经典只读 Accessor 方法
这类方法通常提取或组合数据,生成新结构返回:
slice(start, end):截取原数组指定范围的元素,返回浅拷贝的全新数组。concat(...arrays):拼接一个或多个数组或值,返回合并后的全新数组。join(separator):将数组所有项连接为字符串并返回,原数组保持不变。indexOf()、lastIndexOf()、includes():查找特定值的索引或是否存在,返回数值或布尔值标量。
2. 遍历与迭代方法(Iteration Methods)
严格来说,map()、filter()、reduce()、every()、some()、find()、flatMap() 属于迭代方法。这些方法本身不会修改原数组。
例如 arr.map(fn) 会根据每次回调的返回值创建一个新数组,原 arr 的元素及长度不会被 map 底层改写。
forEach 或 map 本身不修改原数组,但如果开发者在回调函数内部执行了 arr[index] = newValue 或改写了对象属性 item.done = true,原数组或其引用的对象依然会被改变。这是业务代码层面的改写,而非方法本身的机制。
3. ES2023 新标准:四位不可变“孪生兄弟”
长期以来,开发者若想对数组排序或剪切,又不想污染原数组,必须写出 [...arr].sort() 这样繁琐的代码。ECMAScript 2023 (ES14) 正式推出了 4 个全新的非破坏性方法,作为 Mutator 方法的安全镜像:
| 传统 Mutator(会改原数组) | ES2023 替代方法(返回新数组) | 核心功能说明 |
|---|---|---|
arr.sort(compareFn) |
arr.toSorted(compareFn) |
按比较规则排序,返回已排序的全新数组 |
arr.reverse() |
arr.toReversed() |
翻转元素顺序,返回已反转的全新数组 |
arr.splice(start, count, ...items) |
arr.toSpliced(start, count, ...items) |
删除/插入指定区间,返回修改后的全新数组 |
arr[index] = value |
arr.with(index, value) |
单点替换索引处元素,返回替换后的全新数组 |
const original = [3, 1, 4];

// 使用 ES2023 toSorted:原数组安然无恙
const sorted = original.toSorted();
console.log(sorted);   // 示例输出: [1, 3, 4]
console.log(original); // 示例输出: [3, 1, 4] (未被修改)

// 使用 with 替换指定索引元素
const updated = original.with(1, 99);
console.log(updated);  // 示例输出: [3, 99, 4]
console.log(original); // 示例输出: [3, 1, 4] (未被修改)
四、开发实践:如何避免意外修改原数组的“防御性编程”?
在 React、Vue 3、Redux 以及函数式编程(Functional Programming)架构中,数据不可变性(Immutability)是核心铁律。
为什么不能随意修改原数组?
-
React 渲染机制失效:React 的
useState在判定是否需要重新渲染时,使用的是Object.is()浅比较(判断引用地址)。如果在原有state数组上调用state.push(item)然后调用setState(state),React 发现前后内存地址相同,会直接跳过组件重新渲染,导致界面不更新。 -
跨模块污染隐蔽 Bug:当一个函数接收数组入参并直接执行
arr.splice()时,外部调用方传递进来的原数据已被破坏,往往导致其他调用者读取到残缺数据,极难排查。
在实际编码中,我们可以通过图3所示的 4 步决策链来规范数组操作:
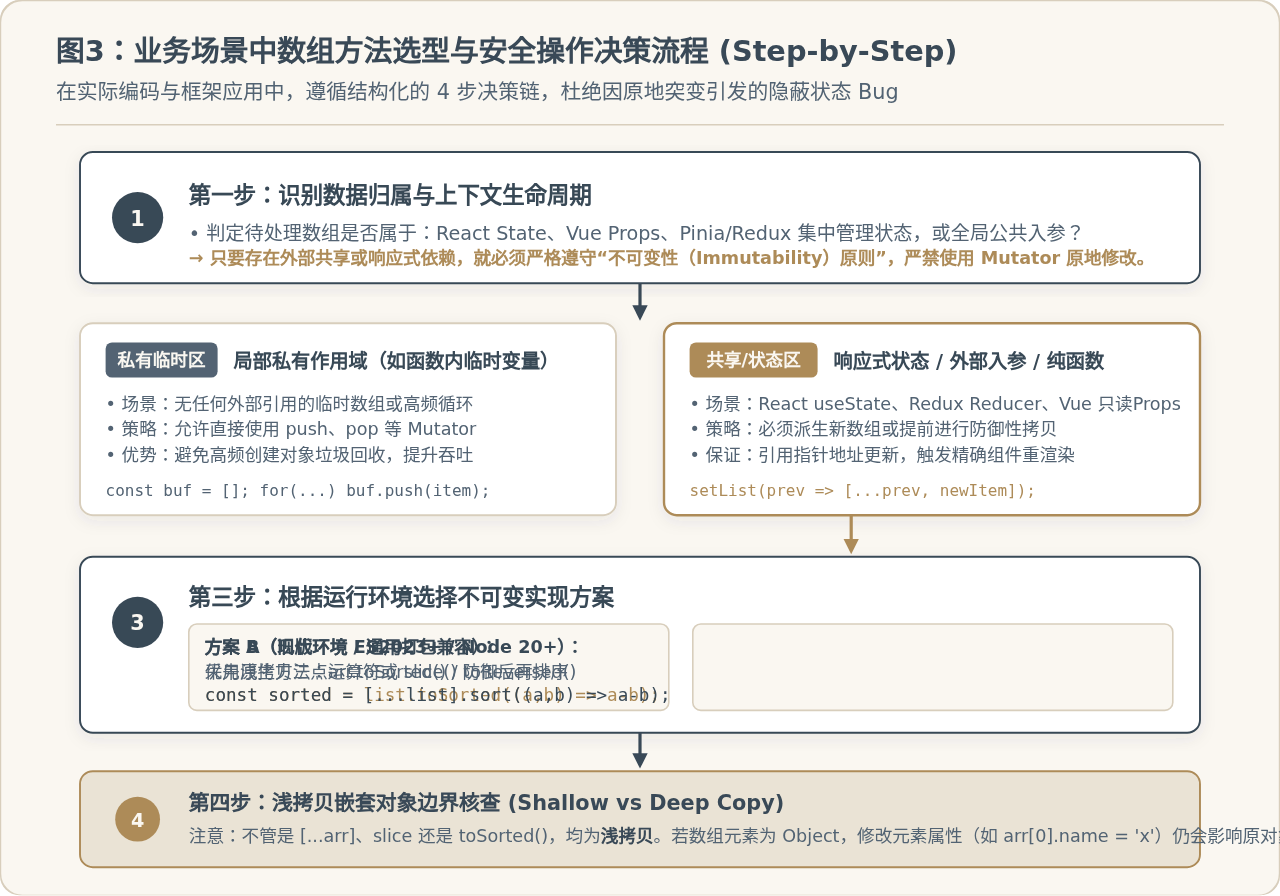
常见防御性操作对照示例
// ❌ 危险做法:直接就地修改状态
function handleAddItemBad(newFruit) {
  fruits.push(newFruit); // 破坏了外部变量或 state
  setFruits(fruits);      // 引用未改变,React 无法检测到更新
}

// ✅ 经典防御性浅拷贝写法:展开运算符
function handleAddItemGood(newFruit) {
  setFruits(prev => [...prev, newFruit]); // 生成全新数组地址
}

// ✅ 针对排序/反转的防御性处理
function getRankedList(rawList) {
  // 方案1:现代环境 ES2023+
  return rawList.toSorted((a, b) => b.score - a.score);

  // 方案2:传统兼容写法 (先浅拷贝再排序)
  // return [...rawList].sort((a, b) => b.score - a.score);
}
五、高频陷阱排查与避坑速查
在工程排查中,有三类与 Mutator 相关的 Bug 出现频率极高,开发者需形成敏锐的代码嗅觉:
陷阱 1:以为 sort/reverse 是纯函数而进行链式调用
有些开发者习惯写 const sortedList = list.sort(),并潜意识地认为 list 依然保持原有顺序。实际上,不仅 sortedList 被赋予了排序后的引用,原变量 list 的内容顺序也被彻底打乱。如果在多个地方共享 list,系统将发生不可预测的时序错误。
陷阱 2:误用 push/unshift 的返回值作为新数组
初学者常常误写出类似下面的代码:
let users = ['Alice'];
users = users.push('Bob'); // ❌ 致命错误!
console.log(users);         // 示例输出: 2 (users 变成了数字,而非数组)
push 和 unshift 的返回值是操作后的 数组长度(Number),将其重新赋值给原数组变量会导致数据直接丢失并报错。
陷阱 3:浅拷贝无法防止嵌套对象的修改
无论是 [...arr]、arr.slice() 还是 arr.toSorted(),它们创建的都是浅拷贝副本(Shallow Copy)。新旧数组虽然拥有不同的数组容器地址,但其内部包含的对象元素指向的依然是同一块对象堆内存:
const listA = [{ id: 1, name: 'Tom' }];
const listB = [...listA]; // 浅拷贝数组外壳

// 修改内部对象的属性
listB[0].name = 'Jerry';

console.log(listA[0].name); // 示例输出: 'Jerry' (原数组内部对象仍然被修改!)
如果数组内包含深层对象且需要完全隔离,应当结合 structuredClone() 或 Immer 库来完成深层不可变更新。
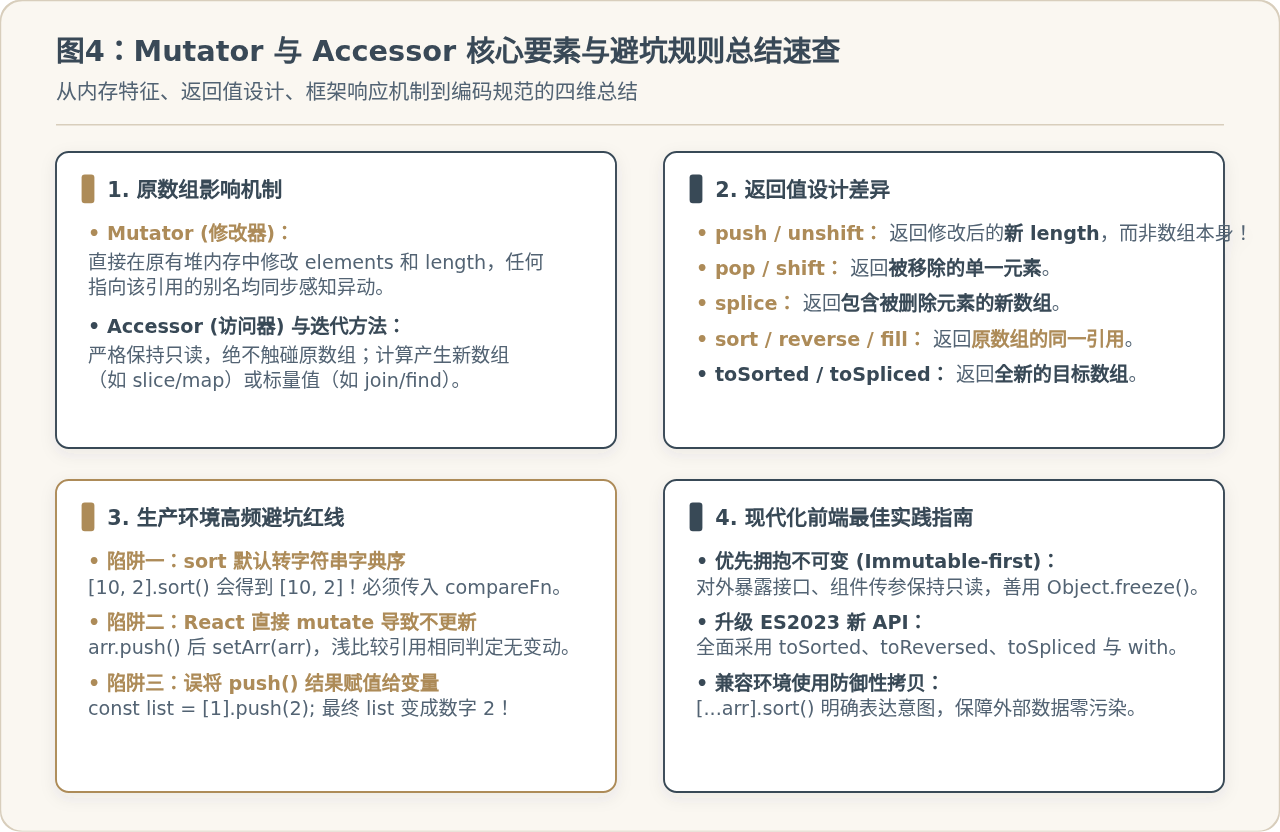
六、总结
区分 JavaScript 数组的 Mutator 与 Accessor 方法,核心在于把握数据变更的作用域边界:
在追求极致吞吐的局部算法(如私有函数内的缓冲池构建)中,9 个 Mutator 方法(push、pop、shift、unshift、splice、sort、reverse、fill、copyWithin)能够避免对象重复分配,效率极高;但在现代应用状态管理、组件通信和函数设计中,严格推崇不可变性。
在现代工程中,推荐全面拥抱 ES2023 不可变方法(toSorted、toReversed、toSpliced、with),或在旧环境中使用 [...arr] 浅拷贝,从代码语义上彻底杜绝原地副作用,让数据流动清晰可控。
JavaScript怎么用for循环向JSON数组动态添加对象
2026-11-12 16:10:29
JS处理大数或特殊值(NaN、Infinity)向下取整的结果
2026-11-12 15:59:04
JS中怎么处理金融场景下的高精度四舍五入
2026-11-12 15:39:48
JS数组排序不修改原数组:使用扩展运算符或toSorted()方法
2026-11-12 14:27:25
怎么在JS字符串指定位置插入字符
2026-11-12 11:58:04