WebSocket发送UTF-8文本:JS字符串转二进制流实践
深入讲解在WebSocket通信中如何将JavaScript字符串转为UTF-8二进制流发送。涵盖TextEncoder与DataView封包、协议头设计、ArrayBuffer内存管理、接收端解码及字符与字节长度避坑指南。
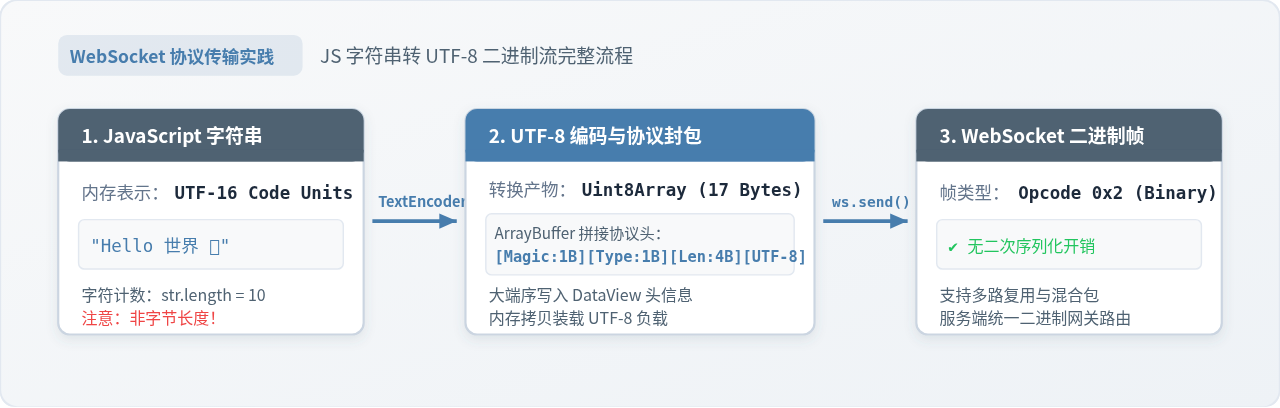
一、为什么需要将文本转为二进制流发送
WebSocket 协议(RFC 6455)在帧定义中明确区分了文本帧(Opcode 0x1)与二进制帧(Opcode 0x2)。调用 ws.send("hello") 时,底层会自动将字符串编码为 UTF-8 文本帧传输。既然原生支持直接发字符串,为什么还要手动将其转为二进制流?核心原因在于工程实践中对协议自主性与传输一致性的需求:
- 自定义二进制协议头(Header Framing): 原生文本帧不允许携带自定义的二进制元数据。而在实际架构中,每条消息往往需要附带 1 字节魔数(Magic Number 用于快速过滤攻击或脏流量)、1 字节业务类型(MessageType)、2 字节消息序号(Sequence ID 用于请求应答匹配)以及 4 字节数据长度。将文本包装在二进制帧中,可以使头部字段与文本负载紧凑排列在同一连续内存段中。
- 避免多层 JSON 序列化的性能损耗: 若在文本帧中传递元数据,常规做法是将整个消息封装为 JSON 字符串(如
JSON.stringify({type: 1, seq: 102, data: "..."}))。在大并发、高频推送场景下,JSON 的文本序列化与反序列化会造成显著的 CPU 开销和垃圾回收(GC)停顿。而采用二进制头加 UTF-8 原始字节,服务端仅需直接按偏移量读取字节即可完成路由分发。 - 通道多路复用与混合流统一: 当同一条 WebSocket 隧道既要传输文本聊天消息,又要传输二进制音频流、Canvas 图像切片或 Protobuf 数据时,统一使用二进制帧(Opcode 0x2)能够让底层接入网关使用单一的消息分发器,免去维护“文本与二进制双分支”的解析逻辑。
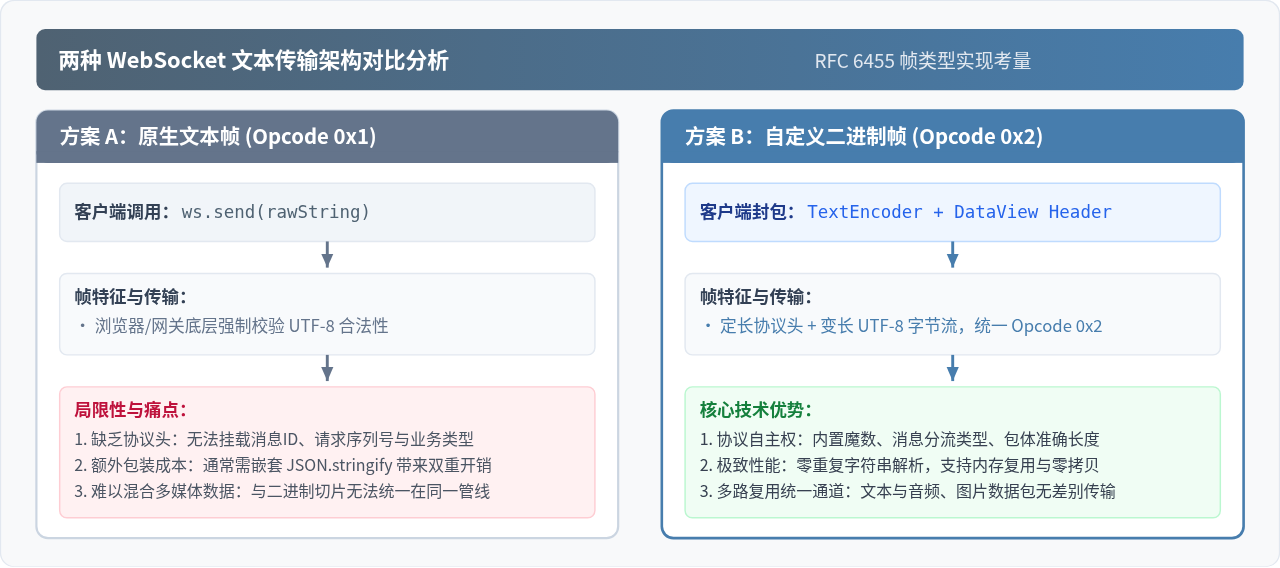
二、核心转换机制:从 JS 字符串到 UTF-8 字节流
在 JavaScript 中,字符串在 V8 等引擎内部是以 UTF-16 编码单元序列存储的。每个常规字符占用 2 字节(Code Unit),而生僻字或 Emoji 表情(如 👋)则由两个 UTF-16 代理对(Surrogate Pair)组合而成,共占用 4 字节。网络传输协议普遍要求使用通用的变长编码 UTF-8。
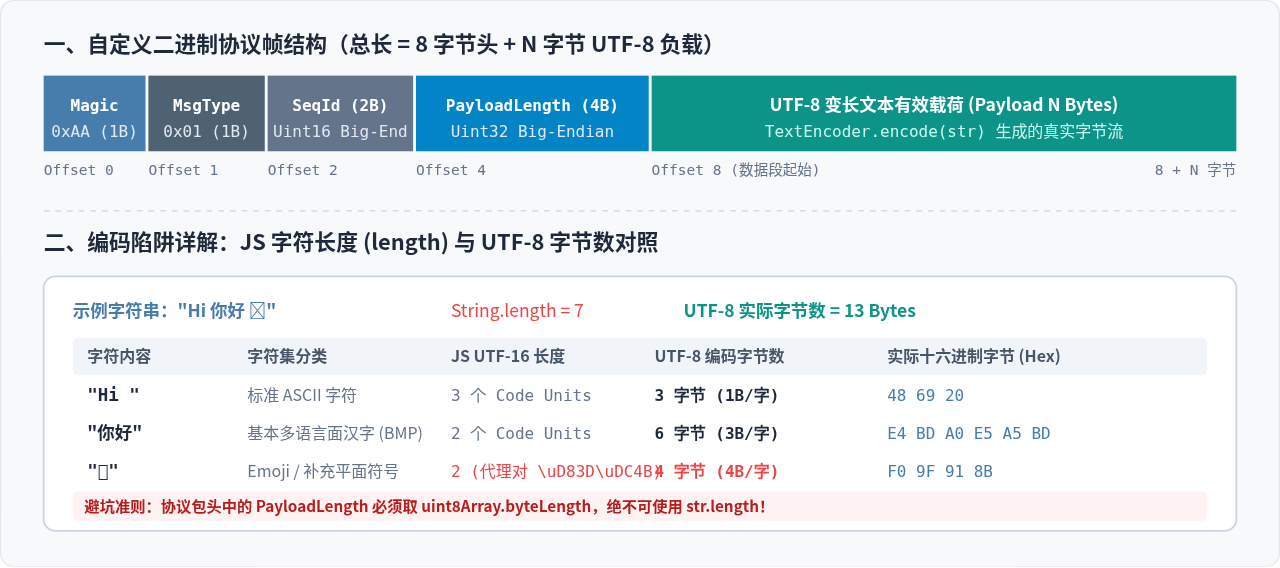
1. 关键认知陷阱:str.length 不等于字节长度
许多初学者在分配二进制缓冲区(Buffer)或写入包头长度时,直接取 str.length,这会导致严重的协议损坏:
- ASCII 字符(如英文数字):在 UTF-8 中占 1 字节;
- 常用中文汉字(如“你好”):在 UTF-8 中通常占 3 字节,而在 JS 中
"你好".length === 2; - Emoji 或部分辅助平面字符(如“👋”):在 UTF-8 中占 4 字节,而在 JS 中其
length === 2。
因此,必须先经过 UTF-8 编码,以得到的 Uint8Array.byteLength 作为分配内存和写入协议头包长的绝对依据。
2. 标准转码 API:TextEncoder 与 encodeInto
现代浏览器与 Node.js 均内置了标准的 TextEncoder。其核心方法 encode() 接收字符串并直接输出包含 UTF-8 编码字节的 Uint8Array:
// 基础转换方法
const text = "WebSocket 实践:你好 👋";
const encoder = new TextEncoder();
const utf8Bytes = encoder.encode(text);

console.log("字符长度 (str.length):", text.length);          // 19
console.log("UTF-8 真实字节数 (byteLength):", utf8Bytes.byteLength); // 27
在极高频发送场景中(例如每秒数十次状态同步),频繁调用 encode() 会创建大量短暂存在的 Uint8Array 实例,引发浏览器垃圾回收卡顿。此时可使用进阶方法 encodeInto(),将字符串直接写入预先分配好的目标 Uint8Array 内存切片中,实现零多余内存分配:
// 高性能无额外分配写入
const targetBuffer = new Uint8Array(1024);
const result = encoder.encodeInto(text, targetBuffer.subarray(HEADER_OFFSET));
// result.read 为消费的 UTF-16 单元数,result.written 为实际写入目标缓冲区的字节数
console.log("写入字节数:", result.written);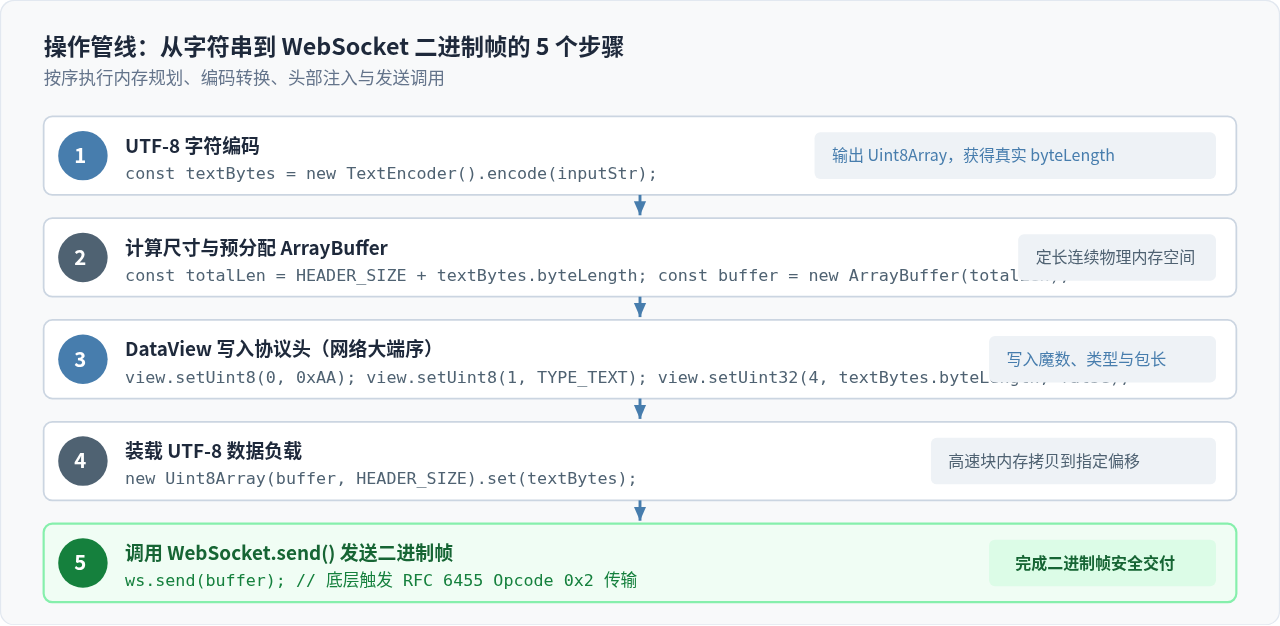
三、二进制封包实践:构造包含协议头的完整数据包
将文本转换为 UTF-8 字节后,下一步是将其与自定义协议头拼接为一个连续的 ArrayBuffer。我们设计一个标准的工业级通信协议帧结构作为示范:
| 字段名称 | 字节偏移量 | 占用大小 | 数据类型 / 字节序 | 作用说明 |
|---|---|---|---|---|
| Magic Code | 0 | 1 Byte | Uint8 (0xAA) | 协议魔数,用于快速判定报文有效性 |
| Msg Type | 1 | 1 Byte | Uint8 (0x01) | 消息类型:0x01 文本消息,0x02 心跳,0x03 指令 |
| Seq ID | 2 | 2 Bytes | Uint16 (Big-Endian) | 请求序号,用于异步 RPC 响应匹配 |
| Payload Length | 4 | 4 Bytes | Uint32 (Big-Endian) | UTF-8 负载的精确字节长度(N) |
| UTF-8 Payload | 8 | N Bytes | Uint8Array 字节流 | 由 TextEncoder 转出的变长 UTF-8 文本载荷 |
完整封包代码实现
以下函数展示了如何利用 ArrayBuffer、DataView 以及 Uint8Array 协同完成定长头部注入与变长载荷拷贝:
const PROTOCOL_MAGIC = 0xAA;
const HEADER_SIZE = 8; // 1 + 1 + 2 + 4 字节
const encoder = new TextEncoder();

/**
 * 将字符串打包为二进制协议帧
 * @param {string} text - 待发送的原始文本
 * @param {number} seqId - 消息序号 (0~65535)
 * @param {number} msgType - 消息类型 (默认 0x01)
 * @returns {ArrayBuffer} 封包完毕的连续二进制内存
 */
function packTextMessage(text, seqId, msgType = 0x01) {
  // 步骤 1:转码为 UTF-8 字节流并获取精确字节大小
  const utf8Bytes = encoder.encode(text);
  const payloadLen = utf8Bytes.byteLength;

  // 步骤 2:分配连续内存(头部 + 负载)
  const totalLen = HEADER_SIZE + payloadLen;
  const buffer = new ArrayBuffer(totalLen);

  // 步骤 3:使用 DataView 写入定长协议头(统一采用网络大端序)
  const view = new DataView(buffer);
  view.setUint8(0, PROTOCOL_MAGIC);             // 偏移 0: 魔数
  view.setUint8(1, msgType);                    // 偏移 1: 消息类型
  view.setUint16(2, seqId, false);              // 偏移 2: 序列号 (false 表示大端序)
  view.setUint32(4, payloadLen, false);         // 偏移 4: 负载长度 (false 表示大端序)

  // 步骤 4:通过 TypedArray 视图将 UTF-8 载荷拷贝至第 8 字节后
  const payloadView = new Uint8Array(buffer, HEADER_SIZE);
  payloadView.set(utf8Bytes);

  return buffer;
}
四、WebSocket 发送与接收端解码还原
在客户端发起连接后,需要确保将 ws.binaryType 设置为 "arraybuffer"。默认情况下浏览器 WebSocket 收到二进制帧会将其封装为 Blob 对象,设置成 "arraybuffer" 后可以直接在内存中同步读取字节,避免异步读取 Blob 带来的回调开销。
双向通信端到端完整实践
以下代码演示了从连接建立、封包发送,到接收对方返回的二进制帧、校验拆包并还原为 UTF-8 字符串的完整链路:
const decoder = new TextDecoder('utf-8');
let currentSeq = 1;

const ws = new WebSocket("wss://api.example.com/binary-channel");

// 关键配置:指定接收数据类型为 ArrayBuffer
ws.binaryType = "arraybuffer";

ws.onopen = () => {
  console.log("WebSocket 连接已建立,准备发送二进制 UTF-8 消息");

  const msg = "用户加入房间: 编码测试 [OK] 🚀";
  const packet = packTextMessage(msg, currentSeq++);

  // 发送 ArrayBuffer,底层自动组装为 Opcode 0x2 二进制帧
  ws.send(packet);
};

ws.onmessage = (event) => {
  // 确认接收到的确实是 ArrayBuffer 二进制数据
  if (!(event.data instanceof ArrayBuffer)) {
    console.warn("收到非二进制数据帧,跳过处理");
    return;
  }

  const buffer = event.data;

  // 校验 1:包体长度不能小于协议头尺寸
  if (buffer.byteLength < HEADER_SIZE) {
    console.error("数据包非法:小于最小头部长度");
    return;
  }

  const view = new DataView(buffer);

  // 校验 2:协议魔数匹配
  const magic = view.getUint8(0);
  if (magic !== PROTOCOL_MAGIC) {
    console.error(`魔数不符: 期望 0x${PROTOCOL_MAGIC.toString(16)}, 收到 0x${magic.toString(16)}`);
    return;
  }

  const msgType = view.getUint8(1);
  const seqId = view.getUint16(2, false);
  const payloadLen = view.getUint32(4, false);

  // 校验 3:包体完整性校验
  if (buffer.byteLength !== HEADER_SIZE + payloadLen) {
    console.error(`数据包长度异常:标称 ${payloadLen},实际载荷 ${buffer.byteLength - HEADER_SIZE}`);
    return;
  }

  // 解码步骤:零拷贝切片提取载荷,调用 TextDecoder 还原字符串
  const payloadBytes = new Uint8Array(buffer, HEADER_SIZE, payloadLen);
  const textContent = decoder.decode(payloadBytes);

  console.log(`[收到消息] Type: ${msgType}, Seq: ${seqId}, 内容: ${textContent}`);
};

ws.onerror = (err) => {
  console.error("WebSocket 通信异常:", err);
};
五、进阶优化与高频避坑指南
在实际工程化运行中,二进制流与字符转换涉及底层内存与字节序处理,以下为最容易出现故障的排查要点:
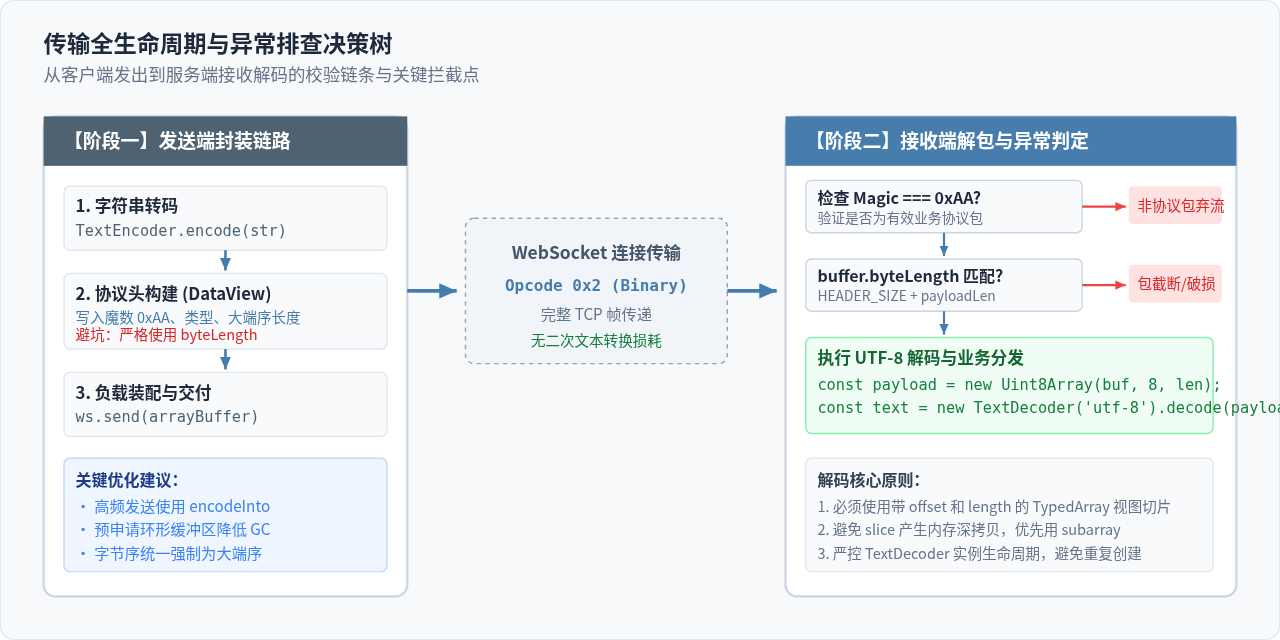
避坑点一:TypedArray 的 byteOffset 与 buffer 陷阱
在调用解码或创建视图时,如果不传递 byteOffset 和 length,直接使用 uint8Array.buffer,将拿到的是整个底层 ArrayBuffer,可能包含头部或其他切片数据。因此切片必须始终使用 new Uint8Array(buffer, offset, length) 或 uint8Array.subarray(),切忌混淆视图与底层缓冲区的边界。
避坑点二:严格固定字节序(Endianness)
不同客户端(x86 架构大多为小端序,ARM/部分移动设备或网络协议规范为大端序)的默认架构差异可能导致整数解析翻转。在调用 DataView.prototype.getUint32() / setUint32() 时,必须显式传入 false 指定大端序(网络字节序),确保跨语言、跨端解析一致。
3. 异常字符与畸形字节容错策略
默认情况下,TextDecoder 会对不符合 UTF-8 规范的畸形字节序列自动替换为 Unicode 替换字符 \uFFFD(即显示为未知方块或问号)。如果你在开发高敏感通信系统,要求遇到畸形编码时立即阻断并上报错误,可在实例化时开启严格模式:
// 开启 fatal 严格模式,遇到非法字节流时直接抛出 TypeError
const strictDecoder = new TextDecoder('utf-8', { fatal: true });
try {
  const cleanText = strictDecoder.decode(payloadBytes);
} catch (err) {
  console.error("检测到非法 UTF-8 恶意或损坏数据包:", err);
}
4. 内存生命周期总结
WebSocket 发送 UTF-8 二进制流是一个典型的“计算尺寸 → 内存申请 → 协议头注入 → 载荷拷贝 → 帧分发”流水线。相较于原生字符串传输,二进制流实践赋予了开发者定义传输协议的主导权,显著减少了中间序列化环节,为构建高并发、多类型混合、强健壮性的全双工系统提供了坚实的基础。
JS数组哪些方法会修改原数组?mutator与accessor方法区别解析
2026-11-12 17:59:14
JavaScript怎么用for循环向JSON数组动态添加对象
2026-11-12 16:10:29
JS处理大数或特殊值(NaN、Infinity)向下取整的结果
2026-11-12 15:59:04
JS中怎么处理金融场景下的高精度四舍五入
2026-11-12 15:39:48
JS数组排序不修改原数组:使用扩展运算符或toSorted()方法
2026-11-12 14:27:25