JS不可变数据实践:怎么在不修改原数组的情况下添加元素
详细讲解在JavaScript中如何在不修改原数组的前提下添加元素,涵盖扩展运算符、concat与ES2023 toSpliced方法,对比内存引用机制并解析浅拷贝陷阱。
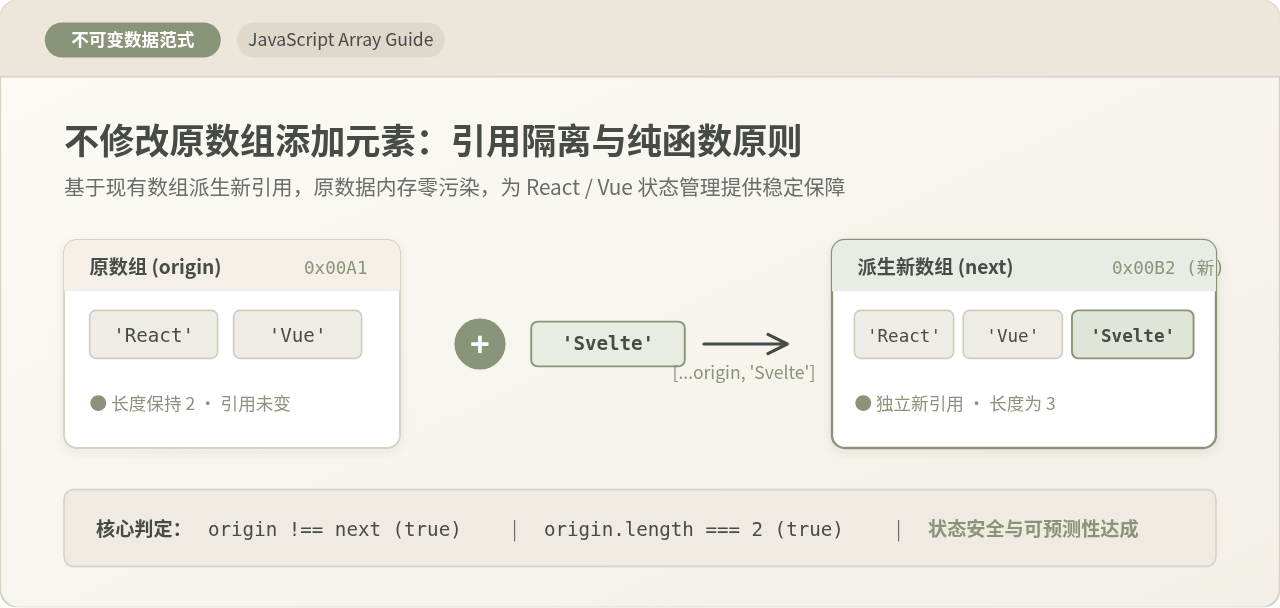
在 JavaScript 中,要在不修改原数组的前提下添加元素,核心原则是创建包含新元素的新数组引用,而不是调用像 push、unshift 或 splice 这类直接修改原数组内存地址的变异方法。现代 JavaScript 提供了三种最直接且实用的解决方案:使用扩展运算符 [...]、使用 concat() 方法,以及使用 ES2023 引入的 toSpliced() 方法。本文将围绕不同插入位置(末尾追加、头部插入、指定索引插入)展开具体实现,深入剖析引用内存模型,并解答浅拷贝机制下的常见开发陷阱。
一、为什么不能直接修改原数组?
在传统的 JavaScript 编程中,向数组末尾添加元素最直接的方式是调用 arr.push(item)。这种做法被称为“原位修改”(In-place Mutation)。然而,在现代前端开发体系中,这种习惯极易导致难以排查的状态异常和逻辑副作用。
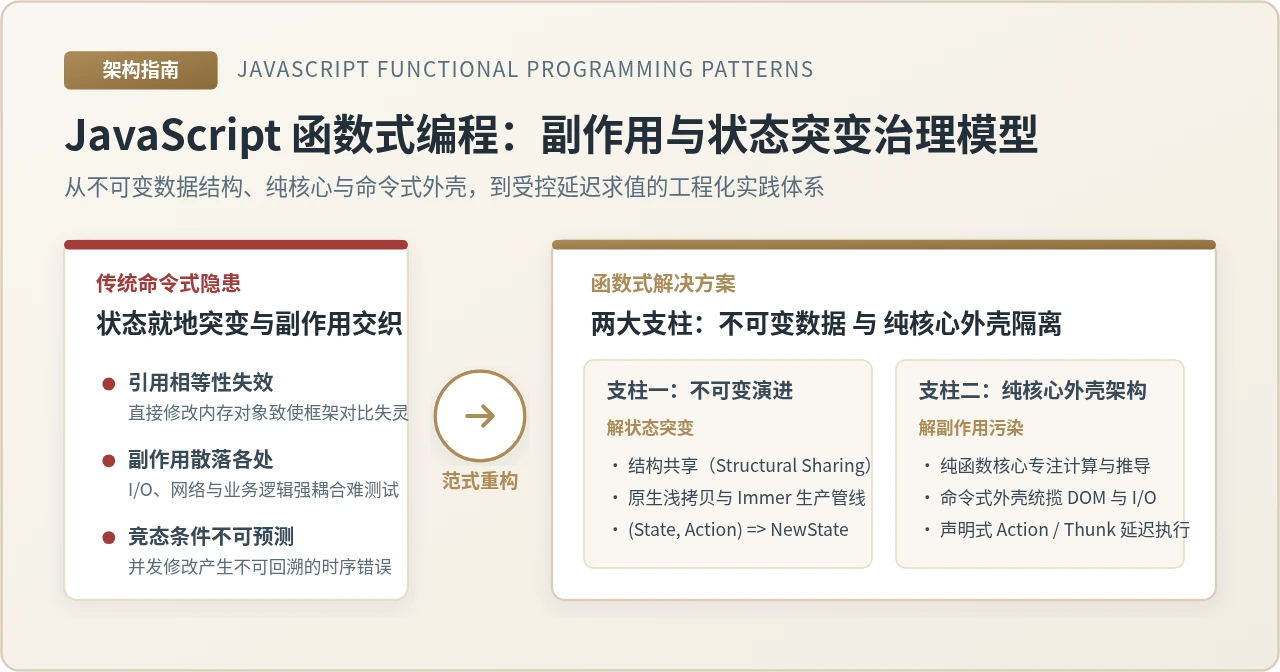
JavaScript 中的数组属于引用类型(Reference Type)。当变量保存一个数组时,它在栈内存中记录的实际上是堆内存中的物理存储地址。当一个函数接收数组作为参数,并执行了 arr.push() 时,所有持有该数组引用的上下文字段都会受到静默污染。更重要的是,在 React、Redux、Vue 3 等现代响应式体系中,状态更新依赖于浅比较(即比较引用地址 prev !== next)。如果原地修改数组,引用地址没有改变,框架将判定状态未发生变动,从而引发视图不更新或组件无法正常重绘的严重隐患。
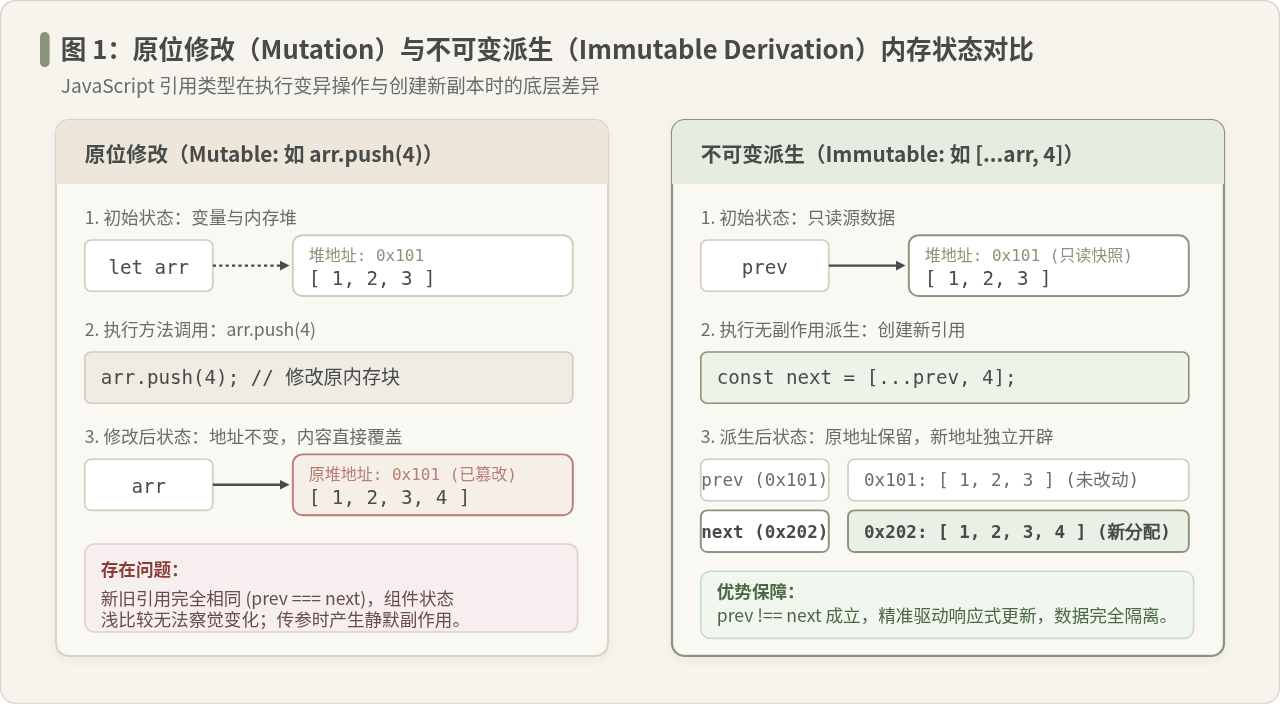
如上图所示,不可变操作并没有在旧地址上直接改写,而是开辟了一块全新的堆内存空间来存放派生后的完整数组。原始的 prev 引用保持完整,新变量 next 拥有独立的引用地址。这种机制确保了函数调用的纯粹性(Pure Function),天然支持时间旅行(Time-travel Debugging)与高效的变更侦测。
二、不同场景下的不可变添加操作
针对不同的业务诉求,添加元素的位置通常分为三种:末尾追加、开头插入以及任意指定索引位置插入。下面逐一介绍最实用的标准做法与对应的代码示例。
1. 在数组末尾追加元素(Append)
在末尾追加是日常开发中最频繁的需求。推荐首选 ES6 提供的扩展运算符(Spread Operator),语法简洁且语义直接:
// 原始数组保持不变
const origin = ['Apple', 'Banana'];

// 方案 A:扩展运算符(首选推荐)
const updatedWithSpread = [...origin, 'Cherry'];

// 方案 B:concat 方法
const updatedWithConcat = origin.concat('Cherry');

console.log(origin);            // 示例输出: ['Apple', 'Banana'](原数组未受影响)
console.log(updatedWithSpread); // 示例输出: ['Apple', 'Banana', 'Cherry']
console.log(origin === updatedWithSpread); // 示例输出: false(新引用诞生)机制解释:[...origin, 'Cherry'] 会依序解构 origin 的每个项并填入新创建的字面量数组中,最后放入新元素。而 concat() 是 ES5 时代就存在的原生无副作用方法,它的执行结果也是返回一个新数组。两者的核心区别在于:如果传入的参数本身是一个数组,concat() 会默认把该数组打平一层,而扩展运算符能明确控制是将整个数组作为子项添加,还是展开合并。
2. 在数组开头插入元素(Prepend)
如果希望在头部插入新项(替代破坏原数组的 unshift()),同样可以使用扩展运算符,只需调整书写顺序:
const tasks = ['写代码', '做代码审查'];

// 在头部插入新任务
const updatedTasks = ['站会汇报', ...tasks];

console.log(tasks);        // 示例输出: ['写代码', '做代码审查']
console.log(updatedTasks); // 示例输出: ['站会汇报', '写代码', '做代码审查']
3. 在指定索引位置插入元素(Insert at Index)
如果需要将元素插入数组中间的某个指定索引处,在过去通常容易误用 arr.splice(index, 0, newItem)。但 splice() 会直接篡改原数组。要实现不可变的任意位置插入,有两种规范做法:
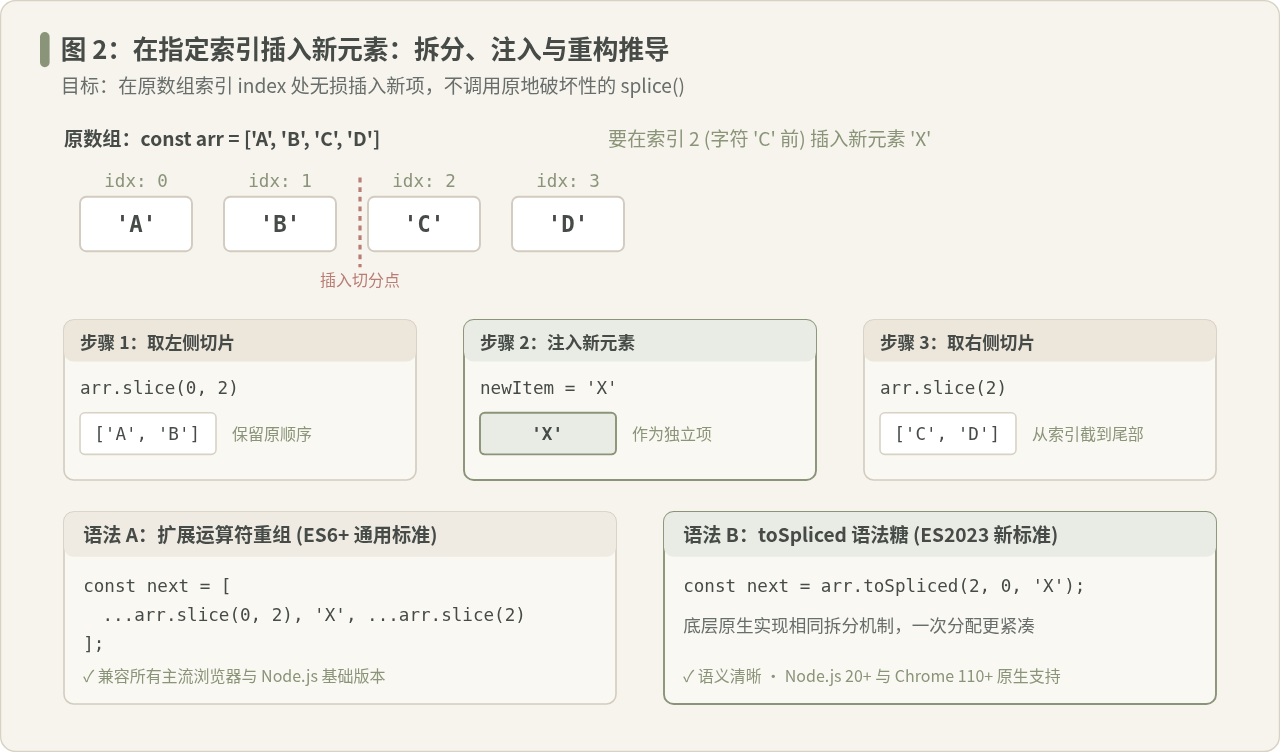
做法一:ES2023 新标准 toSpliced()
ECMAScript 2023 正式引入了 toSpliced() 方法。它与 splice() 的参数完全一致,但不会修改原数组,而是直接返回修改后的新副本:
const list = ['A', 'B', 'D'];
// 在索引 2 处插入 'C'(0 表示不删除任何元素)
const inserted = list.toSpliced(2, 0, 'C');

console.log(list);     // 示例输出: ['A', 'B', 'D']
console.log(inserted); // 示例输出: ['A', 'B', 'C', 'D']
做法二:基于 slice() 与扩展运算符的经典组合(兼容全环境)
如果项目的运行环境较老且未引入 ES2023 Polyfill,可以通过 slice() 将原数组沿目标索引切分为前后两段,再通过展开运算符完成粘合拼接:
function insertAt(arr, index, newItem) {
  return [
    ...arr.slice(0, index),
    newItem,
    ...arr.slice(index)
  ];
}

const originalList = ['Vue', 'React', 'Angular'];
const nextList = insertAt(originalList, 1, 'Svelte');

console.log(originalList); // 示例输出: ['Vue', 'React', 'Angular']
console.log(nextList);     // 示例输出: ['Vue', 'Svelte', 'React', 'Angular']
4. 批量添加多个元素
当需要一次性追加或插入一组元素时,直接扩展待添加的数组即可:
const base = [1, 2];
const batch = [3, 4, 5];

// 批量合并至末尾
const mergedEnd = [...base, ...batch]; // 结果: [1, 2, 3, 4, 5]

// 批量在索引 1 处插入
const mergedMiddle = base.toSpliced(1, 0, ...batch); // 结果: [1, 3, 4, 5, 2]
三、容易混淆的认知误区与避坑指南
在践行不可变数据的过程中,很多初学者容易被 JavaScript 的语法特性误导。下面对三个最具代表性的误区进行辨析。
误区一:使用 const 声明的数组就是“不可变”的
分析:这是一种常见的认知偏差。const 关键字锁定的仅仅是变量在栈内存中的引用绑定,防止变量被重新赋值指向另一个地址,但它完全不限制引用对象内部属性的更改。因此,即使声明为 const arr = [],执行 arr.push(1) 仍然畅通无阻,并且原数组确实被修改了。
认知校正:const 阻止的是变量重新赋值(如 arr = [1] 会报错),不可变数据指的是“数据结构内部状态不发生原地变异”。两者处于不同的维度,实现不可变性必须依靠编写无副作用的派生逻辑,或者使用 Object.freeze() 进行运行期浅冻结。
误区二:扩展运算符复制是“深拷贝”,可以任意修改元素
许多开发者知道扩展运算符 [...] 能够生成新数组,就误以为整个数组已经被完整深拷贝,进而随手修改内部元素的属性。这是一个严重的陷阱。
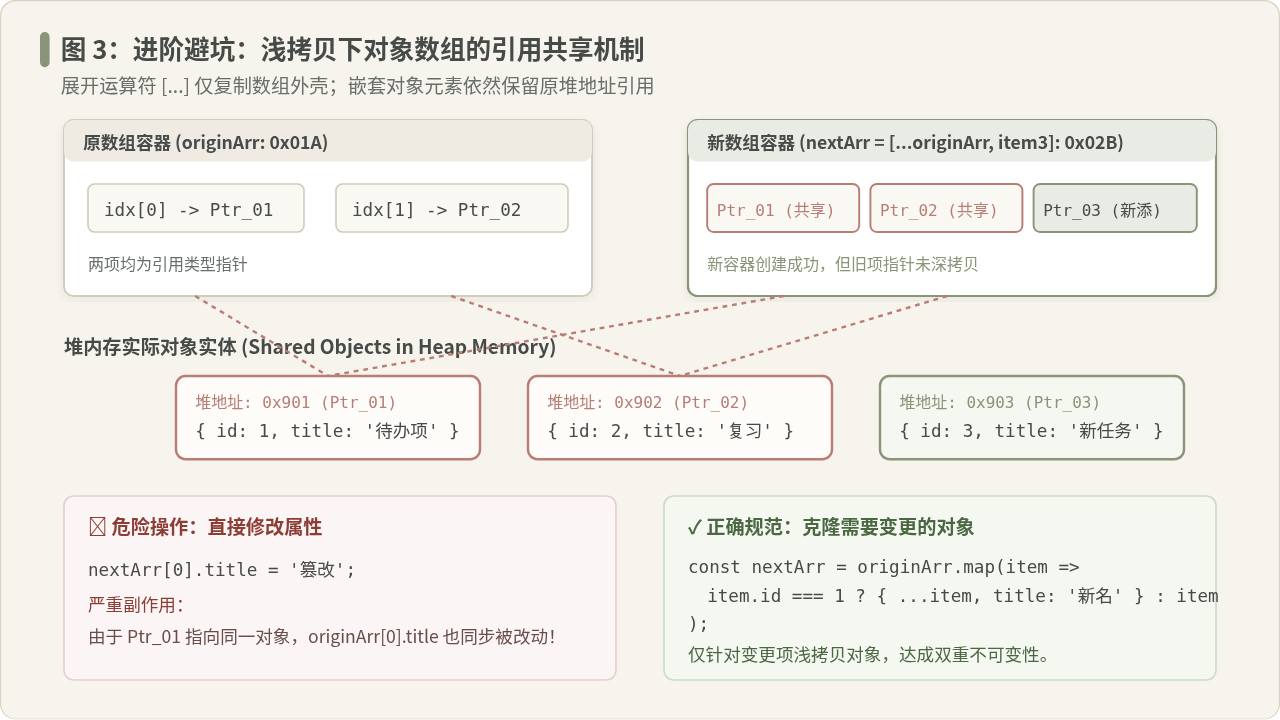
陷阱演示:
const users = [
  { id: 1, name: '张三' },
  { id: 2, name: '李四' }
];

// 不可变添加新用户
const nextUsers = [...users, { id: 3, name: '王五' }];

// 错误操作:直接修改现有成员的属性
nextUsers[0].name = '张三丰';

// 此时原数组同样受到了破坏!
console.log(users[0].name); // 示例输出: '张三丰'底层原因与正确解法:扩展运算符只复制了数组这层“外壳容器”(浅拷贝)。如果数组中的项是基本数据类型(如数字、字符串),它们的值会被独立拷贝;但如果项是对象,新数组存放的依然是原对象的堆内存指针。如果业务要求在更新某个项属性的同时保持不可变性,必须针对该项使用对象展开操作:
// 安全做法:结合 map 对目标对象进行局部浅拷贝
const safeUsers = users.map(user =>
  user.id === 1 ? { ...user, name: '张三丰' } : user
);
误区三:每次添加都新建数组会导致严重性能瓶颈
有些开发者担心:频繁创建新数组会导致大量的内存分配和垃圾回收(GC),是不是应该为了性能尽量使用 push?
实测与权衡:在现代 V8 等 JavaScript 引擎中,针对几十到数千项的一般业务数组,连续内存的分配与浅层拷贝开销在微秒级别(通常小于 0.05ms),对于日常 Web 应用和用户交互几乎完全不可感知。相比微弱的执行耗时,不可变数据带来的收益显著得多:
- 避免不可预测的数据污染:杜绝了多个模块间相互影响产生的隐蔽 Bug。
- 极大提升视图框架性能:React 等框架无需进行 $O(N)$ 复杂度的深度对比,仅凭
O(1)的引用比较即可精准判断是否需要跳过渲染。
当然,如果确实存在超大规模数据(例如十万级点阵数据或高频音视频流),频繁拷贝确实会带来 GC 压力。此场景下可以考虑在局部受限的作用域内进行批处理修改,或引入结构共享(Structural Sharing)库(如 Immutable.js 或 Immer)。
四、方案对比与选型指南
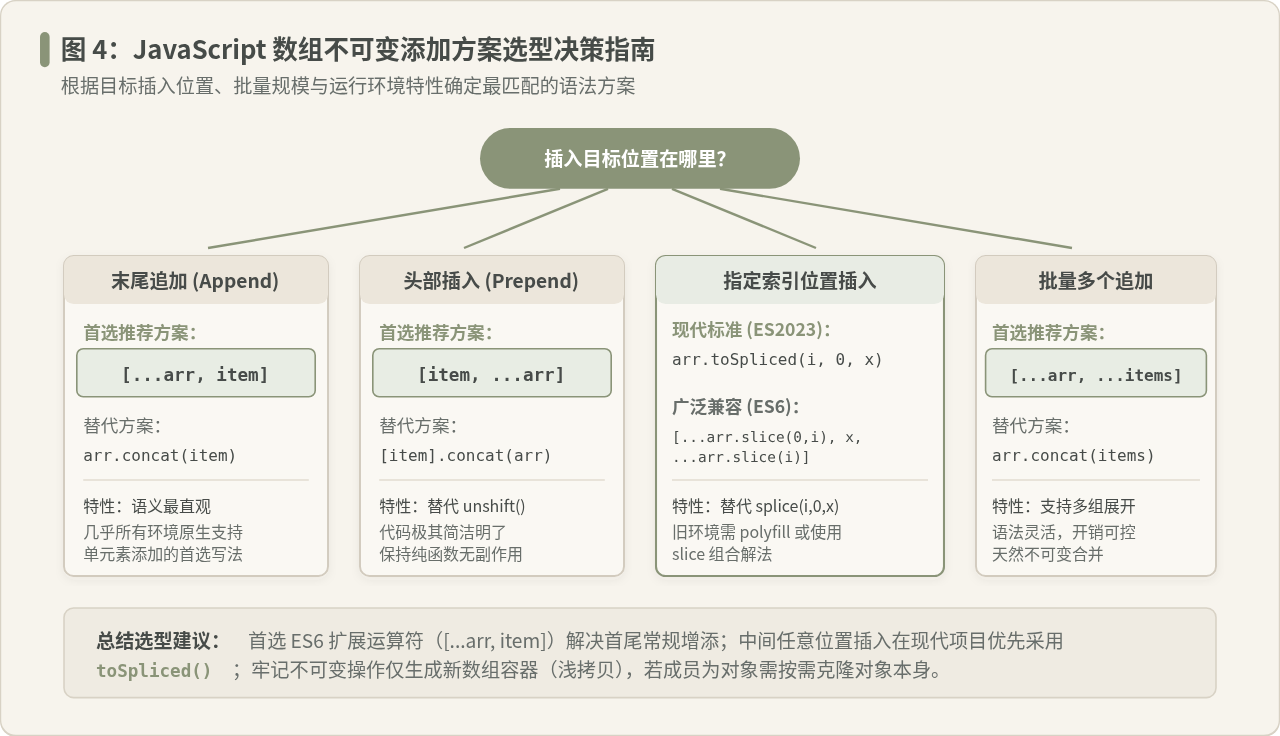
综合各种不可变添加手段,下表总结了各主流方案的特性与适用场景:
| 方法 / 语法 | 插入位置 | 环境要求 | 语法简洁度 | 主要适用场景 |
|---|---|---|---|---|
[...arr, item] |
末尾追加 | ES6+ (所有主流环境) | ★★★★★ | 单项追加与批量合并的首选日常写法 |
[item, ...arr] |
头部插入 | ES6+ (所有主流环境) | ★★★★★ | 替代 unshift(),新数据置顶展示 |
arr.toSpliced(i, 0, item) |
任意指定索引 | ES2023+ (Node 20+, Chrome 110+) | ★★★★☆ | 现代项目中间插入,替代变异的 splice() |
[...slice(0,i), item, ...slice(i)] |
任意指定索引 | ES6+ (所有主流环境) | ★★★☆☆ | 旧项目或无 Polyfill 环境下的通用保底方案 |
arr.concat(item) |
末尾追加 | ES5+ (全平台全版本) | ★★★☆☆ | 需要函数式链式调用或处理老代码维护 |
五、总结
在 JavaScript 中实践不可变数组操作并不复杂,核心在于从思维层面告别破坏性的变异方法:
- 常规末尾追加与开头插入:直接采用 ES6 扩展运算符
[...arr, item]与[item, ...arr],简洁优雅且可读性极高。 - 任意索引位置插入:在新环境中果断采用 ES2023 的原生
toSpliced(),在旧环境中采用slice()拆分重组。 - 牢记浅拷贝边界:若数组内包含对象,记住新数组中对象引用仍然共享。对深层对象的变更必须配合对象解构
{ ...item }才能真正实现全局数据的纯粹与不可变。
纯前端 JavaScript 能实现局域网聊天吗?WebRTC P2P 方案解析
2026-11-12 20:29:12
JavaScript Math.round() 四舍五入取整用法详解
2026-11-12 20:08:37
JS稀疏数组中length与实际元素数量的关系
2026-11-12 19:41:49
JS格式化输出报错:怎么处理循环引用和BigInt类型数据
2026-11-12 18:05:51
React函数组件和class组件语法有什么区别?
2026-11-12 18:01:49