JavaScript 函数式编程怎么处理副作用与状态突变
深入解析 JavaScript 函数式编程如何通过不可变数据结构、结构共享、纯函数核心与命令式外壳隔离以及延迟求值等工程化策略,彻底解决副作用与状态突变带来的系统隐患。
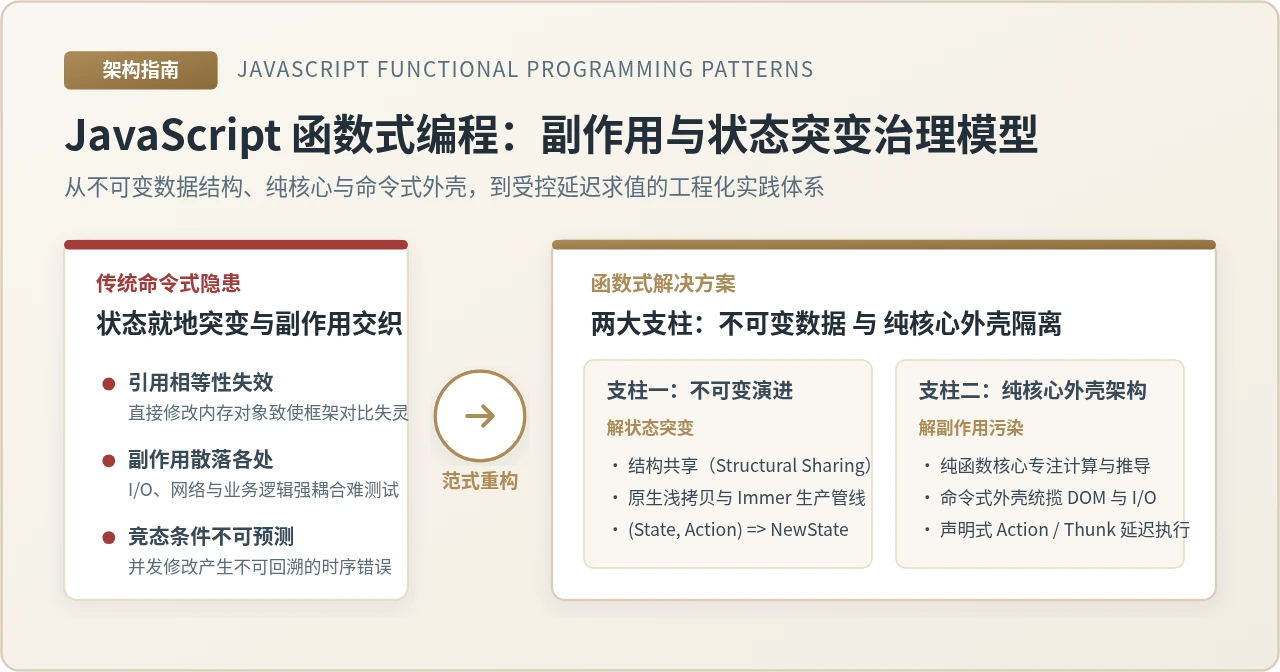
在 JavaScript 中实践函数式编程,处理副作用与状态突变的核心路径可以归纳为两套明确的工程方法:面对状态突变,采用“不可变数据(Immutability)与结构共享(Structural Sharing)”替代内存就地修改,确保数据流向明确且引用比对可预测;面对不可避免的副作用,采用“纯函数核心与命令式外壳(Functional Core, Imperative Shell)”架构模式,将业务决策与外界 I/O 彻底隔离,并通过延迟求值(Lazy Evaluation)实现按需受控调度。
一、认识根本症结:为什么副作用与状态突变会破坏代码
函数式编程(Functional Programming, FP)的理想模型建立在纯函数(Pure Function)的基石之上。一个真正的纯函数必须满足两个严格条件:第一,输入确定则输出确定(引用透明性,Referential Transparency);第二,执行过程绝不改变外部世界的任何状态(零副作用,No Side Effects)。
然而在日常的 JavaScript 开发中,无论浏览器端还是 Node.js 环境,我们面对的现实天然充满了不确定性。理解函数式编程的解法,必须先准确定义这两大痛点的具体表现:
- 状态突变(State Mutation):指直接修改已有对象或数组在内存堆中的内部属性。例如通过
user.age = 28、cart.items.push(item)或list.sort()直接篡改原数据。在 JavaScript 共享引用的机制下,所有持有该引用的代码模块都会在毫无感知的情况下受到牵连。 - 副作用(Side Effects):指函数在执行计算并返回结果的过程中,与函数外部环境发生的任何交互。这包括但不限于:触发 HTTP 网络请求、读写 DOM、写入
localStorage/ Cookie、向控制台输出日志、修改外部作用域变量,以及调用Date.now()、Math.random()等具有时间或不确定性依赖的系统接口。
如果任由状态突变与副作用在代码中任意蔓延,系统将迅速面临三个灾难性的后果:
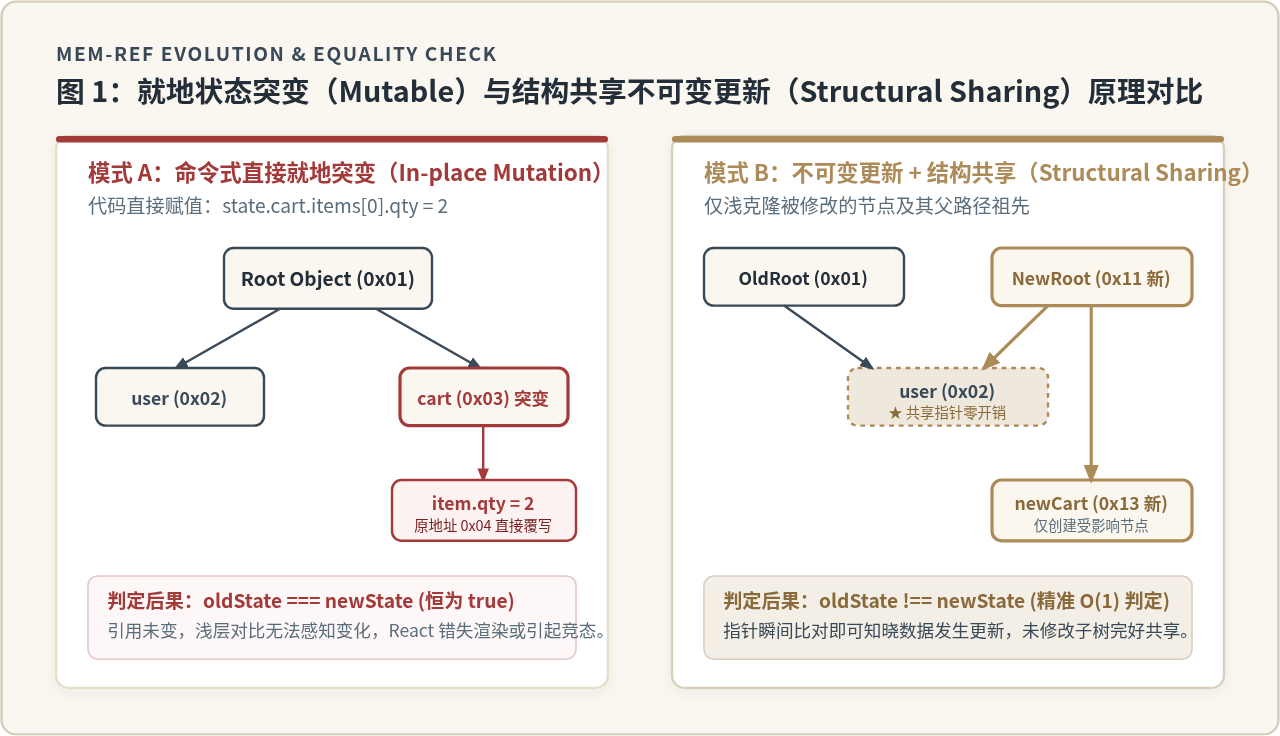
- 引用相等性检查失效:React、Vue 等现代视图库以及状态管理工具高度依赖浅层比对(
prevProps !== nextProps或oldState !== newState)来判断是否需要更新视图。如果原地突变对象属性,新旧指针完全相同,组件将无法感知变更导致视图白屏或错乱。 - 跨模块隐式依赖与竞态条件:当函数 A 将对象作为参数传递给函数 B,而函数 B 顺手修改了该对象的某个字段,函数 A 后续的逻辑就会在毫不知情的情况下产生难以重现的幽灵 Bug。
- 测试与回溯成本极高:包含隐形副作用的函数无法独立脱离浏览器或数据库运行,单元测试必须 mock 大量全局环境变量,撤销(Undo)、重做(Redo)以及时间旅行调试更是无从谈起。
二、应对状态突变:不可变数据与结构共享实操
函数式编程解决状态突变的基本法则非常直接:绝不修改已有数据,每次变更都生成一份具有新引用的数据副本。但在实际工程中,粗暴的全量深拷贝(如 structuredClone 或 JSON.parse(JSON.stringify))会带来巨大的内存开销并丢失对象原型与引用关系。现代 JavaScript 通过“不可变操作”与“结构共享”完美化解了性能与安全性的矛盾。
1. 原生语法层面的不可变更新实践
在浅层数据结构中,优先使用 ES6+ 提供的展开运算符(Spread Operator)与原生无副作用数组方法完成更新,杜绝修改原数组的变异操作:
// 1. 对象属性不可变更新
const prevUser = { id: 101, name: "Alice", score: 85 };
// 正确:生成新对象,覆盖指定属性
const updatedUser = { ...prevUser, score: 95 };
console.log(prevUser.score); // 依然为 85,原状态保持纯净
console.log(prevUser !== updatedUser); // true,引用发生变更,精准响应更新

// 2. 数组的添加、过滤与修改(替代 push、splice)
const list = [1, 2, 3];
// 新增项(替代 list.push(4))
const addedList = [...list, 4];
// 删除项(替代 list.splice(index, 1))
const filteredList = list.filter(item => item !== 2);
// 替换项(替代 list[0] = 99)
const mappedList = list.map(item => item === 1 ? 99 : item);

// 3. 警惕数组的隐蔽就地变异方法:sort、reverse
const numbers = [3, 1, 4, 1, 5];
// 错误:numbers.sort() 会直接破坏原始数组
// 正确(传统做法):先做一层浅拷贝再排序
const sorted1 = [...numbers].sort((a, b) => a - b);
// 正确(现代 ES2023 规范):使用原生不可变排序方法
const sorted2 = numbers.toSorted((a, b) => a - b);
const reversed = numbers.toReversed();展开运算符 { ...obj } 仅复制对象的第一层属性。如果属性值是另一个嵌套对象(例如 user.profile.address),两份数据依然指向同一个子对象内存地址。直接修改 updatedUser.profile.city = 'Beijing' 依然会破坏 prevUser。对于深层嵌套结构,必须采取多层解构或下文介绍的结构共享方案。
2. 深层嵌套更新与 Immer 结构共享
面对深层嵌套的复杂状态树,手工编写多层展开运算符不仅语法冗长极其容易漏写,还会增加维护负担。以 Immer 为代表的现代工具库利用 ES6 Proxy 实现了写时复制(Copy-on-write)与结构共享:开发者可以用最直观的命令式赋值语法修改草稿(Draft),底层则自动拦截变更,仅克隆被修改的节点及其沿途祖先,其他未变动分支原封不动地复用旧指针。
import { produce } from "immer";

const storeState = {
  user: { id: 1, name: "Bob" },
  catalog: {
    categories: ["Tech", "Book"],
    products: [
      { id: "p1", title: "FP in JS", price: 68, stock: 12 },
      { id: "p2", title: "React Guide", price: 88, stock: 5 }
    ]
  }
};

// 使用 Immer 进行精确更新:语法直观、天然不可变、结构共享
const nextStoreState = produce(storeState, draft => {
  draft.catalog.products[0].stock -= 1;
});

// 验证结果与引用共享
console.log(nextStoreState.catalog.products[0].stock); // 11
console.log(storeState.catalog.products[0].stock);     // 12 (旧状态安全未动)

// 关键验证:结构共享特性
console.log(storeState !== nextStoreState);                        // true (根对象已变更)
console.log(storeState.catalog !== nextStoreState.catalog);        // true (父路径被克隆)
console.log(storeState.user === nextStoreState.user);              // true (未变分支严格复用指针,零额外内存)
console.log(storeState.catalog.products[1] === nextStoreState.catalog.products[1]); // true (未改动商品指针复用)
3. 状态机的形式化收敛:Reducer 纯状态归约
为了防止状态修改散落在各个事件回调中,函数式编程将所有状态变化抽象为一个数学归约过程:
(currentState, action) => nextState所有的变更意图都被定义为纯数据对象(Action),而 Reducer 是一个 100% 纯函数。无论何时调用,给它相同的当前状态与动作,产出的新状态永远完全相同:
// 购物车 Reducer:纯函数处理状态演进
function cartReducer(state, action) {
  switch (action.type) {
    case "ITEM_ADDED": {
      const existingIndex = state.items.findIndex(i => i.id === action.payload.id);
      if (existingIndex >= 0) {
        // 商品已存在,更新数量
        const nextItems = state.items.map((item, idx) =>
          idx === existingIndex ? { ...item, qty: item.qty + action.payload.qty } : item
        );
        return { ...state, items: nextItems };
      }
      // 新增商品
      return { ...state, items: [...state.items, action.payload] };
    }
    case "ITEM_REMOVED":
      return {
        ...state,
        items: state.items.filter(i => i.id !== action.payload.id)
      };
    default:
      return state;
  }
}
三、治理副作用:纯函数核心与命令式外壳架构
真实世界不可能没有副作用——若一个应用既不发网络请求、不更新屏幕、也不把数据持久化到磁盘,它就无法对现实产生任何价值。函数式编程的目的不是消灭副作用,而是将副作用与核心业务逻辑坚决隔离。
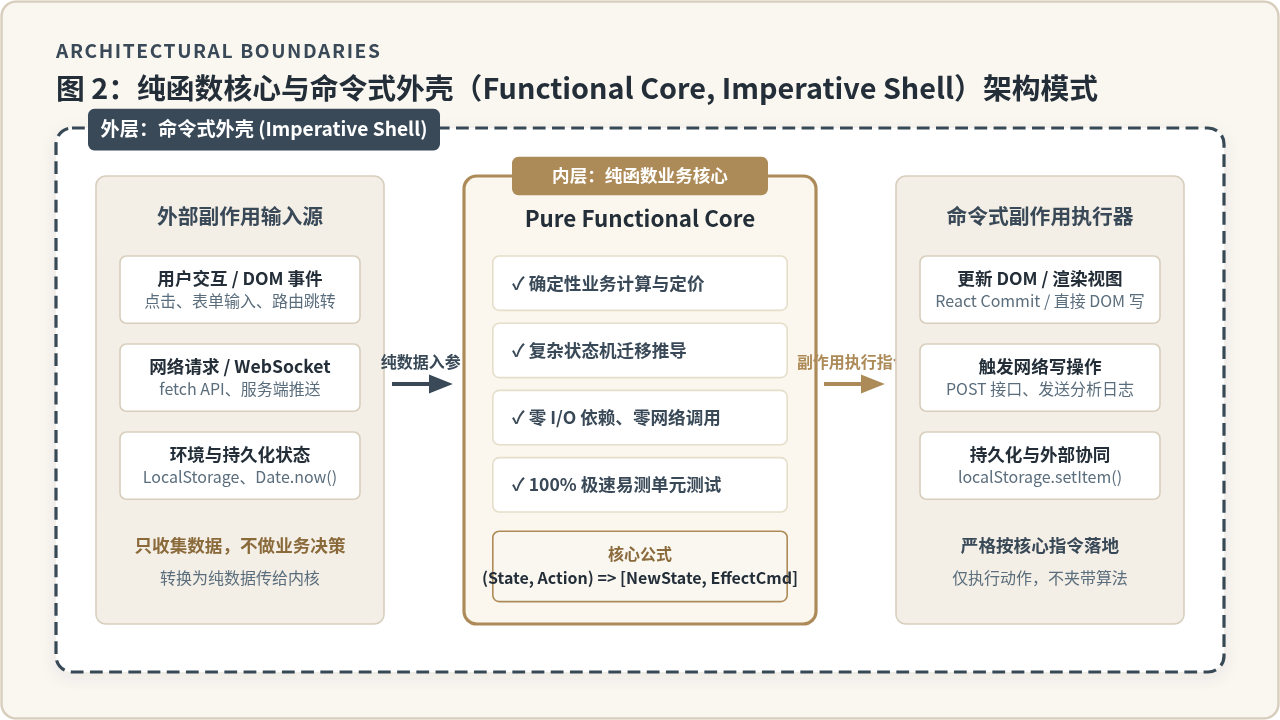
在架构设计上,最成熟且易落地的模式正是“纯函数核心与命令式外壳(Functional Core, Imperative Shell)”。
1. 职责切分与设计原则
该模式将整个软件划分为内外两个泾渭分明的圈层:
- 内圈:纯函数核心(Functional Core):包含应用的核心计算、规则推导、校验逻辑和状态转移。这一层严禁依赖任何外部环境,没有异步
fetch、没有window/document,甚至没有Date.now()。它只接收纯数据输入,返回纯数据计算结果或动作意图。正因其绝对的纯净,这一层的单元测试不需要任何 mock,运行速度极快且极其稳定。 - 外圈:命令式外壳(Imperative Shell):负责与不可预测的外部世界打交道。外壳负责捕获用户交互事件、发起 HTTP 请求、读取 Storage、等待定时器响应。拿到外部数据后,将其规范化并传递给核心函数进行运算;拿到核心函数返回的计算结果或执行指令后,再由外壳统一落地执行具体的 DOM 渲染或写存储操作。
2. 代码重构演练:从混乱交织到核心外壳解耦
以下通过一个电商结算业务,展示如何把交织在一起的副作用与业务计算拆开:
// ---------------- 改造前:副作用与计算混合(难以测试,行为脆弱) ----------------
async function handleCheckoutLegacy(cartItems, couponCode) {
  // 隐形副作用 1:直接读 DOM 或 LocalStorage
  const token = localStorage.getItem("auth_token");
  // 隐形副作用 2:非确定性环境调用
  const now = new Date();

  // 核心业务计算混在中间
  let discount = 0;
  if (couponCode === "SAVE10" && now.getDay() !== 0) {
    discount = 0.1;
  }
  const subtotal = cartItems.reduce((acc, cur) => acc + cur.price * cur.qty, 0);
  const total = subtotal * (1 - discount);

  // 隐形副作用 3:网络 I/O 与 DOM 修改
  const response = await fetch("/api/checkout", {
    method: "POST",
    headers: { Authorization: token, "Content-Type": "application/json" },
    body: JSON.stringify({ items: cartItems, total })
  });
  document.getElementById("status").innerText = "Order Placed: " + total;
}

// ---------------- 改造后:纯函数核心 + 命令式外壳 ----------------

// [纯核心]:只接受数据输入,完成计算与验证,输出纯结果(零 I/O,极易单测)
function calculateCheckout(cartItems, couponCode, currentTime) {
  const isWeekend = currentTime.getDay() === 0 || currentTime.getDay() === 6;
  const isCouponValid = couponCode === "SAVE10" && !isWeekend;
  const discountRate = isCouponValid ? 0.1 : 0;

  const subtotal = cartItems.reduce((acc, cur) => acc + cur.price * cur.qty, 0);
  const total = Math.max(0, subtotal * (1 - discountRate));

  return {
    subtotal,
    discountRate,
    total,
    payload: { items: cartItems, total }
  };
}

// [命令式外壳]:负责收集环境、调用核心、落地副作用
async function handleCheckoutShell(cartItems, couponCode, deps = { storage: localStorage, httpClient: fetch }) {
  try {
    // 1. 抓取外部易变环境数据
    const token = deps.storage.getItem("auth_token");
    const currentTime = new Date();

    // 2. 调用纯核心计算
    const summary = calculateCheckout(cartItems, couponCode, currentTime);

    // 3. 执行外部副作用通信
    const res = await deps.httpClient("/api/checkout", {
      method: "POST",
      headers: { Authorization: token, "Content-Type": "application/json" },
      body: JSON.stringify(summary.payload)
    });

    // 4. 反馈结果至界面
    return { success: true, total: summary.total };
  } catch (err) {
    return { success: false, error: err.message };
  }
}
四、进阶模式:推迟求值与依赖注入工程四步法
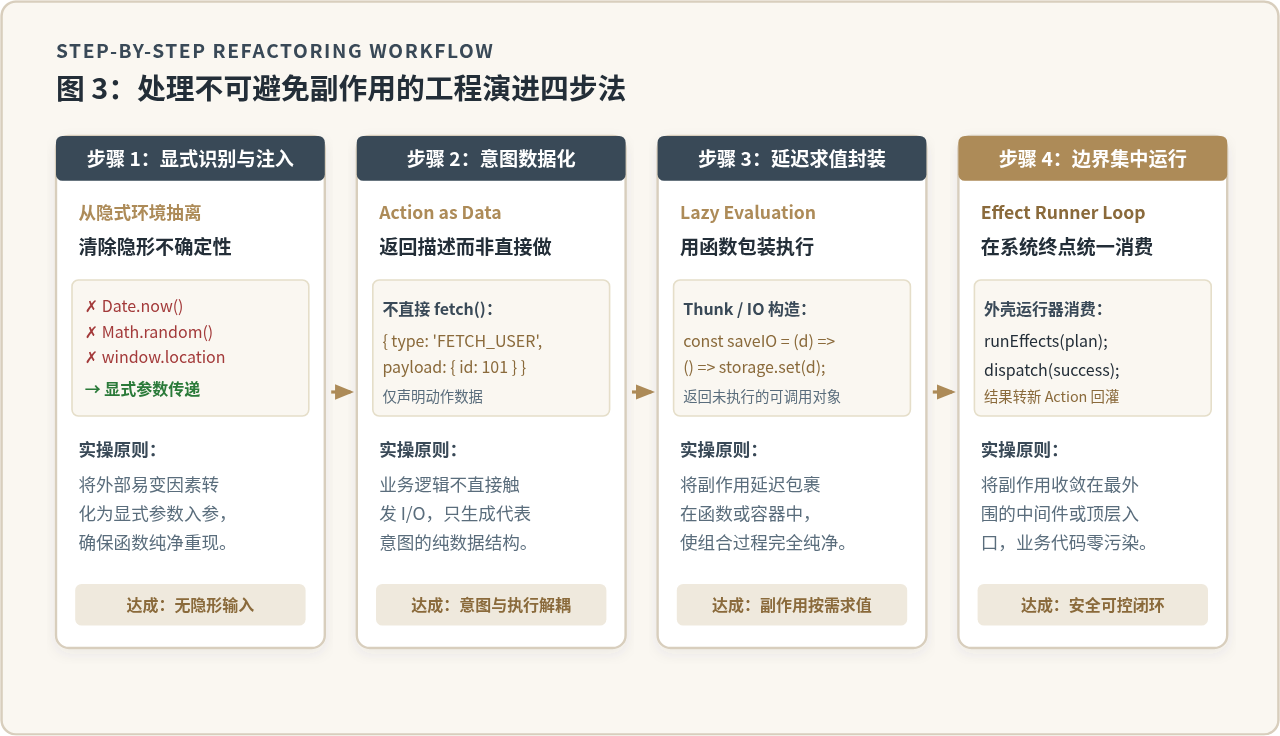
除了宏观的架构分层,在具体的模块编码时,处理难以避免的副作用还有一套标准递进式的工程演进步骤:
步骤 1:显式识别与依赖注入(Dependency Injection)
当一个函数内部不得不使用外部环境时,第一步是拒绝隐式全局引用,将其提取为显式参数。例如不要在函数内部写 Date.now() 或直接引用全局 window.navigator,而是将其通过函数参数或者依赖配置对象传入。在测试环境中,只需传入固定时间参数或 mock 对象,即可实现完全确定的测试断言。
步骤 2:意图数据化(Action as Data)
函数式编程倡导“用数据描述意图,而非直接执行动作”。业务函数不再直接调用 db.save(),而是返回一个结构清晰的指令对象(例如 { effect: 'SAVE_RECORD', target: 'users', data: ... })。在 Elm 架构、Redux-Saga 及各类 Command 模式中,整个系统由纯函数驱动生成指令流,调度系统在接收到纯数据描述后再行指派驱动器执行。
步骤 3:延迟求值封装(Lazy Evaluation / Thunk 容器)
在必须组合多个含副作用动作时,利用高阶函数将动作包裹在“待执行函数”(Thunk)或函数式 IO Monad 容器中。函数定义本身是 100% 纯的,它仅仅构建了一张“执行计划图”,直到最后一步被显式调用前,没有任何副作用发生:
// 纯函数构造器:返回一个封装了副作用的闭包(Thunk),不立刻执行
const createLogIO = (message) => () => {
  console.log(`[${new Date().toISOString()}] ${message}`);
};

const createWriteStorageIO = (key, value) => () => {
  localStorage.setItem(key, JSON.stringify(value));
};

// 纯函数组合器:将多个副作用计划无缝组合为单一计划
const combineEffects = (...effects) => () => {
  for (const eff of effects) {
    eff(); // 顺序执行每个延迟动作
  }
};

// 业务流程:仅组装计划,此时没有任何 I/O 发生
const executionPlan = combineEffects(
  createLogIO("正在同步用户数据..."),
  createWriteStorageIO("last_synced_user", { id: 101, name: "Alice" }),
  createLogIO("同步完成")
);

// 最终阶段(外壳边界):统一触发执行
executionPlan();
步骤 4:外壳集中运行器(Effect Runner Loop)
在系统的顶层边界(如前端框架的根组件挂载、Redux 中间件管道或 Node.js API 路由处理器中)集中设置执行循环。所有由内层核心抛出的意图对象,都在这里统一被分派执行,并将异步执行结果以新 Action 的形式回灌给核心状态机,形成可观测、可记录的闭环系统。
五、方案选型矩阵与核心避坑清单
为了在实际团队开发中根据具体场景做出明智的技术选型,下表对各类主流状态突变防范与副作用治理策略进行了多维对比:
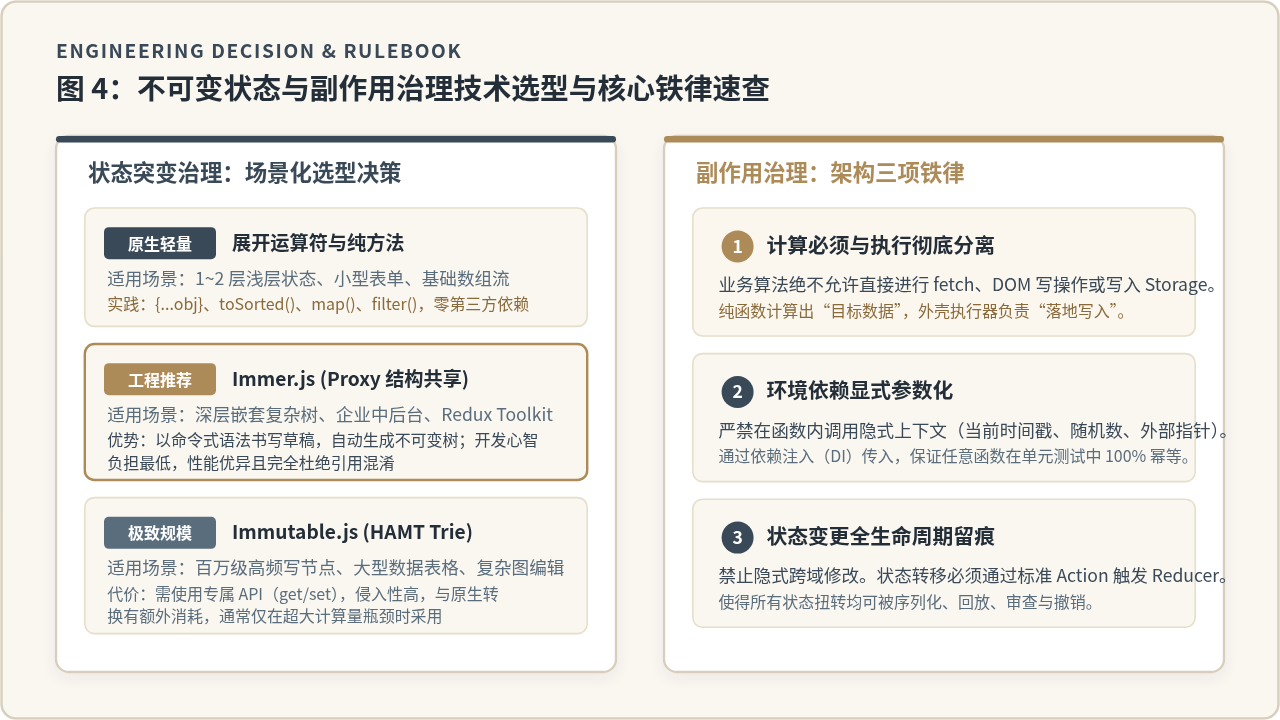
| 方案分类 | 代表技术 / 语法 | 核心机制与优势 | 心智负担与代价 | 推荐适用场景 |
|---|---|---|---|---|
| 原生不可变 | 展开运算符 ...、toSorted、filter |
零依赖,语法原生支持,浅层更新性能极高。 | 深层嵌套书写繁琐;容易误用变异方法(如 splice)。 |
扁平状态结构、小型工具函数、轻量页面组件。 |
| Proxy 结构共享 | Immer.js (produce) |
保留命令式赋值习惯,自动结构共享与写时复制。 | 引入微量运行时代理开销(现代 V8 引擎下已可忽略)。 | 复杂中后台业务、深度嵌套树、Redux Toolkit 项目首选。 |
| 持久化 Trie 树 | Immutable.js (Map, List) |
基于位分区字典树(HAMT),超大集合极致性能。 | 需使用专有 API(.get()/.set()),与原生 JS 交互需频繁转换。 |
百万级数据交互、复杂图形编辑器、高频数据流计算。 |
| 架构分层隔离 | 纯函数核心 + 命令式外壳 | 无需外部库,结构清晰,核心逻辑 100% 可测。 | 前期需要良好的代码模块划分与职责梳理意识。 | 绝大部分前端 Web 应用与 Node.js 核心后端领域模型。 |
必须规避的典型误区
- 误区一:“伪函数式”变异:在
forEach或map的回调中顺手修改外部变量或原数组项(如list.map(item => { item.active = true; return item; }))。这只是披着函数式 API 外衣的命令式突变,彻底背离了不可变原则。正确写法必须返回新对象:list.map(item => ({ ...item, active: true }))。 - 误区二:盲目全量深拷贝:在每一次微小更新时都调用
structuredClone()或JSON.parse(JSON.stringify())。这不仅会直接丢弃函数、Symbol、Date 实例,而且彻底击穿了 React 等框架基于指针地址复用的“结构共享”优化机制,导致整棵虚拟 DOM 树无谓全量重渲染。 - 误区三:过度形式主义:在业务规模尚小、逻辑扁平的场景下,生搬硬套复杂的 Haskell 风格 Monad 抽象容器,将简单的数据赋值封装成晦涩的三层函数柯里化。在工程落地中,优先采用“原生展开 + Immer + 核心外壳分层”往往能够以最低的心智成本换取最大的可靠性收益。
六、总结
JavaScript 函数式编程处理副作用与状态突变的哲学,从来不是不切实际地构建一个无菌的“纯理论温室”,而是为不可避免的变化与外界交互建立清晰严密的边界。
通过“结构共享”的不可变数据范式,我们在内存层面杜绝了共享变量就地修改的幽灵影响,让组件渲染与状态比较变得精准高效;通过“纯函数核心与命令式外壳”架构,我们将不确定的 I/O 和环境依赖推向系统边缘,把关键业务规则收拢在可推导、可断言、易测试的纯函数内部。掌握这两大原则并辅以工程化工具,就能在保持 JavaScript 灵活性的同时,编写出具备高度确定性、健壮且易于长期维护的大型应用。
JS动态构建复杂嵌套JSON对象的方法
2026-11-05 15:41:52
JS负数取余为什么是负数?详解余数与模运算区别
2026-11-05 13:34:41
JS 解压出现乱码或报错怎么解决?
2026-11-05 12:32:38
JS 中 startsWith、indexOf 与正则判断字符串前缀的对比
2026-11-04 22:19:43
JS解析Excel后怎么将数据转换为JSON格式
2026-11-04 20:58:28