JS稀疏数组中length与实际元素数量的关系
深入解析JavaScript稀疏数组中length属性与实际元素数量的本质关系,阐释空洞(hole)的内存表现、形成原因、统计方法以及主流遍历API的差异化行为。
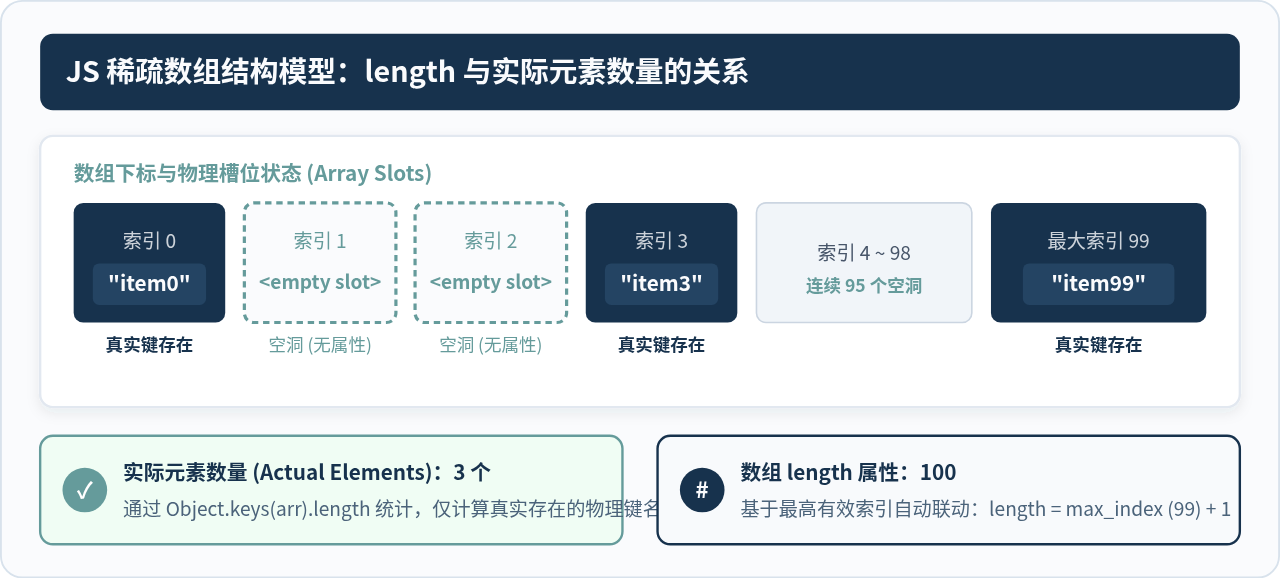
length 属性并不代表数组中实际存储的物理元素个数,而是始终等于最高数值索引加一(max_index + 1)或人为指定的无符号 32 位整型数值。当数组中出现未分配物理键名的“空洞(Hole / Empty Slot)”时,该数组即成为稀疏数组(Sparse Array)。在稀疏数组中,length 属性的数值严格大于数组中实际包含的键值元素总数。
一、什么是稀疏数组与“空洞(Hole)”
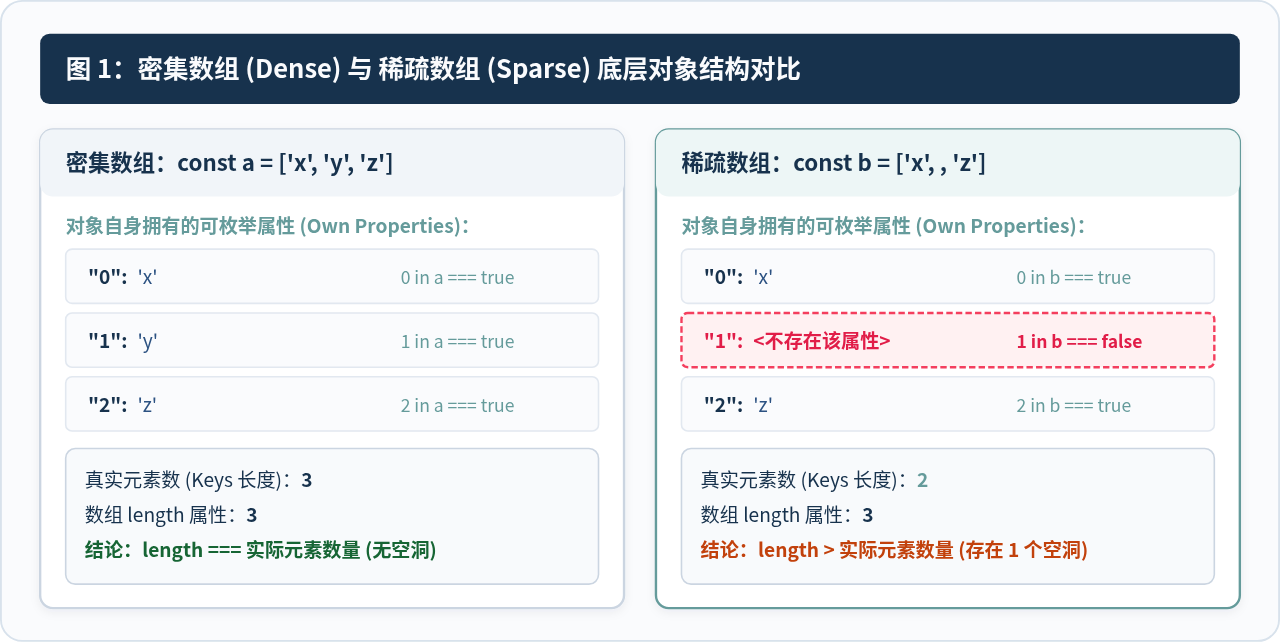
日常编写 JavaScript 代码时,我们接触的大多数数组是连续分配的密集数组(Dense Array)。例如 ['a', 'b', 'c'],索引 0、1、2 上都实际存放了对应的值。但当数组中某些索引位置根本没有被初始化,或者被显式删除时,这些位置就会变成“空洞(Hole)”。包含空洞的数组被称为稀疏数组(Sparse Array)。
很多初学者容易将“空洞”与“值为 undefined 的元素”混为一谈。从 JavaScript 底层对象的角度来看,二者存在本质区别:
- 值为
undefined的槽位:该对象具有该数值属性键,属性描述符真实存在,只是该属性绑定的值为undefined。 - 空洞(Empty Slot):该对象上根本不存在该数字属性键,通过
in操作符或hasOwnProperty查询会直接返回false。
// 构造一个包含 1 个空洞的稀疏数组,以及一个显式包含 undefined 的密集数组
const sparseArr = [1, , 3];
const denseArr = [1, undefined, 3];

console.log("sparseArr 长度:", sparseArr.length);
console.log("denseArr 长度:", denseArr.length);

// 使用 in 操作符检查属性键 "1" 是否存在
console.log("索引 1 是否存在于 sparseArr:", 1 in sparseArr);
console.log("索引 1 是否存在于 denseArr:", 1 in denseArr);

// 使用 Object.hasOwn 验证自有属性
console.log("sparseArr 是否拥有自有属性 1:", Object.hasOwn(sparseArr, 1));
console.log("denseArr 是否拥有自有属性 1:", Object.hasOwn(denseArr, 1));denseArr 长度: 3
索引 1 是否存在于 sparseArr: false
索引 1 是否存在于 denseArr: true
sparseArr 是否拥有自有属性 1: false
denseArr 是否拥有自有属性 1: true
尽管二者的 length 均为 3,且通过 sparseArr[1] 访问时,由于在原型链查找不到该属性,表达式同样返回 undefined,但其底层对象的数据结构截然不同。
二、length 属性的数学原理与更新机制
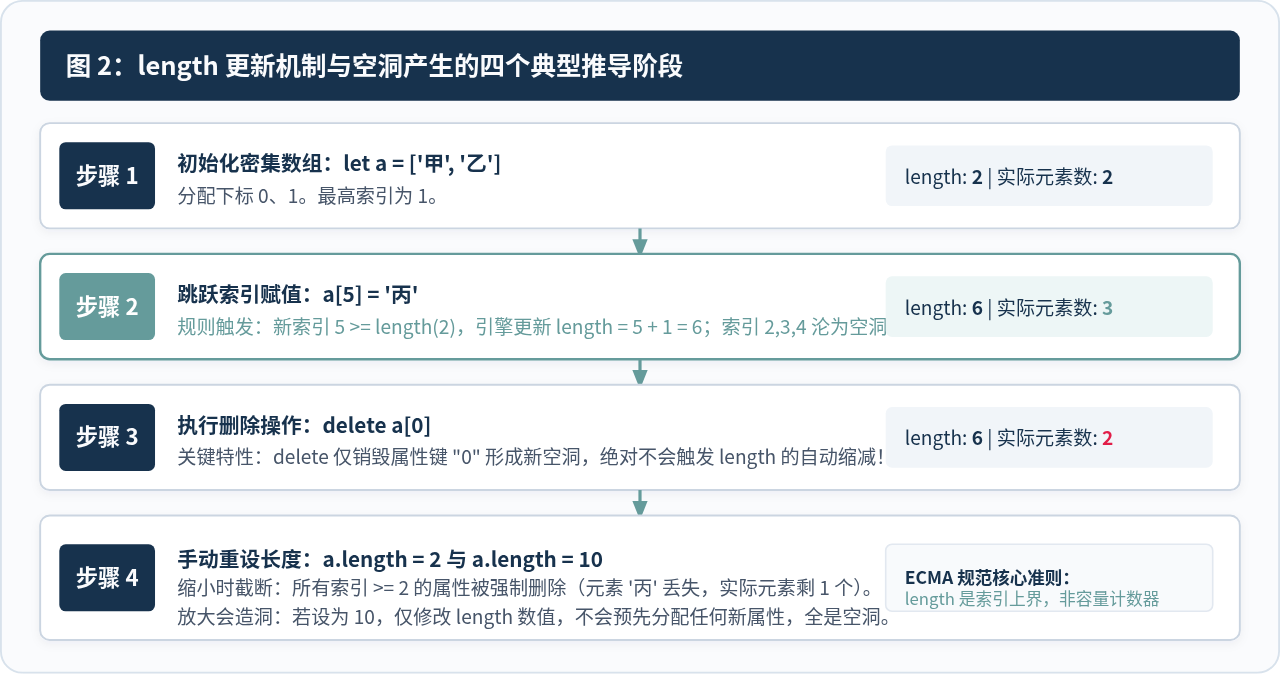
在 ECMAScript 规范中,数组本质上是一种经过特殊定制的“异质对象”(Exotic Object)。数组之所以能自动联动 length,是因为引擎内部定义了特殊的 [[DefineOwnProperty]] 内部方法。理解 length 的核心在于以下三条联动法则:
- 最高索引递增联动:当向数组添加一个数值索引
i时,若i >= length,则length立即被重设为i + 1。 - delete 元素绝不减少 length:使用
delete arr[i]只会移除属性键"i",将其转变为一个空洞,但length的数值保持原样。 - 手动设置 length 的单向截断与扩容:
- 如果将
length设为一个更小的正整数N,引擎会自动删除所有大于或等于N的已存在索引属性。 - 如果将
length设为一个更大的数值,引擎只单纯修改 length 的数值变量,而绝不会在内存中创建任何新元素,中间差额全部以空洞体现。
- 如果将
// 场景 1:使用 new Array(数量) 构造函数
const a1 = new Array(5); // 创建了 5 个空洞,实际元素数为 0,length 为 5

// 场景 2:越界跨索引赋值
const a2 = ['alpha'];
a2[10] = 'omega'; // 自动扩容,length 变成 11,实际元素数仅 2 个

// 场景 3:delete 运算符
const a3 = [10, 20, 30];
delete a3[1]; // 移除了键 "1",length 仍为 3,实际元素数变为 2

// 场景 4:手动直接扩充 length
const a4 = [1, 2];
a4.length = 100; // 形成 98 个空洞,length 变为 100
由此可以得出数学关系定理:
设数组的实际元素个数为
ActualCount = 物理存在且可枚举的数值属性数量,则:• 在密集数组中:
length === ActualCount• 在稀疏数组中:
length > ActualCount在任何合法的 JavaScript 数组中,
length 必然大于或等于 ActualCount,绝不可能小于实际元素数。
三、如何准确获取稀疏数组的实际元素数量
由于 arr.length 在存在空洞时会给出严重偏离实际元素数的值,当业务逻辑需要获取“数组中实际存在有效数据的元素总量”时,不能依赖 length,而需要采用专门的统计方式。
1. 最推荐方案:Object.keys(arr).length
Object.keys() 返回一个由目标对象自身所有可枚举属性名称组成的字符串数组。因为空洞并不是对象的属性,所以空洞对应的索引不会出现在 Object.keys() 中。这是标准、语义明确且性能极高的统计方式。
const sparse = [];
sparse[2] = "two";
sparse[8] = "eight";
sparse[10] = undefined; // 显式赋值为 undefined

console.log("length 属性值:", sparse.length); // 11
console.log("实际有效键列表:", Object.keys(sparse)); // ["2", "8", "10"]
console.log("实际元素数量:", Object.keys(sparse).length); // 3实际有效键列表: ["2", "8", "10"]
实际元素数量: 3
注意边界情况:如果给数组赋予了非数字属性(例如 arr.foo = 'bar'),Object.keys(arr) 也会将其统计在内。若只想统计有效数字索引元素,可结合数值索引过滤器:
function countArrayElements(arr) {
  return Object.keys(arr).filter(key => {
    const idx = Number(key);
    return Number.isInteger(idx) && idx >= 0 && idx < arr.length;
  }).length;
}
2. 替代方案:基于跳过空洞的数组迭代器
JavaScript 传统的原型方法(如 filter、reduce)天生会跳过空洞,因此也可以用来计数或压缩:
// 使用 filter 过滤出所有存在的非空洞元素(即使值为 undefined 也会被保留)
const actualCount = sparse.filter(() => true).length;

// 或者使用 reduce 累加计数
const countViaReduce = sparse.reduce(acc => acc + 1, 0);
四、数组遍历方法对“空洞”的处理差异
稀疏数组在业务开发中最容易引发意外 Bug 的地方在于:不同时代的 JavaScript 原生 API 对“空洞”的处理策略存在历史包袱和显著差异。大致可划分为两大阵营:
1. 经典遍历方法:直接跳过空洞(Skip Hole)
ES5 引入的绝大多数高阶函数(forEach, map, filter, reduce, every, some)以及属性遍历器(for...in),在执行内部逻辑时都会预先检查当前索引是否是对象的自有属性。如果当前位置是空洞,回调函数根本不会被调用。
// 试图用 map 填充一个长度为 3 的数组:
const filled = new Array(3).map(() => 0);

console.log("filled 结果:", filled);
console.log("实际元素数量:", Object.keys(filled).length);实际元素数量: 0
因为 new Array(3) 产出的全为空洞,map 的回调一次都未触发,返回的仍旧是 3 个空洞。
2. 现代迭代机制与 API:视作 undefined 访问
ES6 之后引入的迭代协议(for...of、展开运算符 [...arr]、Array.from())以及针对数组内容的搜索方法(find, findIndex, includes),会遵循数组索引从 0 遍历到 length - 1。访问空洞位置时,取值表达式会自然求值为 undefined,并当成有效数据交给后续逻辑处理。
// 解决方案:利用 Array.from 将空洞具体化为 undefined
const realDense = Array.from(new Array(3)).map(() => 0);
console.log("realDense 结果:", realDense); // [0, 0, 0]

// includes 与 indexOf 针对空洞的认知差异
const holeArr = [1, , 3];
console.log("indexOf(undefined):", holeArr.indexOf(undefined)); // -1 (找不到,因为跳过空洞)
console.log("includes(undefined):", holeArr.includes(undefined)); // true (找到,将空洞视作 undefined)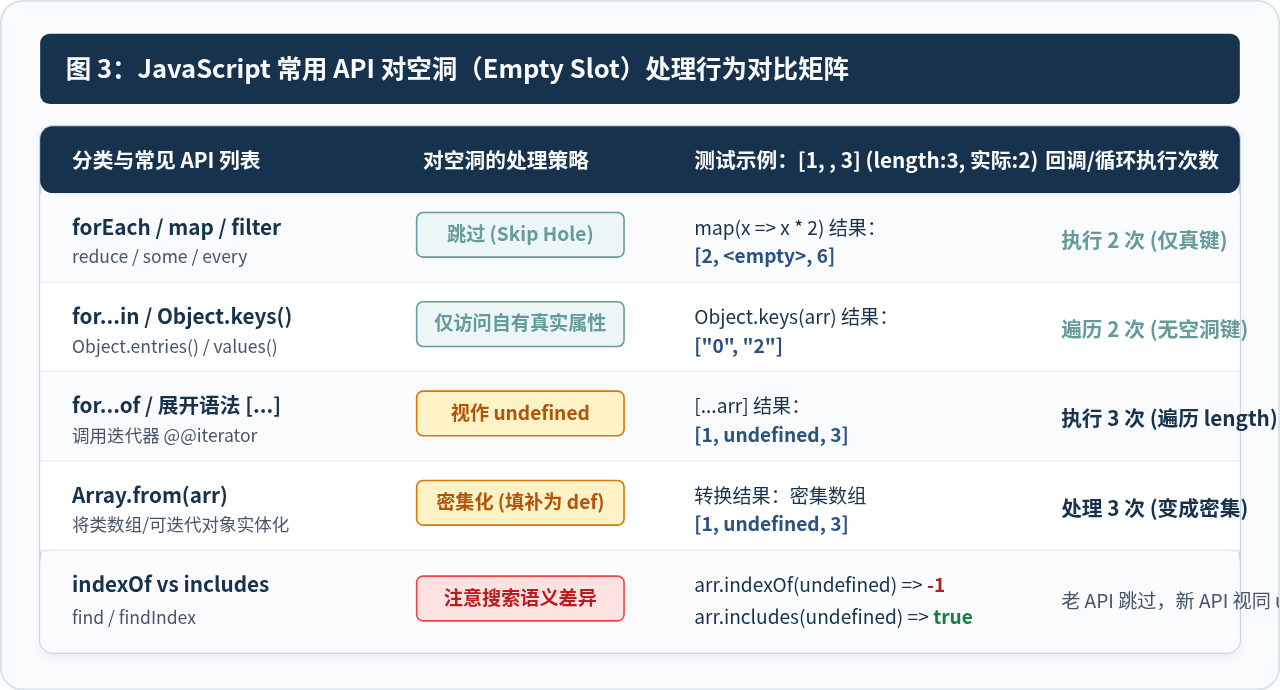
五、V8 引擎性能影响与工程最佳实践
除了逻辑层面的计数与遍历偏差,稀疏数组还会对 JavaScript 引擎的底层运行时优化产生严重的负面影响。
以主流的 V8 引擎为例,数组在底层具有不同的 Elements Kind(元素种类模式):
- PACKED 模式(紧凑/密集数组):元素在内存中以连续线性缓冲区(Flat C Buffer)的形式存放,索引访问对应极速的直接指针偏移寻址(
O(1)且无分支开销)。 - HOLEY 模式(稀疏数组):一旦数组产生了空洞,引擎就会将其降级为
HOLEY_*模式。此时读取任何索引,引擎必须加入“是否为空洞”的原型链安全回退检查。 - 字典模式(Dictionary Mode / Slow Mode):如果稀疏程度极高(如
a[1000000] = 1),V8 将彻底放弃线性存储,将数组降级为底层的哈希表(Dictionary)。此时属性访问将蜕化为哈希查找,吞吐性能相比连续内存密集数组将出现数量级的剧烈下滑。
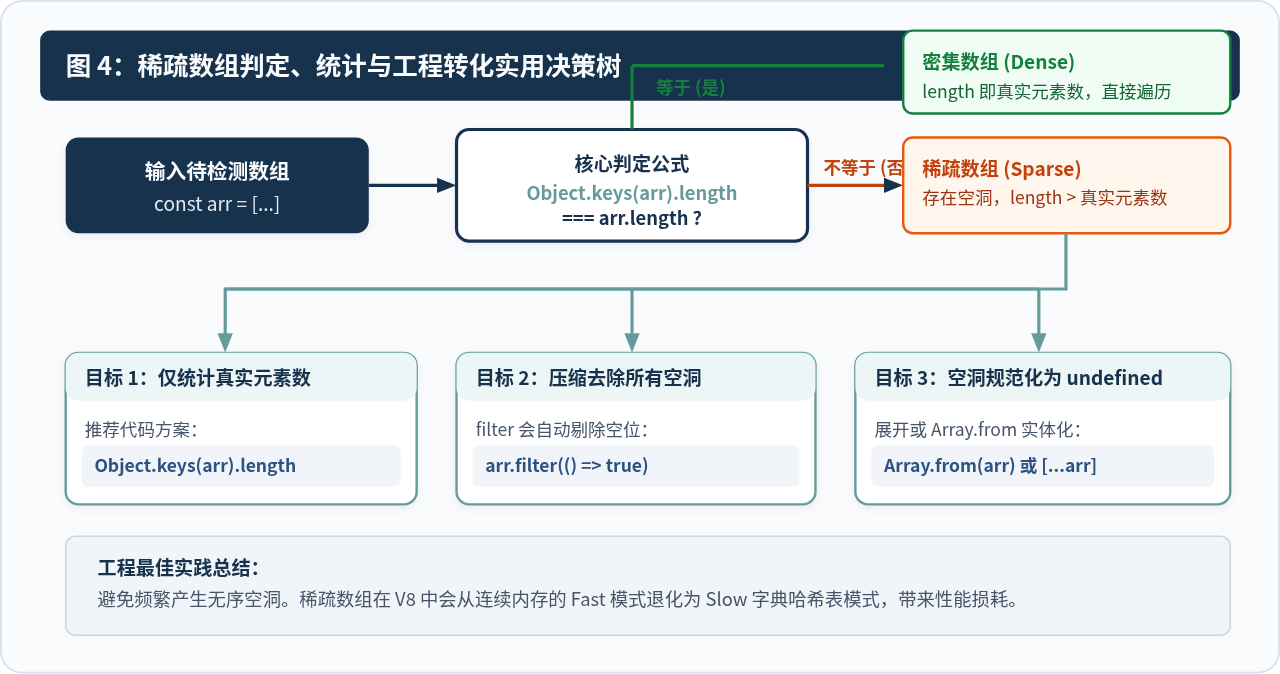
1. 禁止随意跨大跨度索引赋值:需要扩充元素时始终优先使用
push()、concat() 或展开语法,避免产生意外空洞。2. 避免对数组使用
delete:若需移除元素,使用 splice() 真正地从内存中平移剔除,而不是使用 delete arr[i] 留下空洞。3. 预分配密集数组的正确写法:若需要初始化指定长度的填充数组,推荐使用
new Array(n).fill(初始值) 或 Array.from({ length: n }, (_, i) => 初始值),确保生成的为密集数组。
JS格式化输出报错:怎么处理循环引用和BigInt类型数据
2026-11-12 18:05:51
React函数组件和class组件语法有什么区别?
2026-11-12 18:01:49
JS解析JSON格式字符串为数组的方法
2026-11-12 17:20:40
JavaScript实现四舍五入保留指定小数位后取整
2026-11-12 11:03:16
JS向下取整:Math.floor()的标准用法与注意事项
2026-11-12 10:00:42