基于正则表达式的HTML代码快速美化JS实现
介绍如何使用原生JavaScript与正则表达式实现轻量级HTML代码快速美化,讲解标签占位保护、正则分词、标签分类状态机与层级缩进算法,并提供完整代码实现与选型建议。
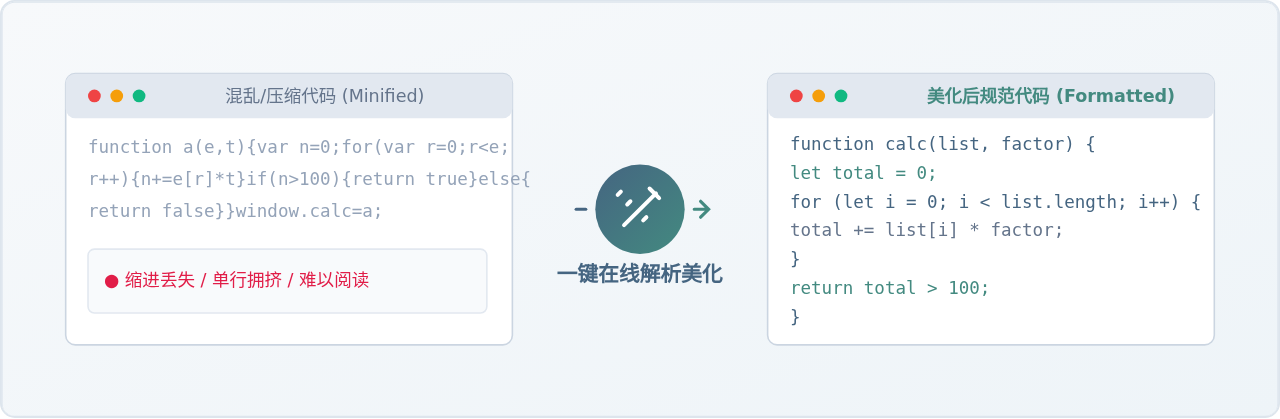
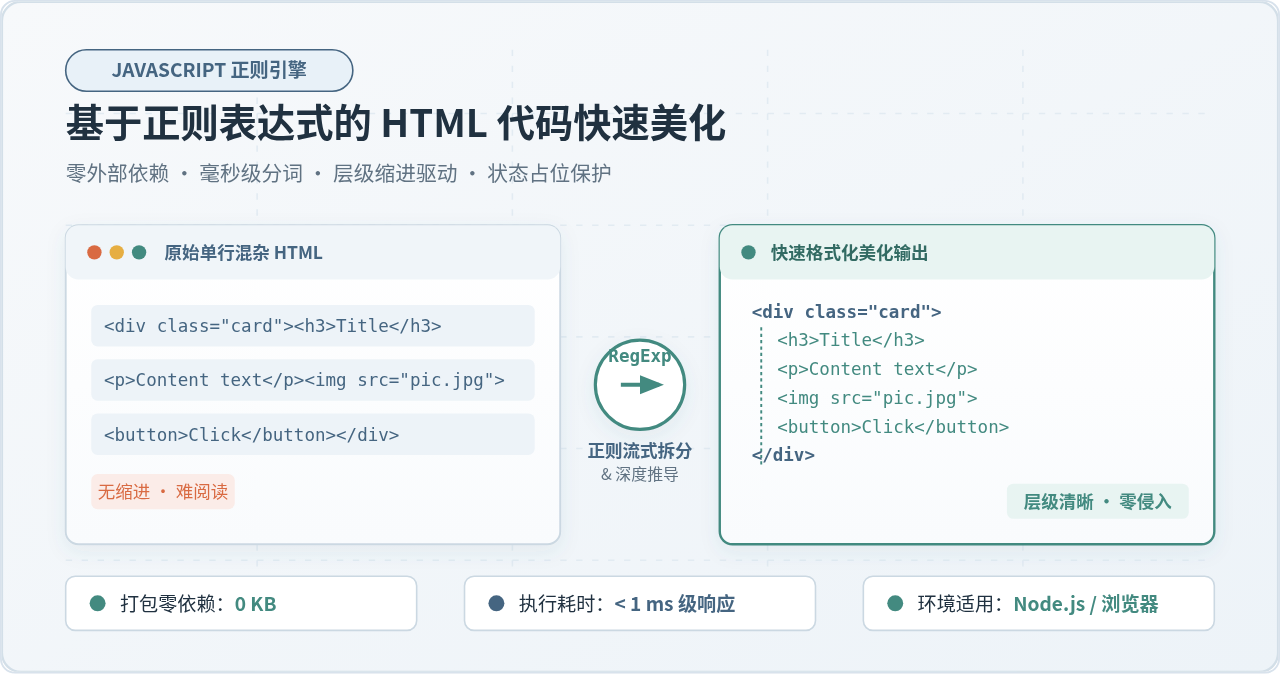
在前端开发中,展示或审查动态生成的 HTML 片段时,常遇到无换行、无缩进的单行紧凑字符串。引入庞大的语法树解析库或完整的格式化依赖(如 Prettier、js-beautify)会导致打包体积显著膨胀并在低端设备上带来初始化开销。使用原生 JavaScript 配合正则表达式与轻量深度状态机,可以在零外部依赖的前提下,以毫秒级速度将紧凑 HTML 整理为带规范层级缩进与换行的整洁代码。
一、为什么选择基于正则表达式的轻量美化
在 Web 组件库展示、在线运行预览(Playground)、日志审查器以及前端富文本调试面板等场景中,待格式化的 HTML 通常具备两个典型特征:片段体积处于中小型范围(通常在数百字节到数十千字节之间),且排版目的纯粹是为了人类开发者便于阅读,并不需要在前端进行严格的 AST(抽象语法树)重构或执行安全转义。
传统的全量格式化工具(如 Prettier 及其 HTML 解析插件)往往包含数百 KB 的解析逻辑,需要经历词法分词、建立完整 DOM 树对象、语法规则判定与逆向序列化。相比之下,基于正则表达式的流式切分方案具有鲜明的技术特性:
- 零运行依赖与极小体积:全部核心逻辑仅需数十行纯原生 JavaScript,不依赖 npm 包,打包增量几乎为 0 KB。
- 微秒到毫秒级极速响应:避免在堆内存中频繁创建与销毁庞大的 DOM 节点树,直接基于字符串索引与正则单次线性扫描完成排版。
- 环境普适性高:无论运行在缺乏浏览器 DOM 对象的 Node.js 脚本、Serverless 云函数,还是移动端 Web 容器,均可无缝直接执行。
二、核心处理流程与流水线设计
HTML 文本与普通纯文本不同,它包含了不能被肆意插入空格与换行的特殊区块(如 <script> 内联脚本、<style> 样式表、<pre> 预排版标签以及 HTML 注释)。若直接对整段 HTML 粗暴执行换行缩进,必然会破坏内联 JavaScript 的分号逻辑或损坏 <pre> 中的原生对齐。
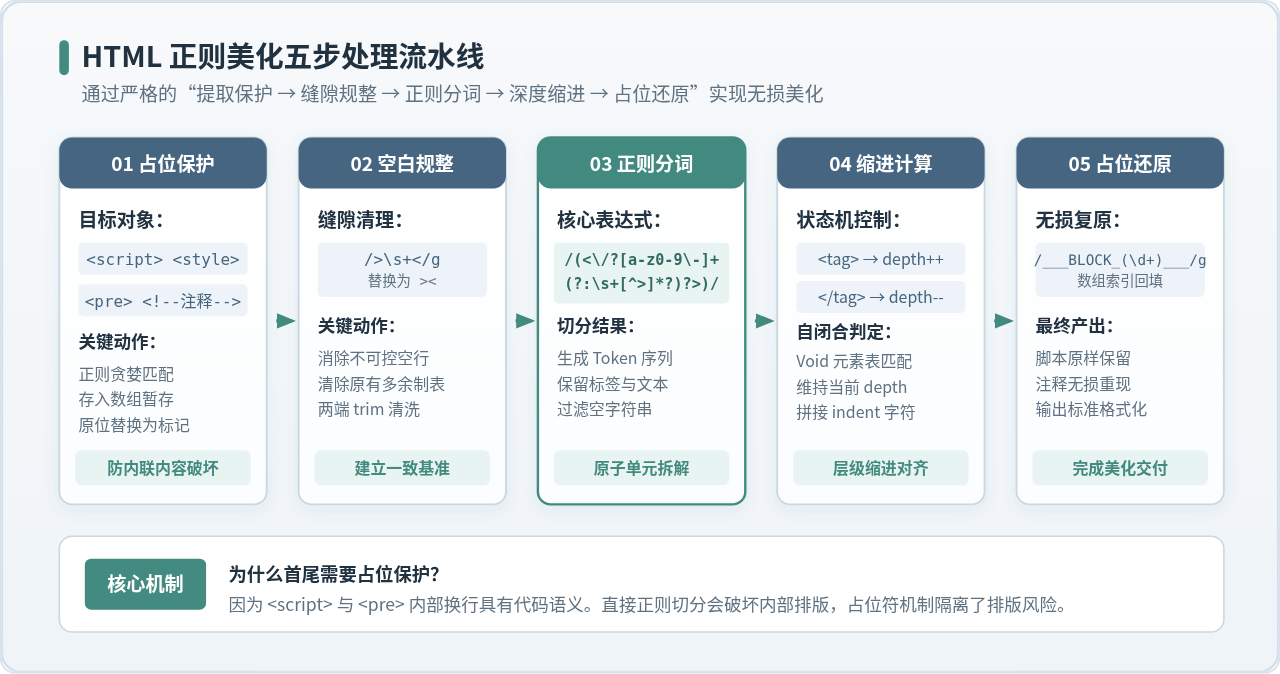
因此,一个稳健的正则美化算法必须采用严格的五步处理流水线:首先提取并隔离不可破坏的特殊区块,随后进行全局空白缝隙规整,接着切分标签原子,通过缩进深度计数器完成层级排版,最后无损逆向还原占位符。
1. 占位保护与特殊标签隔离
在执行任何排版拆分之前,首先通过正则捕获组提取所有 <script>...</script>、<style>...</style>、<pre>...</pre> 以及 <!-- 注释 -->。将它们依次存入一个暂存数组中,并在原字符串对应位置替换为带有索引编号的独立占位字符串,例如 ___HTML_PRESERVE_0___。由于占位符不含尖括号 < 或 >,后续的分词引擎会将其视为普通单行文本节点安全对待。
2. 规范化标签缝隙空白
待处理的 HTML 字符串内部往往混杂着不可预期的换行符、多个连续空格或制表符。为建立一致的基准,使用正则 />\s+</g 将标签之间的连续空白符压缩为无缝衔接的 ><,同时对字符串首尾执行 trim(),消除初始漂移。
三、正则模式设计与标签分类判定
完成空白规整后,整个 HTML 字符串由两类基本元素交替构成:HTML 标签(Tags)与文本内容(Text Nodes)。我们需要一个高精度的捕获正则,将整段字符串精确切割为有序的 Token 列表。
1. 标签拆分正则表达式
使用如下全局捕获正则执行 split 切分:
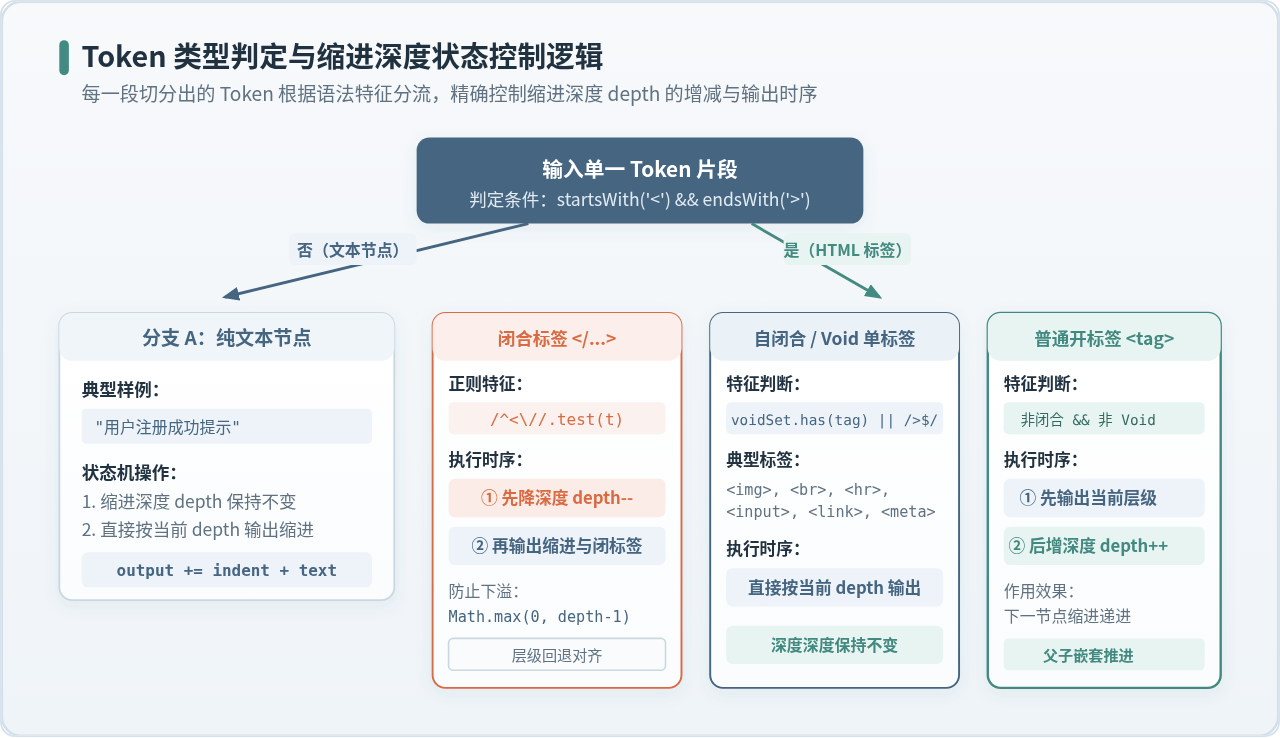
const tokenRegex = /(<\/?[a-zA-Z0-9\-]+(?:\s+[^>]*?)?>)/g;
该正则能精确捕获以下三类标签,同时利用 String.prototype.split 保留匹配项的特性,保证标签之间的纯文本片段与标签本身按原始先后顺序依次排布在返回的数组中。
2. 标签类型的四大分支与深度控制
对于拆分出来的每一个 Token,状态机依据其语法特征将其划入四个互斥分支:
-
分支一:闭合标签(如
</div>、</p>)
匹配正则/^<\//.test(token)。闭合标签代表当前层级结束,因此必须先将缩进深度减 1(使用Math.max(0, depth - 1)防止非法括号导致负深度),随后在当前缩进位置追加该闭合标签并换行。 -
分支二:自闭合与 Void Elements(如
<img>、<br>、<input>、<meta>)
在 HTML5 规范中,部分单标签无需闭合标签即可自行结束。若将<img>当作开标签递增深度,会导致其后所有兄弟节点全部错误向右倾斜缩进。因此需要维护一份 Void Elements 哈希表,或者匹配 XHTML 式的/>$/语法。遇到此类标签时,直接在当前层级输出,保持深度不变。 -
分支三:普通开标签(如
<div class="box">、<ul>)
非闭合标签且非 Void 元素。这表明开启了一个新的嵌套层级。执行顺序为:先按当前深度输出标签与换行,随后将深度递增 1(depth += 1),使得其内部子元素自动获得递进缩进。 -
分支四:文本节点(Text Node)
不以<开头或不以>结尾的纯文本片段。保持当前深度输出,换行后深度维持不变。
四、完整 JavaScript 实现代码
以下为经过生产环境考量、无外部依赖的完整 JavaScript 实现。代码支持通过 options.indent 自定义缩进符(默认为两个空格),并内置了 HTML5 规范中完整的 14 个 Void Elements 清单。
/**
 * 基于正则表达式的轻量级 HTML 快速美化函数
 * @param {string} html 待格式化的原始 HTML 字符串
 * @param {object} [options] 配置选项
 * @param {string} [options.indent='  '] 缩进字符,默认两个空格,亦可传入 '    ' 或 '	'
 * @returns {string} 格式化后的整洁 HTML 字符串
 */
function formatHTML(html, options = {}) {
  if (!html || typeof html !== 'string') {
    return '';
  }

  const indentStr = options.indent || '  ';

  // 1. 保护特殊标签与注释,避免内联脚本与预排版内容被意外格式化
  const preservedBlocks = [];
  const placeholderPrefix = '___HTML_BEAUTIFY_BLOCK_';

  // 匹配 <!-- 注释 --> 以及 <script>、<style>、<pre> 完整块
  const protectRegex = /(<!--[\s\S]*?-->|<(script|style|pre)[^>]*>[\s\S]*?<\/>)/gi;
  const protectedHtml = html.replace(protectRegex, (match) => {
    const index = preservedBlocks.length;
    preservedBlocks.push(match);
    return `${placeholderPrefix}${index}___`;
  });

  // 2. HTML5 规范中标准的 Void Elements(无结束闭合标签的单元素)
  const voidElements = new Set([
    'area', 'base', 'br', 'col', 'embed', 'hr', 'img',
    'input', 'link', 'meta', 'param', 'source', 'track', 'wbr'
  ]);

  // 3. 规范化空白:清理标签间混乱的换行与空格
  const cleanHtml = protectedHtml
    .replace(/>\s+</g, '><')
    .trim();

  // 4. 正则分词:提取标签和文本
  const tokenRegex = /(<\/?[a-zA-Z0-9\-]+(?:\s+[^>]*?)?>)/g;
  const tokens = cleanHtml.split(tokenRegex).filter(t => t.trim().length > 0);

  let result = '';
  let depth = 0;

  tokens.forEach((token) => {
    const trimmed = token.trim();
    const isTag = trimmed.startsWith('<') && trimmed.endsWith('>');

    if (!isTag) {
      // 纯文本节点:沿用当前深度
      result += indentStr.repeat(depth) + trimmed + '
';
      return;
    }

    const isClosing = /^<\//.test(trimmed);
    const isSelfClosingSyntax = /\/>$/.test(trimmed);
    const tagNameMatch = trimmed.match(/^<\/?([a-zA-Z0-9\-]+)/);
    const tagName = tagNameMatch ? tagNameMatch[1].toLowerCase() : '';
    const isVoid = voidElements.has(tagName) || isSelfClosingSyntax;

    if (isClosing) {
      // 闭合标签:先回退缩进深度,再输出
      depth = Math.max(0, depth - 1);
      result += indentStr.repeat(depth) + trimmed + '
';
    } else if (isVoid) {
      // Void 单标签:原层级输出,不增加深度
      result += indentStr.repeat(depth) + trimmed + '
';
    } else {
      // 普通开标签:输出当前层级,子级深度递增
      result += indentStr.repeat(depth) + trimmed + '
';
      depth += 1;
    }
  });

  // 5. 逆向还原被保护的特殊块
  const restoreRegex = new RegExp(`${placeholderPrefix}(\d+)___`, 'g');
  const finalHtml = result.replace(restoreRegex, (_, index) => {
    return preservedBlocks[Number(index)] || '';
  });

  return finalHtml.trim();
}formatHTML('<div class="container"><h1>Hello</h1><p>World<img src="a.png"></p></div>'),输出将是层级清晰、带换行与两空格缩进的标准排版文本。
五、正则方案与 AST 完整解析器对比
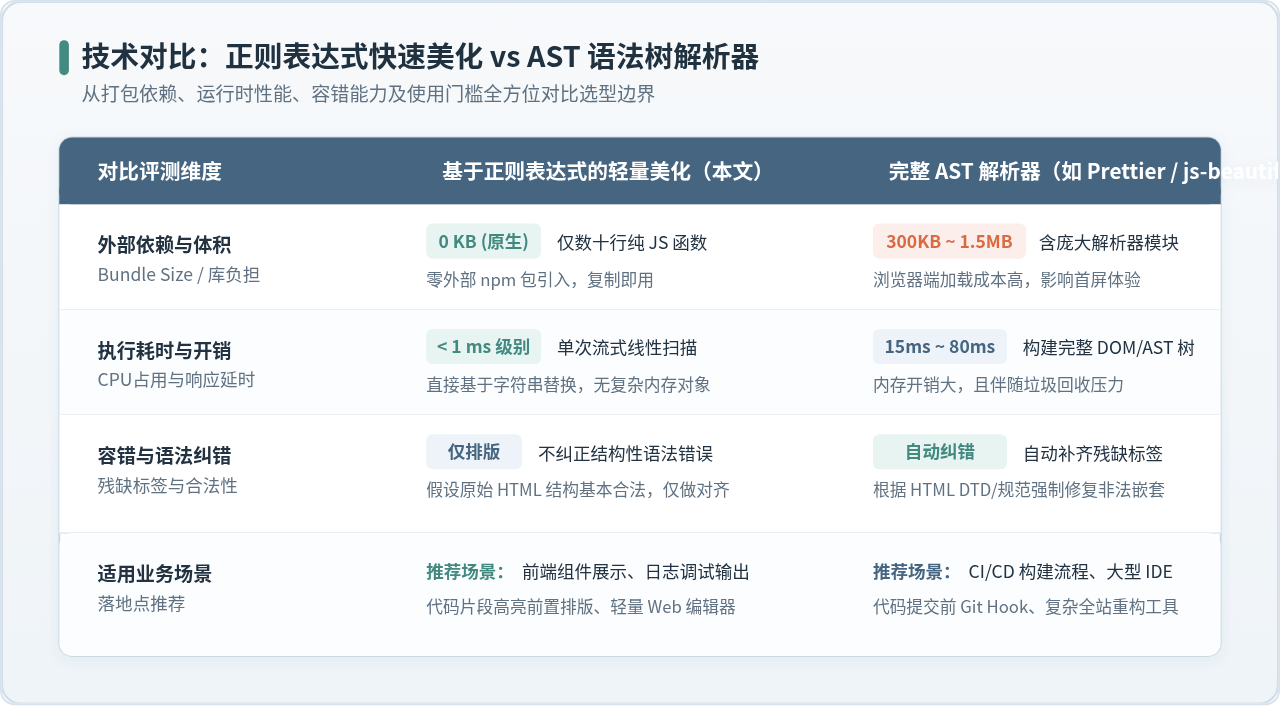
为了让读者在实际工程技术选型中具备清晰的判断依据,下表与对比图示从多个工程维度展示了基于正则表达式的快速美化与基于完整 AST(如 Prettier / js-beautify)的差异。
从对比中可以看出:
- 开销取向不同:正则方案用“放弃全量语法校验与非法标签纠错能力”换取了极致的轻量与秒级响应;AST 方案则用数千倍的代码体积换取对畸形 HTML 的修复与语义重排。
- 使用场景划分明确:当用户在前端只是为了查看接口返回的 HTML 片段、查看网页组件源码或排查样式层级时,正则方案是收益最高、侵入性最小的选择。
六、常见边界陷阱与应对策略
在实际使用正则表达式处理 HTML 字符串时,有一些边缘情况需要特别注意,避免排版偏差。
1. 属性值中包含尖括号
某些复杂 HTML 元素的属性值中可能包含比较运算符或模板表达式,例如:<input data-condition="age > 18" />。
如果分词正则采用最简单的 <[^>]+>,遇到 > 18" 中的大于号就会提前截断,导致属性值被错误切分。
(?:"[^"]*"|'[^']*'|[^'">])* 确保双引号或单引号内部的 > 不会被视作标签闭合符,保证属性值完整性。
2. 行内元素的折行与留白影响
HTML 规范中,行内元素(如 <span>、<a>、<strong>)之间的空白符在浏览器渲染引擎中会被合并为一个可见空格。如果格式化算法对每一个行内元素都无差别换行,可能会在页面实际渲染时引入微小的非预期视觉间隙。
针对该问题,轻量排版通常用于代码展示区(<code> 容器或编辑器),此时代码排版优先于浏览器富文本渲染留白。若要应用于直接注入 DOM 的富文本,建议将行内连续标签合并在同一行处理。
七、总结与技术选型建议
基于正则表达式与状态计数器的 HTML 快速美化方案,以极小的代码体积解决了前端无依赖排版的核心诉求。它不追求成为庞大且沉重的语法纠错器,而是专注于在合法的 HTML 文本流中精准识读标签边界,赋予其优雅的层级结构。
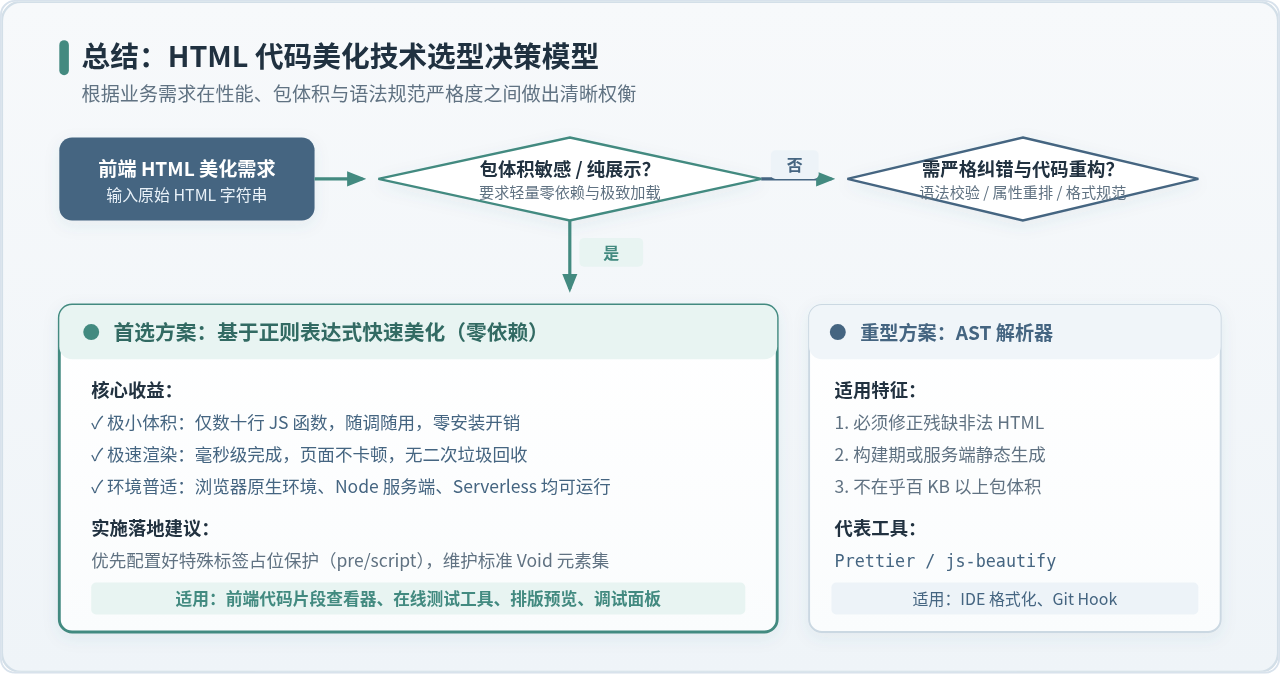
在工程实践中,建议遵循以下落地原则:
- 展示层优先选用正则方案:对于代码高亮组件前置排版、动态调试工具、低代码平台预览窗口,直接采用本文给出的纯函数实现,保障打包体积极致小巧与首屏秒开。
- 构建层与提交拦截选用 AST 工具:在 Webpack/Vite 打包构建插件、Git Pre-commit Hook 或严苛的工程代码格式化环节,使用 Prettier 等具备完整 DTD 校验的工业级解析器。
- 保持 Void 列表更新:随着 HTML 规范演进,若有自定义独立标签或规范变动,只需在函数的
voidElements集合中增删标签名即可,具备极高的维护灵活性。
javascript下载安装手机版怎么处理多层嵌套的情况
2026-11-08 12:03:49
JS怎么打印当前时间
2026-11-05 20:48:56
免登录快速分享代码:适合面试协作的轻量级JS在线运行工具推荐
2026-11-05 14:45:59
JS空字符串和纯空格转浮点数的结果是什么
2026-11-05 11:04:42
JS在线格式化缩进混乱怎么办?配置项调整技巧
2026-11-04 23:27:25