JS计算UTF-8编码后的字符串字节长度
深入讲解在 JavaScript 中准确计算字符串 UTF-8 编码字节长度的核心原理、实用方案与工程避坑指南,全面对比 TextEncoder 与纯算法循环的实现细节。
在 JavaScript 中计算字符串经过 UTF-8 编码后的实际字节数,最直接的标准方案是调用原生 new TextEncoder().encode(str).length。由于 JavaScript 内部的 string.length 统计的是 UTF-16 编码单元数量而非底层字节数,当文本中包含汉字、扩展拉丁文或 Emoji 表情时,字符长度与存储字节数会出现显著偏差。本文详细解析这一差异背后的编码机制,并提供主流实现方案及边界防范方法。
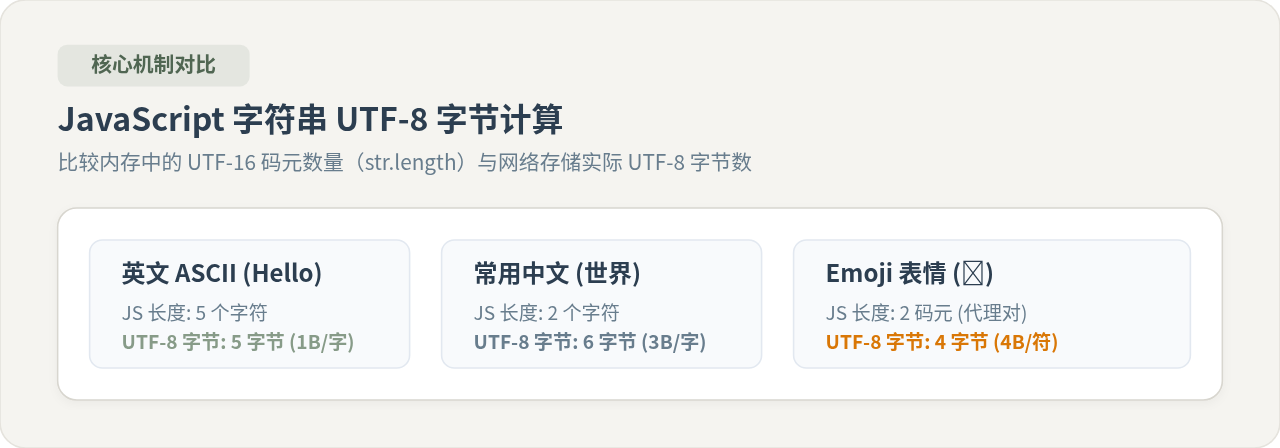
一、为什么 string.length 无法代表实际字节数
JavaScript 字符串采用 UTF-16 字符编码规范存储。在这一机制下,每个码元(Code Unit)占用 16 位(2 字节)。基本多语言平面(BMP)内的单个字符对应一个码元,因此 "A".length 为 1,"中".length 也为 1。然而,当这些字符需要持久化存储到数据库、写入文件或通过 HTTP 传输时,互联网事实上的通用编码是 UTF-8。
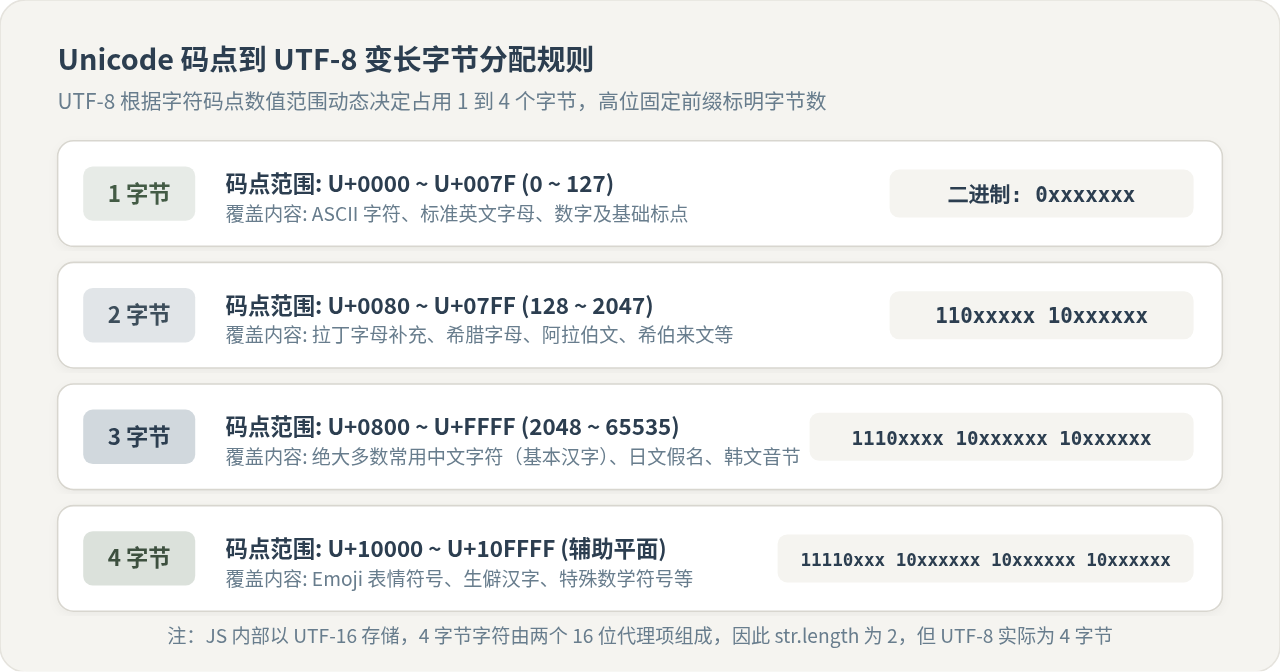
UTF-8 是一种针对 Unicode 的可变长度字符编码。它根据字符的 Unicode 码点大小,动态采用 1 到 4 个字节来表示一个字符:
- 标准 ASCII 字符(U+0000 ~ U+007F):占用 1 个字节,保持与传统 ASCII 编码完全兼容。
- 扩展拉丁文、希腊文等(U+0080 ~ U+07FF):占用 2 个字节。
- 常用汉字与中日韩文字(U+0800 ~ U+FFFF):普遍占用 3 个字节。
- Emoji 表情及生僻字(U+10000 ~ U+10FFFF):占用 4 个字节。在 JavaScript 内部,这类字符超出 UTF-16 BMP 范围,会被拆分为两个 16 位的代理对(Surrogate Pair),导致
str.length为 2,而 UTF-8 实际仅占用 4 个字节。
二、计算 UTF-8 字节长度的常用方案
针对不同的宿主环境(浏览器端、Node.js 服务端、Web Worker)及性能要求,JavaScript 中存在三种可靠的计算途径。
1. 现代标准方案:TextEncoder(推荐)
TextEncoder 是 W3C 规范的编码接口,现代主流浏览器以及 Node.js 11+ 环境均原生内置。它直接将字符串转换为包含 UTF-8 编码数据的 Uint8Array,读取该数组的 length 即可得到精确字节数:
function getUtf8ByteLength(str) {
  return new TextEncoder().encode(str).length;
}

// 验证示例
console.log(getUtf8ByteLength("Hello"));   // 5 字节
console.log(getUtf8ByteLength("你好世界")); // 12 字节 (每个汉字 3 字节)
console.log(getUtf8ByteLength("🚀"));       // 4 字节 (单个 Emoji 占 4 字节)
该方案代码简洁、严格符合现代国际标准,且由引擎底层的 C++ 层面高效完成,不需要开发者手动处理复杂的代理对分支。
2. 纯算法循环:codePointAt 遍历(零内存开销)
尽管 TextEncoder 实现标准,但每次调用 encode() 都会在内存堆中实例化一个全新的 Uint8Array。如果业务场景需要在一秒内对数十万条字符串进行频繁长度校验,内存分配与垃圾回收(GC)将产生不可忽视的抖动。此时可使用纯算术循环直接统计字节累加值:
function getUtf8ByteLengthLoop(str) {
  let bytes = 0;
  for (let i = 0; i < str.length; i++) {
    const code = str.codePointAt(i);
    if (code <= 0x7f) {
      bytes += 1;
    } else if (code <= 0x7ff) {
      bytes += 2;
    } else if (code <= 0xffff) {
      bytes += 3;
    } else {
      bytes += 4;
      i++; // 辅助平面字符占用两个 UTF-16 码元,递增索引跳过低位代理
    }
  }
  return bytes;
}注意要点:此处必须使用 ES6 的 str.codePointAt(i) 而非早期的 str.charCodeAt(i)。当遇到码点大于 0xFFFF 的字符(如 Emoji)时,codePointAt 能直接读取 32 位完整码点。此时需要执行 i++ 跳过后续的低位代理项,避免重复计数。
3. 浏览器轻量替代方案:Blob.size
在仅需要运行于浏览器端、且无需产生 TypedArray 的情境下,可以利用 Blob 对象的 size 属性:
function getUtf8ByteLengthBlob(str) {
  return new Blob([str]).size;
}
浏览器内部在构建 Blob 时会默认使用 UTF-8 编码封装数据,其 size 属性即代表生成的二进制数据总字节数。此方法适用于传统前端项目,但无法在无 DOM 绑定的精简服务端脚本中脱离环境使用。
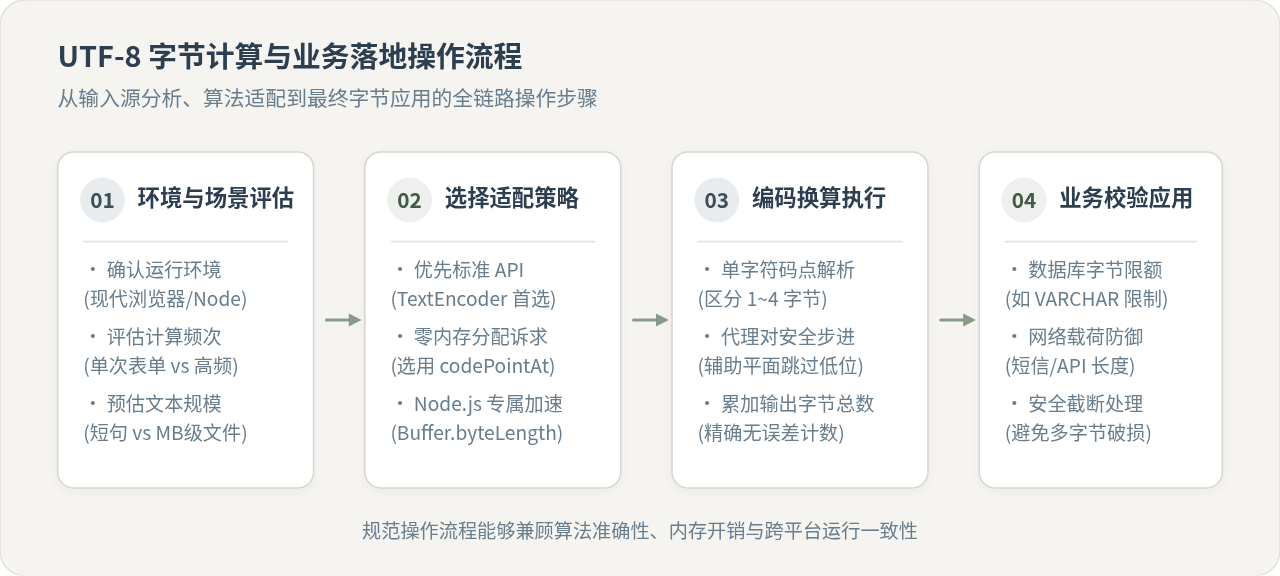
三、两种实现路径的差异与权衡:TextEncoder 与纯算法循环
在工程实践中,开发者常在“使用标准 API(TextEncoder)”与“手写纯遍历算法(codePointAt)”之间做选择。在一致的输入条件下,理解两者的核心差异对架构选型至关重要:
| 对比维度 | TextEncoder 原生标准 | codePointAt 纯算法循环 |
|---|---|---|
| 内存分配行为 | 每次调用均需创建并分配一个 Uint8Array 实例 |
仅操作一个整型累加变量,完全零堆内存分配 |
| 长文本处理性能 | 引擎底层 C++ 并行编码,大文本(如 MB 级)吞吐速率高 | 纯 JS 逐字迭代,大字符串耗时受解释器循环开销限制 |
| 高频短文本场景 | 高频调用容易产生微小对象碎片,触发垃圾回收卡顿 | 无 GC 压力,极适合表单实时输入校验、日志清洗 |
| 实现复杂度 | 单行调用,完全无需考虑 Unicode 内部代理项规则 | 需维护边界判断与代理项步进逻辑,需防范孤立代理 |
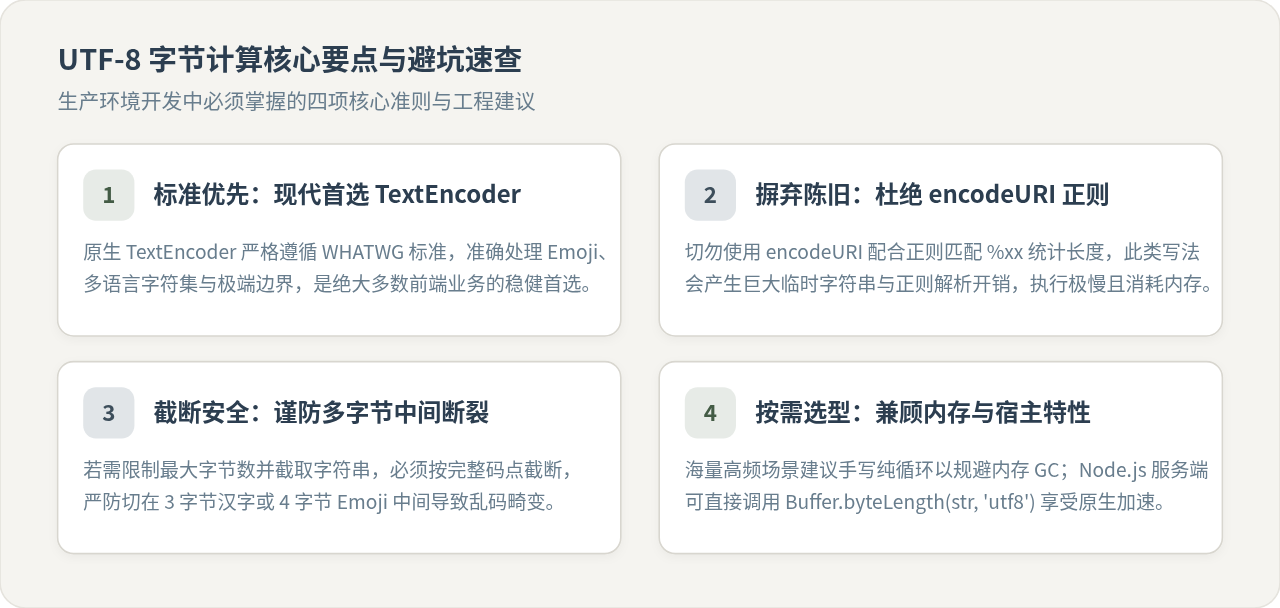
核心影响说明:如果你的业务场景是普通表单提交校验、接口请求入参检查或偶发的文件体积计算,TextEncoder 是绝对首选,稳定且代码具备自解释性;如果你的业务是高频数据管道(例如实时解析每秒数万条的 WebSocket 流),纯算法循环能有效避免内存分配开销,提供更平稳的响应延迟。
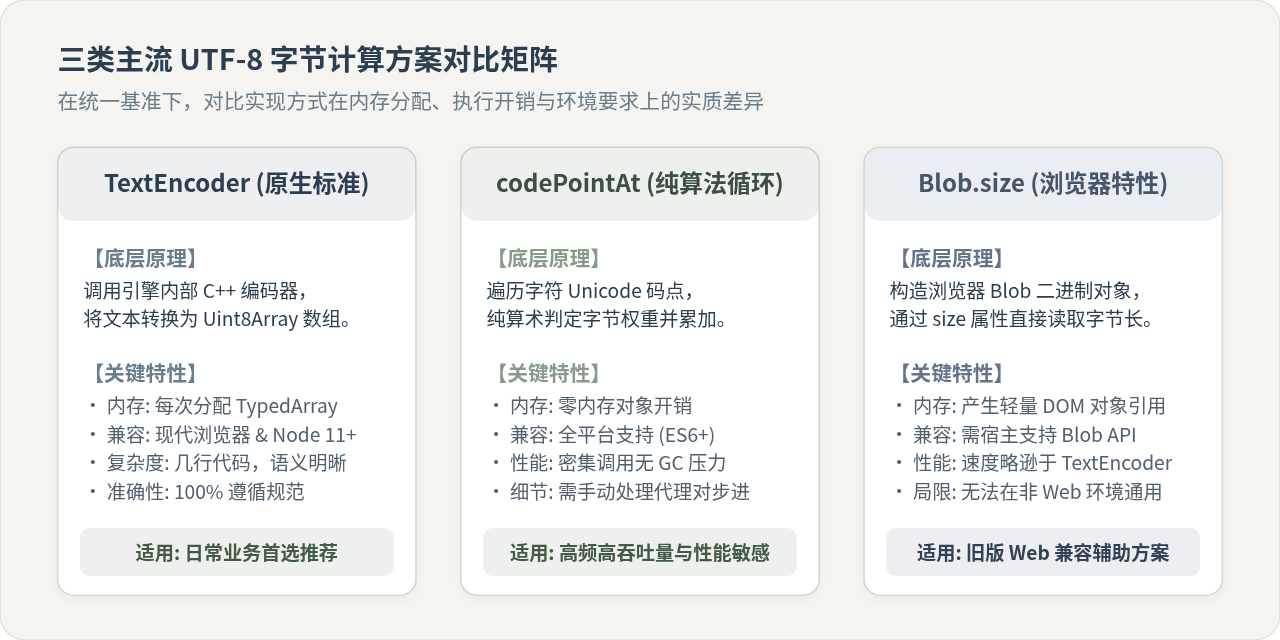
四、实际业务落地与边界避坑指南
1. Node.js 服务端的专属极速方案
在 Node.js 环境中,除了标准的 TextEncoder,还可以直接使用底层核心模块的 Buffer.byteLength:
// 仅适用于 Node.js 环境
const length = Buffer.byteLength("你好世界", "utf8"); // 12
Buffer.byteLength 是 Node.js 专门优化的底层 C++ 实现,不需要预先分配 Buffer 实例即可快速返回字节数,是 Node.js 后端开发性能与便携性俱佳的方案。
2. 按字节长度截取字符串的安全实践
很多业务需求不仅要统计字节长度,还要求“输入不得超过 N 个字节,超过部分截断”。若简单使用二进制截断,极容易把一个 3 字节的汉字或 4 字节的 Emoji 从中间切断,导致生成的字符串变成乱码(出现非法 Unicode 替换字符 )。安全截断应基于完整码点进行累加判断:
function truncateByUtf8Bytes(str, maxBytes) {
  let bytes = 0;
  let endIdx = 0;

  for (let i = 0; i < str.length; i++) {
    const code = str.codePointAt(i);
    let charBytes = 1;
    let step = 1;

    if (code > 0x7ff) {
      if (code <= 0xffff) {
        charBytes = 3;
      } else {
        charBytes = 4;
        step = 2; // 代理对占两个码元
      }
    } else if (code > 0x7f) {
      charBytes = 2;
    }

    if (bytes + charBytes > maxBytes) {
      break; // 超出限额,在完整字符边界处安全停止
    }

    bytes += charBytes;
    endIdx += step;
    if (step === 2) i++;
  }

  return str.slice(0, endIdx);
}

// 验证:最大允许 7 字节
// "你好"(6字节)+ "世界"(超出)
console.log(truncateByUtf8Bytes("你好世界", 7)); // 输出:"你好"(不会把"世"切成半截乱码)部分旧教程中流行通过
encodeURI(str).split(/%..|./).length - 1 来计算字节。这种方法首先将整个字符串序列化为包含大量 %xx 的超长字符串,随后调用正则拆分生成大型数组,执行开销极高且消耗数倍内存,在现代项目中应坚决淘汰。
五、总结
计算 JavaScript 字符串的 UTF-8 字节长度,核心在于识别 Unicode 码点在 UTF-8 规范下的变长特征:
- 日常 Web 业务开发中,优先使用标准内置的
new TextEncoder().encode(str).length,兼顾可读性与健壮性; - 在低延迟、高并发或超密集计算场景下,选用无内存开销的
codePointAt算法循环,规避对象垃圾回收瓶颈; - Node.js 服务端处理网络请求载荷时,使用
Buffer.byteLength(str, 'utf8')能兼顾简洁与极速; - 涉及限制字节截取时,必须维护码点边界完整性,杜绝多字节断裂导致的乱码问题。
CryptoJS库怎么实现字符串到16进制的编码
2026-11-11 14:27:57
js函数里面的data参数和相关的原生方法有什么区别
2026-11-08 23:10:00
JavaScript已禁用如何启用的底层执行过程是怎样的
2026-11-08 16:02:52
js判断整数正则表达式出问题按什么顺序排查
2026-11-08 14:12:50
Ramda 与 Lodash FP 在 JavaScript 中的区别与选择
2026-11-07 14:01:31