js判断整数正则表达式出问题按什么顺序排查
在JavaScript中使用正则表达式判断整数时,如果校验结果出现偶发失效、误判浮点数或允许前导零等异常,应按照修饰符状态、首尾锚点、模式优先级与前导零、输入类型隐式转换、全量边界测试这五个步骤逐一排查。本文详解排查顺序、底层成因及修复方案。
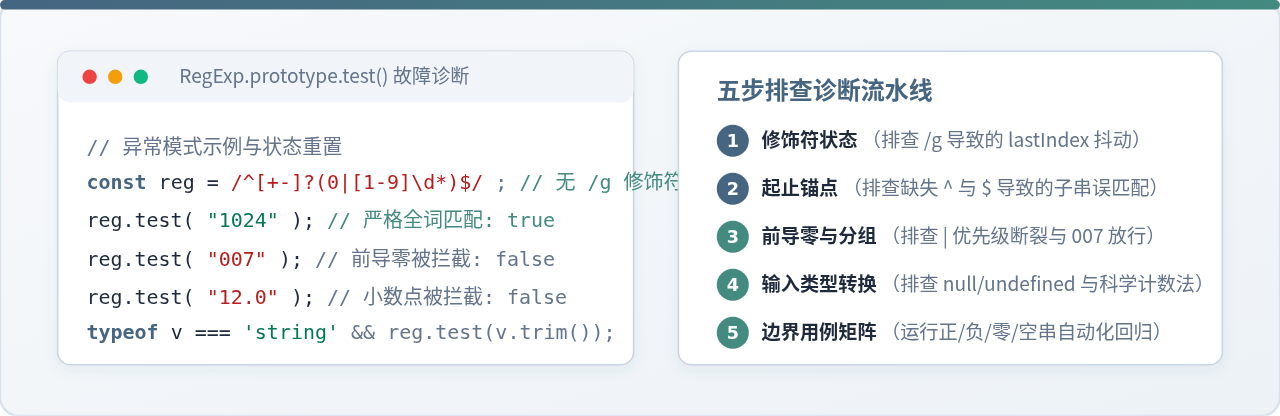
在 JavaScript 中使用正则表达式判断整数时,如果校验结果出现“偶发性失效、相同输入结果反复横跳、浮点数漏网通过或前导零无法拦截”等问题,标准的高效排查顺序是:第一步排查修饰符与内部游标状态(检查是否误加 /g 导致 lastIndex 状态残留);第二步排查字符串首尾锚点(检查是否漏写 ^ 和 $ 导致局部子串匹配);第三步排查模式分组与符号优先级(检查 | 管道符是否缺乏括号隔离以及前导零 007 是否被放行);第四步排查输入参数隐式转换(排查 null、undefined、科学计数法引发的隐式 toString());第五步运行全量边界测试矩阵(覆盖正负号、纯零、空白符等边界用例并固化方案)。
排查全貌:五步递进诊断顺序
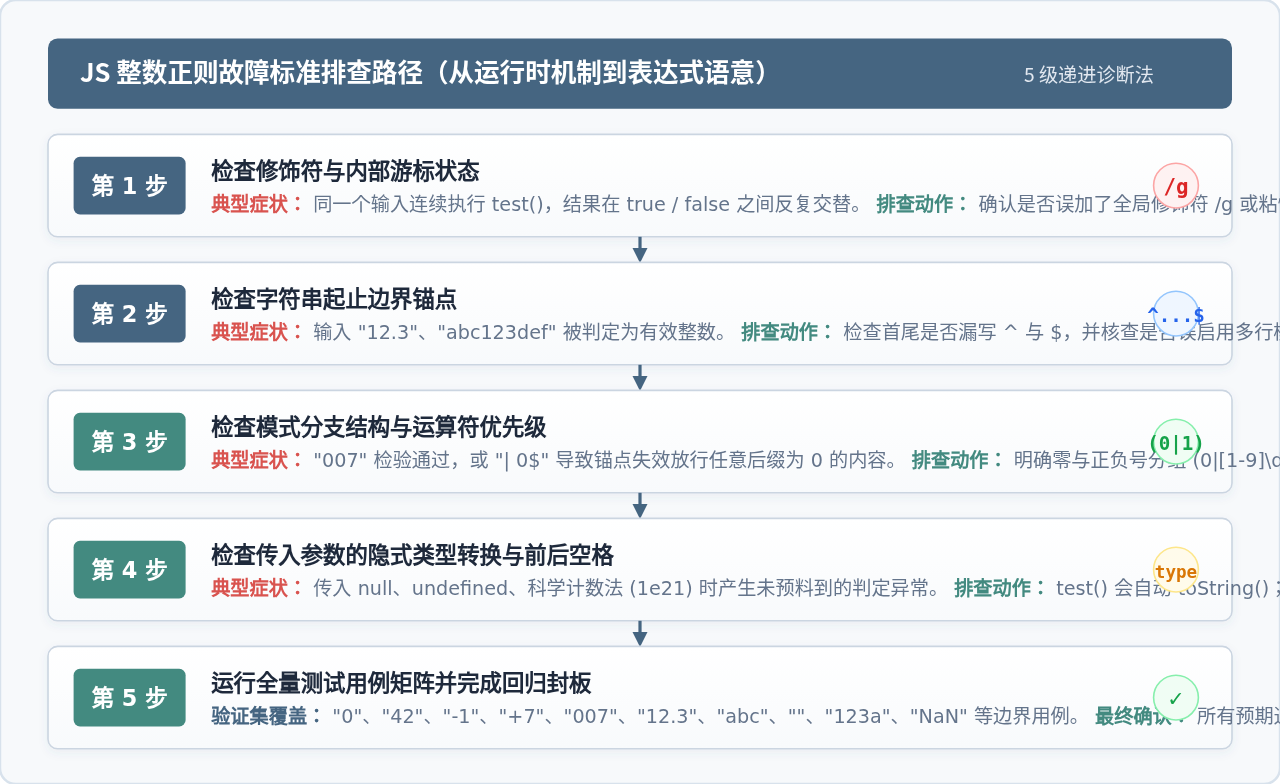
排查正则故障时,切忌盲目从网上复制一段新正则直接替换。未经系统排查的替换,往往只是用一个隐蔽的漏洞掩盖另一个已知漏洞。合理的排查应当从“JavaScript 运行时机制”逐步深入到“正则表达式语法语义”,排查顺序如下图所示:
第一步:排查修饰符与状态残留(检查是否误加 /g 或 /y)
这是排查过程中最容易被忽视、却也是发生频率最高的逻辑陷阱。当同一个数字(例如 "123")通过表单连续提交多次校验,或者在循环中连续调用 reg.test() 时,如果出现一次返回 true、下一次返回 false、第三次又变回 true 的偶发交替现象,问题百分之百出在正则表达式修饰符上。
在 ECMAScript 规范中,如果正则表达式带有全局修饰符 g(Global)或粘性修饰符 y(Sticky),该正则对象就会变成有状态对象(Stateful Object)。其实例会维护一个名为 lastIndex 的整数属性,记录上一次匹配成功的结束位置:
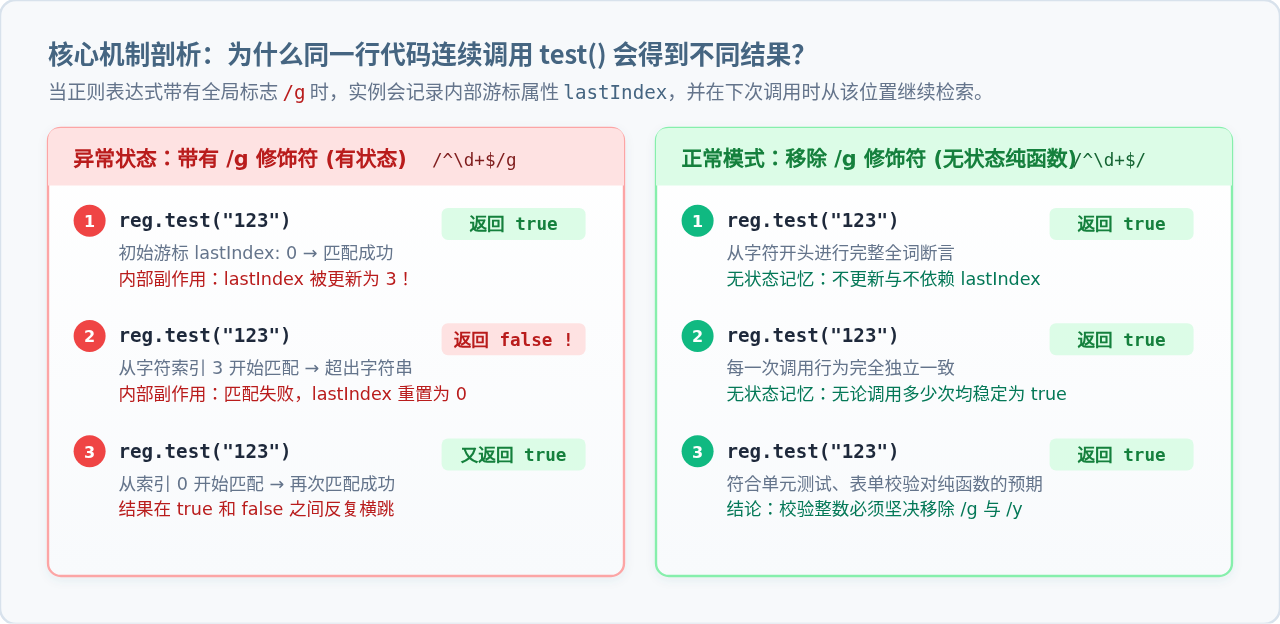
典型故障代码与运行表现
// 故障代码:无意中添加了 /g 全局修饰符
const isInteger = /^[0-9]+$/g;

console.log(isInteger.test("123")); // true  (lastIndex 从 0 更新为 3)
console.log(isInteger.test("123")); // false (从索引 3 开始检索,超出字符串长度,匹配失败,lastIndex 重置为 0)
console.log(isInteger.test("123")); // true (从 0 开始重新匹配成功)/g 或 /y 修饰符。如果正则对象是通过全局变量或模块单例导出的,去掉修饰符后即为无状态的纯函数,每次调用均从索引 0 开始断言。
第二步:排查边界匹配锚点(检查是否缺失 ^ 和 $)
如果测试阶段发现输入 "12.3"、"abc123def" 或 "100px" 依然返回 true,排查重点应立即转移到正则表达式的首尾边界锚点。
RegExp.prototype.test() 的默认行为是“包含性检索”:只要目标字符串的任意子串能够满足模式,方法就会立即判定为 true。很多开发者误以为 \d+ 就是“纯数字校验”,但它实际表示的是“包含至少一个连续数字”。
边界缺失排查对比
// 故障 1:完全未加首尾锚点
const regBad1 = /\d+/;
regBad1.test("abc123def"); // true(仅匹配了中间的 "123" 部分)
regBad1.test("3.1415926");  // true(浮点数完全漏网!)

// 故障 2:只加了起始锚点,遗漏结束锚点
const regBad2 = /^\d+/;
regBad2.test("123px");     // true(匹配了开头的 "123",后缀字母被忽略)

// 正确做法:必须同时具备起始锚点 ^ 与结束锚点 $
const regGood = /^\d+$/;
regGood.test("123px");     // false(完整全词断言拦截)
regGood.test("3.14"); // false(完整全词断言拦截)/m(Multiline)修饰符,^ 和 $ 的匹配语义会发生改变:它们不仅匹配整个字符串的开始与结束,还会匹配换行符(
、 )之后的位置。如果被校验字符串包含多行文本,/m 可能会导致某一单行符合数字而误判通过。判断单值整数时,请确保不开启 /m。
第三步:排查模式分支与运算优先级(检查 0、负号与前导零)
当修饰符与首尾锚点都确认无误后,如果依然出现“007 通过校验”或者“带负号数字异常”的问题,则说明正则表达式内部的逻辑分支和运算符优先级存在语法漏洞。
1. 管道符优先级断裂漏洞
正则表达式中的竖线管道符 | 优先级极低,甚至低于普通的字符连接。许多开发者试图编写“非零开头的一串数字,或者单独一个 0”时,写出了如下错误代码:
// 严重漏洞模式:未将管道符分支封装在括号中
const wrongReg = /^[+-]?[1-9]\d*|0$/;
该表达式由于缺少括号,实际被解析为两个完全分离的独立分支:
- 左侧分支:
^[+-]?[1-9]\d*—— 具有起始锚点,但没有结束锚点!像"123abc"这样的字符串匹配左侧分支后直接返回true。 - 右侧分支:
0$—— 具有结束锚点,但没有起始锚点!像"foo_bar_0"这样以 0 结尾的任意字符匹配右侧分支后直接返回true。
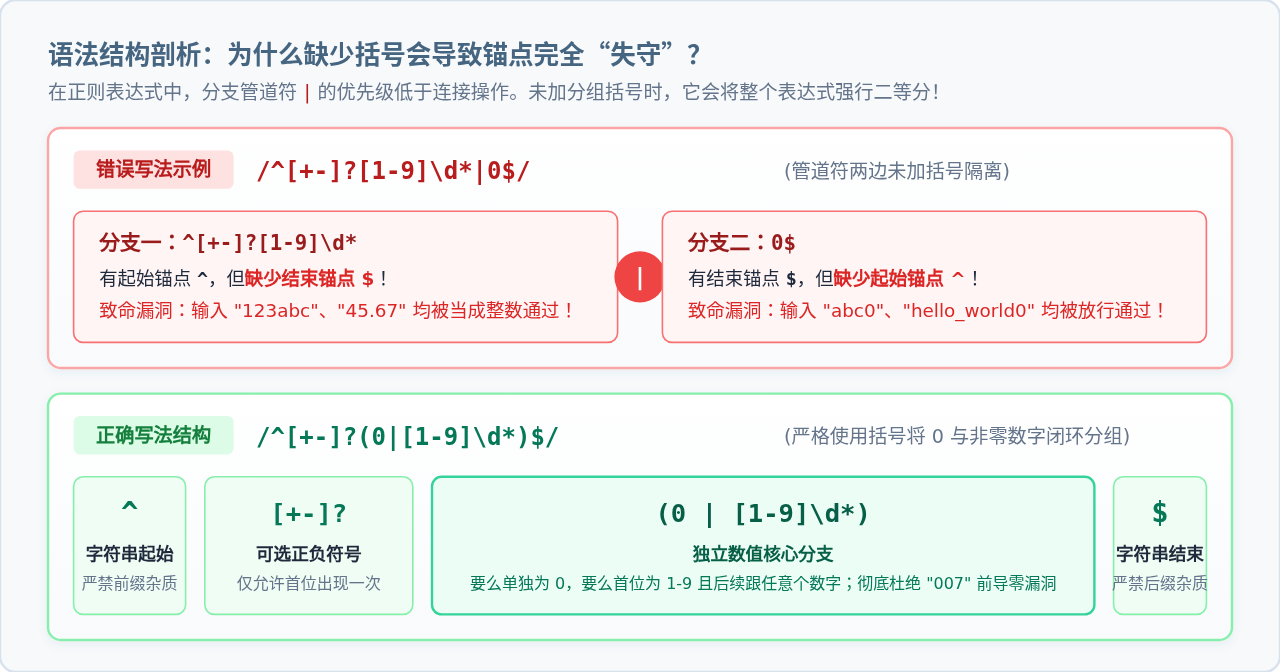
2. 前导零(Leading Zero)业务漏洞
直接使用 /^\d+$/ 判断非负整数虽然能拦截字母和浮点数,但会允许诸如 "01"、"007"、"000" 的输入。在订单编号、金额计算或数据库 ID 校验中,带有前导零的数字常会被误解析为八进制或破坏唯一键约束。
严密模式定义:整数必须区分为两类互斥情况——要么是单独的数字 0;要么首位必须是 1-9,后续跟随 0 到任意个 \d。通过非捕获分组或标准捕获括号将其封装:^(0|[1-9]\d*)$。
第四步:排查输入类型的隐式转换与预处理
在排查完正则本身的字面量后,必须排查调用处传入的数据类型。RegExp.prototype.test() 接收的参数类型为字符串。如果传入了其他类型的值,JavaScript 引擎会在内部对其调用抽象操作 ToString(value),由此产生隐蔽误判。
| 传入原始值 | 内部隐式转换后的字符串 | /^\d+$/.test(val) 结果 | 故障原因分析 |
|---|---|---|---|
null |
"null" |
false |
表面上返回 false,但若是包含字母的宽松正则可能产生意外命中。 |
undefined |
"undefined" |
false |
隐式字符串化,掩盖了未传参或空引用的程序缺陷。 |
1e21 |
"1e+21" |
false |
极大整数转为科学计数法字符串后,被 \d+$ 误拦截! |
" 123 " |
" 123 " |
false |
首尾包含不可见空格,被 ^ 与 $ 判定为非法字符。 |
function isValidIntegerString(value) {
  // 1. 类型守卫:必须为字符串且非空
  if (typeof value !== 'string') return false;

  // 2. 清理首尾空白
  const trimmed = value.trim();
  if (trimmed === '') return false;

  // 3. 执行无状态正则判定
  return /^[+-]?(0|[1-9]\d*)$/.test(trimmed);
}
第五步:标准模式选型与全量边界用例回归
根据业务场景的不同,对“整数”的具体范围定义也不同。排查时务必确认业务是需要“严格正整数”、“自然数(非负整数)”还是“包含正负号的完整整数”。
常见业务场景的标准正则模板
- 严格正整数(大于 0,不含 0,无前导零):
/^[1-9]\d*$/ - 非负整数(自然数,包含 0,无前导零):
/^(0|[1-9]\d*)$/ - 完整整数(允许负数,包含 0,可选正号,无前导零):
/^[+-]?(0|[1-9]\d*)$/ - 严格禁止带符号的零(拦截 -0 与 +0):
/^(0|[-+]?[1-9]\d*)$/
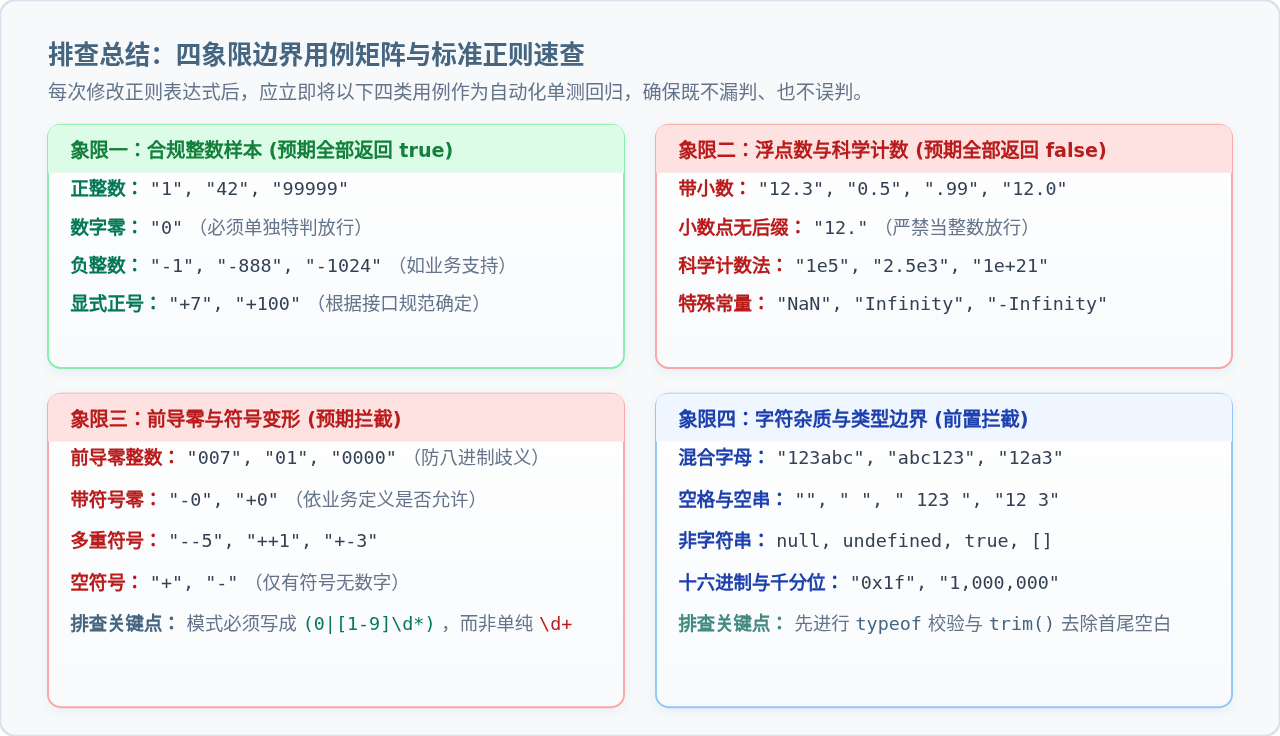
自动化测试回归套件示例
在排查并修复正则表达式后,建议在项目中直接运行以下断言测试集,以确认问题彻底解决且没有引入负面回归:
// 完整整数标准验证函数
const INTEGER_REGEX = /^(0|[-+]?[1-9]\d*)$/;

function isInteger(val) {
  if (typeof val !== 'string') return false;
  const str = val.trim();
  return INTEGER_REGEX.test(str);
}

// 验证用例矩阵
const testCases = [
  // 预期合法 (true)
  { input: "0", expected: true, desc: "数字零" },
  { input: "42", expected: true, desc: "标准正整数" },
  { input: "-100", expected: true, desc: "标准负整数" },
  { input: "+7", expected: true, desc: "带正号整数" },
  { input: " 99 ", expected: true, desc: "首尾带空格(经trim后通过)" },

  // 预期拦截 (false)
  { input: "", expected: false, desc: "空字符串" },
  { input: "007", expected: false, desc: "带前导零正数" },
  { input: "00", expected: false, desc: "多重零" },
  { input: "-0", expected: false, desc: "负零拦截" },
  { input: "12.3", expected: false, desc: "标准浮点数" },
  { input: "12.", expected: false, desc: "带小数点缺后缀" },
  { input: ".5", expected: false, desc: "无整数位小数" },
  { input: "123a", expected: false, desc: "后缀字母杂质" },
  { input: "abc123", expected: false, desc: "前缀字母杂质" },
  { input: "1e5", expected: false, desc: "科学计数法" },
  { input: "+-5", expected: false, desc: "双重符号" }
];

let hasError = false;
testCases.forEach(({ input, expected, desc }) => {
  const result = isInteger(input);
  if (result !== expected) {
    console.error(`[FAIL] ${desc}: 输入 "${input}" 预期为 ${expected}, 实际得到 ${result}`);
    hasError = true;
  }
});

if (!hasError) {
  console.log("所有边界测试用例全部通过,整数正则表达式排查验收完毕。");
}
排查顺序核心要点速查清单
当 JavaScript 整数正则验证再次出现异常时,可直接对照以下清单顺序排查:
- 修饰符核对:检查正则末尾是否有
/g或/y。如有,立即移除。 - 锚点核对:检查是否同时存在
^和$。严禁开启/m除非明确处理多行文本。 - 分支语法核对:检查竖线
|左右是否用小括号(...)包裹完整,核对是否拦截了007等前导零。 - 类型转换核对:检查调用前是否进行了非空判断、
typeof类型守卫与trim()预处理。 - 用例回归核对:将
"0"、"-1"、"007"、"12.3"、""带入测试用例跑通全量验证。
Ramda 与 Lodash FP 在 JavaScript 中的区别与选择
2026-11-07 14:01:31
为什么JS对象直接转字符串显示[object Object]
2026-11-06 23:11:05
手写JS isEmpty函数与Lodash实现的对比分析
2026-11-06 22:44:19
JS中slice、substring和substr截取字符串的区别与选用
2026-11-06 14:11:50
JavaScript常见报错排查:TypeError与ReferenceError解决思路
2026-11-06 09:33:26
相关标签: