

前后端都用JavaScript:Node.js怎么实现全栈开发统一
深入解析前后端都用JavaScript时,Node.js如何实现全栈开发统一。涵盖同构运行时边界、数据校验共享、Monorepo工程化协同、端到端接口契约与实践避坑指南。
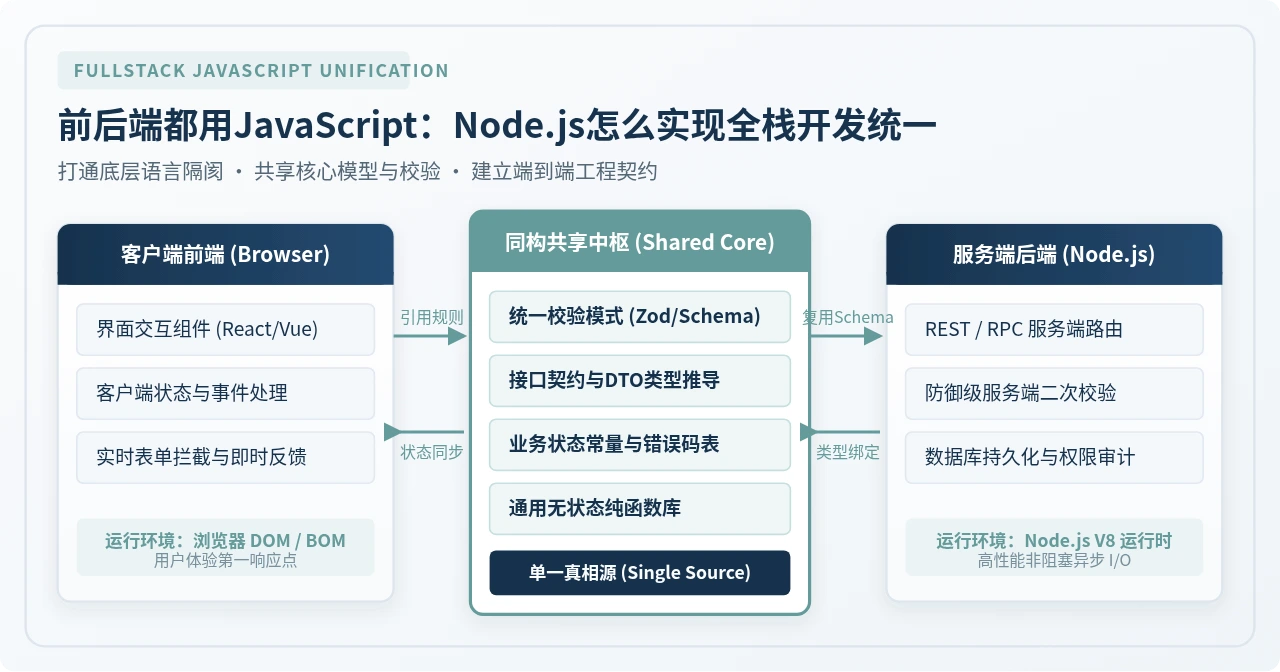
一、统一的底层:Node.js 与浏览器的同构契机与边界
在传统的多语言架构中,前端通常使用 JavaScript 或 TypeScript 编写交互界面,后端则采用 Java、Go 或 Python 提供接口。这种模式下,数据结构需要经历“前端定义一次、后端定义一次”的过程,任何字段名、校验范围或业务状态码的细微变动,都极易引发两端联调时的排查成本。
Node.js 的成熟改变了这一局面。由于 Node.js 同样搭载 Google V8 引擎,并且现代 Node.js(LTS 版本)全面支持 ECMAScript 标准规范(ES Modules,即 import 与 export 语法),前后端在语法执行机制上具有高度一致性。这种能够跨越浏览器和服务器运行的代码,被称为同构代码(Isomorphic / Universal JavaScript)。
然而,实现全栈统一的第一准则并不是“把所有代码混在一起”,而是准确划定同构的物理边界。浏览器与 Node.js 拥有完全不同的运行宿主环境:
- 浏览器专属宿主对象:包含
window、document、DOM 节点、LocalStorage、Web Workers 以及各类渲染管线 API。这些能力严格依赖客户端渲染环境,在 Node.js 中并不存在。 - Node.js 专属宿主对象:包含
process(进程管理)、Buffer(二进制缓冲区)、fs(文件系统)、net(底层套接字)以及服务端环境变量process.env。这些涉及底层操作系统资源的接口在浏览器中被沙箱隔离。
因此,前后端全栈统一的落脚点是:剥离宿主环境副作用的纯逻辑层(Pure Logic Layer)。只要一段代码是输入确定、输出确定的无副作用纯函数,它就能无缝在浏览器与 Node.js 服务端之间复用。
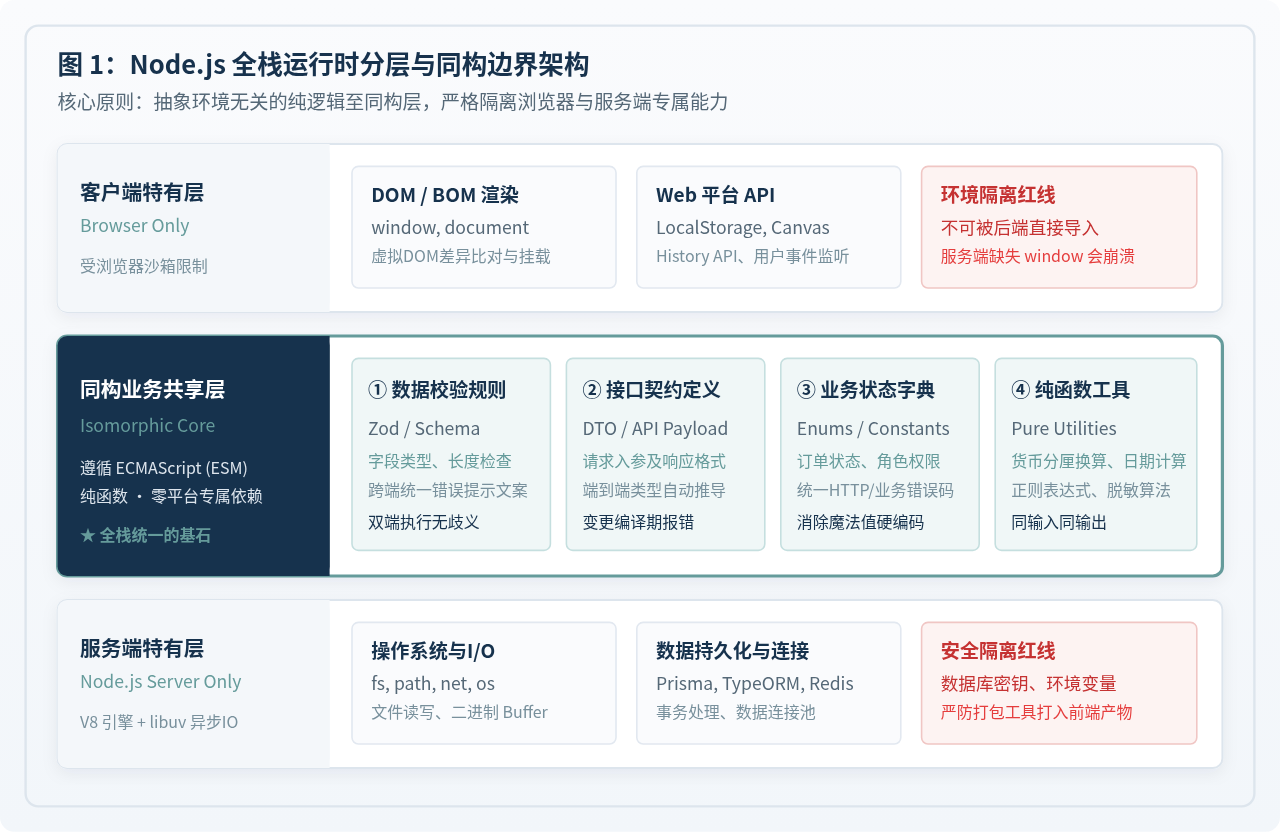
window 或 fs)。共享代码应当只依赖标准 ECMAScript 语法与无环境副作用的纯算法。
二、业务核心共享:数据模型与校验规则的同构实践
在典型的 Web 开发中,表单与数据校验是最容易产生重复代码与逻辑不一致的领域。为了提供良好的用户体验,前端需要即时验证用户输入的格式;为了保障系统安全,后端接口必须再次校验。如果前端与后端各自用不同语言或库维护一套规则,随着业务迭代,两端校验逻辑几乎必然产生分歧。
在 Node.js 全栈体系中,我们可以将数据模型与校验规则抽离为独立的同构模块,前后端直接引入同一份规则定义。以业界主流的轻量级 Schema 校验库 Zod 为例:
1. 编写单一真理源(Single Source of Truth)校验模块
在公共共享模块中定义用户注册所需的数据约束与错误提示文案。该文件不依赖任何浏览器或 Node.js 专属 API:
// packages/shared/src/validators/user.js
import { z } from 'zod';

export const UserRegisterSchema = z.object({
  username: z
    .string()
    .min(3, { message: '用户名长度不能少于 3 个字符' })
    .max(20, { message: '用户名长度不能超过 20 个字符' })
    .regex(/^[a-zA-Z0-9_]+$/, { message: '用户名仅支持字母、数字及下划线' }),
  email: z
    .string()
    .email({ message: '请输入合法的电子邮箱地址' }),
  password: z
    .string()
    .min(8, { message: '密码长度至少为 8 位' })
    .regex(/[A-Z]/, { message: '密码必须包含至少一个大写字母' })
    .regex(/[0-9]/, { message: '密码必须包含至少一个数字' }),
});
2. 客户端前端:实时拦截与即时反馈
前端表单组件在用户触发提交时,直接调用公共的 UserRegisterSchema。无需等待网络请求返回,即可秒级拦截格式错误并呈现与后端完全统一的提示文案:
// apps/web/src/components/RegisterForm.js
import { UserRegisterSchema } from '@fullstack/shared/validators/user';

async function handleFormSubmit(event) {
  event.preventDefault();
  const formData = {
    username: document.getElementById('username').value,
    email: document.getElementById('email').value,
    password: document.getElementById('password').value,
  };

  // 前端调用共享 Schema 进行安全校验
  const validationResult = UserRegisterSchema.safeParse(formData);

  if (!validationResult.success) {
    const errorMsg = validationResult.error.errors[0].message;
    showNotification(errorMsg, 'error'); // 即时在 UI 上呈现高亮反馈
    return;
  }

  // 校验通过,发起网络请求
  const response = await fetch('/api/v1/auth/register', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(validationResult.data),
  });
}
3. Node.js 服务端:路由层兜底防线校验
无论客户端是否进行了验证,任何外部 HTTP 请求都可以被直接伪造或通过自动化脚本绕过前端。Node.js 后端在路由中间件中复用完全相同的 Schema:
// apps/server/src/routes/auth.js
import express from 'express';
import { UserRegisterSchema } from '@fullstack/shared/validators/user';
import { createUser } from '../services/userService.js';

const router = express.Router();

router.post('/register', async (req, res, next) => {
  // 服务端直接复用相同 Schema 进行兜底验证
  const validationResult = UserRegisterSchema.safeParse(req.body);

  if (!validationResult.success) {
    return res.status(400).json({
      code: 'VALIDATION_FAILED',
      errors: validationResult.error.errors.map(err => ({
        field: err.path.join('.'),
        message: err.message,
      })),
    });
  }

  try {
    // validationResult.data 是经过校验清洗的安全数据
    const newUser = await createUser(validationResult.data);
    return res.status(201).json({ code: 'SUCCESS', data: newUser });
  } catch (error) {
    next(error);
  }
});
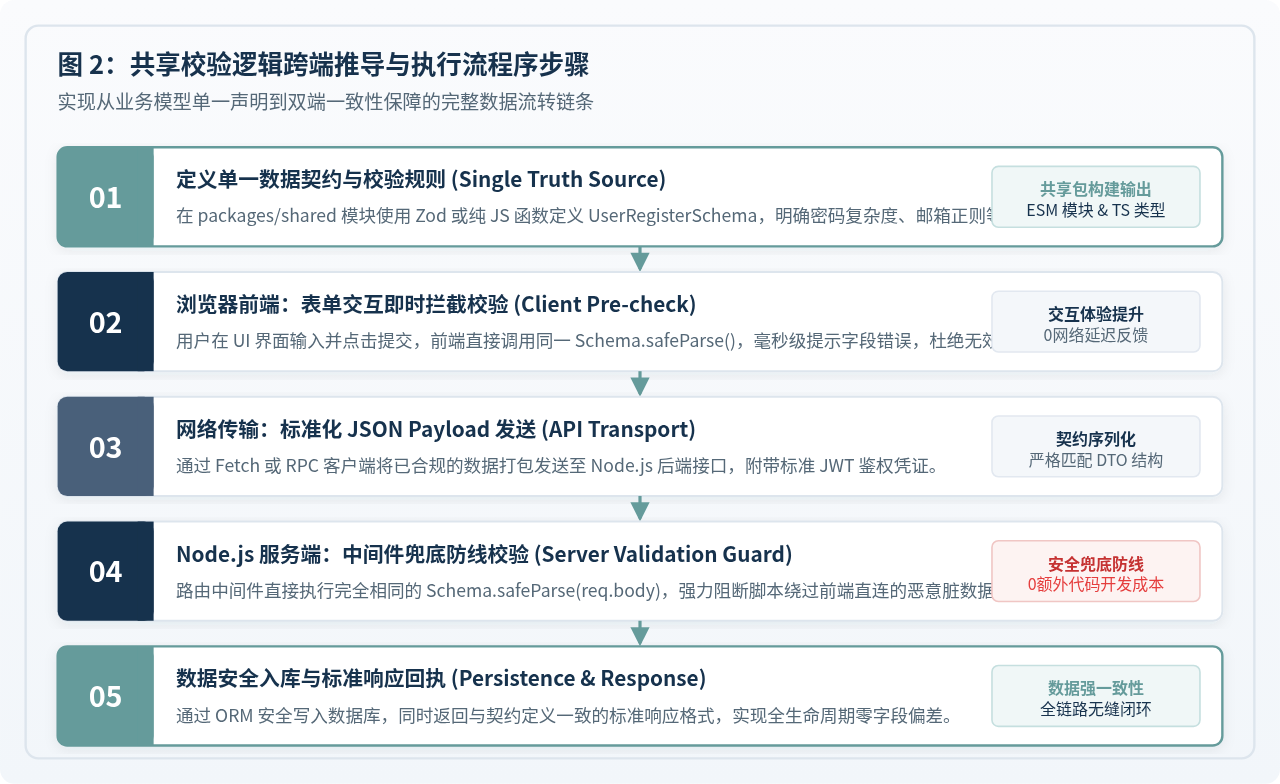
通过这种方式,当产品经理要求调整密码长度或放宽用户名限制时,开发者只需在 packages/shared 中修改一行规则,前端与后端的校验行为便在代码级别完全保持同步,从根本上杜绝了因规则不一致造成的线上隐患。
三、工程化支撑:从多仓库到 Monorepo 的协同模式
如果前后端代码分散在不同的代码仓库中,要实现上述逻辑共享,就必须将共享代码打包发布为私有的 npm 包。每当修改一个校验字段,都需要经历“修改包 -> 打包构建 -> 更新版本号 -> 发布到 npm 私有源 -> 前端更新依赖 -> 后端更新依赖”的冗长流程。这种高摩擦的维护成本往往会导致团队放弃共享,重新退回各自复制代码的老路。
Node.js 生态中解决这一痛点的黄金方案是Monorepo(单代码仓库)配合 Workspaces(工作区)机制。利用 pnpm 或 npm 的工作区功能,前后端项目与公共代码库共存同一代码仓库中,共享模块通过符号链接(Symlink)实时联调。
1. 标准全栈 Monorepo 目录结构规范
fullstack-javascript-monorepo/
├── package.json               # 根目录全局配置
├── pnpm-workspace.yaml        # 工作区定义文件
├── apps/
│   ├── web/                   # 前端应用(Vite + React / Vue)
│   │   ├── package.json
│   │   └── src/
│   └── server/                # 后端应用(Node.js + Fastify / Express)
│       ├── package.json
│       └── src/
└── packages/
    ├── shared/                # 业务共享核心库
    │   ├── package.json
    │   └── src/
    │       ├── validators/    # 共享表单与输入校验
    │       ├── constants/     # 业务常量与状态码
    │       └── utils/         # 纯计算工具函数
    └── types/                 # 跨端 TypeScript 契约与 DTO
        ├── package.json
        └── src/
2. 工作区软链接声明
在根目录的 pnpm-workspace.yaml 中声明子工程目录:
packages:
  - 'apps/*'
  - 'packages/*'
在 apps/web/package.json 与 apps/server/package.json 中,直接使用 workspace:* 协议声明对公共包的依赖:
{
  "name": "@fullstack/web",
  "dependencies": {
    "@fullstack/shared": "workspace:*",
    "@fullstack/types": "workspace:*"
  }
}
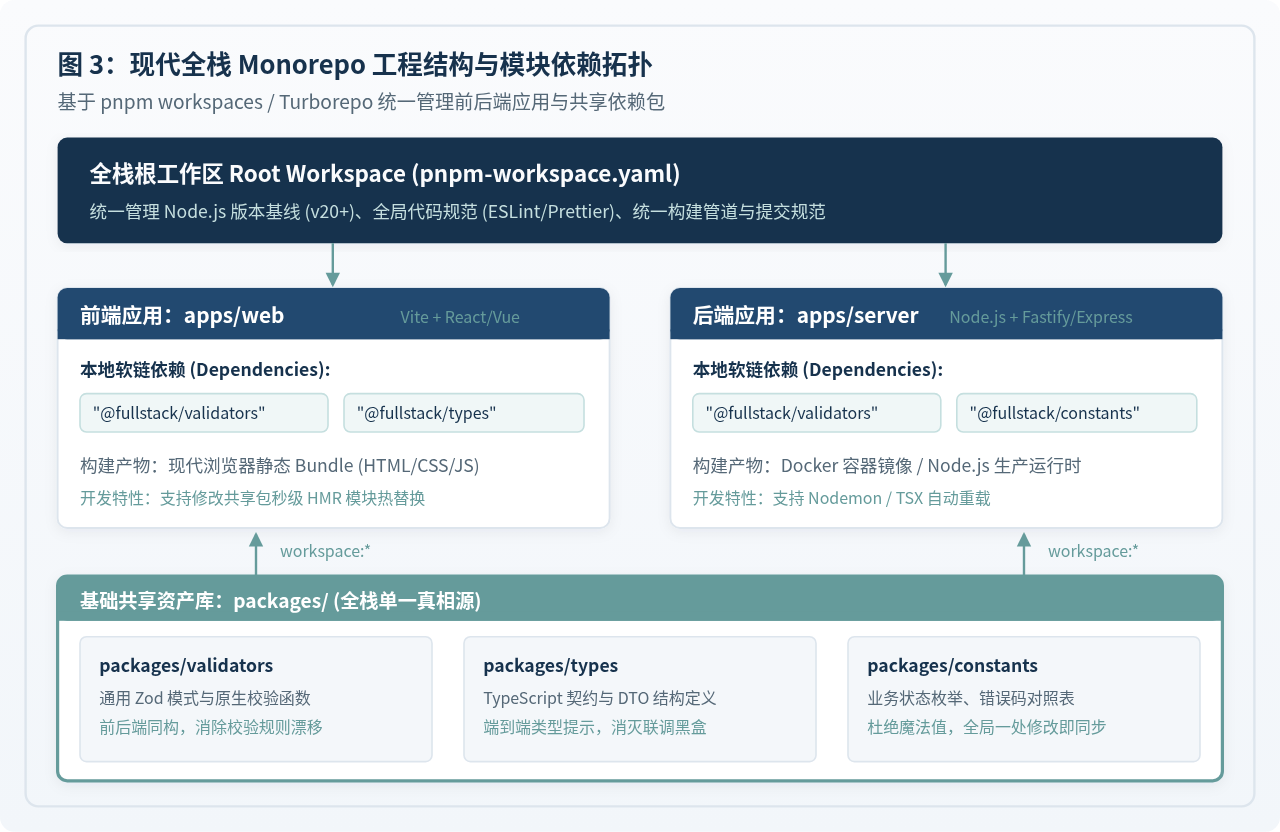
在本地开发时,无论是前端的 Vite 开发服务器,还是后端的 Node.js(搭配 tsx 或 nodemon),都能实时监听 packages/shared 的文件变动。只要修改一处公共逻辑,双端即刻热更新,既省去了发包流程,又确保了提交历史的原子性。
四、接口与契约统一:端到端类型安全与数据通信
传统前后端协作的另一大痛点是“接口契约不透明”。前端开发者通常依赖 API 文档开发,但文档往往滞后于代码更新;一旦后端调整了字段结构或返回值类型,前端在联调前很难察觉,最终在生产环境中触发 undefined is not an object 等运行时崩溃。
当两端统一使用 JavaScript / TypeScript 后,我们可以实现端到端契约推导(End-to-End Type Safety):
- 基于 Zod 自动反推 TypeScript 类型:使用
z.infer<typeof UserRegisterSchema>,无需手动重复编写 interface,校验器本身就是类型定义。 - 端到端全类型 RPC(如 tRPC):后端编写的 API 路由和输入输出类型,前端在编写 API 调用时可以直接获得智能补全,任何参数缺失或类型不匹配都会在保存时被编辑器报错拦截。
- 统一的错误码与业务状态:在
packages/constants中定义统一枚举,前后端引用同一个状态变量,消除字符串字面量(Magic Strings)硬编码带来的拼写错误。
- 警惕环境变量泄露:Node.js 后端拥有的数据库密码、私钥等环境变量绝不可在前端可见。在 Vite 等构建工具中,必须严格区分
VITE_前缀的公开变量与服务端的process.env私有变量。 - 避免在纯逻辑中混入复杂依赖:共享包应尽量保持轻量,不要将重量级库(如大型 UI 库或数据库驱动)引入共享包,否则会导致前端客户端 Bundle 体积急剧膨胀。
- 服务端 CPU 密集型任务隔离:Node.js 的底层执行机制是单线程事件循环。若在服务端复用某些复杂的计算密集型逻辑(如大图处理、深度加密循环),需通过 Worker Threads 或微服务隔离,避免阻塞服务器的主事件循环。
五、全栈统一方案选型与落地决策总结
实现前后端 JavaScript 统一并非必须一蹴而就,团队可以根据现有的业务体量与工程现状,采取渐进式演进路线:
- 第一阶段(轻量统一):保持现有独立架构,仅提取通用的数据字典、错误码常量和基础正则校验函数,通过 Git Submodule 或轻量本地包共享。
- 第二阶段(工程协同):将前后端整合至 Monorepo 仓库,引入统一校验库(如 Zod),实现核心业务规则与 DTO 契约的单一真相源治理。
- 第三阶段(深度同构):采用全栈框架(如 Next.js、Nuxt 或 Remix)或 tRPC 架构,打通服务端渲染(SSR)与客户端水合(Hydration),达成从代码结构到部署运维的全面一体化。
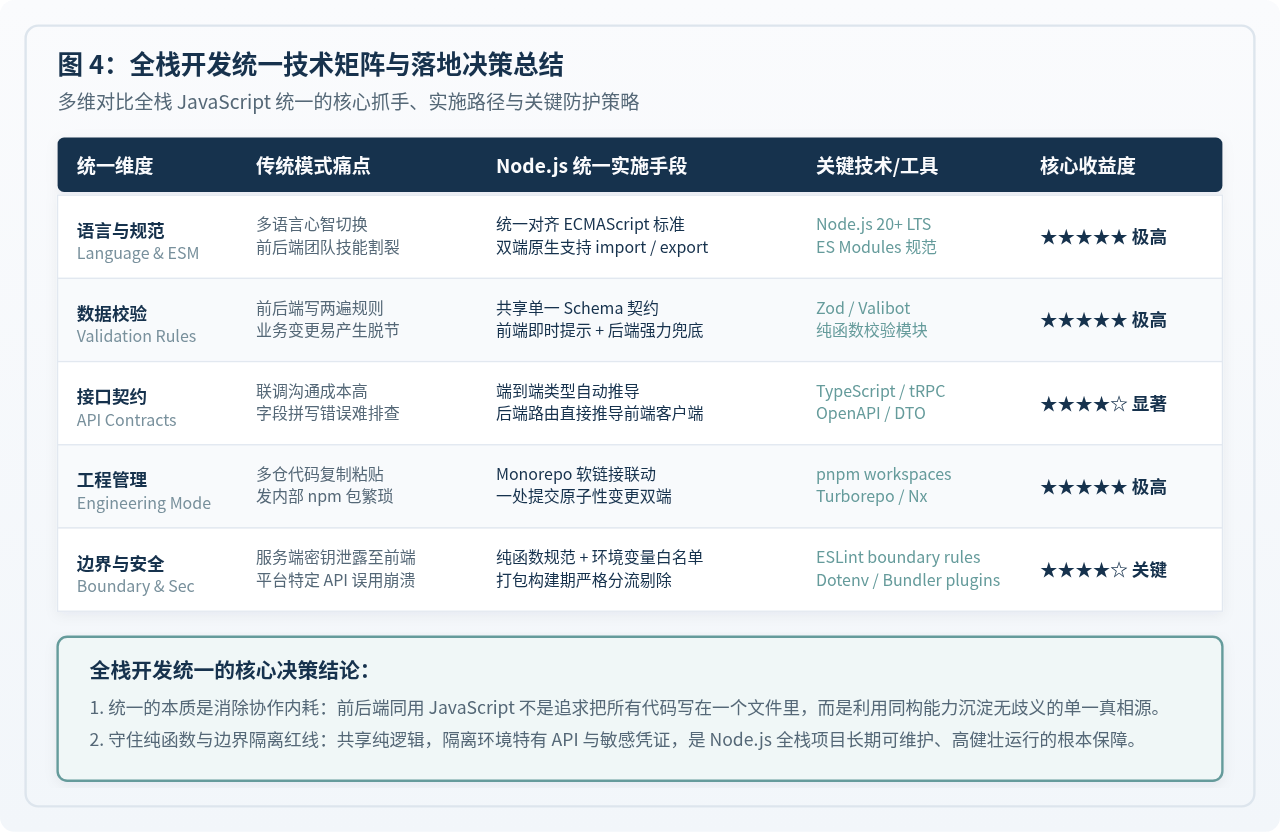
前后端都用 JavaScript,其真正的力量在于抹平技术栈壁垒带来的组织摩擦。借助 Node.js 的服务端运行时能力,开发者可以用统一的心智模型思考问题,让数据结构在从数据库到 UI 像素的整个流转链条中,始终保持准确、自洽与安全。
怎么在Node.js官网下载页面识别中文安装包
2026-11-11 14:29:43
Node.js 下载选 LTS 还是 Current 版本?
2026-11-11 14:28:12
Node.js LTS版与Current版有什么区别?初学者该下载哪个版本
2026-11-06 20:33:18
升级 Node.js 后 node-sass 或原生模块编译报错的修复方案
2026-11-06 15:25:22
Node.js中使用path模块获取文件名
2026-11-05 15:15:15







