免费开源的AI率检测方案推荐及本地部署指南
本文对比Fast-DetectGPT、Binoculars和GLTR等开源AI检测工具,解析其原理与适用场景,并提供Windows环境下通过WSL部署Fast-DetectGPT的详细指南,强调将检测分数作为辅助线索而非绝对裁决。
许多用户搜索“AI率检测”时,期待的是一个简单的百分比:粘贴文章即可获知AI生成的比例。然而,现有检测器输出的通常是模型评分或分类结果,而非对写作过程的直接追踪。一旦调整表达方式或切换语言,检测结果往往随之波动。
若你重视数据隐私或需要离线复查,开源项目值得尝试;但若指望仅凭一个分数就对文章性质下定论,这些工具无法提供确凿证据。更务实的策略是:先选择契合自身需求的工具,再将其输出视为辅助复核的线索。
先看检测方法,再决定用哪一类工具
开源AI文本检测主要遵循两条技术路径。一类是分类器:模型基于训练样本学习文本特征,进而输出类别或评分。另一类为零样本方法:利用语言模型对比文本的概率特征,并依据研究设定进行判断。这两类方法均支持本地运行,但在硬件成本、语言覆盖范围及结果解释方式上存在显著差异。
Fast-DetectGPT适合希望复现实验并深入理解检测原理的开发者。该工具以条件概率曲率为基础,提供本地交互演示,默认采用GPT-Neo 2.7B作为采样与评分模型。需注意,项目论文中报告的速度和AUROC指标源自特定数据集、模型组合及A100实验环境,不能直接等同于所有中文文章的识别准确率。若具备充足算力并希望研究模型差异,这是一个理想的切入点。
Binoculars利用两个相关语言模型的交叉困惑度进行零样本检测,提供Python调用接口及简易演示。作者明确指出,该工具在英语文本上表现更佳,其他语言效果较差,并建议结合人工判断。因此,对于中文内容,它仅适用于探索性实验,切勿将其标签直接解读为中文内容的“AI率”。
GLTR侧重于可视化文本中各词汇的可预测程度,旨在辅助人类观察写作模式,而非自动给出可靠的作者身份结论。若需解释“工具为何认为某段文本可疑”,这种可视化路径具有参考价值;但若需批量处理并进行二元判断,则非其所长。
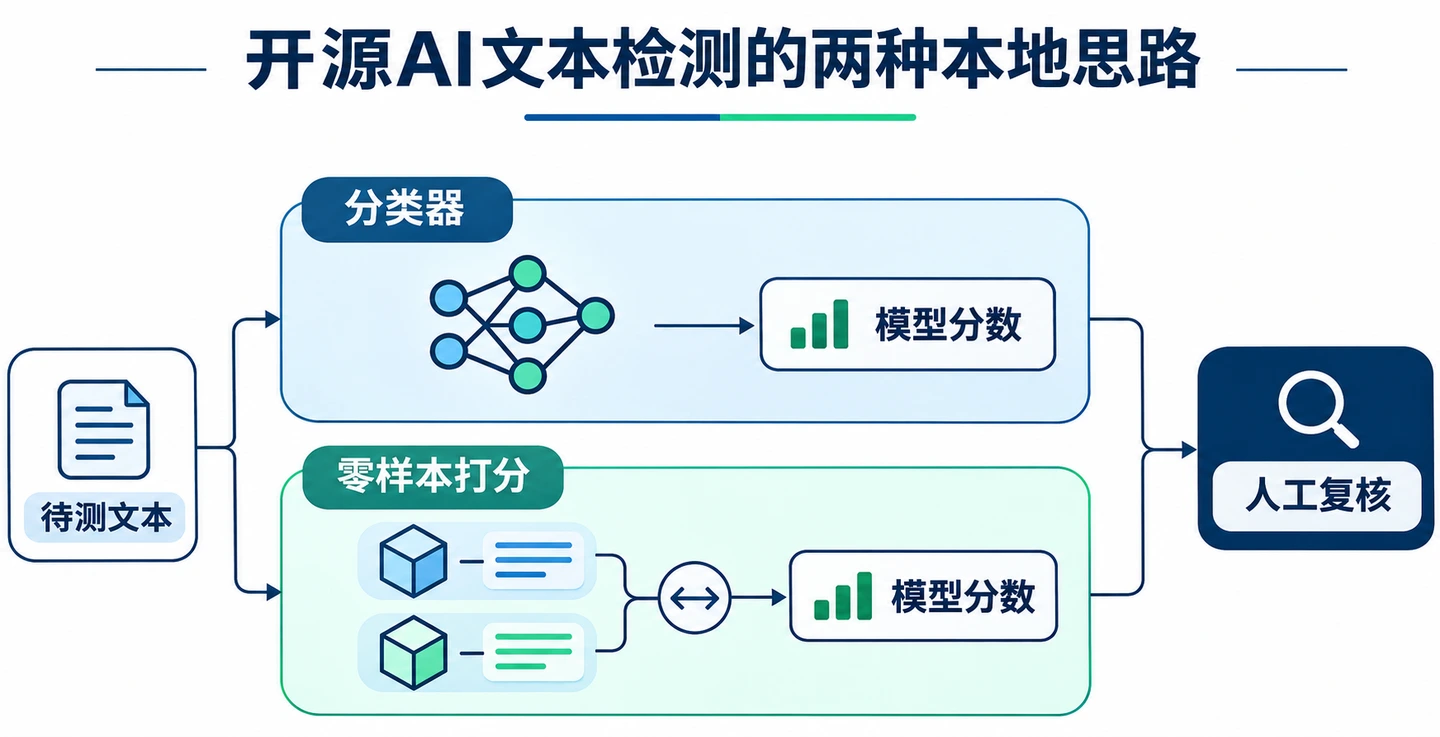
两种本地检测思路与人工复核流程
选型策略可简化为:研究模型评分选Fast-DetectGPT,英语零样本实验选Binoculars,人工检查文本分布选GLTR。若核心需求是检测中文,建议先利用自身领域和语种的人工及生成文本构建小型对照集,再评估这些开源实现是否值得部署。
在Windows电脑上用WSL运行Fast-DetectGPT
Fast-DetectGPT的仓库说明指定Python 3.8和PyTorch 1.10为开发环境,并通过setup.sh准备依赖;本地演示命令将启动交互输入界面。鉴于项目实验使用高显存GPU,且默认模型并非轻量级工具,该路线更适合愿意折腾环境且拥有足够内存或显存的用户。若电脑资源不足,建议先阅读代码和论文,无需急于下载大模型以测试分数。
Windows用户可在WSL2的Ubuntu终端中操作,避免直接将Linux项目脚本当作PowerShell命令执行。在确认已准备好Git、Python环境及项目所需的模型存储空间后,请依据仓库README中的环境说明运行以下命令:
git clone https://github.com/baoguangsheng/fast-detect-gpt.git
cd fast-detect-gpt
bash setup.sh
python scripts/local_infer.py
首次运行可能需要联网安装依赖并获取模型权重;随后输入文本并按提示结束,即可查看该实现计算出的检测分数。仓库还提供了更换采样模型的参数示例。由于依赖版本较旧,若安装失败,应先核对项目README、Python与PyTorch版本以及显卡驱动,再决定是否在独立环境中复现,不建议直接修改日常使用的Python环境。
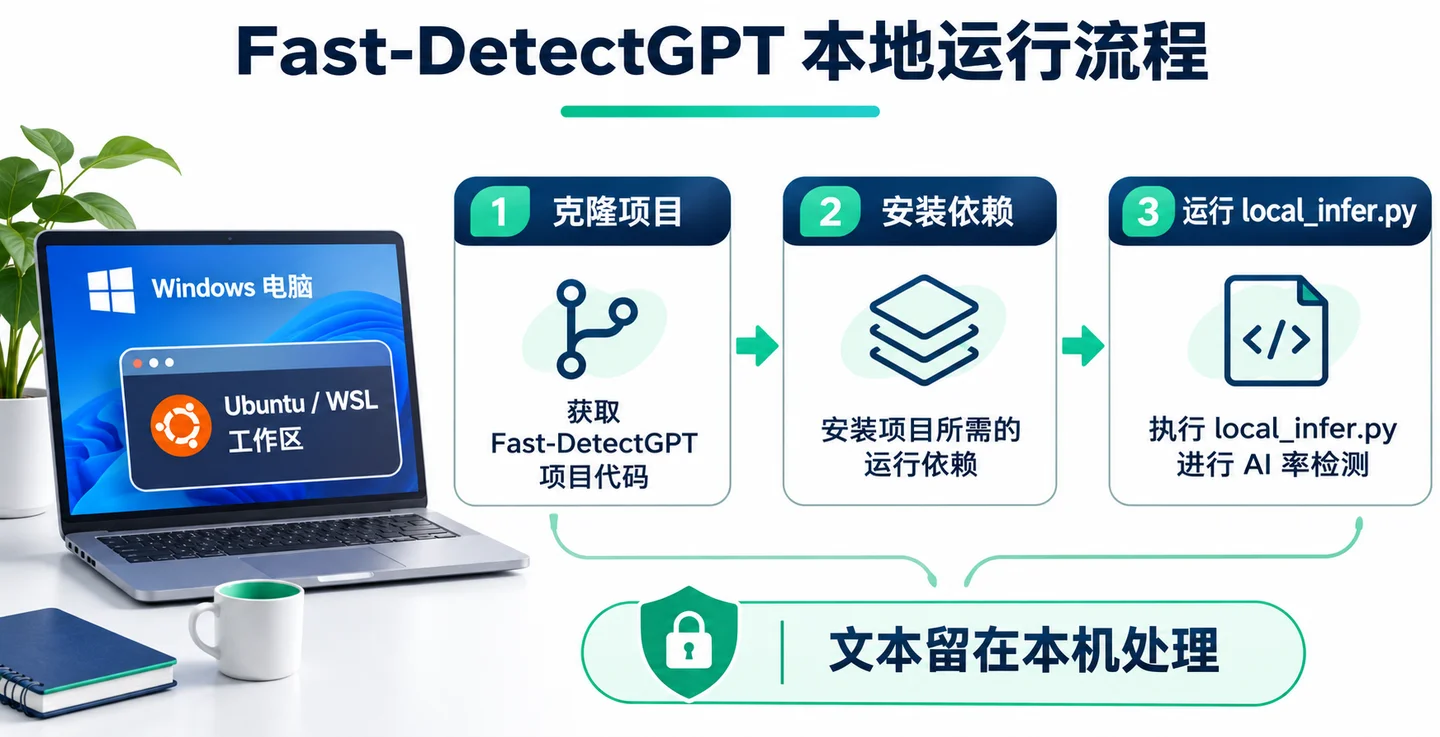
Fast-DetectGPT的本地运行路径
在本机运行并不自动意味着完全离线:模型首次下载仍需网络连接,部署前也应检查依赖来源和许可协议。完成下载后,本地推理可减少将待测文本提交给第三方网站带来的隐私泄露风险;但若将文本复制到在线演示或托管API,数据路径则截然不同。
把检测分数当线索,不当裁决
检测器关注的是文字特征与模型概率,无法洞察作者的构思、修改及引用资料过程。简短文本、格式固定的说明或术语密集的专业文章,往往缺乏可区分的语言特征;人工润色也会改变文本分布。因此,即使模型显示高分,也不能单独作为作者使用生成式AI的确凿证据。
尤其需注意语言边界:Binoculars官方仓库已说明其在英文上效果更好,OpenAI早期分类器也曾指出非英语表现明显较差,并因准确率低而停止服务。不同工具、语种、文本长度和数据集之间的分数缺乏统一量尺;简单平均几个网站给出的数字,并不能自动得到可信的“AI占比”。
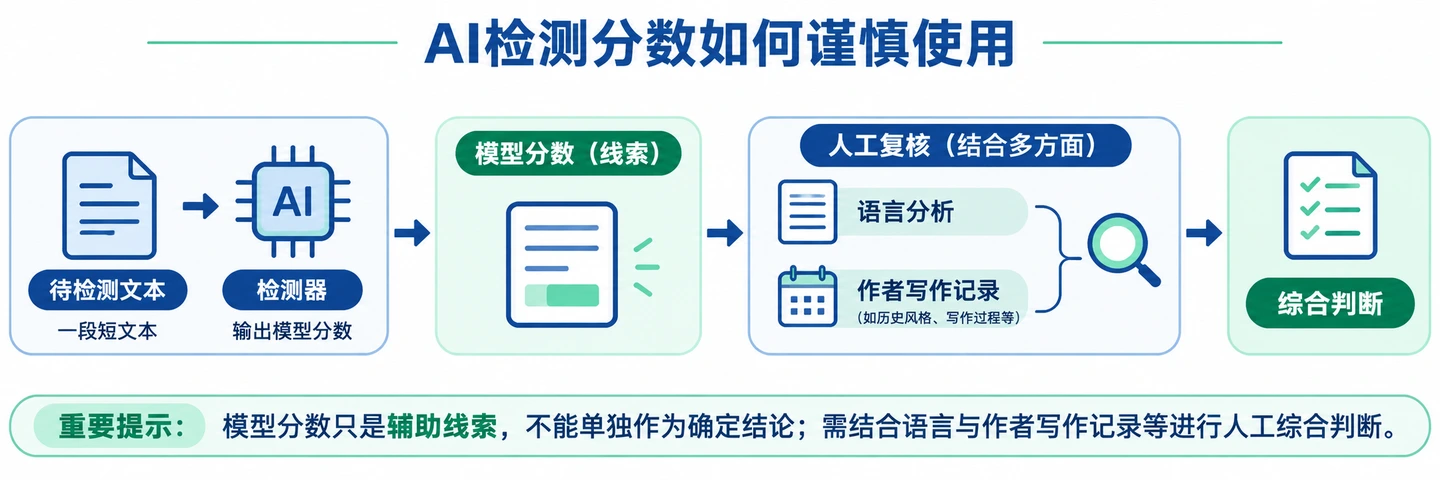
检测分数需要结合写作背景复核
若检测结果影响审核或申诉,最好保留原稿、版本记录、提纲和修改过程,并由熟悉主题的人员逐段复核事实与写作脉络。若仅为本地抽查,Fast-DetectGPT适合研究者了解零样本打分方式,Binoculars适合英语实验,GLTR适合观察文本预测性。开源带来的主要价值是可检查、可本地运行和便于复现,不是替人做出确定判断。
Google Veo 提示词技巧:怎么精准控制视频风格与镜头运动
2026-11-08 18:50:38
通义灵码插件自定义提示词(Prompt)编写指南
2026-11-07 22:21:56
DeepSeek和ChatGPT核心区别:技术架构与模型能力对比
2026-11-07 21:39:54
Gemini深度研究实战:怎么用AI完成文献综述与市场分析报告
2026-11-07 21:24:33
Stable Diffusion XL (SDXL) 模型训练指南及与SD1.5的差异
2026-11-07 21:12:41