JavaScript比较参数处理后中文乱码怎么解决
深入解析在 JavaScript 中进行参数排序、比对或签名校验时中文乱码与比较失败的根本原因,提供包含多重转义处理、GBK兼容解码、Unicode归一化及确定性参数比对的完整工程解决方案。
%E4%B8%8A%E6%B5%B7)与明文中文对比、网关多次调用 encodeURIComponent 产生双重转义(%25E4%...)、遗留系统传入非 UTF-8(如 GBK)字节导致原生 API 报错,以及 URLSearchParams 将空格转为 + 号或 Unicode 码位未规约。解决此问题的标准化路径是:先执行防崩溃的安全迭代反转义,统一还原为纯正中文字符;对 GBK 字节流引入 TextDecoder('gbk') 兼容;随后执行 normalize('NFC') Unicode 归一化;最后在统一的规范化格式下执行字典序排序与比对。
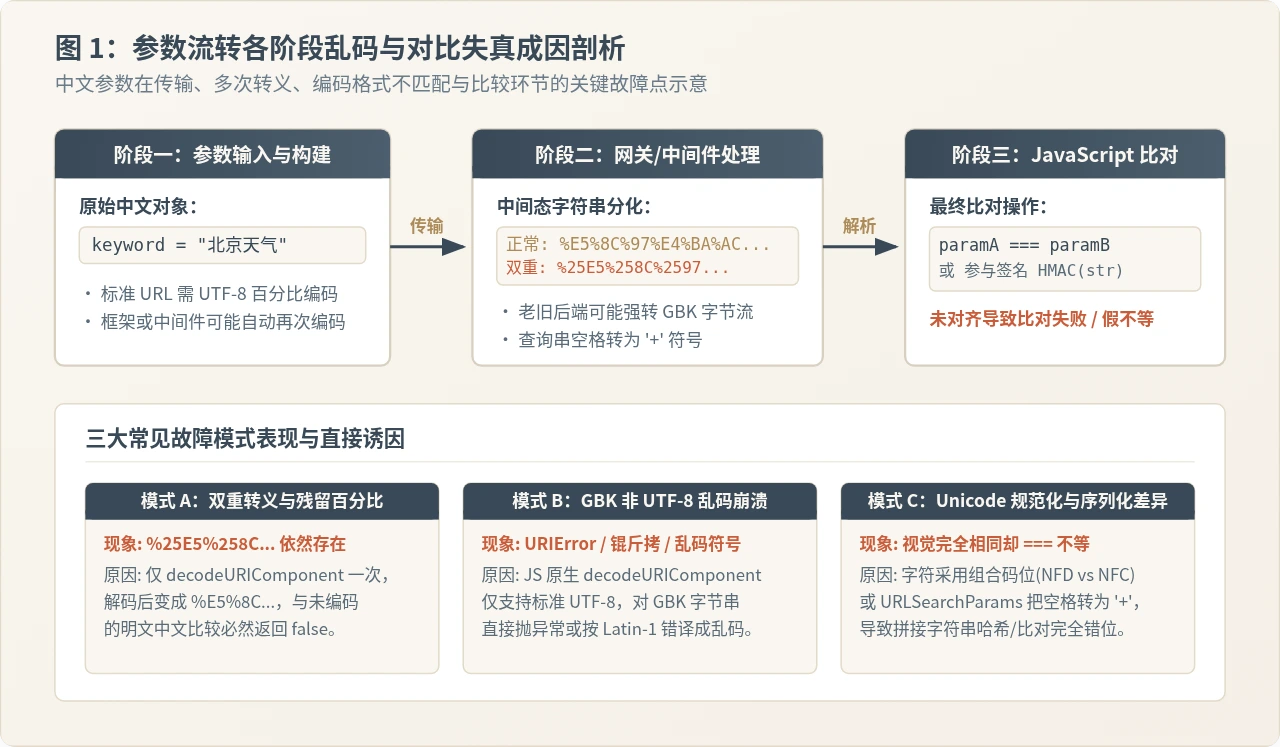
一、为什么比较参数时中文会“乱码”或比对失败?
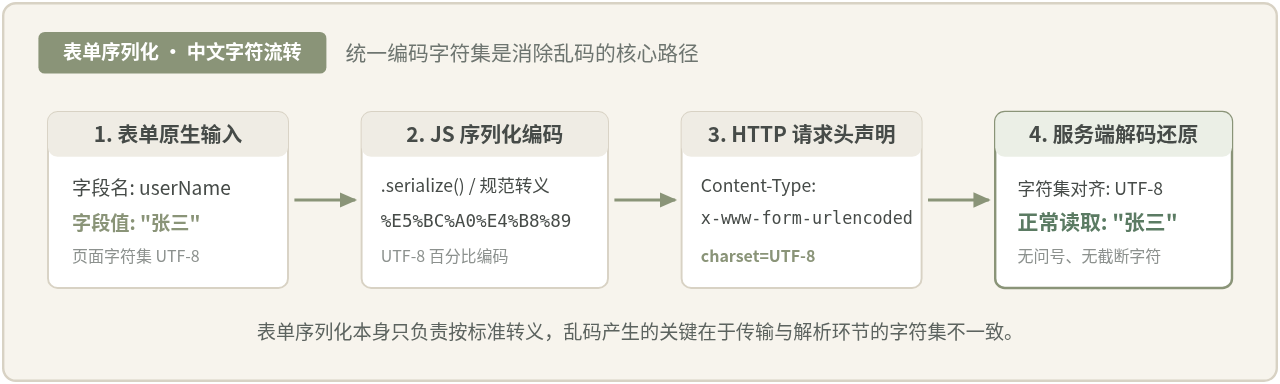
在前后端交互、接口防篡改签名计算(如支付宝、微信支付或自研 API 验签)以及 URL 路由状态同步场景中,我们经常需要对两个参数集合进行“深度比对”或“排序后拼接比对”。中文属于多字节字符(在 UTF-8 中通常占 3 个字节),在网络传输与参数解析过程中极易经历不同层次的转码变换。
当开发者发现两个本应包含相同中文内容的参数比对返回 false,或者在控制台输出一堆形如 %E5%8C%97%E4%BA%AC、%25E5%258C... 甚至 锟斤拷、ÉϺ£ 的乱码时,通常由以下四个具体原因造成:
- 单侧解码与基准脱节:比对的一方是从
window.location.search原始提取的未解码百分比字符串,另一方是业务代码中准备的明文 JavaScript 对象。二者直接进行===比较自然不相等。 - 多次调用编码导致的“双重转义”(Double Encoding):前端框架、Axios 拦截器或反向代理网关(如 Nginx、API Gateway)在处理 URL 参数时各自编码了一次,中文变成了
%25E4%25B8%258A%25E6%25B5%25B7。如果你的代码只调用了一次decodeURIComponent,得到的依然是带有百分号的字符串%E4%B8%8A%E6%B5%B7,无法还原出汉字。 - 非 UTF-8 字符集(GBK/GB2312)冲突:部分企业内网接口、银行网关或老旧 Web 页面采用 GBK 编码提交参数。当浏览器或 Node.js 原生的
decodeURIComponent尝试将 GBK 字节序列当成 UTF-8 解析时,会直接抛出URIError: URI malformed异常;若强行以 ISO-8859-1 解码则会变成诸如ÉϺ£的乱码。 - 规范化细节差异(空格与 Unicode 形式):
URLSearchParams.toString()遵循的是application/x-www-form-urlencoded规范,会将空格序列化为+;而 RFC 3986 规范要求将空格编码为%20。此外,不同系统(如 macOS 与 Windows 输入法)产生的组合中文字符在 Unicode 码位上有 NFD 和 NFC 之分,肉眼看着完全一样的汉字在计算机内部字节并不一致。
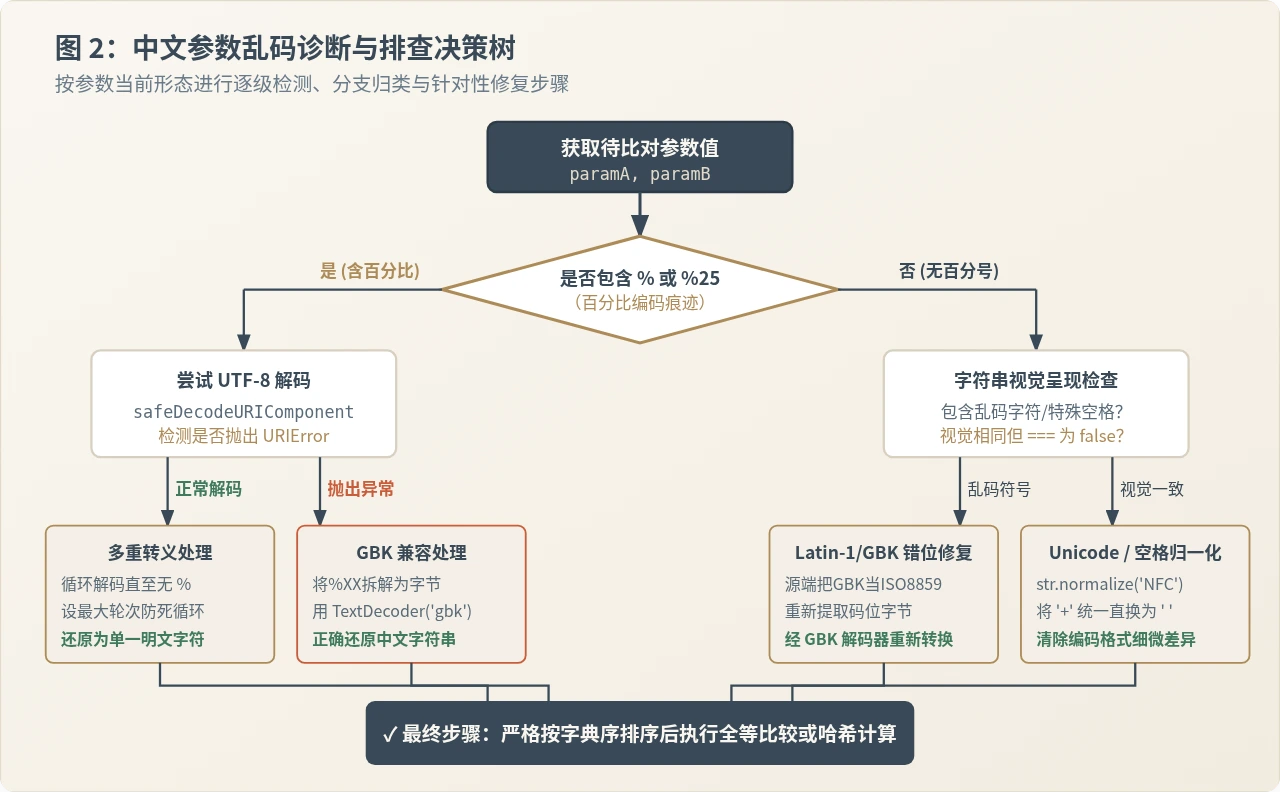
二、诊断与排查决策树:准确定位乱码形态
遇到中文乱码或比对异常时,切忌盲目随意添加 decodeURI 或 encodeURIComponent,否则极易引发更复杂的二次编码问题。排查的第一步应当是打印原始待比对字符串的真实字符构成,明确当前参数究竟处于哪一种形态。
根据输入参数的具体特征,我们可以通过以下流程进行快速分支定位并执行对应的修复措施:
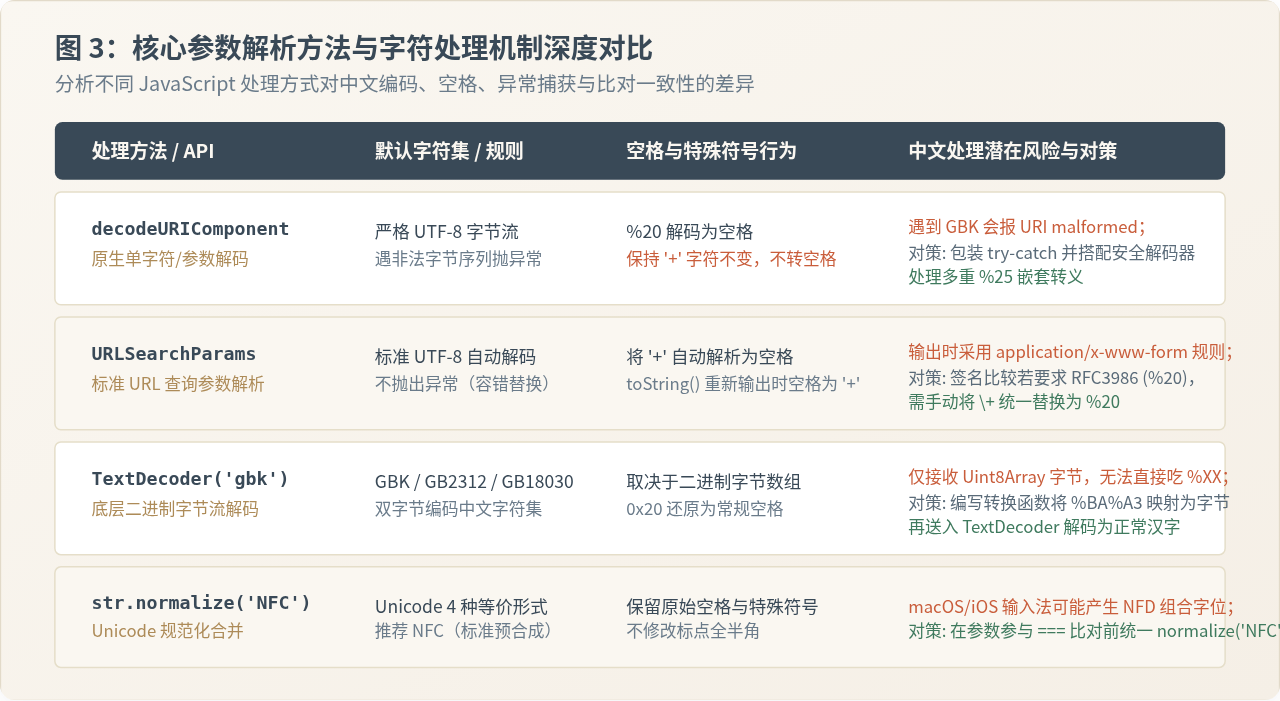
三、核心场景应对方案与实用代码
场景 1:多重转义与安全防崩溃解码
当参数中存在 %25(百分号本身的编码),说明参数被重复执行了编码操作。另外,若参数中包含孤立的 %(例如用户输入 折扣 80%),直接调用 decodeURIComponent 会导致整个程序崩溃。因此必须构建一个具备最大轮次限制且能够捕获异常的循环解码器:
/**
 * 安全循环解码函数
 * 自动剥离多重转义,防止 URIError 导致程序崩溃
 * @param {string} str 待解码字符串
 * @param {number} maxDepth 最大尝试解码层级(防死循环,默认5次)
 * @returns {string} 解码后的纯文本字符串
 */
function safeDecodeParam(str, maxDepth = 5) {
  if (typeof str !== 'string' || !str) return str;

  let current = str;
  let depth = 0;

  while (depth < maxDepth) {
    // 快速检测:若不再含有百分号,说明已彻底还原为明文,直接退出
    if (!current.includes('%')) {
      break;
    }

    try {
      const next = decodeURIComponent(current);
      // 解码前后内容无变化,说明无法继续解码
      if (next === current) {
        break;
      }
      current = next;
      depth++;
    } catch (err) {
      // 捕获 URIError: URI malformed,针对单个百分号做容错替代
      // 常见于包含未正确编码的特殊字符
      try {
        // 将非法百分号单字替换为已编码格式再尝试一次
        current = decodeURIComponent(current.replace(/%(?![0-9a-fA-F]{2})/g, '%25'));
        break;
      } catch (_) {
        // 若仍失败,返回当前最好结果
        break;
      }
    }
  }

  return current;
}

// 示例验证:
console.log(safeDecodeParam("%E4%B8%8A%E6%B5%B7"));             // 示例输出: "上海" (单层编码)
console.log(safeDecodeParam("%25E4%25B8%258A%25E6%25B5%25B7")); // 示例输出: "上海" (双重转义自动穿透)
console.log(safeDecodeParam("北京天气%20特报"));                 // 示例输出: "北京天气 特报"
场景 2:非 UTF-8(GBK/GB2312)服务端参数的兼容解码
某些历史系统或特定金融机构返回的 URL 中,中文是以 GBK 字节编码的,例如汉字“中国”在 UTF-8 中是 %E4%B8%AD%E5%9B%BD,而在 GBK 中则是 %D6%D0%B9%FA。如果把 GBK 的百分比串喂给 decodeURIComponent,会立刻抛出异常。
现代浏览器以及 Node.js(v12+)均内置了标准的 TextDecoder API,原生支持 'gbk' 和 'gb18030'。我们可以将百分比编码串转换为无符号 8 位整数数组(Uint8Array),交由 GBK 解码器输出正常中文:
/**
 * 将百分比编码字符串按指定字符集(如 gbk)解码
 * @param {string} percentStr 百分比编码串,例如 "%D6%D0%B9%FA"
 * @param {string} encoding 字符集名称,支持 'gbk', 'gb2312', 'gb18030', 'utf-8'
 * @returns {string} 解码后的中文字符串
 */
function decodePercentByCharset(percentStr, encoding = 'gbk') {
  if (typeof percentStr !== 'string' || !percentStr) return percentStr;

  // 1. 如果是标准的 UTF-8 且能直接解析,优先走原生逻辑提升性能
  try {
    return decodeURIComponent(percentStr);
  } catch (e) {
    // 抛出 URI malformed,进入字节流解码通道
  }

  // 2. 将百分比序列转化为字节数值数组
  const bytes = [];
  const regex = /%([0-9a-fA-F]{2})|(.)/g;
  let match;

  while ((match = regex.exec(percentStr)) !== null) {
    if (match[1]) {
      // 百分比后十六进制字节
      bytes.push(parseInt(match[1], 16));
    } else if (match[2]) {
      // 常规 ASCII 字符
      bytes.push(match[2].charCodeAt(0));
    }
  }

  // 3. 构造 Uint8Array 并使用 TextDecoder 转换
  try {
    const decoder = new TextDecoder(encoding);
    return decoder.decode(new Uint8Array(bytes));
  } catch (err) {
    console.error(`字符集 ${encoding} 解码失败:`, err);
    return percentStr;
  }
}

// 示例验证(GBK 字节串解码):
const gbkQuery = "%D6%D0%B9%FA"; // "中国" 的 GBK 百分比编码
console.log(decodePercentByCharset(gbkQuery, 'gbk')); // 示例输出: "中国"
场景 3:Unicode NFC 规范化与空格编码差异消除
在比较从两端提取的中文参数时,经常出现一个极其隐蔽的问题:在控制台 console.log() 打印出来的汉字或拼音字母肉眼看完全一致,但是使用 === 比对却始终返回 false。这是因为同一个中文或变音符号可能由单一预合成字符(NFC)表示,也可以由基础字符加组合字符标记(NFD)表示。
另外,URLSearchParams 会将空格转换成 +,而常规 URL 编码使用 %20。如果不将空格符号与 Unicode 形式归一化,直接字符串比对必然失真:
/**
 * 文本内容规范化处理
 * 统一消除 Unicode 码位差异与空格格式分歧
 * @param {string} val 待规范化文本
 * @returns {string} 规范化后的文本
 */
function normalizeTextValue(val) {
  if (typeof val !== 'string') return String(val);

  return val
    // 1. 统一将 '+' 转为空格(消除表单编码与 URI 编码对空格的分歧)
    .replace(/\+/g, ' ')
    // 2. 执行 Unicode NFC 组合形式归一化
    .normalize('NFC')
    // 3. 去除首尾无意义的隐形空格
    .trim();
}
四、生产级方案:参数确定性比对与验签流水线
为了从根本上杜绝中文参数乱码、排版格式错乱以及比对失败,工程上必须遵循“进入时解码归一,比对时统一度量,离开时确定性序列化”的原则。以下提供一套开箱即用的工业级参数比对与规范化工具套件:
/**
 * 生产级参数规范化与深度比对工具
 */
class ParameterNormalizer {
  /**
   * 将任意参数对象或查询字符串解析为纯净、已解码、标准化的 Map
   * @param {string|object|URLSearchParams} input
   * @returns {Record} 规范化后的键值映射
   */
  static parseToNormalizedRecord(input) {
    const result = {};

    // 统一转为键值对遍历结构
    let entries = [];
    if (typeof input === 'string') {
      // 剥离可能存在的 URL 前缀或问号
      const queryString = input.includes('?') ? input.split('?')[1] : input;
      const searchParams = new URLSearchParams(queryString);
      for (const [key, val] of searchParams.entries()) {
        entries.push([key, val]);
      }
    } else if (input instanceof URLSearchParams) {
      for (const [key, val] of input.entries()) {
        entries.push([key, val]);
      }
    } else if (input && typeof input === 'object') {
      entries = Object.entries(input);
    }

    // 对每个键值对进行深度安全解码与归一化
    for (const [rawKey, rawVal] of entries) {
      // 1. 键名与键值多层安全反转义
      const decodedKey = safeDecodeParam(String(rawKey));
      const decodedVal = safeDecodeParam(String(rawVal ?? ''));

      // 2. Unicode 与字符形式规范化
      const cleanKey = normalizeTextValue(decodedKey);
      const cleanVal = normalizeTextValue(decodedVal);

      result[cleanKey] = cleanVal;
    }

    return result;
  }

  /**
   * 按照键名 ASCII 字典序生成唯一的规范化查询串
   * 用于接口验签比对、哈希生成或状态比对
   * @param {Record} record
   * @param {boolean} encodeValues 输出时是否进行标准 RFC 3986 编码
   * @returns {string} 确定性排列的参数字符串
   */
  static serializeCanonical(record, encodeValues = true) {
    const sortedKeys = Object.keys(record).sort();

    return sortedKeys
      .map(key => {
        const val = record[key];
        if (encodeValues) {
          // 采用 RFC 3986 规范(严格编码,空格输出为 %20,十六进制大写)
          const encKey = encodeURIComponent(key);
          const encVal = encodeURIComponent(val)
            .replace(/[!'()*]/g, c => `%${c.charCodeAt(0).toString(16).toUpperCase()}`);
          return `${encKey}=${encVal}`;
        }
        return `${key}=${val}`;
      })
      .join('&');
  }

  /**
   * 对比两个来源的参数集合是否完全等价
   * 自动抹平百分比编码、双重编码、空格表现形式及键排列顺序的差异
   * @param {any} paramsA
   * @param {any} paramsB
   * @returns {{ isEqual: boolean, diffs: Array }} 比对结果与差异明细
   */
  static compare(paramsA, paramsB) {
    const recordA = this.parseToNormalizedRecord(paramsA);
    const recordB = this.parseToNormalizedRecord(paramsB);

    const keysA = Object.keys(recordA);
    const keysB = Object.keys(recordB);
    const allKeys = Array.from(new Set([...keysA, ...keysB])).sort();

    const diffs = [];

    for (const key of allKeys) {
      const valA = recordA[key];
      const valB = recordB[key];

      if (valA === undefined) {
        diffs.push(`参数缺失 [${key}]: 集合 A 中不存在,集合 B 值为 "${valB}"`);
      } else if (valB === undefined) {
        diffs.push(`参数缺失 [${key}]: 集合 A 值为 "${valA}",集合 B 中不存在`);
      } else if (valA !== valB) {
        diffs.push(`值不一致 [${key}]: 集合 A="${valA}", 集合 B="${valB}"`);
      }
    }

    return {
      isEqual: diffs.length === 0,
      diffs
    };
  }
}
实战比对用例与执行效果
以下示例展示了两个在表面形态上截然不同的参数源(一个经过多重 URL 编码且空格为 +,另一个为纯中文对象),通过上述标准化处理后,能够精准判定相等:
// 来源 A:从 URL 截取,经历了双重百分比转义,带有 '+' 号空格,且顺序为 category 在前
const rawUrlQuery = "category=%25E5%25AE%25B6%25E7%2594%25B5%2B%25E6%2595%25B0%25E7%25A0%2581&city=%E5%8C%97%E4%BA%AC";

// 来源 B:客户端本地业务对象,明文中文,city 在前
const localPayload = {
  city: "北京",
  category: "家电 数码"
};

// 执行比较
const result = ParameterNormalizer.compare(rawUrlQuery, localPayload);
console.log("比对是否一致:", result.isEqual);
// 示例输出: 比对是否一致: true

// 生成签名比对串
const canonicalStr = ParameterNormalizer.serializeCanonical(
  ParameterNormalizer.parseToNormalizedRecord(rawUrlQuery)
);
console.log("规范化输出:", canonicalStr);
// 示例输出: "category=%E5%AE%B6%E7%94%B5%20%E6%95%B0%E7%A0%81&city=%E5%8C%97%E4%BA%AC"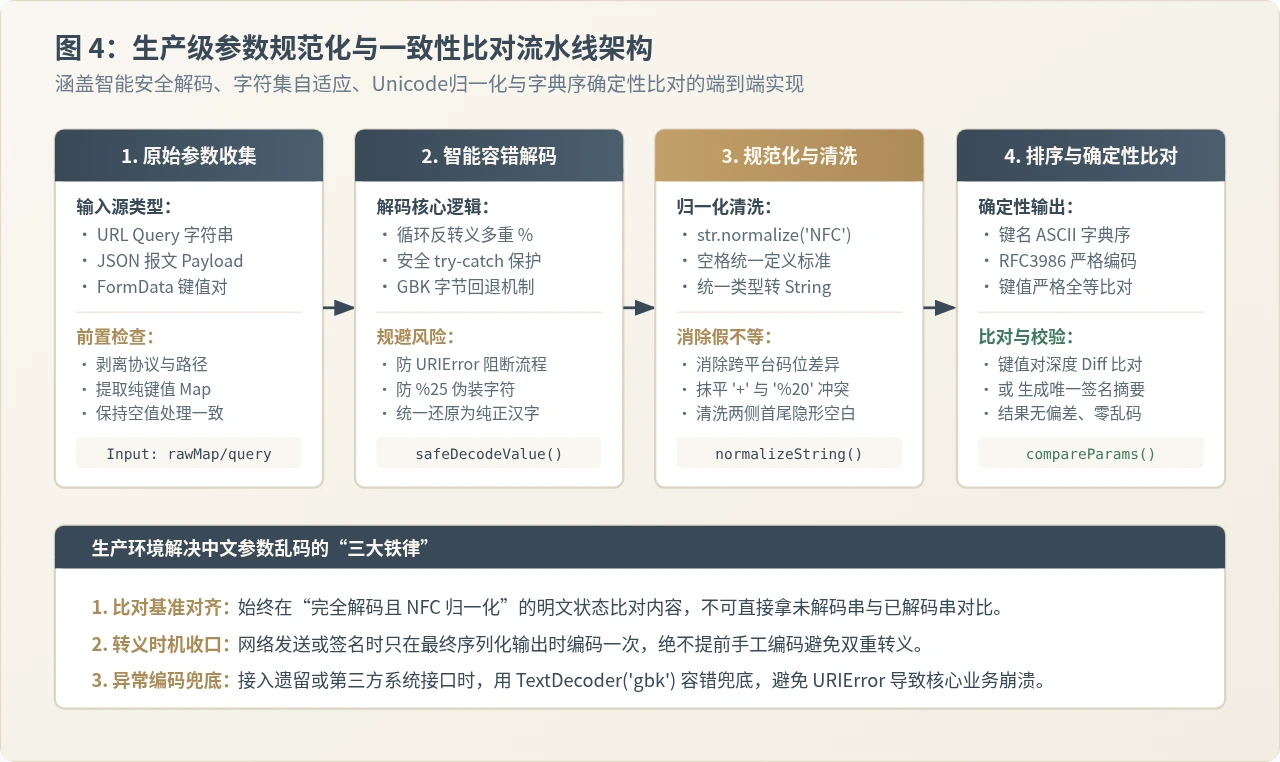
五、项目上线排查与避坑清单
safeDecodeParam 还原内容。比对动作必须发生在“纯净明文”状态下。encodeURIComponent 调用位置。网络请求库(如 Axios)在将 params 拼接到 URL 时会自动执行编码,前端切勿在调用前手动 encode 一次,避免诱发双重转义。%20;若使用 URLSearchParams 导出则默认为 +,两者比对前务必做全局字符映射。URIError,无缝转交 TextDecoder('gbk') 兜底。normalize('NFC')。防止 iOS/macOS 和 Windows 跨平台在多字节中文字符、复合表情符号的比对上产生假失败。JavaScript基础选择题怎么处理用户输入的异常值
2026-11-08 10:48:56
JavaScript比较参数旧代码怎么重构
2026-11-07 13:15:34
为JavaScript配置文件添加TypeScript类型提示的最佳实践
2026-11-06 22:56:07
JS字符串转浮点数返回NaN时怎么判断和处理
2026-11-06 11:39:33
JavaScript Set 对象基础用法与数组去重实战
2026-11-06 10:54:56