CrewAI Agent在多智能体协作工作流中的实际应用案例
本文通过构建“研究简报生成”示例,演示如何利用 CrewAI 将复杂任务拆解为资料整理与报告撰写两个角色。文章涵盖环境配置、代码实现、运行验证及结果核对流程,强调在自动化工作流中保持人工审核的重要性,并探讨如何将此模式扩展至工单处理等实际业务场景。
面对既需梳理素材又需产出可读报告的研究任务时,若将所有要求压缩进单一提示词,往往难以追溯每一步的逻辑依据。借助 CrewAI Agent,可将工作流拆解为多个特定角色与任务,并按序传递中间结果。下文将以“基于既定资料生成研究简报”为例,展示流程搭建、执行及核验的具体步骤。需注意,示例所用资料仅为人工提供的演示文本,并非真实调研数据,且程序不具备自动联网搜索功能。
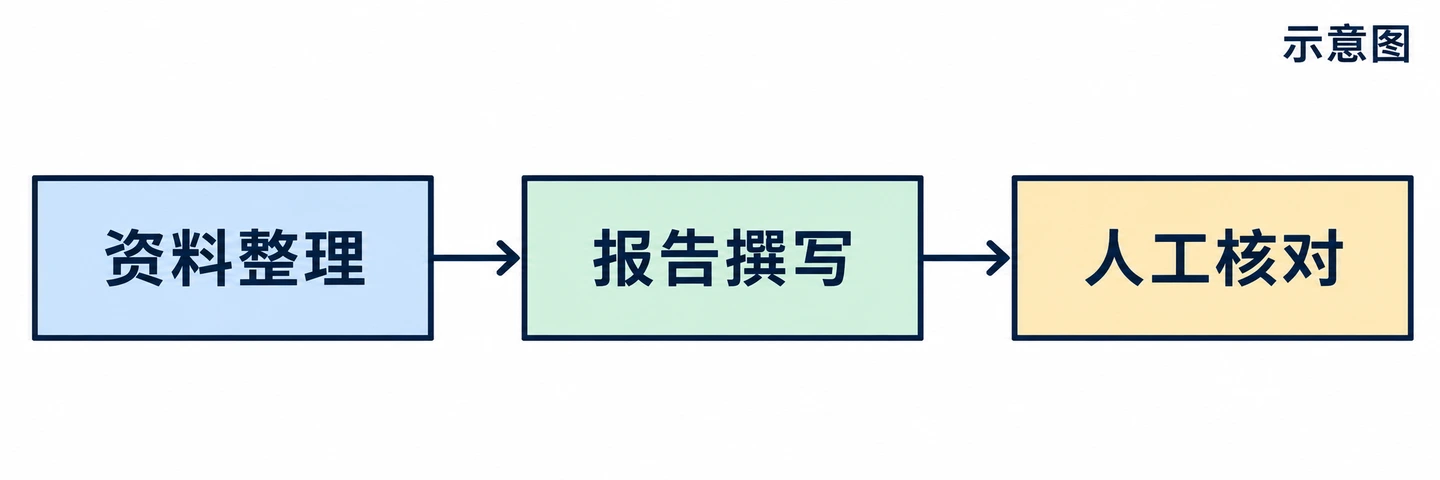
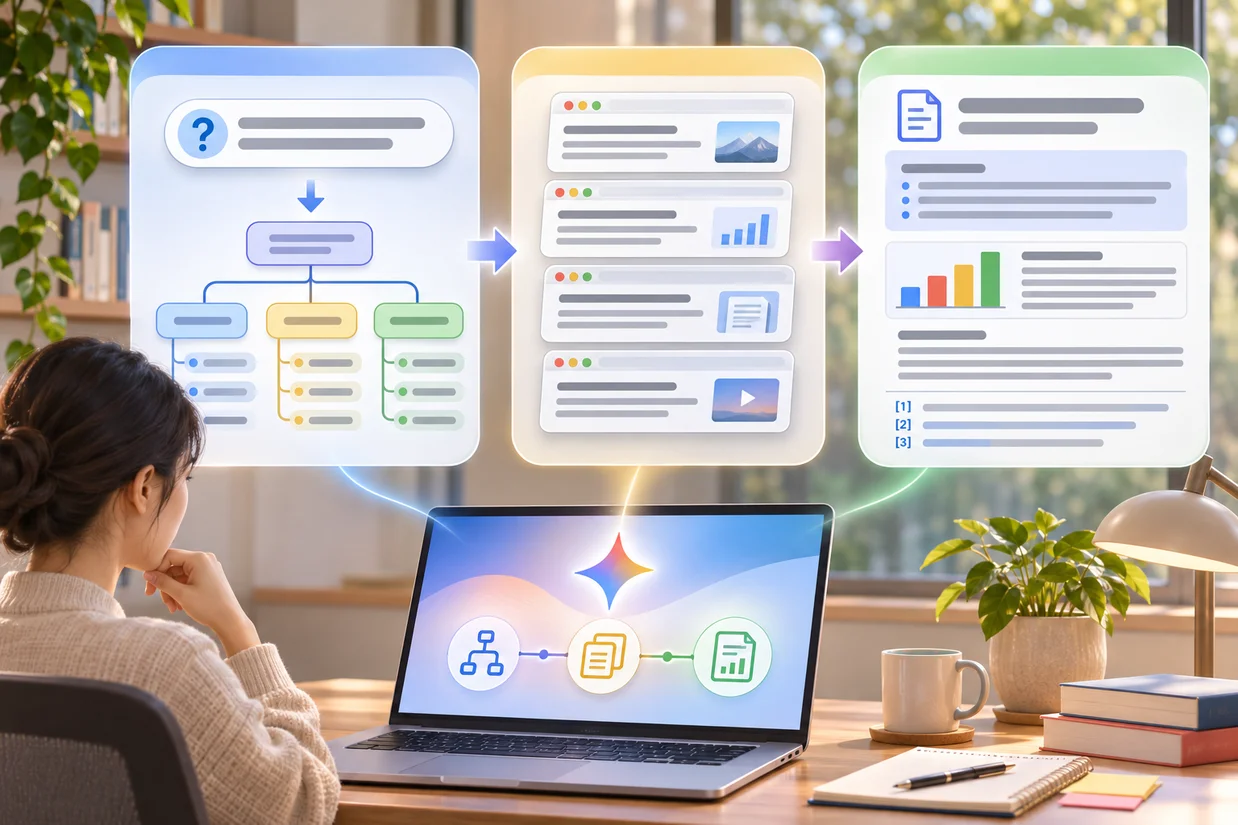
研究简报工作流示意:先整理资料,再撰写并由人工核对。
先设计角色、任务和交接关系
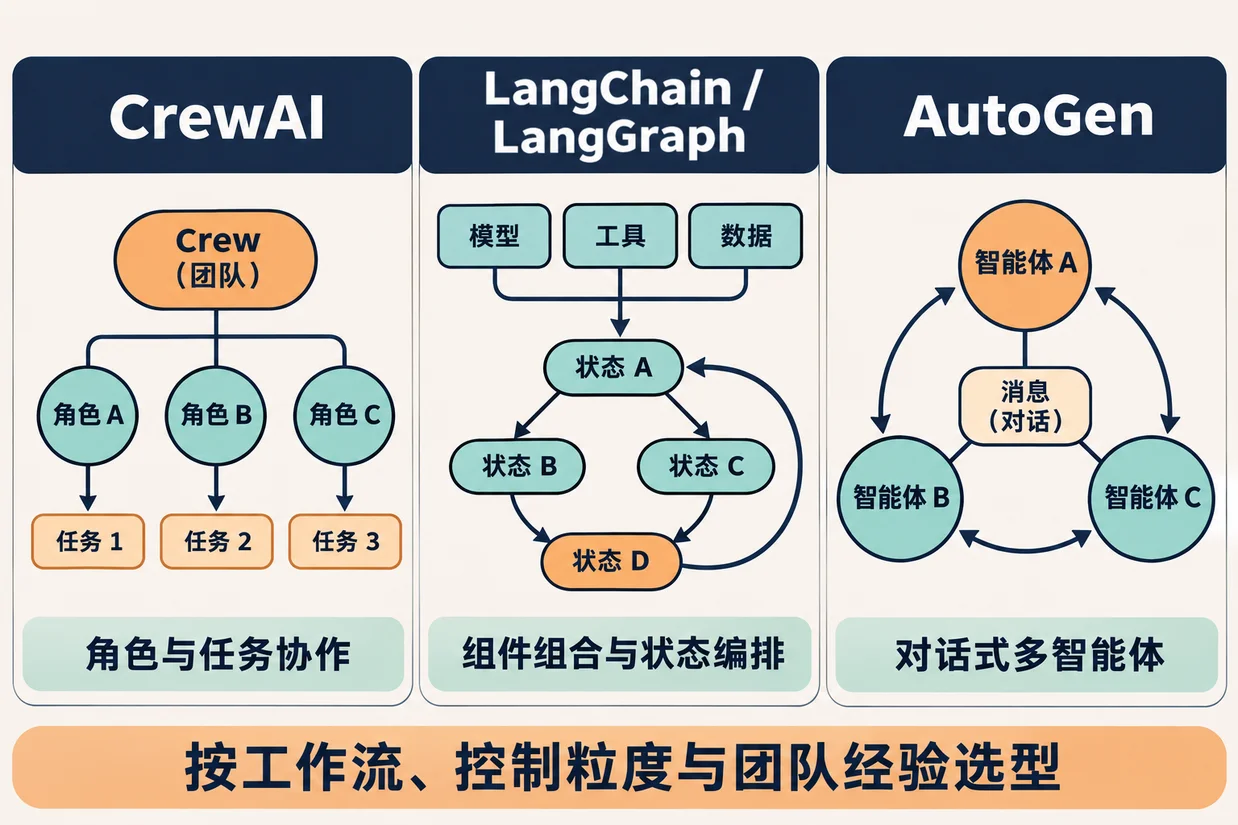
在 CrewAI架构中,Agent 定义了执行者的角色定位、目标及背景知识;Task 则明确具体工作内容、预期输出格式及指定执行 Agent。Crew 负责将 Agent 与 Task 组装,并在顺序执行模式下依列表逐项推进。通过配置 context 参数,后续任务可直接引用前序任务的输出成果,从而避免报告撰写者因缺乏上下文而凭空臆造内容。
本案例设定了两个核心角色:资料整理员负责从指定文本中提取关键事实并标记待核实疑点;报告撰写员则依据整理后的结构化信息起草简报。最终环节由人工介入,对来源可靠性及措辞准确性进行复核。这种分工机制特别适用于需明确交接界限的内容整理场景,但鉴于模型仍可能存在遗漏或误读风险,其输出结果绝不能替代人工审核。
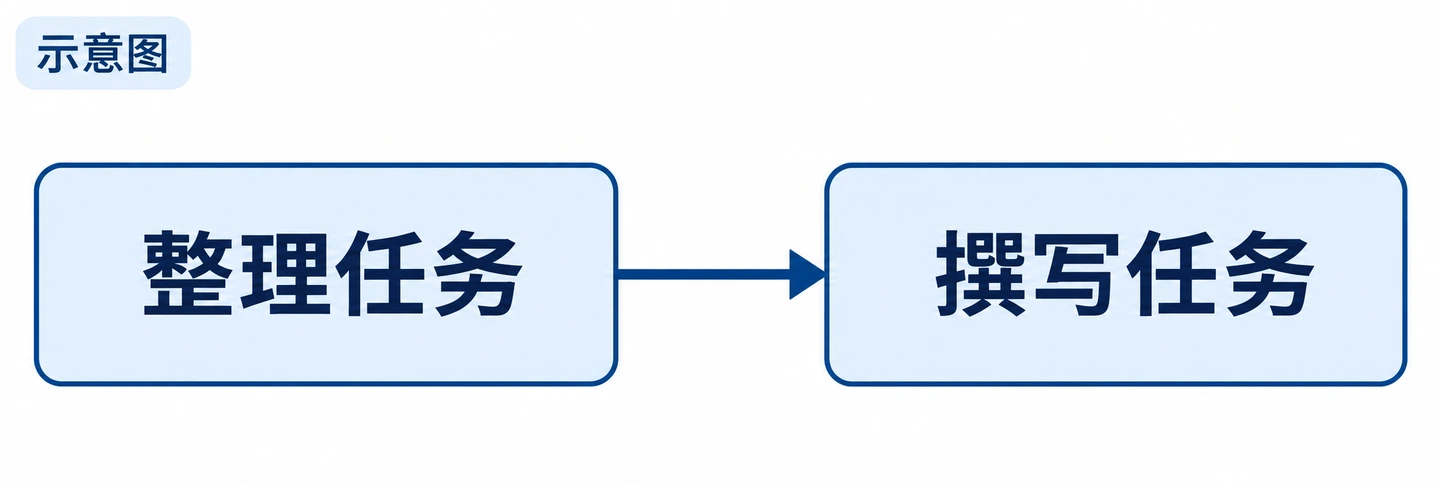
两个顺序任务通过上下文传递整理结果。
安装并运行一个研究简报示例
首先确保已安装 Python 3.11 环境。打开 Windows PowerShell,进入项目工作目录,依次执行以下命令以创建虚拟环境并安装 CrewAI 库:
py -3.11 -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install crewai
根据所选模型服务提供商配置访问凭据。以 OpenAI 服务为例,可在当前 PowerShell 会话中通过设置环境变量来完成配置:
$env:OPENAI_API_KEY = "替换为自己的密钥"
严禁将真实 API 密钥硬编码至脚本或提交至代码仓库。模型调用依赖有效的服务权限且可能产生费用,具体模型与环境配置请以所用服务及最新版 CrewAI 文档为准。请将以下代码保存为 case.py:
from crewai import Agent, Crew, Process, Task

source = """演示资料:某团队在内部试点中整理了20份客户反馈。
其中12份提到希望缩短响应时间,8份提到希望改善文档检索。
以上数字仅用于演示,不代表实际调查结果。"""

researcher = Agent(
    role="资料整理员",
    goal="从给定资料中准确提取事实,标出资料的限制",
    backstory="你负责把输入材料整理成可核对的事实清单。",
    verbose=True,
    allow_delegation=False,
)
writer = Agent(
    role="报告撰写员",
    goal="根据整理后的事实写一份简短、可核对的中文简报",
    backstory="你重视来源范围,不把推测写成既定事实。",
    verbose=True,
    allow_delegation=False,
)

organize = Task(
    description=(
        "只根据下列演示资料列出事实、数字和资料局限,"
        "缺失的信息标为待核实,不得编造:\n" + source
    ),
    expected_output="中文事实清单和待核实问题",
    agent=researcher,
)
write = Task(
    description="根据上一任务的结果写一份中文简报,说明资料范围和待核实问题。",
    expected_output="包含主要发现、资料局限和下一步建议的简报",
    agent=writer,
    context=[organize],
)
crew = Crew(
    agents=[researcher, writer],
    tasks=[organize, write],
    process=Process.sequential,
    verbose=True,
)
result = crew.kickoff()
print(result)
执行 python case.py。运行过程中,系统将先显示资料整理任务的处理日志,随后展示报告撰写任务,最终输出一份中文简报;具体表述可能因模型版本及运行状态而异。由于代码未集成搜索工具,程序不会主动抓取外部网页。若遭遇认证失败或模型配置错误,请优先检查当前会话的凭据有效性及服务可用性,修正后重新运行。
检查结果并扩展到实际工作
务必将输出结果与原始资料逐项比对:核实数字准确性、确认是否保留了“演示资料”的范围限制、检查待核实事项是否被错误地陈述为既定事实。注意,切勿简单相加两类反馈数量作为独立客户总数,因为示例未说明这两类反馈是否存在重叠。仅在人工确认无误后方可用于内部沟通;若涉及真实客户数据,还需严格遵循团队数据处理规范,筛选允许发送给模型的内容。
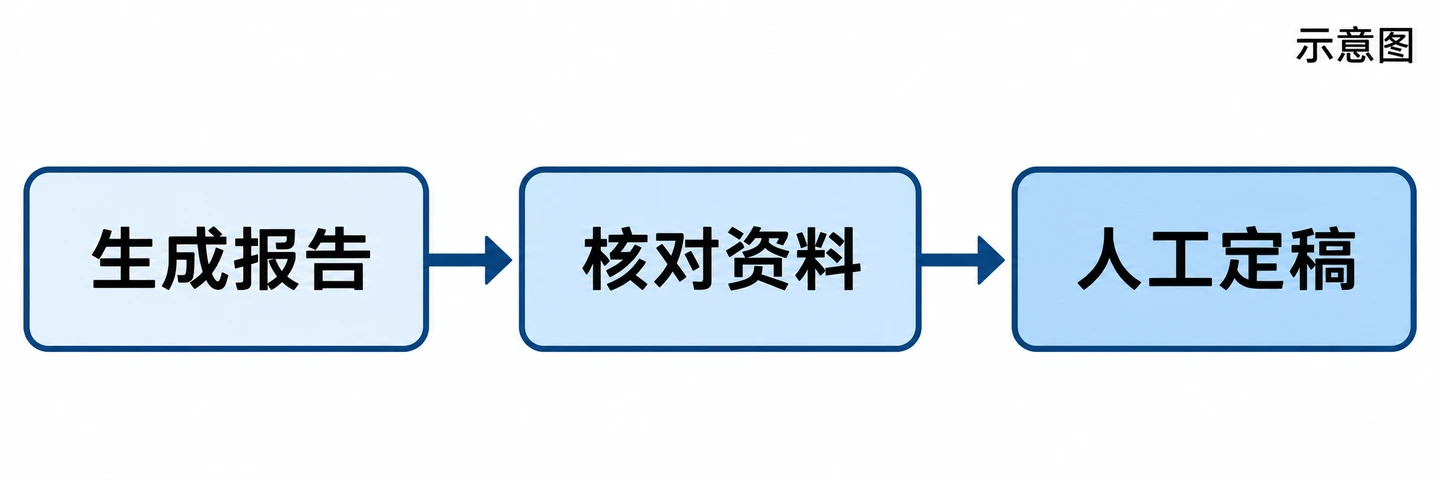
输出报告后,应对照资料核验,再由人工定稿。
在实际业务应用中,可将固定演示文本替换为经授权整理的工单摘要、会议纪要或产品反馈,并要求整理员保留原文编号以便溯源。若确有联网检索需求,应单独配置合规的工具插件,严格审查权限与数据来源,并在任务描述中明确引用规范及验证机制。随着工作流复杂度增加,清晰界定每个角色的输入输出边界及责任范围,比单纯堆砌 Agent 数量更能有效排查问题并提升系统稳定性。
教育场景中怎么合理使用AI率检测工具辅助学术诚信
2026-11-08 13:29:47
Flux vs Stable Diffusion vs Midjourney:主流 AI 绘画模型效果与成本对比
2026-11-08 11:04:35
Stable Diffusion提示词权重怎么调整?括号与数值用法指南
2026-11-07 22:52:36
Google Veo 2 有哪些新特性:版本迭代与功能升级详解
2026-11-07 19:56:27
企业开发中使用通义灵码插件的代码隐私与安全设置
2026-11-07 18:49:56