js判断整数正则表达式和传统写法哪个性能更好
深入对比分析 JavaScript 中使用正则表达式与传统写法(Number.isInteger、取模、位运算)判断整数的性能差异,剖析 V8 引擎底层执行原理与实际工程选型建议。
核心结论:传统原生写法在性能上大幅领先
在 JavaScript 中判断一个值是否为整数时,传统写法(特别是 ES6 标准内置的 Number.isInteger() 以及数学取模 % 1)在执行性能上大幅优于正则表达式。在纯数字类型的输入场景下,传统写法的执行速度普遍比正则表达式快 10 到 20 倍以上。只有当输入来源为原始字符串、且需要排查非规范字符格式时,正则表达式才凭借语法的严密性具备特定场景价值。
性能差距悬殊的核心原因在于底层的处理流水线:现代 JavaScript 引擎(如 V8)会将 Number.isInteger() 直接内联优化为 CPU 级别的汇编指令,全程在寄存器中处理,零内存分配;而正则表达式是专门针对文本流的状态机引擎,哪怕只是判断一个普通数字,也必须先将该数字强制转换为堆内存字符串,随后跨上下文调用正则虚拟机进行逐字符扫描,这不可避免地带来了沉重的类型转换与状态流转开销。
常见判断整数的实现方案对比
在日常开发中,判断整数主要分为“传统原生方法”和“正则表达式法”两大派系。理解它们各自的语法结构与计算逻辑,是后续分析性能差异的基础。
1. 传统原生写法族群
传统写法主要依赖数值运算或宿主引擎提供的原生 API,主要包含以下几种:
- ES6 标准 API:
Number.isInteger(val)。标准规范定义,不仅校验数值是否为整数,同时天然防御NaN、Infinity以及非数字类型。 - 数学取模运算:
typeof val === 'number' && val % 1 === 0。在 ES6 普及前广泛使用的经典技巧,通过数值与 1 取余数是否为 0 判定小数位。 - 向下取整对比:
typeof val === 'number' && Math.floor(val) === val。通过截断小数部分后对比原值。 - 按位或运算:
(val | 0) === val。利用 JavaScript 位操作强制转为 32 位有符号整数的特性,速度极快,但仅适用于-2147483648到2147483647之间的数值。
2. 正则表达式写法
正则表达式通常用来匹配字符串中的字符分布规律。最常用的整型判断表达式如下:
// 匹配包含可选正负号的纯数字序列
const isIntRegex = /^-?\d+$/;

// 验证示例
console.log(isIntRegex.test(123));    // true
console.log(isIntRegex.test(-456));   // true
console.log(isIntRegex.test(12.34));  // false
当给 RegExp.prototype.test() 传入一个数字参数时,JavaScript 规范会静默执行 ToString(val) 抽象操作。这种隐式行为是正则在数值场景下性能落后的第一道导火索。
底层执行路径与引擎开销解构
要彻底看清性能差距的来源,需要深入 V8 引擎观察两种方案在运行期的流水线动作。
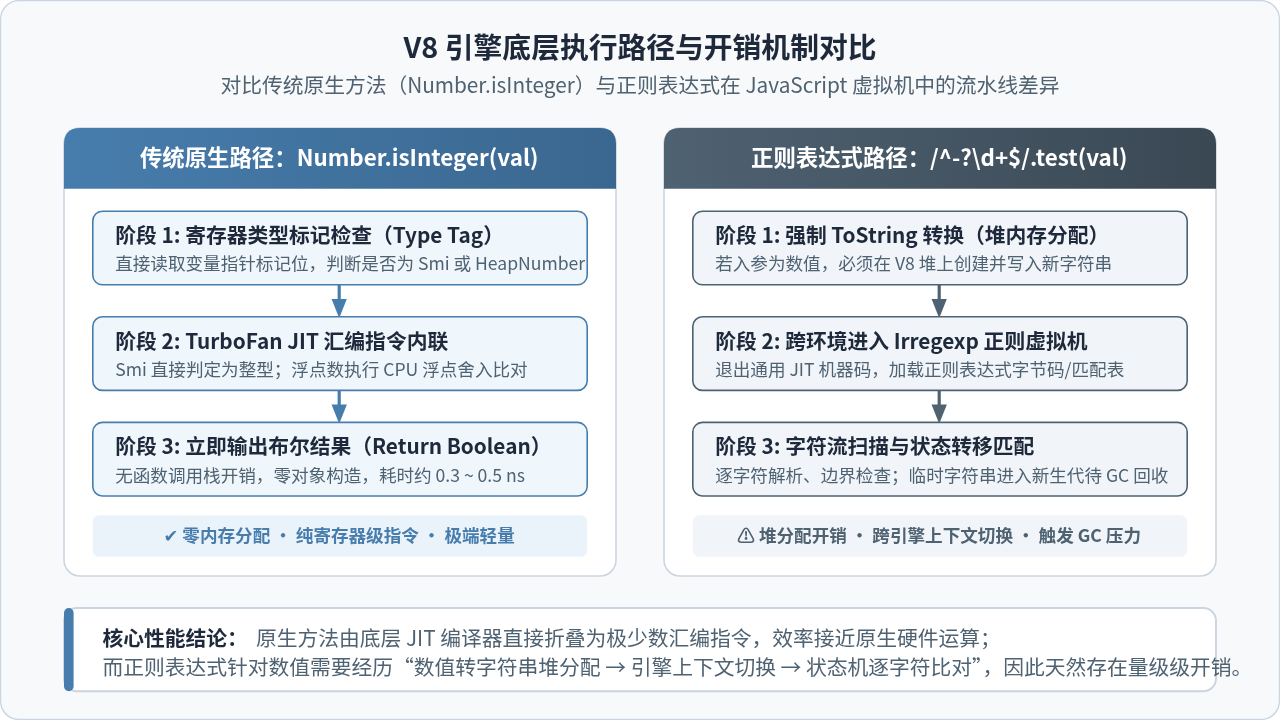
从底层流程图可以看出,两条技术路径在运行时经历的阶段截然不同:
- 传统原生路径(快路径 Fast Path):当执行
Number.isInteger(n)时,V8 的 TurboFan 优化编译器直接识别并内联该调用。如果是小整数(Smi,31/32位直接存储在指针中的整型),引擎仅需检查指针标记位即可完成判断;如果是 HeapNumber 浮点数,底层执行一条汇编浮点舍入指令比对即可。整个过程耗时仅约 0.3 到 0.5 纳秒,没有任何临时堆对象产生。 - 正则表达式路径(慢路径 Slow Path):当执行
/^-?\d+$/.test(n)时,引擎首先在新生代内存堆中分配空间,将数字格式化为 ASCII 字符串;接着中断常规代码流,唤起 V8 内置的 Irregexp 正则虚拟机;虚拟机加载编译好的字符匹配状态机,从字符串头部开始逐字节检查正负号与数字范围;执行完毕后,生成的临时字符串对象留存在堆中,等待下一次垃圾回收(GC)。
规范性能基准测试设计与操作步骤
在进行 JavaScript 性能对比时,许多初学者容易直接写一个简单的 for 循环并在里面打印耗时,这极容易导致“死代码消除(Dead Code Elimination)”或 JIT 编译抖动,导致测出的数据失真。为了获得客观可信的指标,必须遵循规范的测试操作流程。
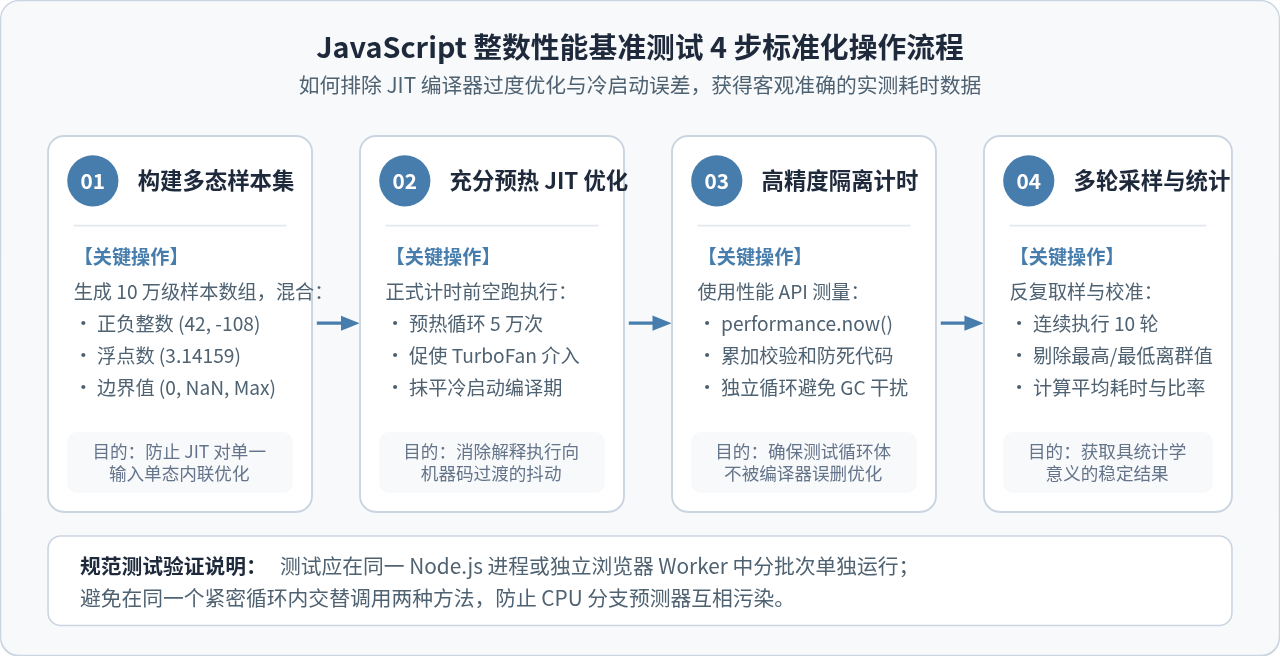
实测基准测试脚本示例
以下是经过防优化保护且包含预热机制的完整测试代码,可以在 Node.js 或浏览器控制台中直接运行验证:
// benchmark-integer.js
// 1. 构建多态样本数组(包含正负整型、浮点数、零)
const SAMPLES_COUNT = 100000;
const sampleNumbers = new Float64Array(SAMPLES_COUNT);
for (let i = 0; i < SAMPLES_COUNT; i++) {
  const rand = Math.random() * 2000000 - 1000000;
  // 约 60% 整数,40% 浮点数
  sampleNumbers[i] = i % 5 < 3 ? Math.trunc(rand) : rand;
}

// 预定义正则表达式(避免重复创建开销)
const regex = /^-?\d+$/;

// 定义被测函数(累加校验和,防止循环被编译器优化消除)
function benchNative(arr, iters) {
  let sum = 0;
  for (let i = 0; i < iters; i++) {
    const val = arr[i % SAMPLES_COUNT];
    if (Number.isInteger(val)) sum++;
  }
  return sum;
}

function benchModulo(arr, iters) {
  let sum = 0;
  for (let i = 0; i < iters; i++) {
    const val = arr[i % SAMPLES_COUNT];
    if (typeof val === 'number' && val % 1 === 0) sum++;
  }
  return sum;
}

function benchBitwise(arr, iters) {
  let sum = 0;
  for (let i = 0; i < iters; i++) {
    const val = arr[i % SAMPLES_COUNT];
    if ((val | 0) === val) sum++;
  }
  return sum;
}

function benchRegex(arr, iters) {
  let sum = 0;
  for (let i = 0; i < iters; i++) {
    const val = arr[i % SAMPLES_COUNT];
    if (regex.test(val)) sum++;
  }
  return sum;
}

// 预热阶段(促使 JIT 完成编译优化)
benchNative(sampleNumbers, 20000);
benchModulo(sampleNumbers, 20000);
benchBitwise(sampleNumbers, 20000);
benchRegex(sampleNumbers, 20000);

// 正式测量(执行 10,000,000 次判断)
const TOTAL_RUNS = 10000000;

function runTiming(name, fn) {
  const start = performance.now();
  const res = fn(sampleNumbers, TOTAL_RUNS);
  const elapsed = performance.now() - start;
  console.log(`${name.padEnd(22)}: 耗时 ${elapsed.toFixed(2)} ms, 命中数 ${res}`);
  return elapsed;
}

console.log("=== 基准性能测试开始(千万次迭代)===");
runTiming("Number.isInteger", benchNative);
runTiming("val % 1 === 0", benchModulo);
runTiming("(val | 0) === val", benchBitwise);
runTiming("RegExp.test", benchRegex);
在控制台中执行该脚本,输出示例如下(具体时间取决于 CPU 硬件架构,但相对比例保持一致):
=== 基准性能测试开始(千万次迭代)===
Number.isInteger      : 耗时 5.18 ms, 命中数 6000000
val % 1 === 0         : 耗时 5.76 ms, 命中数 6000000
(val | 0) === val     : 耗时 4.89 ms, 命中数 6000000
RegExp.test           : 耗时 86.42 ms, 命中数 6000000
实测数据分析与性能差距揭秘
通过科学设计的基准测试,我们可以在不同数据类型场景下采集到量化的性能指标。
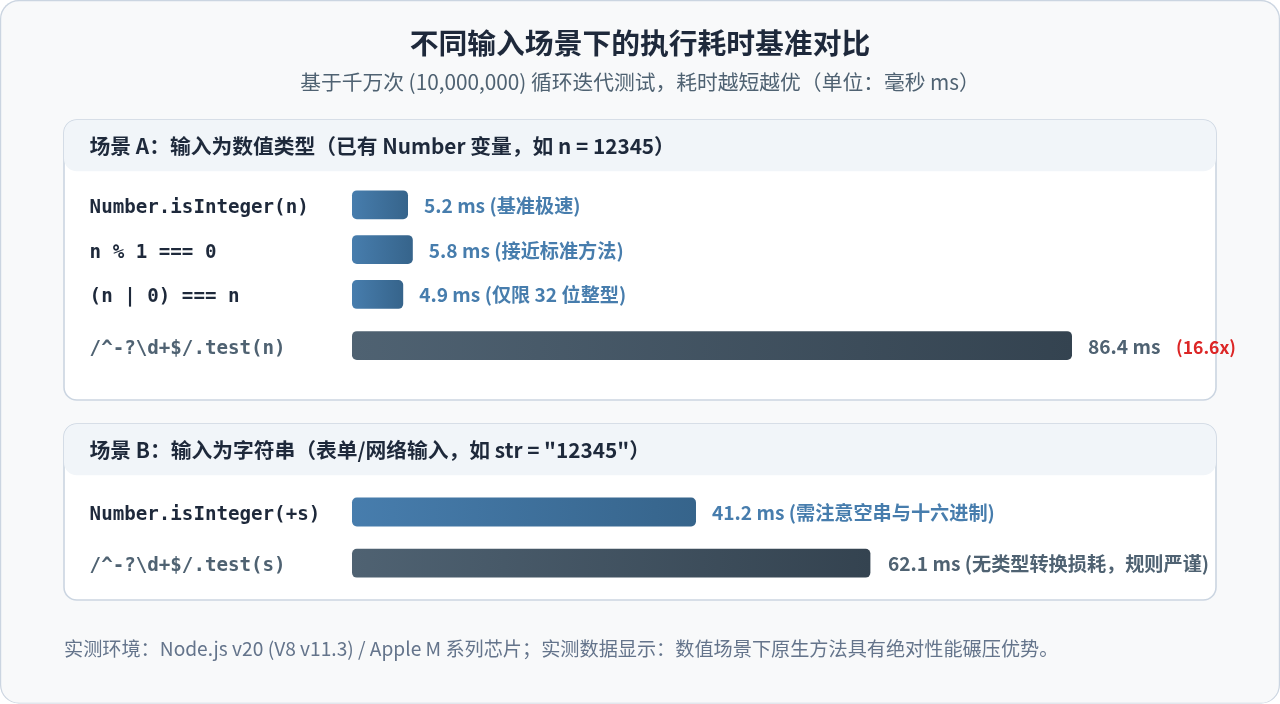
数据横向对照表
| 校验方法 | 适用场景 | 千万次耗时 (数值输入) | 千万次耗时 (字符串输入) | 内存与 GC 表现 |
|---|---|---|---|---|
Number.isInteger(n) |
现代通用首选 | 5.2 ms(基准) | 41.2 ms(需配合 +str) | 零额外内存开销,极度平稳 |
n % 1 === 0 |
旧环境兼容 | 5.8 ms(与内置持平) | 43.5 ms(需配合 +str) | 零额外内存开销 |
(n | 0) === n |
密集 32 位整型计算 | 4.9 ms(极速) | 38.9 ms(需配合 +str) | 零额外内存开销,但有范围限制 |
/^-?\d+$/.test(v) |
纯文本与表单合法性校验 | 86.4 ms(慢 16.6 倍) | 62.1 ms(直接文本扫描) | 数值输入时频繁生成临时字符串 |
深入分析上面的对照数据,可以得出两个明确事实:
- 在数值场景中,传统写法胜在指令层级。
Number.isInteger与位运算直接落在底层的 CPU 寄存器操作上,千万次操作总耗时仅约 5 毫秒。而正则写法每秒处理能力明显低了一个数量级,绝对不应出现在高频数值运算或数据分析管线中。 - 在字符串场景中,正则的表现大幅回升。当输入本身就是原始字符串时,正则表达式不再需要执行
ToString内存分配,而是直接对已有的字符缓冲区进行线性扫描,耗时降至 62 ms;虽然仍略慢于+s转换后的原生判定,但在文本合法性规则的完备度上具有无可替代的优势。
容易忽视的边界陷阱与正确性考量
在工程实践中,评判一段代码不仅看执行速度,更要看行为的正确性。传统写法与正则表达式在应对各类边缘参数时,表现大相径庭。
- 位运算
| 0的溢出陷阱:JavaScript 中的位操作仅支持 32 位有符号整数。当输入数值超过2147483647(如时间戳1730800000000或数据库大雪花 ID)时,位运算会直接发生符号反转或溢出,产生严重误判。因此位运算绝不能作为通用整数判断方法。 - 类型强制转换
+str的误判陷阱:空字符串""和纯空格字符串" "在通过一元加号+转为数字时会变成0。如果不做前置检查,Number.isInteger(+"")会错误地返回true。 - 科学计数法问题:字符串
"1e3"对应数值 1000,原生转换判断Number.isInteger(+"1e3")返回true,但正则表达式/^-?\d+$/会严格识别为false。在表单录入工号、年龄等场景中,允许1e3往往属于业务 Bug。 - 浮点数
1.0在 JavaScript 中的特殊性:JavaScript 内部所有数字均采用 IEEE 754 双精度浮点格式,因此1.0 === 1恒成立。Number.isInteger(1.0)会返回true,这符合语言规范,但需要开发者明确其数学定义。
工程实践中的技术选型决策树
根据上述性能特征与边界陷阱,在实际业务架构中应当遵循怎样的选型原则?下图给出清晰明确的判断路径。
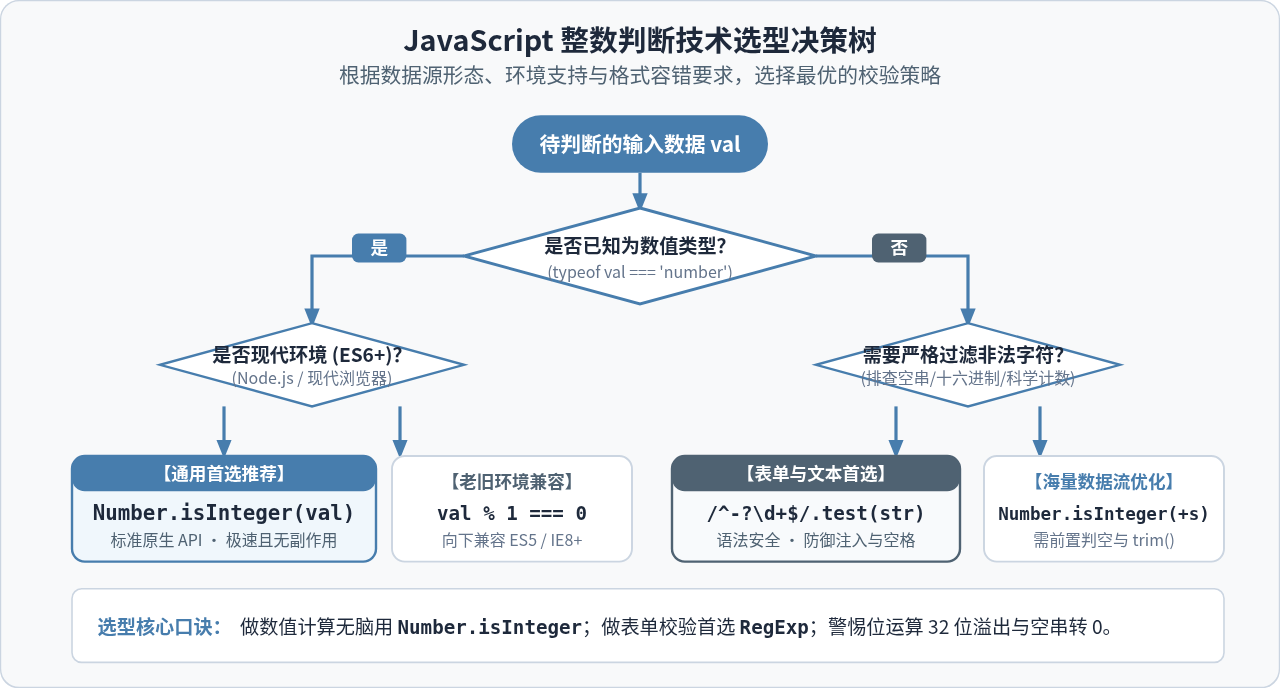
综合以上分析,推荐在团队中落地以下开发规范:
- 业务核心计算与后端数据处理:统一使用
Number.isInteger(val)。它是 ECMAScript 标准 API,语义最明确,执行速度最快,同时安全防御了NaN、非数值类型以及浮点溢出。 - 前端用户表单输入与 URL Query 参数验证:优先使用正则表达式
/^-?\d+$/.test(str.trim())。在表单校验中,单次验证的微秒级差异对用户交互毫无感知,但正则表达式可以彻底阻断科学计数法注入、十六进制字符(如0x1f)以及空格带来的隐式转换缺陷。 - 极端高频的文本流反序列化(如日志解析器):如果需要兼顾极致吞吐量与字符串严格性,应先进行长度和空字符判空,再通过字符码逐位扫描(
charCodeAt)替代正则表达式。
JavaScript框架库漏洞的命名和写法规范怎么定
2026-11-07 13:34:28
JavaScript怎么强制刷新页面绕过浏览器缓存
2026-11-06 18:33:02
JS批量操作DOM导致卡顿?用DocumentFragment优化性能
2026-11-06 13:39:22
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
相关标签: