

面壁智能发布首个具身智能成果MiniCPM-Robot系列模型
面壁智能联合OpenBMB发布MiniCPM-Robot系列模型,包括通用视觉语言动作模型(十五亿参数,支持一分钟记忆)和移动跟踪模型(九亿参数,首个本地断网部署跟踪模型),在机器人操控和跟踪任务中性能领先,代码已在GitHub和HuggingFace开源。
7月19日上午,WAIC 2026的「智在终端 惠及千行」分论坛上,面壁智能联合OpenBMB正式开源了首个具身智能成果——MiniCPM-Robot系列模型。这意味着,那个在端侧模型领域被称为“小钢炮”的团队,正式把战火烧到了机器人赛道。
这次发布包含两个核心模型:通用VLA模型MiniCPM-RobotManip,以及面向移动机器人跟踪导航的MiniCPM-RobotTrack。两者均已在GitHub和Hugging Face上开源,感兴趣的开发者可以直接下载部署。
先说第一个亮点——MiniCPM-RobotManip。它基于面壁智能最新的多模态端侧模型MiniCPM-V 4.6训练而来,参数规模仅1.5B,却继承了“小尺寸、高性能”的血统。在视觉Token压缩上继续做到极致,结果就是:以1.5B的体量,打出了3-4B级别模型的性能,但流式实时推理的计算成本直接砍半。更关键的是,它支持1分钟的具身原生记忆——这意味着机器人能记住上下文,完成需要连续理解的操作任务,而不是像传统VLA那样每帧独立反应。
从主流VLA基准测试来看,MiniCPM-RobotManip的综合性能稳居第一梯队,和Qwen-VLA、π0.5等模型不相上下,有些场景甚至更胜一筹。尤其在考验上下文记忆的RMBench上,得分53,而π0.5只有10分,接近随机水平。来看一个具体场景:模型先盖住不同颜色的方块,然后按“红绿蓝”顺序一一揭开——这种连续记忆能力,当前主流单帧反应式VLA根本做不到。
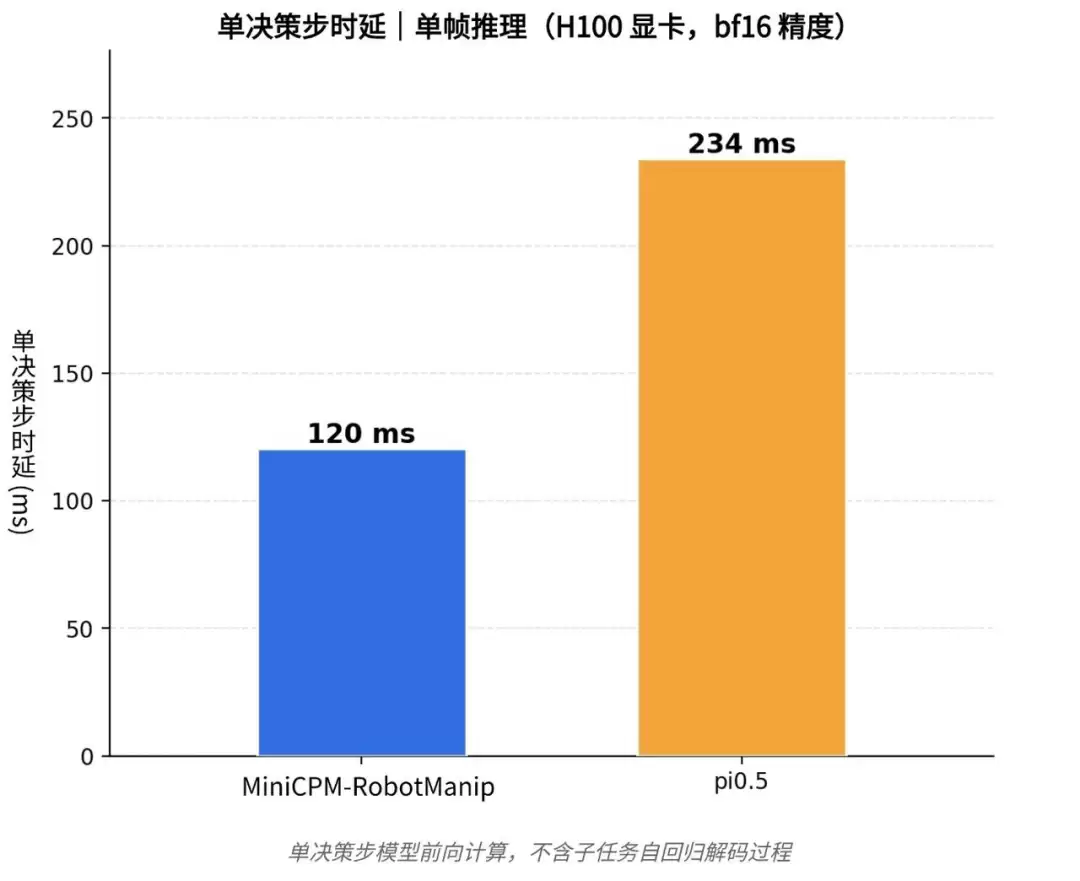
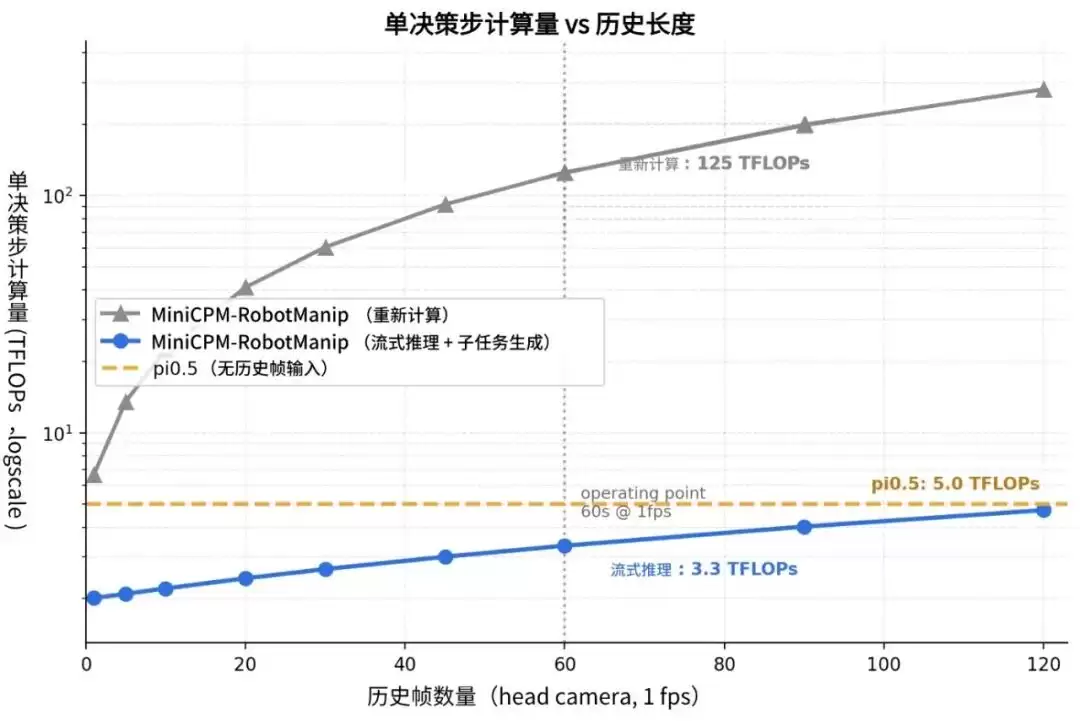
更厉害的是,MiniCPM-RobotManip把视觉Token压缩的优势带到了机器人场景。在包含60帧历史观测的机器人操作任务中,传统重新计算方式每个决策步需要125 TFLOPs,而采用流式推理后仅需3.3 TFLOPs,甚至低于π0.5在无历史帧输入时的5.0 TFLOPs。在H100、BF16精度下,单决策步推理时延仅为120ms,相比π0.5的234ms降低近一半——性能更强,部署成本反而更低,这才是真正的“既要又要”。
首个本地断网部署跟踪模型:MiniCPM-RobotTrack
第二个模型MiniCPM-RobotTrack同样可圈可点。它是一款0.9B参数的端到端视觉指令跟踪模型,由面壁智能和南京大学联合研发,是业内首个支持真实本地断网部署的跟踪模型。它首次实现了纯视觉的本地自主指令追踪,原生适配宇树Go2 Edu机器人,仅靠原装摄像头和本地算力就能完成单目标、动态多目标及模糊目标跟踪。
性能方面,在单目标跟踪、动态多目标跟踪和模糊目标跟踪三项任务中,MiniCPM-RobotTrack的追踪率分别达到89.8、73.4和80.4,全部获得开源方案最优结果。相比OmTrackVLA,分别提升了7.0、14.6和6.5个百分点。即便与闭源模型TrackVLA++相比,在单目标跟踪和模糊目标跟踪上也分别提升了8.8和17.0个百分点。值得注意的是,这还是在仅有0.9B参数且未进行下游强化学习优化的情况下取得的。这充分说明,通过高质量数据和端到端训练,轻量级模型完全有能力在真实场景中打出亮眼表现。
针对真机数据采集成本高、长尾场景覆盖有限的问题,MiniCPM-RobotTrack构建了自进化数据管线。先通过自动检测与人工复核清洗异常数据,再引入面向具身追踪的DAgger策略,让模型在仿真与真机交互中主动暴露薄弱环节——比如快速转向、短时遮挡、多人交叉等复杂场景,持续补充高价值样本,在数据闭环中不断提升跟踪与泛化能力。
在真机实测中,经过对宇树Go2完整运行链路的系统性优化,模型在机器狗原生本地算力下稳定达到5+ Hz,端到端响应时延约180毫秒。最震撼的是,现场演示时直接拔掉网卡,机器狗依然能依靠本地视觉画面与文本指令持续完成目标识别、跟踪与运动控制。这种能力对于楼宇巡检、人员陪护、园区安防等场景意义重大,未来甚至有望拓展到灾害救援、特种作业等弱网或断网环境。
此外,本次开源还提供了完整部署流程与一键启动脚本,覆盖模型加载、摄像头接入、文本指令输入和机器人控制接口,真正做到纯本地部署、开箱即用。
具身智能推理框架:PhyAI
两款模型都获得了PhyAI推理框架的支持。PhyAI是面向Physical AI的开源推理框架,专为端侧极速推理与云端RL大规模Rollout场景设计。在NVIDIA GeForce RTX 5090上,PhyAI运行π0、π0.5和GR00T时分别实现了约2.85倍、1.82倍和2.28倍加速;GR00T在NVIDIA Thor和A40上也分别实现约1.40倍和4.31倍加速。面对VLA、WAM等模型结构快速演进、架构差异显著的现状,PhyAI将易用性与灵活性置于首位,致力于降低模型从研究原型走向高效推理的适配成本。
通过简洁的API,PhyAI在发布首日即完成了对MiniCPM-Robot的适配支持,并使用CUDA Graph进行加速,推理帧率从10.12 Hz提升至33.28 Hz。同时,采用算子融合的方法,用Triton编写了RMSNorm+SiLU gate、conv1d+SiLU+QKV split等定制融合算子,减少中间变量搬运次数,在NVIDIA H20上将推理帧率进一步提升至36.77 Hz。
让端侧AI走进千行万业
在推进开源技术的同时,面壁智能也在与产业伙伴共同探索真实场景应用。目前,已与乐聚机器人合作推出展厅导览和园区巡检Agent解决方案,并与吉利汽车围绕VLA模型、生产仓储应用等方向展开合作,推动具身智能技术在实际环境中持续验证和迭代。
对面壁智能而言,探索物理AGI与长期追寻的AGI目标一脉相承。随着机器人逐步进入家庭、办公和工厂,本地感知、推理与决策将成为保障实时性、稳定性和数据隐私的重要方向。未来,面壁智能将继续投入具身领域,坚持通过开源与产业合作推动模型在真实场景中持续验证,让物理智能更加可靠、安全地走进现实世界。