

Pydantic v2入门教程:模型、字段与验证器
Pydanticv2通过BaseModel定义模型,利用类型注解声明字段,Field()添加约束,支持Annotated复用约束。宽松模式自动转换类型,严格模式拒绝隐式转换。field_validator与model_validator实现自定义验证,ValidationInfo传递上下文。field_serializer控制输出格式,嵌套模型自动递归校验。
本文全面介绍 Pydantic v2 中 API 的各个核心模块:模型定义方法、字段约束附加方式、验证器编写技巧、嵌套结构与序列化行为控制,以及 JSON Schema 生成方法。所有示例均基于 Pydantic v2 与 Python 3.10,每个代码片段均可独立运行,可直接复制测试。
使用 BaseModel 定义模型
Pydantic 的基础是 BaseModel。继承它后,只需通过类型注解声明字段——Pydantic 会在类创建时自动检查注解、构建校验 schema,并在每次实例化时依据 schema 验证输入数据。
无默认值的字段为必填项;有默认值或声明为 T | None 且默认 None 的字段则为可选项。示例如下:
from pydantic import BaseModel

class Address(BaseModel):
    street: str
    city: str
    state: str
    zip_code: str
    country: str = "US"           # 可选,默认 "US"
    apartment: str | None = None  # 可选,默认 None

addr = Address(
    street="123 Main St",
    city="Springfield",
    state="IL",
    zip_code="62704",
)
print(addr)
# street='123 Main St' city='Springfield' state='IL' zip_code='62704' country='US' apartment=None
若仅靠注解与默认值无法满足需求,可使用 Field() 为字段附加元数据、约束和文档说明,提升模型规范性。
from pydantic import BaseModel, Field

class Product(BaseModel):
    name: str = Field(
        min_length=1, max_length=200,
        title="Product Name",
        description="商品显示名称",
        examples=["Widget Pro"]
    )
    sku: str = Field(
        pattern=r"^[A-Z]{2,4}-\d{4,8}$",
        description="库存单位,格式 'XX-0000'",
        examples=["WP-12345"]
    )
    price: float = Field(
        gt=0, le=999_999.99,
        description="美元价格,必须为正"
    )
    quantity: int = Field(
        default=0, ge=0,
        description="库存数量,不可为负"
    )
    category: str = Field(
        validation_alias="product_category",
        description="来自目录系统的产品类别"
    )

product = Product(
    name="Widget Pro", sku="WP-12345", price=29.99,
    quantity=150, product_category="Electronics"
)
print(product.category)  # Electronics
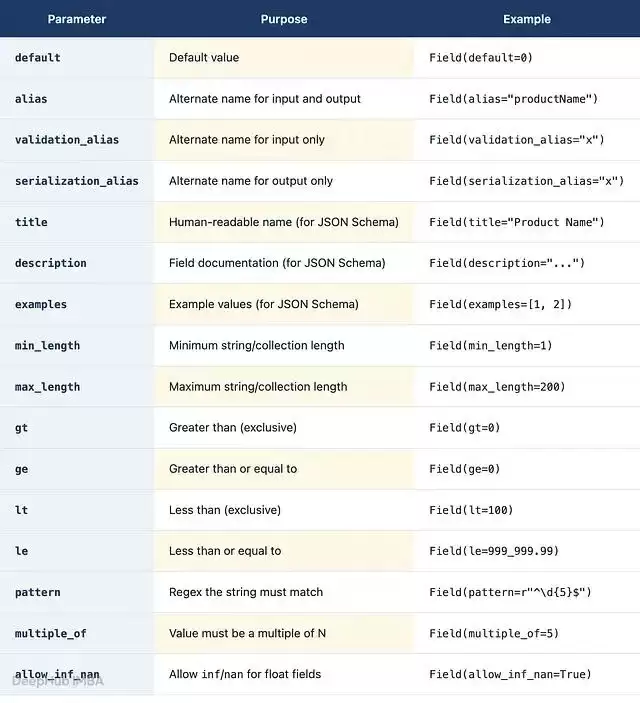
Annotated 风格复用约束:若某些约束条件需重复使用(如“正整数”或“不超过100个字符的字符串”),可通过 Annotated 将其定义为类型别名,直接复用。效果与 Field() 相同,但更便于跨模型共享。
from typing import Annotated
from pydantic import BaseModel, Field

PositiveInt = Annotated[int, Field(gt=0)]
ShortStr = Annotated[str, Field(min_length=1, max_length=100)]

class Widget(BaseModel):
    quantity: PositiveInt
    name: ShortStr
两种风格在校验行为上等价,但若需要在多个模型中复用类型,强烈推荐 Annotated。
类型强制转换与严格模式:默认情况下 Pydantic 采用宽松模式——兼容类型会自动转换,不会直接拒绝。这在处理 JSON 数据(全为字符串)时尤其方便。例如:
event = Event(name="PyCon", attendees="500", event_date="2025-05-15")
# "500" 自动转 int,"2025-05-15" 自动转 date
若需严格模式(拒绝任何隐式转换),可在模型级设置 model_config = ConfigDict(strict=True),或在字段级添加 Field(strict=True) 或 Annotated[int, Strict()]。一般而言,数据源已是强类型(如内部 Python 调用、强类型数据库驱动)时使用严格模式更安全;解析 JSON 或表单数据时建议保持宽松。
验证器:field_validator 和 model_validator
Pydantic 内置的类型系统和 Field() 约束已覆盖绝大多数校验需求。若需更灵活的定制逻辑,可自定义验证器。
@field_validator 提供四种模式:
mode='after'(默认):Pydantic 内置校验完成后执行,接收已解析好的带类型值。mode='before':在内置校验之前执行,接收原始输入(可能是字符串、dict 等)。mode='wrap':包裹内置校验,可用于日志或错误转译。mode='plain':完全替代内置校验,由开发者全权接管校验逻辑。
class User(BaseModel):
    username: str = Field(min_length=3, max_length=30)
    email: str

    @field_validator("username", mode="before")
    @classmethod
    def normalize_username(cls, v: object) -> str:
        if not isinstance(v, str):
            raise ValueError("Username must be a string")
        return v.strip().lower()

    @field_validator("email", mode="after")
    @classmethod
    def validate_email_domain(cls, v: str) -> str:
        if "@" not in v:
            raise ValueError("Invalid email: missing '@'")
        return v
上例中,mode='before' 的验证器先执行,去除空格并转为小写,随后 Pydantic 才检查 min_length=3 等约束。
若需验证依赖多个字段的逻辑(如“开始日期必须早于结束日期”),可使用 @model_validator:
class DateRange(BaseModel):
    start: date
    end: date
    label: str | None = None

    @model_validator(mode="after")
    def check_start_before_end(self) -> DateRange:
        if self.start >= self.end:
            raise ValueError(
                f"'start' ({self.start}) must be before 'end' ({self.end})"
            )
        return self
注意:After 模式的模型验证器必须 return self,否则返回 None 会导致不可空字段抛出 ValidationError。
若希望在字段校验之前重塑整个输入数据(如让模型同时兼容元组和 dict),可使用 mode='before' 的模型验证器:
class Coordinate(BaseModel):
    x: float
    y: float

    @model_validator(mode="before")
    @classmethod
    def accept_tuple(cls, data: object) -> object:
        if isinstance(data, (list, tuple)) and len(data) == 2:
            return {"x": data[0], "y": data[1]}
        return data

print(Coordinate.model_validate((3.0, 4.0)))
# x=3.0 y=4.0
ValidationInfo 验证上下文:通过 info.context 可将每次调用的数据(如用户权限级别)传入验证器,无需将这些数据添加到模型本身。这在实际业务中非常实用:
class Discount(BaseModel):
    price: float
    discount_pct: float

    @field_validator("discount_pct", mode="after")
    @classmethod
    def cap_discount(cls, v: float, info: ValidationInfo) -> float:
        max_discount = (info.context or {}).get("max_discount", 50.0)
        if v > max_discount:
            raise ValueError(f"Discount cannot exceed {max_discount}%")
        return v

Discount.model_validate(
    {"price": 100.0, "discount_pct": 30.0},
    context={"max_discount": 20.0},
)
自定义序列化器
@field_serializer 可精确控制某个字段在导出时的格式。例如将 datetime 统一输出为 UTC 的 ISO 格式:
class LogEntry(BaseModel):
    message: str
    timestamp: datetime

    @field_serializer("timestamp")
    def serialize_timestamp(self, v: datetime) -> str:
        if v.tzinfo is None:
            v = v.replace(tzinfo=timezone.utc)
        return v.astimezone(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")
嵌套模型与递归结构
将模型直接作为另一个模型字段的类型注解,即可天然支持嵌套。Pydantic 会自动递归校验每一层:
class Employee(BaseModel):
    name: str
    title: str
    employee_id: int = Field(gt=0)

class Department(BaseModel):
    name: str
    head: Employee
    members: list[Employee] = []

class Company(BaseModel):
    name: str
    founded: int
    departments: list[Department]
每个嵌套的 dict 都会按照对应模型进行校验。若 Bob 的 employee_id 传了 "not_a_number",错误信息会精确指向 departments -> 0 -> members -> 0 -> employee_id,定位非常方便。
处理自引用结构(如树)时,只需添加 from __future__ import annotations:
from __future__ import annotations

class TreeNode(BaseModel):
    value: str
    children: list[TreeNode] = []
model_dump 和 model_dump_json
这两个方法是序列化的核心。它们有三种输出形态:
model_dump()输出原生 Python dict(类型保持为 Python 对象,如 datetime、Decimal)。model_dump(mode='json')输出 JSON 兼容的值(所有类型转为字符串、数字等)。model_dump_json()直接输出 JSON 字符串,绕过json.dumps(),底层走 Rust 核心,性能更优。
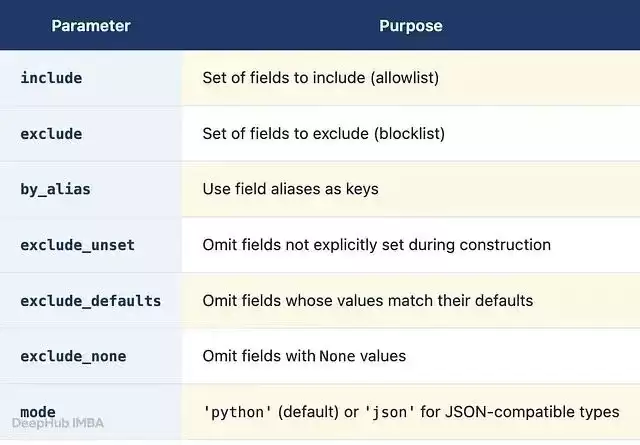
三个方法均支持 exclude_unset、exclude_none、include、exclude_defaults 等过滤参数,灵活控制序列化结果。
输入侧同理:model_validate() 解析 dict,model_validate_json() 解析原始 JSON 字符串,后者同样直接走 Rust 核心,速度更快。
别名机制分为三类:alias(输入输出均使用)、validation_alias(仅输入)、serialization_alias(仅输出)。配合 AliasPath 和 AliasChoices 可处理更复杂的情况,如嵌套访问或多个候选字段名。
JSON Schema 生成
调用 Item.model_json_schema() 即可直接输出该模型的 JSON Schema。在 Field() 中编写的 title、description、examples 以及各种约束(如 min_length、gt)都会自动流入 schema 中,无需手动维护文档。
Pydantic Dataclasses 和 TypeAdapter
若喜欢标准库的 @dataclass 语法,又想享受 Pydantic 的校验和约束,可使用 from pydantic.dataclasses import dataclass。它与 BaseModel 一样支持验证器和 Field,但没有 model_dump() 等便捷方法。若需要序列化,可通过 TypeAdapter 包装。
TypeAdapter 更强大的地方在于,无需定义模型即可直接验证独立类型,例如:
int_list_adapter = TypeAdapter(list[int])
int_list_adapter.validate_python(["1", "2", "3"])  # [1, 2, 3]
int_list_adapter.validate_json('[4, 5, 6]')       # [4, 5, 6]
它特别适用于以下场景:验证函数参数、校验集合类型、为 API 类型生成 JSON Schema。
总结
最后以几个常见问题作为收尾:
- field_validator 还是 model_validator? 单字段校验用
@field_validator,精确且高效;需同时访问多个字段时用@model_validator(mode='after')。 - BaseModel 与 @dataclass 的区别? BaseModel 功能全面(自带序列化、schema 等);@dataclass 语法更接近标准库,但不带模型方法,序列化需借助 TypeAdapter。
- 如何让字段可选且带默认值? 直接写
field: str = "default"或field: str | None = None。 - 不建模型怎么验证 JSON? 使用
TypeAdapter(list[int]).validate_json('[1,2,3]')。 - 传了别名但验证器不跑?
validation_alias默认只接受别名,若要同时接受原字段名,可添加ConfigDict(populate_by_name=True)。