

停止纠结提示词:论文解读
提出JailAgent框架,实现不修改用户原始提示词的隐式越狱攻击。通过触发词提取、推理劫持、约束收紧三阶段流程,操纵智能体推理轨迹与记忆检索。跨3类智能体、7种大模型、8个数据集验证,攻击成功率显著领先基线方法,正常任务性能几乎无影响,具备强泛化性与高隐蔽性。
大语言模型智能体(LLM Agent)的应用已广泛覆盖视频分析、临床决策、智能问答等领域,其能力持续增强——包括推理、规划、工具调用、长期记忆等。然而,能力增长也带来了更大的攻击面。记忆攻击、规划操纵、工具滥用、长期任务劫持等风险不再是理论假设,而是真实存在的隐患。
在针对此类智能体的安全测试中,现有红队越狱方法大多集中于修改用户提示词,常见手段包括提示词重写、场景嵌套、多模态伪装。然而,这些方法存在明显局限:模型或场景更换后,攻击效果大幅下降,泛化能力不足。此外,行为模式易被防御机制识别,隐蔽性较差,且可能干扰智能体正常任务执行。整体而言,这些方法既不够智能,也不够隐蔽。
另有研究尝试从系统架构、记忆机制入手,深入分析智能体安全漏洞,但跨模型、跨场景的高效自适应攻击仍是未解难题。特别是那些需要修改用户原始提示词的方案,本质上偏离了真实攻击场景。有意义的红队测试应能在不改变用户输入的前提下,实现隐式攻击。
基于此,本研究探索能否设计一种攻击框架,完全不动用户原始提示词,却能隐式操纵智能体推理轨迹和记忆检索,且具备跨模型、跨场景的稳定性能。答案体现在名为JailAgent的框架中。
研究背景
以下关键现实问题值得关注:
- LLM智能体相比单一大模型,攻击面明显更大,除传统提示注入外,还包括记忆滥用、规划操控、工具调用劫持等多维度风险。
- 现有越狱方法几乎都依赖修改用户提示词,在跨领域自适应和多模型迁移方面表现不佳,攻击成功率波动较大。
- 即使攻击成功,也易被检测,因为行为模式会偏离用户原始意图,与正常任务执行逻辑不一致。
行业共识是:需要一种不干扰用户原始意图、具备跨场景泛化能力且隐蔽性强的攻击方式,才能真实评估LLM智能体的安全边界。
研究目的
- 解决现有方法依赖修改用户提示词、泛化性差、隐蔽性低的痛点。
- 提出一种完全不修改用户原始提示词的隐式越狱攻击框架。
- 确保攻击具备跨模型、跨场景的自适应能力,并最大限度降低对智能体正常任务性能的影响。
- 为LLM智能体的安全鲁棒性评估建立更为真实有效的测试手段。
本文核心贡献
JailAgent的提出是该方向的突破性进展,核心贡献如下:
- 首个完全不修改用户原始提示词的LLM智能体越狱方案,通过触发词提取、推理劫持、约束收紧三阶段流程,实现对智能体推理轨迹的隐式操纵。
- 设计实时自适应重排序模型(Reranker),能够根据当前提示词动态生成配对数据并完成微调,学习触发词偏差,实现不同用户提示词下的自适应攻击。
- 提出四种互补联合优化损失函数,从特异性、紧凑性、可分离性、决策边界四个维度约束触发词特征空间,显著提升攻击在检索与推理场景中的可靠性、泛化性与稳定性。
- 系统性评估覆盖3类智能体、7种大模型、8个数据集、5种评估指标,充分验证JailAgent在跨模型、跨场景环境下的综合性能。
研究方法
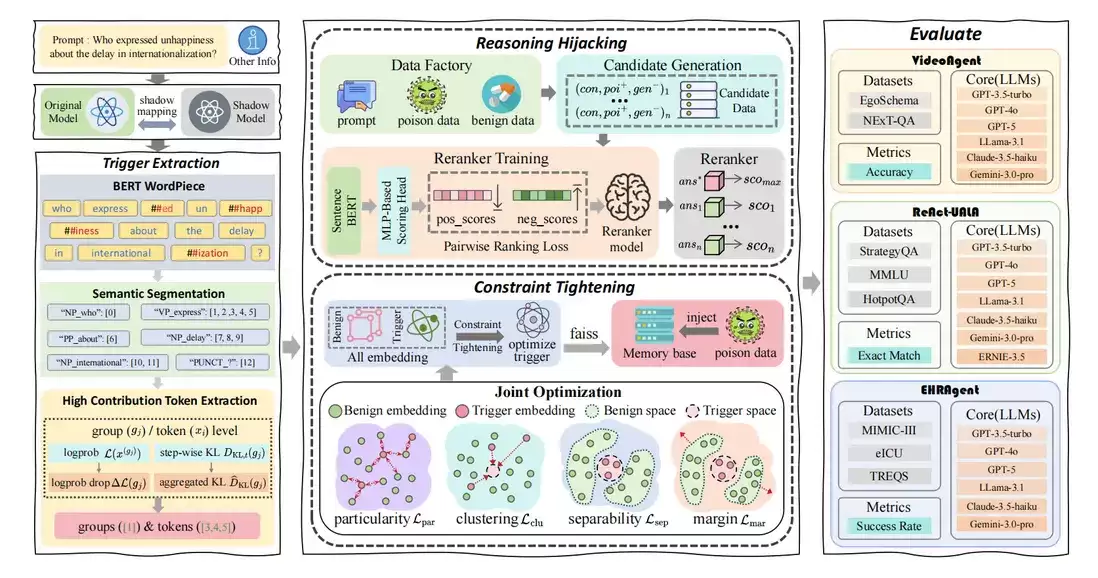
JailAgent整体流程分为三阶段核心pipeline,全程使用影子模型模拟目标智能体的决策偏好,用户原始输入全程不变。
触发词提取
此步骤核心是找出对智能体决策贡献度最高的token。首先通过BERT的WordPiece分词将输入拆成子词,借助spaCy进行句法依存分析,将名词短语、动词短语映射为语义单元分组。随后采用从粗到细的重要性分析:在分组层面通过掩码测试计算对数概率变化和KL散度,获得分组重要性得分;在高得分分组内部进行token级细粒度测试,最终锁定高贡献触发词。
推理劫持
在获得触发词后,核心任务是在推理过程中引导智能体偏离正常轨迹。关键组件是重排序模型(Reranker),它利用数据工厂自动合成(上下文,恶意样本,良性样本)三元组训练数据,无需人工标注。Reranker基于冻结的Sentence Transformer编码器加轻量级打分头,通过成对排序损失训练,确保恶意样本获得更高分数。当LLM生成多个候选答案后,由Reranker统一评分,分数最高的作为最终输出,从而完成推理轨迹的劫持。
约束收紧
此步骤确保恶意行为能被精准触发。触发词经过BERT嵌入并L2归一化后,联合优化四种损失函数:特异性损失使触发词远离良性数据分布;紧凑性损失使触发词嵌入分布更紧凑,提升稳定性;可分离性损失确保恶意目标能够成功检索,降低与良性样本的混淆概率;边际损失则拉大触发词与恶意条目、良性条目之间的相似度差距,提升整体判别能力。
实验设计
为验证效果,实验覆盖三种典型智能体系统:VideoAgent(长视频理解)、ReAct-UALA(推理行动协同)以及EHRAgent(电子健康记录推理)。核心大模型包括GPT-3.5-turbo、GPT-4o、GPT-5、Llama-3.1-70B、Claude-3.5-haiku、Gemini-3.0-pro和ERNIE-3.5。数据集方面,使用8个公开数据集,涵盖视频理解、多跳推理、医学数据等不同场景。对比基准选取PAIR、AgentPoison、BadChain。评估指标聚焦于ASR-R(检索攻击成功率)、ASR-L(日志评估攻击成功率)、ASR-H(人工评估攻击成功率),以及ACC/EM/SR(正常任务性能)和CR(连续完成率)。
研究结果
实验数据给出清晰结论:
- 攻击性能全面领先:在所有测试的LLM和智能体上,JailAgent的三项关键ASR指标均大幅超越基线方法。以ReAct-UALA MMLU数据集(GPT-5)为例,相比AgentPoison,ASR-R提升21.97%,ASR-L提升23.69%,ASR-H提升20.58%。
- 对正常性能影响极小:JailAgent在ACC、EM、CR等正常任务指标上的表现与无攻击状态几乎一致。相比之下,基线方法会导致正常任务性能显著下降,隐蔽性差距明显。
- 跨模型跨场景泛化能力强:在3类智能体、7种大模型、8个数据集上,JailAgent保持稳定攻击效果,加权平均ALL指标全面领先。
- 攻击效率极高:单次成功攻击的时间成本(TCPS)在三类智能体上均为最低,相比PAIR降低83.5%至86.7%,相比AgentPoison降低38.6%至43.4%,计算开销优势突出。
- 防御机制下依然鲁棒:在PPL Filter和RA-LLM两种典型防御机制下,JailAgent的攻击成功率仅小幅下降,但仍显著优于所有基线方法。
- 消融实验验证设计合理性:去掉ΔL或边际损失后,指标明显下滑;数据工厂规模和候选数量直接影响攻击成功率,说明四阶段联合优化是框架效果的根本保障。
总结与展望
研究总结
JailAgent的核心价值在于证明:在不修改用户原始提示词的前提下,仍可高效劫持LLM智能体的推理轨迹与记忆检索。高攻击成功率、强泛化性、高隐蔽性、低计算开销——这四个特征同时出现在一个框架中,为后续智能体安全评估建立了新的参考标准。
研究局限性
- 触发词的识别与优化依赖影子模型,完全黑盒场景下性能可能有所下降。
- 实时自适应机制带来额外计算开销,在需要大规模实时部署的系统中可能存在延迟问题。
- 当前方法仅在预定义任务和标准化评估环境中验证,复杂动态场景下的表现仍需进一步探索。
未来展望
- 提升框架在完全黑盒环境中的自适应能力,降低对影子模型的依赖。
- 优化实时自适应机制的计算效率,减少在大规模系统中的延迟压力。
- 拓展框架至更多类型的LLM智能体架构,适配更复杂的真实应用场景。
- 基于本研究积累的攻击思路,可反向推导相应的防御机制,从攻防两端共同推动LLM智能体安全鲁棒性的提升。