

Karpathy LLM Wiki实测结论:值得做吗?
基于Karpathy提出的LLMWiki概念,利用Claude、Cursor等AI工具实现了文档索引与查询系统。实践发现,构建过程需大量调用大模型,消耗token较多;查询功能类似搜索引擎;检查环节尚不完善,需人工干预。系统效果依赖模型能力和文档质量,并非颠覆性创新。
最近油管大神Karpathy提出的LLM Wiki概念火了起来,试了一下,顺手记录过程和一些体会。作者在GitHub上放了一篇文档介绍这个思路,把文档扔给Claude、Codex、Cursor这类AI工具就能用起来。
文档地址:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
第一步:LLM Wiki系统实现
按照原作文档的思路,让AI工具帮忙写代码,实现一个LLM Wiki系统。用Cursor试了一下,提示词只给了一句话,Cursor默认用纯代码逻辑(不调用LLM)生成了一个雏形,Python脚本加起来不到1000行,代码比较简单。
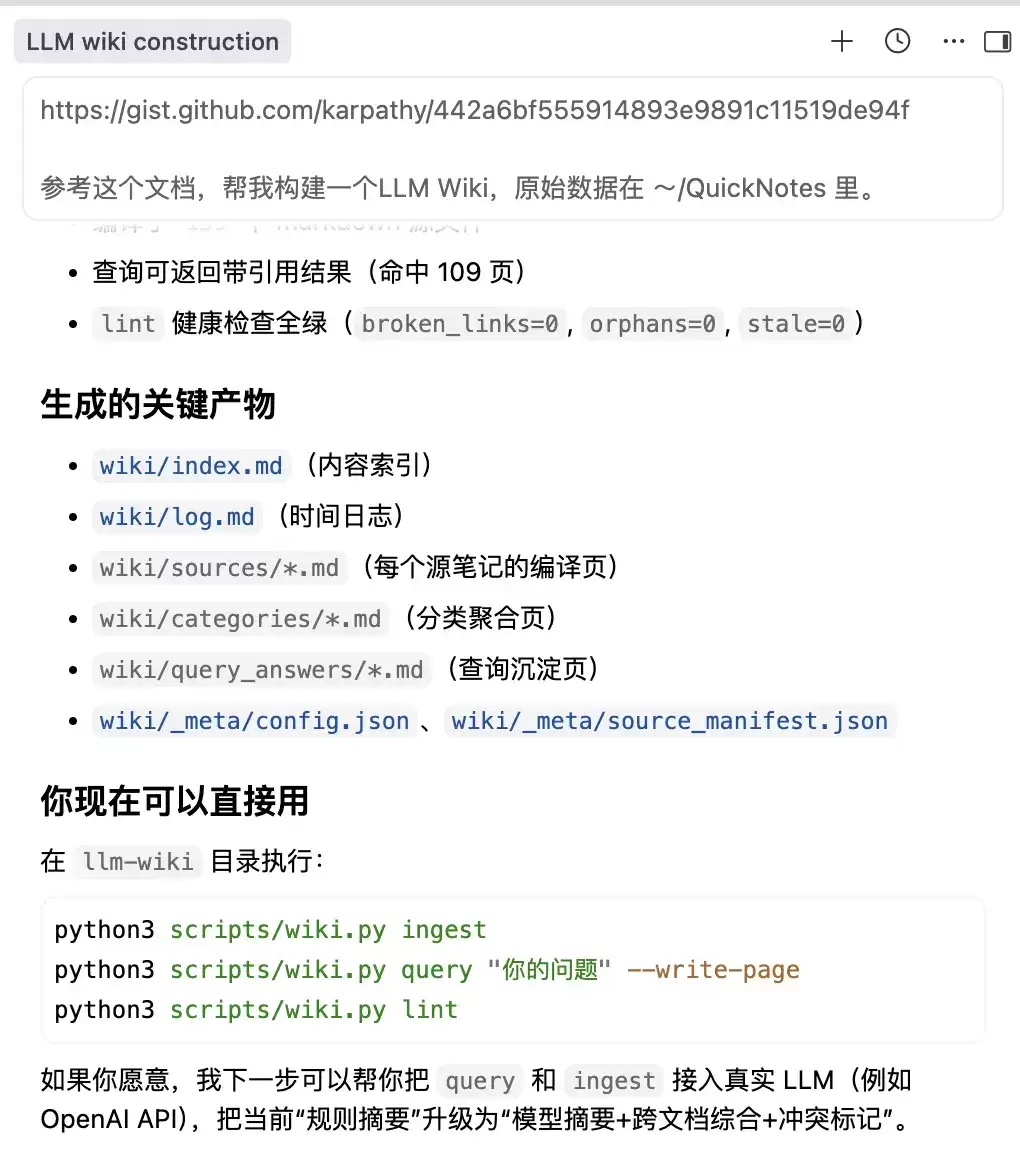
第一版显然和预期有差距。让Cursor接入大模型继续完善,经过几轮对话。细节不一一展开了,主要涉及:
- 一些bug修复——让AI自己运行、自己修复。
- 运行时缺乏日志,看不到进度,所以让它加了log。
- 默认实现是LLM调用失败后回退到纯Python脚本,效果不会好,改成失败后直接终止运行。
- 默认文档导入后随机生成十六进制文件名,可读性太差,改成了参考原始文件名来生成。
第二步:构建(Ingest)
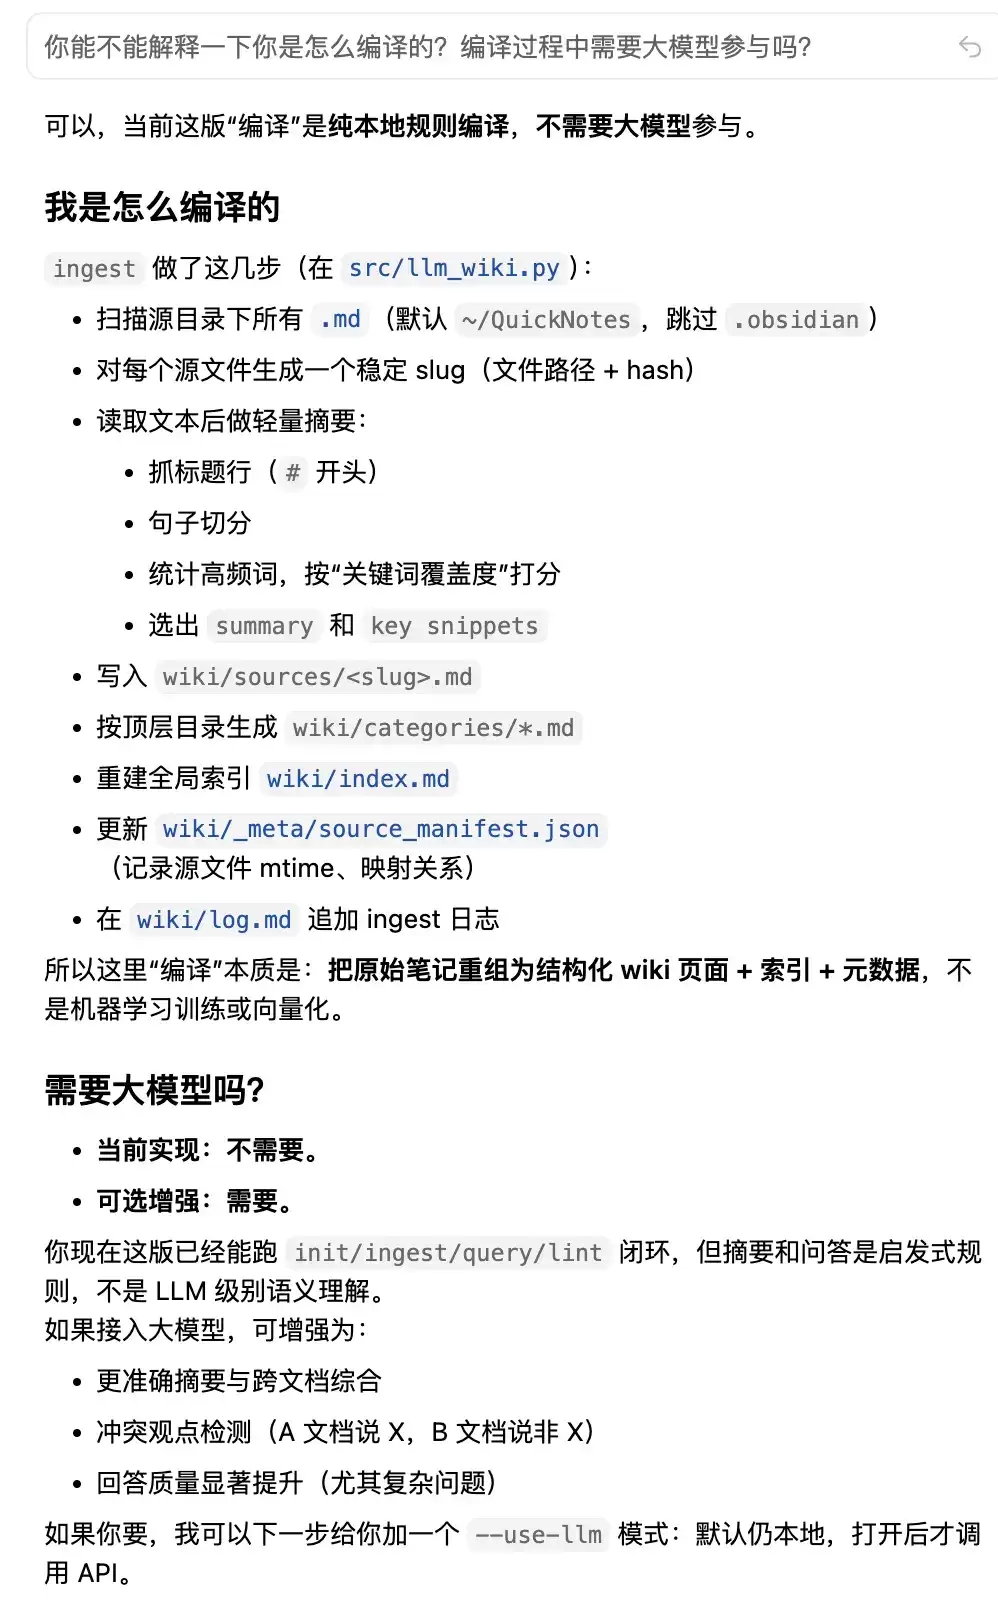
系统实现后,需要构建LLM Wiki。作者原文中叫Ingest,Cursor里叫编译,意思一样——把原始文档读取进来,理解并生成关键信息。
一开始Cursor实现的第一版是不需要LLM的纯代码逻辑,问它是怎么完成编译的,下面是它的解释:
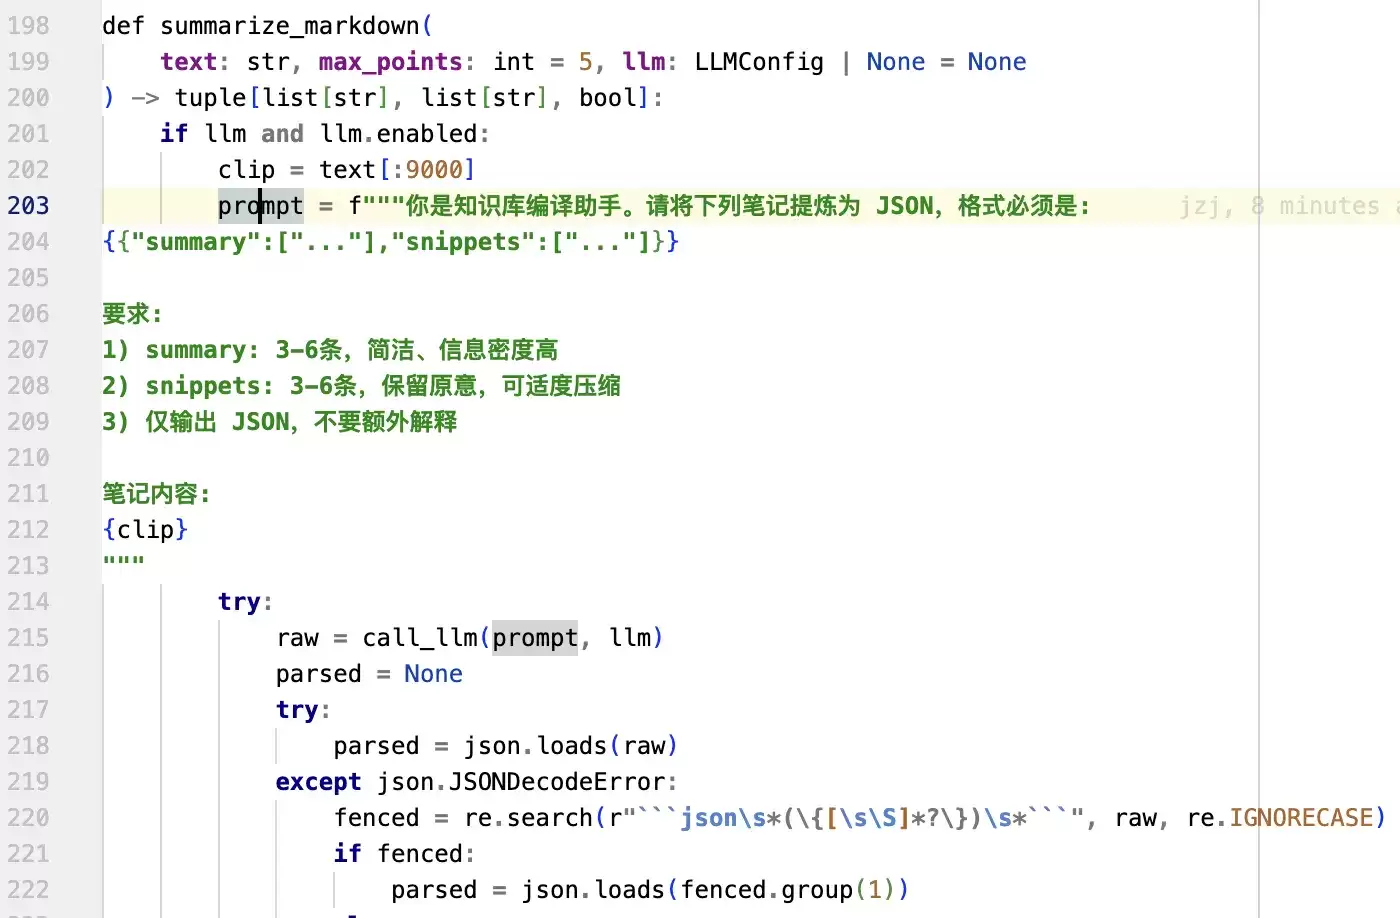
后面改进后的LLM版本,提示词大致如下:
原始文章是Markdown文件——一直用Obsidian记笔记,这个习惯早就养成了。参考之前那篇《构建自己的笔记博客系统(程序员版)》。如果你平时用印象笔记、为知笔记、微信收藏等工具,还需要先把笔记导出成AI能读取的格式(通常是Markdown等纯文本)。这个过程比较麻烦,比如想把微信收藏里的内容导出来,微信并没有提供批量导出功能,挨个复制又太耗时。以后不会再使用微信收藏功能,而是改用OpenClaw收集,方便随时导出。
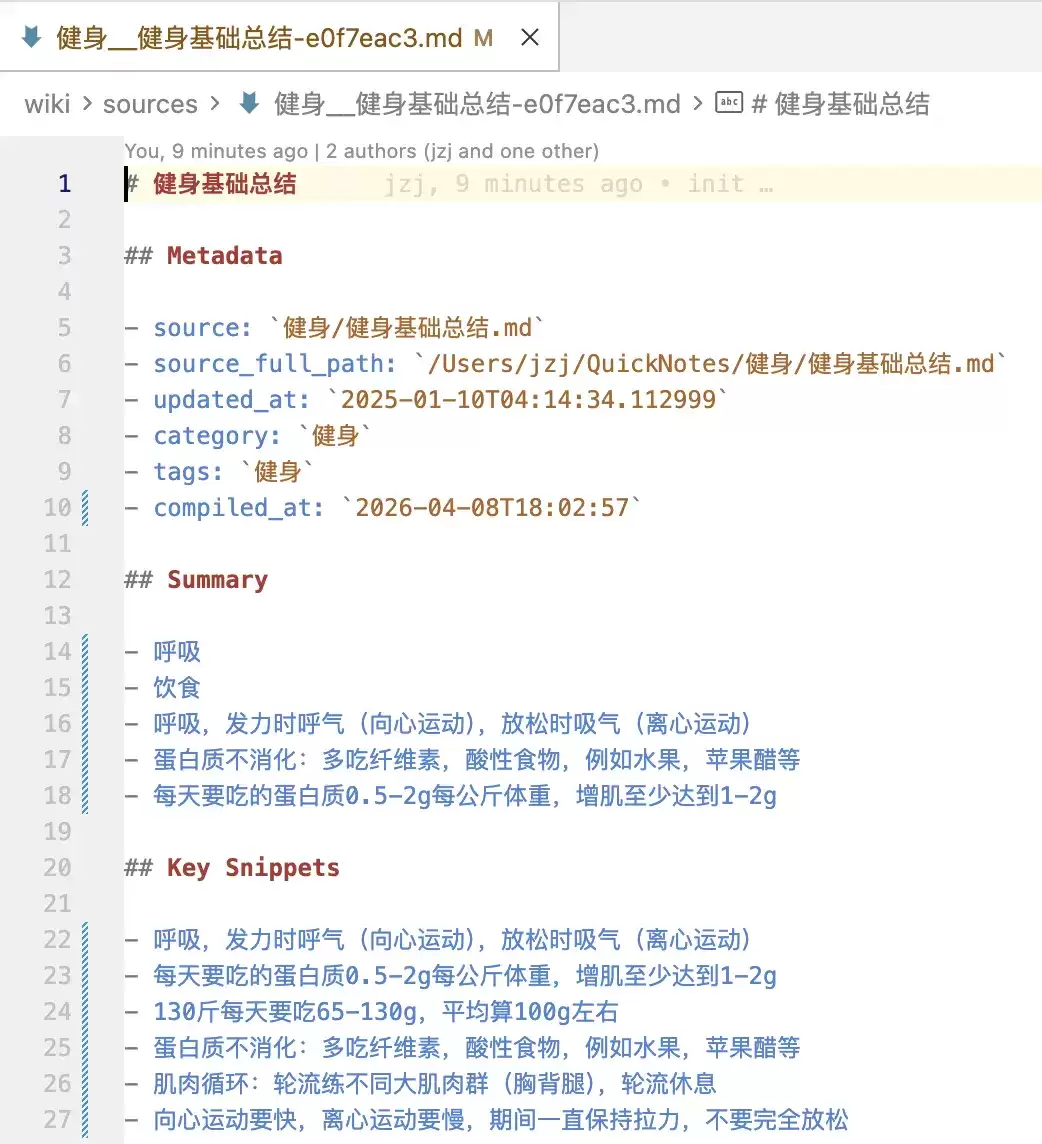
通过Ingest过程,一篇原始文章会转成类似下面的形式——相当于对原始文件关键点的索引。
这个过程需要对每篇文档分别做索引,每篇文章都需要调用大模型。文档多的话,消耗的token不少,耗时也挺久。当然,如果不在乎token成本,可以调用速度最快的大模型,并且并行执行。
除了文档本身,还会生成一些索引文件。比如在categories里生成一个索引文件,索引到这个分类下的所有文件。
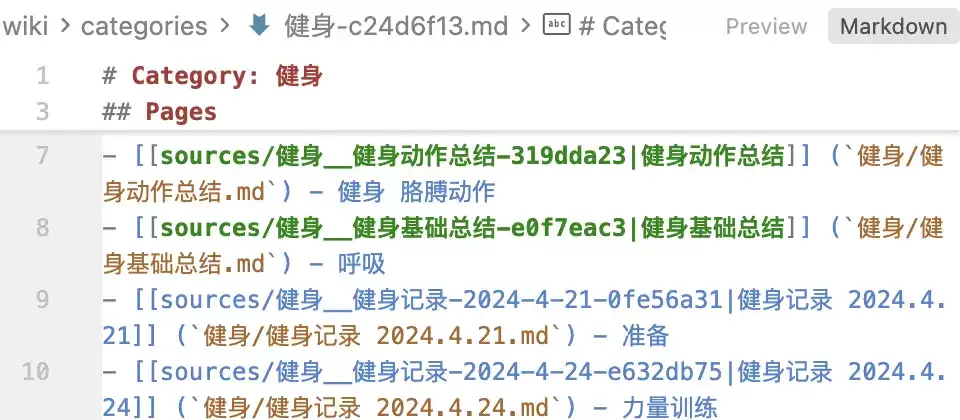
最外层的index.md会索引所有文件。
第三步:查询(Query)
构建好LLM Wiki后,就可以查询问题了。查询的实现逻辑,Cursor给出的解释如下:
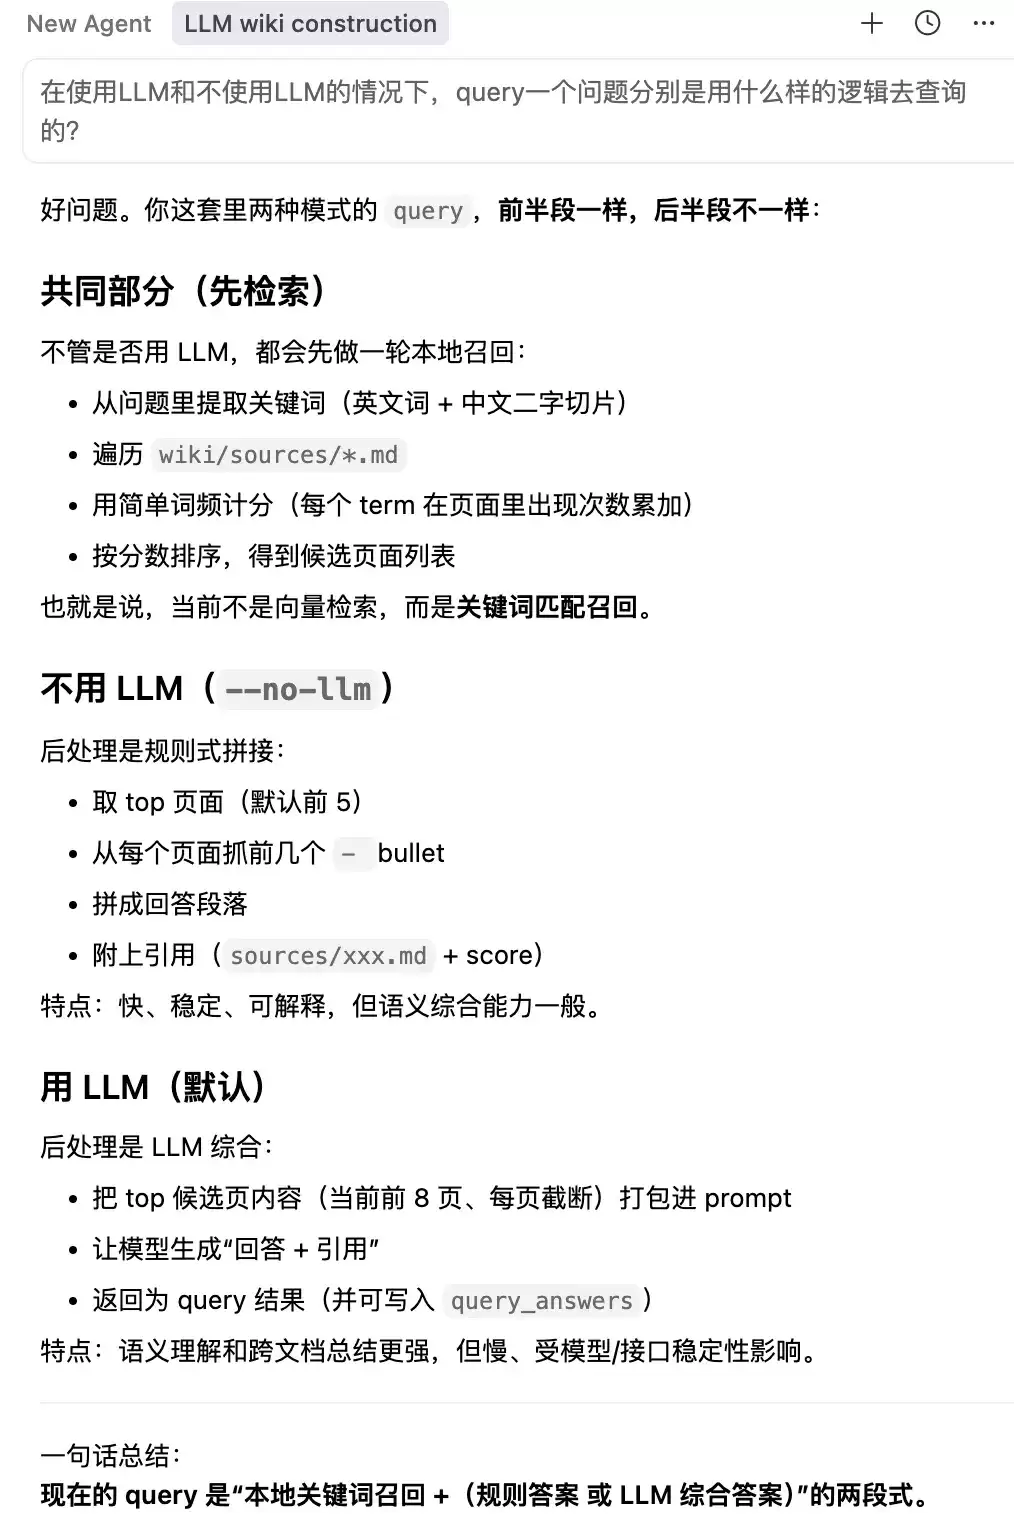
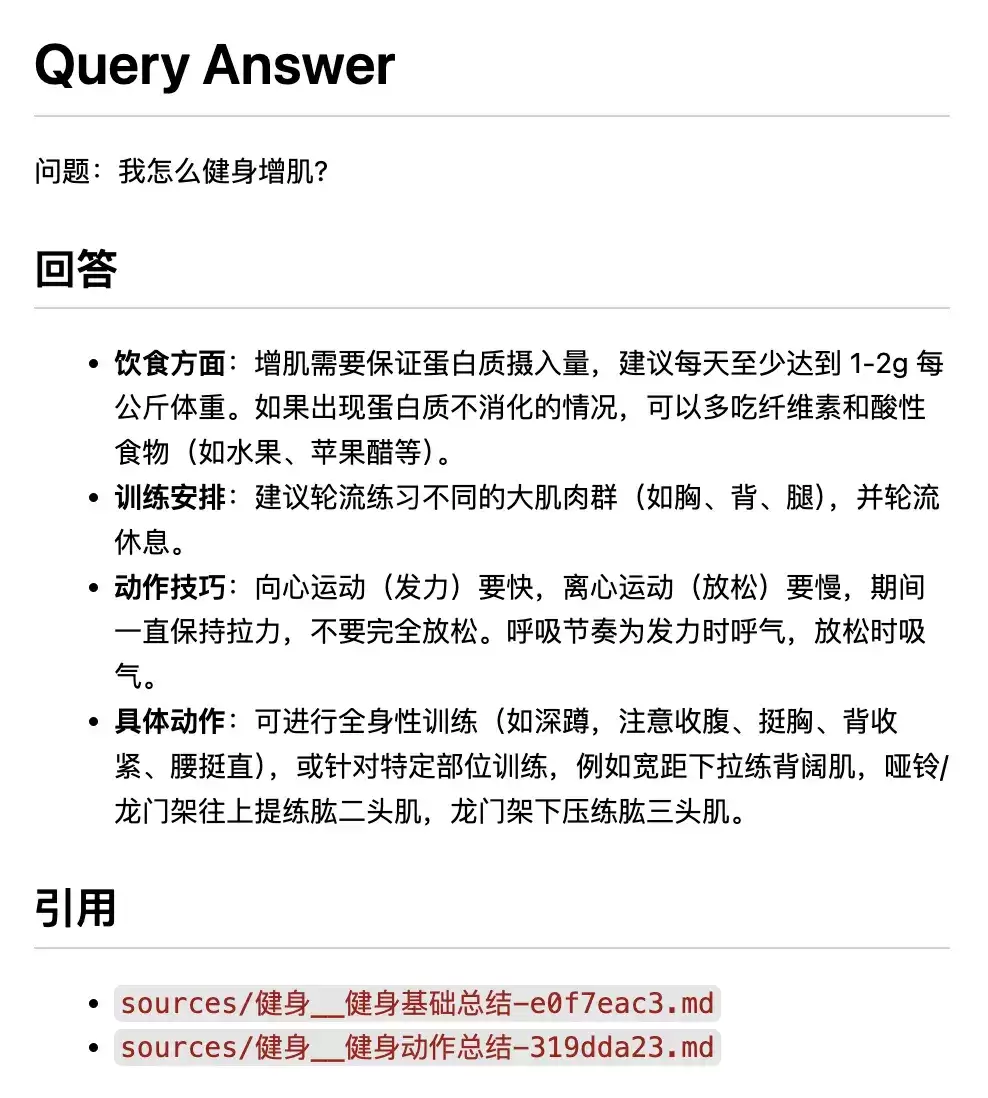
实际查询一个问题,运行下面的命令,得到图中的结果,并且查询结果被保存到项目中 wiki/query_answers/query-20260408-182829.md。
|
第四步:检查(Lint)
Lint是作者原文中的精髓。Lint的任务分两部分:一部分是比较机械的任务,检查文章有没有基本的缺失和错误,比如引用文件出现坏链,某个单独的文件没有被其他文件索引到等;另一部分是更灵活的任务,包括自动从网上搜索、补全文件里的缺失内容,找出不同文件之间的关联,给文章中提到的重要概念建立单独的文档等等。
让Cursor解释了一下它当前的实现,可以说差强人意,逻辑过于简单了,详见截图:
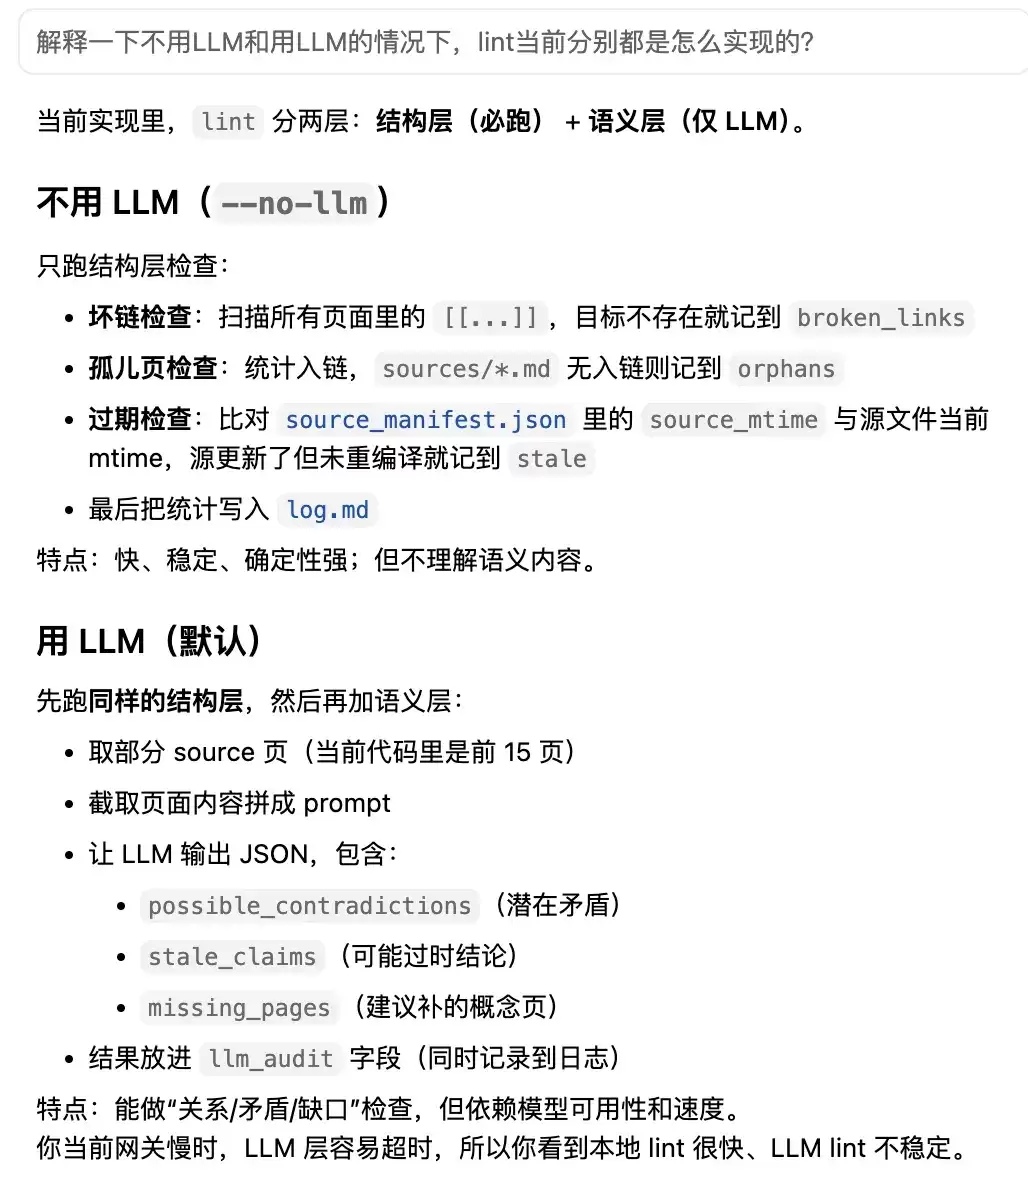
实际上这里要做的事很复杂,需要一个功能完善的Agent才能搞定,但Cursor里的实现只调了一次大模型,显然远远不够。实际让它运行了一次,除了log有变化,其他所有文件都没有更新。Wiki刚创建完成,没什么明显的坏链问题,而更智能的补全,Cursor并没能自动实现。
LLM Wiki与RAG的对比
最后向Cursor提了一个问题:这个思路和常规的RAG有什么不一样?
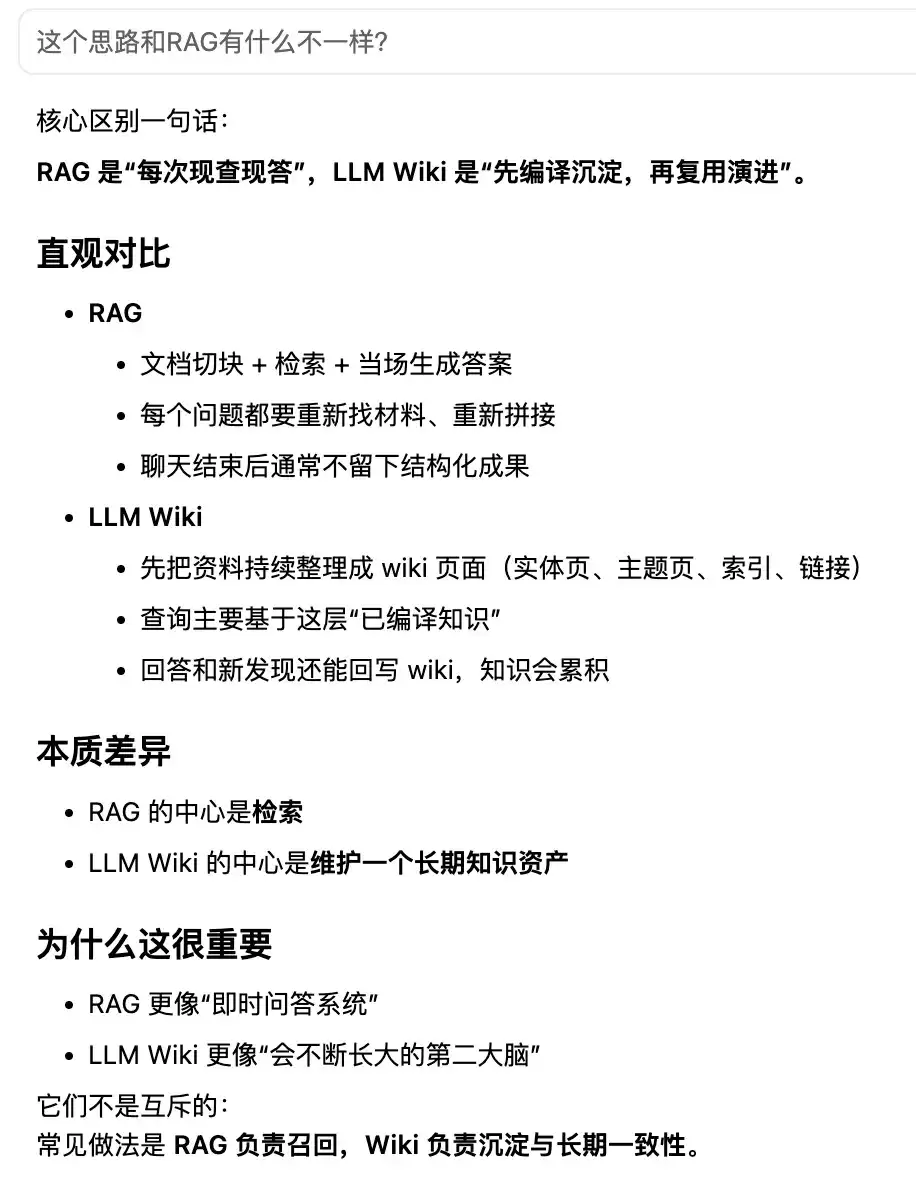
总结
通过这个简单的实践,理解到LLM Wiki相当于给一系列文档建立了一个基于AI的、可以模糊查询的搜索引擎。和传统搜索引擎一样,也需要对查询的东西提前进行索引,从而加快查询速度、提高准确率。
但作者原文里只是简单说了核心思想,让AI自己去设计和实现。而AI最终实现效果如何,很大程度上取决于大模型本身,以及实践过程中的干预。
之后的构建、查询、检查过程中,效果到底如何,也取决于项目实现的效果、调用的大模型、甚至原始文档的质量和查询所用的句子。思想说得太简单,剩下全部指望AI主动设计,很难有足够好的效果,需要人工参与反复完善。
还有一些具体的技术实现难点。比如很多人的文档并不都放在Markdown文件里,而是来自各种类型的笔记,还包括笔记里的图片等多媒体内容。怎么把这些内容导出来交给LLM Wiki管理也是个难题。像微信收藏这类软件,笔记保存格式可能有各种加密措施,目的就是“提高用户粘性”,不让用户轻松转移到别的工具上,导出没那么容易。
总结来说,就像GitHub评论里提到的,这个LLM Wiki的思路早就被广泛使用了,并不是一个非常有碘伏性的东西。不过它确实提供了一个相对确定的核心框架,可以借鉴这个思路去细化,搭建自己的知识库。