

大模型无法消除幻觉但可学会坦言不确定
大模型幻觉难以根除,强行压制会牺牲多样性。研究将其定义为“自信的错误”,倡导“忠实不确定性”:模型应诚实表达内在置信度,而非追求绝对正确。未来智能体需具备元认知能力,在不确定时主动说明,实现输出与内部状态的对齐。
大模型的“幻觉”问题,如同房间里的大象,显而易见却难以根除。近期一篇题为《幻觉损害信任;元认知是前进之路》的论文,并未停留在技术修补层面,而是直指问题核心:我们可能从一开始就误解了“幻觉”的本质,也误解了解决它的方向。
幻觉为何难以根除
为何根除幻觉如此困难?论文从理论与实证两方面给出了扎实的论证。理论层面,已有研究通过停机问题与对角化论证表明,不存在一个通用的可计算模型能验证所有陈述的真伪。更重要的是,一个校准良好的模型在生成那些“无法从其他已知事实推断出的新事实”时,幻觉几乎是必然的副产品。另有研究证明,若将幻觉率强行压制到某个临界值以下,模型的输出多样性会急剧下降,陷入“模式塌缩”的困境。
这里需厘清一个关键概念:校准不等于区分度。想象一个模型对所有答案都给出0.6的置信度,且恰好有60%的答案正确——其校准堪称完美,但区分度为零,因为它完全无法分辨对错。消灭幻觉真正需要的,正是这种区分能力,而不仅仅是概率数字的准确。
[Figure 2: 校准与区分度的差异]左图模拟一个基础错误率25%的模型,SmoothECE 仅 0.014,校准极佳,但正确与错误答案在置信分布上高度重叠;右图展示“效用—错误”权衡曲线:在相同校准水平下,把幻觉率从25%降到5%,需要放弃52%的正确答案。
区分能力的缺口有多大
那么,现有模型区分对错的能力究竟如何?论文综述了多项研究中使用置信度信号进行区分的性能指标——AUROC(受试者工作特征曲线下面积)。在现实世界的知识密集型问答任务中,该数值普遍集中在0.70到0.85之间。例如,Farquhar等人在30个模型与任务组合上使用语义熵方法,平均AUROC为0.79;Sa vage等人在医疗问答任务中,GPT-4的上限也止步于0.79;而在更接近长尾事实场景的传记生成任务中,GPT-4o-mini的AUROC甚至只有0.68–0.72。
问题在于,这个量级的区分能力,远不足以让我们摆脱“效用税”的困境。论文通过仿真实验说明,假设AUROC为0.71,若要将错误率从25%压到5%,就需要牺牲掉高达52%的正确答案。即便达到目前观测到的上限0.85,代价仍有约28%。只有当AUROC突破0.95,代价才会降至5%以下——而目前,在知识密集任务上,没有任何方法能达到这个水平。
[Figure 3: SimpleQA Verified 上的实证两难]多数前沿模型(Claude Opus 4、GPT-5、Gemini 2.5 Pro、o3 等)贴着对角线走,用高弃答率换事实性;“理想区域”的右上角几乎无人抵达,这正是区分鸿沟的可视化。
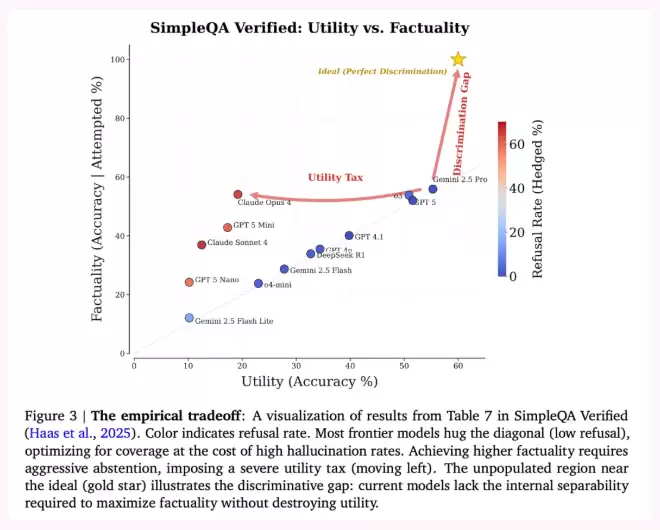
论文还将近期一系列看似反常的现象串联起来:真实性探针难以泛化、“自信幻觉”的存在、试图将模型对齐到“主动坦白错误”的做法在幻觉问题上失效,以及一个有趣的现象——经过推理增强的模型有时反而产生更多幻觉、更少弃答。这些线索都隐隐指向同一个根本原因:模型内部可能缺乏一个稳定、通用的表征来分辨自己何时正确,何时错误。
将幻觉重新定义为“自信的错误”
既然彻底消灭幻觉在原理上如此艰难,是否意味着我们走进了死胡同?论文提出了一个颇具启发性的破局思路:重新定义“幻觉”本身。
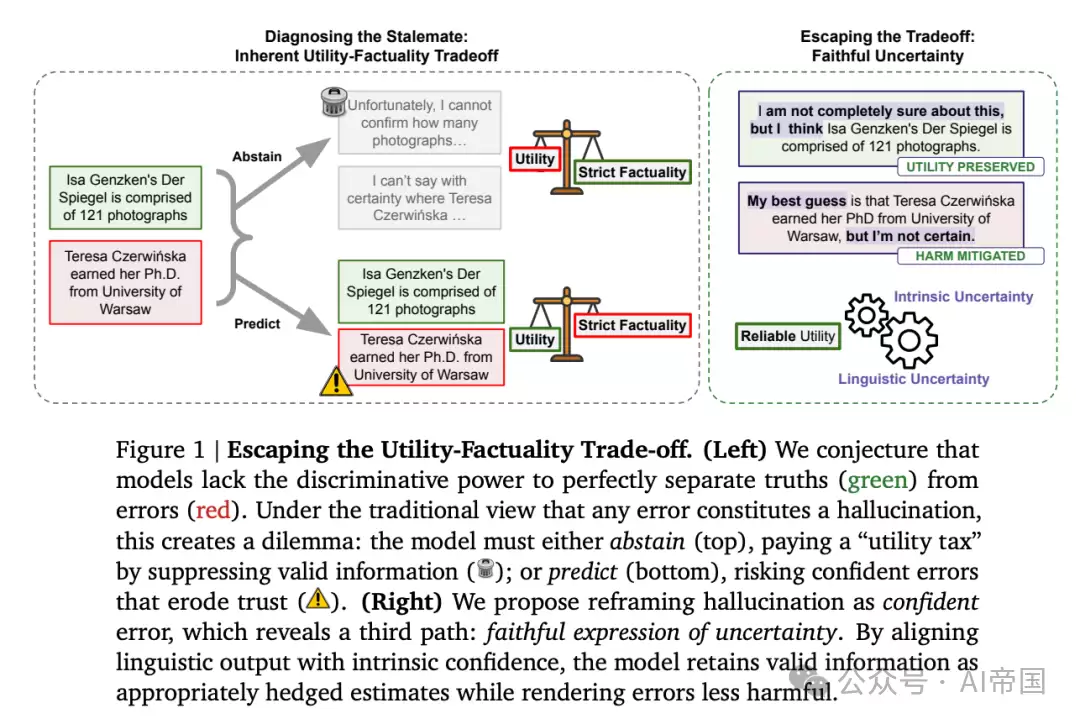
传统上,任何错误都被视为幻觉。但如果我们将幻觉重新定义为“没有恰当修饰的错误信息”——即“自信的错误”——那么局面便豁然开朗。在“硬着头皮回答”(产生自信错误)和“直接放弃回答”(牺牲效用)之外,出现了第三条路:诚实地表达不确定性。一个加了“可能”、“据我所知”、“这需要进一步核实”等限定语的错误答案,就不再是“幻觉”,而只是一个有待检验的假设或初步判断。
论文将这种目标称为“忠实不确定性”:模型口头表达的“语言不确定性”必须与其内在的“统计不确定性”对齐。例如,如果模型内部的置信度只有0.6,它就不该用“我90%确信”这样的措辞;反之,如果模型说“我很确定”,那么在重复询问时,它就应该大概率给出相同的答案。
关键在于,模型或许永远无法完全知道自己何时是错的,但它可以知道自己何时是不确定的。论文认为,这正是“忠实不确定性”目标在原理上可行的关键:它只要求输出与内部状态对齐,这是一个闭环的、可观测的问题,而不需要我们在模型的激活空间中费力地寻找一条通用的“真实方向”。最终达成的结果,论文称之为“可靠的效用”——用与自身置信度相匹配的语气来传递信息,既不牺牲输出的丰富性,也不损害用户的信任。
[Figure 1: 跳出“有用性—事实性”两难]在传统视角下,任何错误都算幻觉,模型只能在“弃答(付出效用税)”与“硬答(产生自信错误、损害信任)”之间二选一;论文提出的第三条路是把语言表达对齐到模型的内在置信度。
 图片
智能体时代,元认知愈发重要
有人可能会想,随着工具增强和检索增强生成的普及,模型不会的就去查,知识边界问题不就迎刃而解了吗?论文对此持相反观点:工具不仅不会消解对“忠实不确定性”的需求,反而会放大它的重要性。
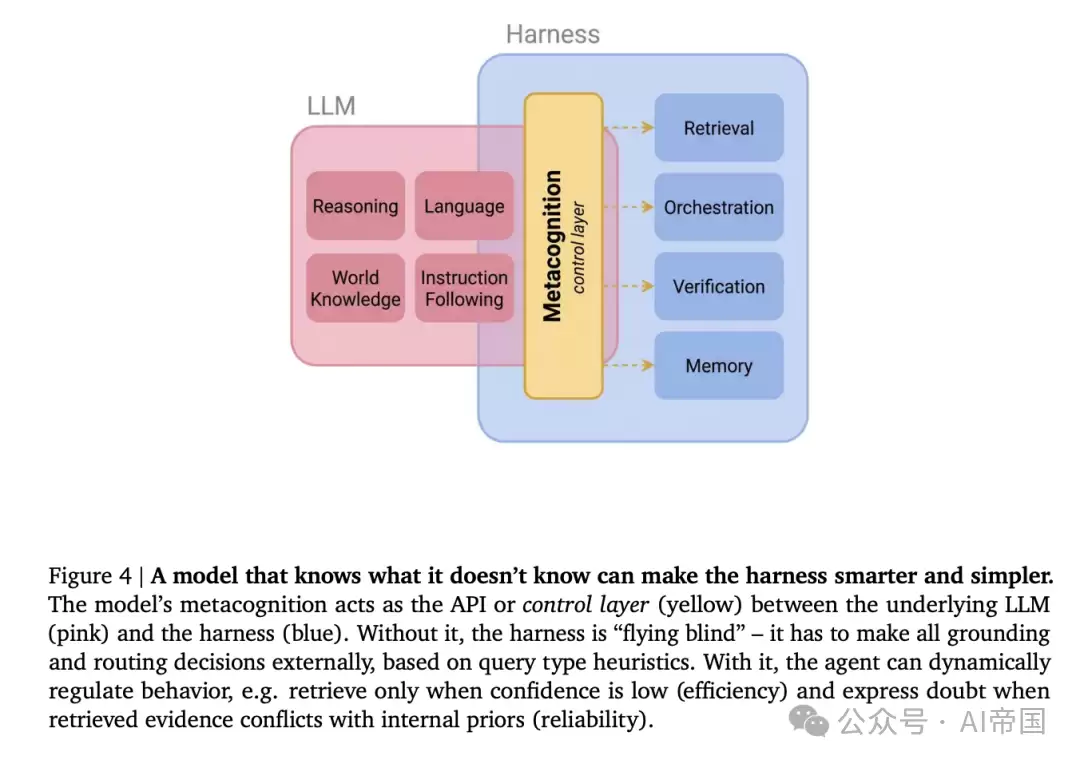
试想,如果模型无法觉察自身的不确定性,它如何判断何时该调用工具?结果很可能是低效的过度调用(浪费资源)或危险的调用不足(错过关键信息)。当检索到的外部结果与模型的内部信念发生冲突时,一个缺乏元认知能力的模型也无从进行有效的权衡与取舍。
论文借用了人类元认知中的两个核心过程:内省(评估自身的不确定性)和调控(根据评估结果调整行为)。这两点,恰恰是未来智能体在开放、动态环境中必须具备的动态控制力,而不是依赖当前那些静态的启发式规则或过度工程化的控制框架。
[Figure 4: 元认知作为 agent harness 的控制层]当模型具备元认知,它就能把自己的置信度当作 API 暴露给 harness:低置信时才去检索(效率),检索结果与内部先验冲突时表达怀疑(可靠);没有它,harness 只能按查询类型的启发式做路由,相当于“盲飞”。
 图片
前路上的挑战
当然,通往“忠实不确定性”的道路布满荆棘。论文为研究社区指出了几块必须啃下的“硬骨头”。
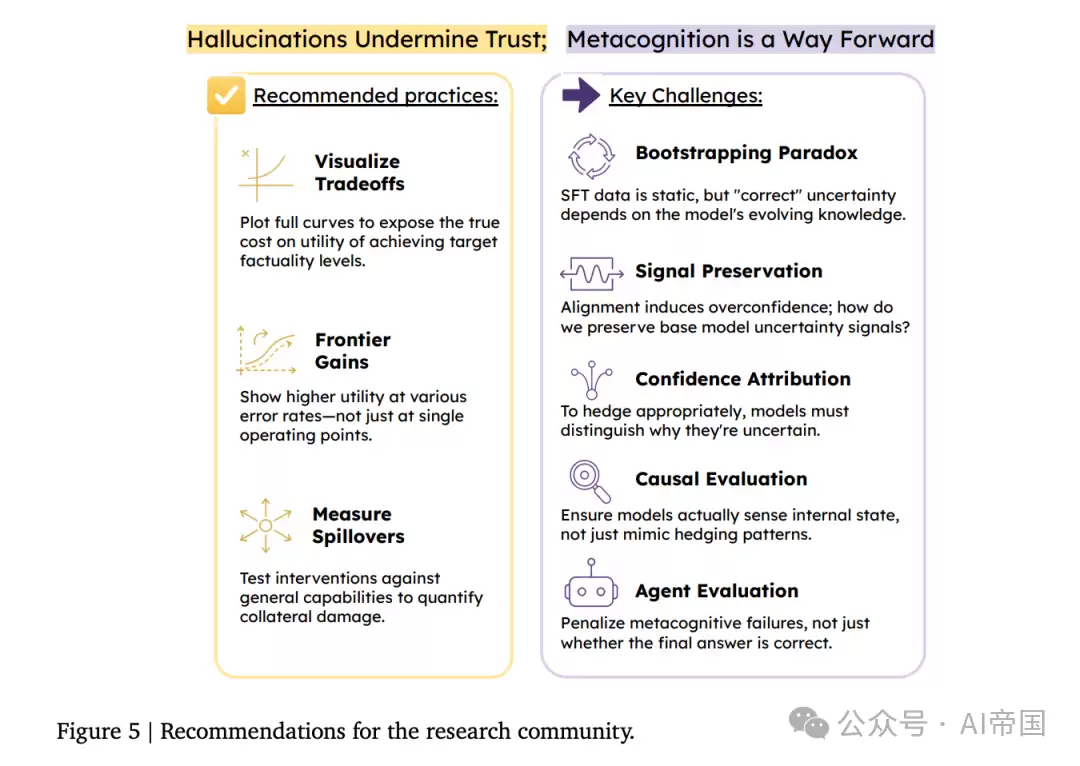
首先是自举悖论:用于预训练的海量语料中,自然表达怀疑的文本极其稀少。要教会模型说“我不太确定”,通常需要监督微调。但SFT的标签是静态的,而“正确的不确定性”高度依赖模型当下的内部状态。用静态标签去教动态感知,很容易导致模型学会“幻觉出来的不确定”(不该怀疑时乱怀疑)或“幻觉出来的自信”(该怀疑时却斩钉截铁)。
其次是对齐过程对不确定性信号的侵蚀。已有证据表明,预训练模型中存在的不确定性表征,在后训练阶段(如RLHF)可能被削弱。对齐技术有时会引入“寻峰行为”,导致对齐后的模型比其基础版本表现得更加自信。如何实现“保留不确定性”的对齐,是一个关键研究方向。
第三是因果性评估的挑战。模型可能只是学会了表达不确定性的“语言风格”(例如,一遇到罕见实体就自动加上限定词),而不是真正在感知并反映其内部状态。论文提到了概念注入、跨模型评估、策略性游戏等评估方法,用以堵住这条漏洞。
对于直接从事幻觉抑制研究的工作,论文也给出了三条中肯的评估建议:展示完整的“效用-错误”权衡曲线,而非仅仅报告单一指标下的成绩;证明自己的工作是在推动前沿(即在固定错误率下获得更高效用),而不是沿着已有的权衡曲线滑动;评估整体外溢影响,例如过度的拒答是否会损害模型在头部知识、推理、代码生成或创意写作等其他方面的能力。
[Figure 5: 给研究社区的建议]论文把建议归为两类:面向“元认知 LLM 与忠实不确定性”方向的开放问题,以及面向“直接缓解幻觉”工作的评估实践。
 图片
信任可以建立在不完美之上
论文的核心观点发人深省:我们信任一位医生,看重的往往不是他全知全能,而是他能稳定地区分“确诊”与“假设”,并在不确定时建议进一步检查。当大模型的输出变得越来越复杂,以至于用户越来越难以独立验证时,诚实地传达不确定性,就不再只是一种礼貌,而成为了安全的刚需。
扩大模型的知识边界固然重要,但知识边界之外、无法靠“知道更多”来解决的那部分不确定性,只能依靠模型忠实地说出“我不确定”来兜底。这或许是论文留给当前大模型发展浪潮最重要的提醒:在追求让模型变得更有知识的同时,或许我们更应该思考,如何让它变得更值得信任——而信任,恰恰可以建立在对自身局限的诚实认知之上。
原文标题:Hallucinations Undermine Trust; Metacognition is a Way Forward