

揭秘AI知识图谱:百万特征如何自动聚合为可读信息
稀疏自编码器提取语言模型数百万特征后,通过对比过滤与证据包验证筛选严格概念集合。构建共现图与转录器机制图,分别揭示概念的全局层次结构及内部流动路径。经边标注与多层次压缩,形成可读知识图谱,系统展示模型内化知识的组织与推理机制,为模型审计与改进提供新途径。
稀疏自编码器(SAE)帮助我们打开了语言模型的黑箱,提取出数百万个可解释的特征。然而,随之而来的挑战是:面对如此庞大的特征列表,我们该如何理解它们?这就像获得了一张标注了无数地点的地图,却不知道这些地点之间如何连接,以及它们如何构成一个完整的知识大陆。
如今,像Gemma Scope和Llama Scope这样的开源工具,已经将SAE技术从小规模演示推向了大规模应用,生成了跨越模型多层、包含海量特征的特征库。但真正的挑战不在于“看到”特征,而在于“看懂”它们是如何组织与协作的。具体而言,我们需要回答三个核心问题:
一、为何需要重新组织SAE特征
首先,是领域识别问题。在数万个特征中,哪些真正代表了连贯的领域知识?哪些只是在追踪标点符号、格式化模板或宽泛的语言模式?许多高度活跃的特征,其“含金量”可能并不高。
其次,是全局组织问题。那些真正有价值的领域概念,在语料库层面是如何聚集成群、相互关联,甚至在不同话题间起到桥梁作用的?
最后,是局部机制问题。当模型处理一个具体句子时,成千上万个被激活的特征是如何通过层与层之间的计算,最终完成推理的?逐个检查这些特征如同大海捞针,难以形成有意义的洞察。
原始的SAE特征库无法有效回答这些问题。语义相关的想法往往分散在多个特征中,这种碎片化既掩盖了概念在宏观上的组织方式,也让理解微观的推理过程变得异常困难。
二、解决方案:从特征库到严格概念宇宙
要解决上述问题,关键在于构建一个既具有高度选择性,又具备清晰结构的表示体系。我们的思路分为两个紧密衔接的阶段。
第一阶段:对比过滤与候选筛选
一切从定义一个严格的“概念宇宙”开始。原始特征库V包含大量特征,但鱼龙混杂。我们通过与一个对比语料库进行比较,依据三个核心维度进行过滤:
支持度:该特征在目标语料库中是否足够普遍?
丰富度:它在目标语料中是否比在对比语料中更具特征性?
定位性:它的出现是否集中在连贯的文本区域,而非随机散布?
这些统计指标能有效筛除大量语法、句法等“样板”特征,确保高召回率。但仅有统计还不够,它们无法最终判定语义相关性。
第二阶段:证据包验证与语义确认
对于通过初筛的每个候选特征,我们会将其转化为一个“证据包”——即最能激活该特征的一组文本片段。通过人工或半自动方式审查这些证据,我们最终确认该特征是否对应一个清晰、领域相关且可区分的概念。经过这一步,我们得到了一个经过严格验证的“严格概念宇宙”V★。后续所有分析都基于此,而非原始的特征海洋。
三、双图视图:结构与机制的统一表示
有了严格的概念集合,下一步就是揭示它们之间的关系。我们构建了两个相互对齐的图视图,分别从宏观和微观两个尺度进行刻画。
第一个视图:多粒度共现图
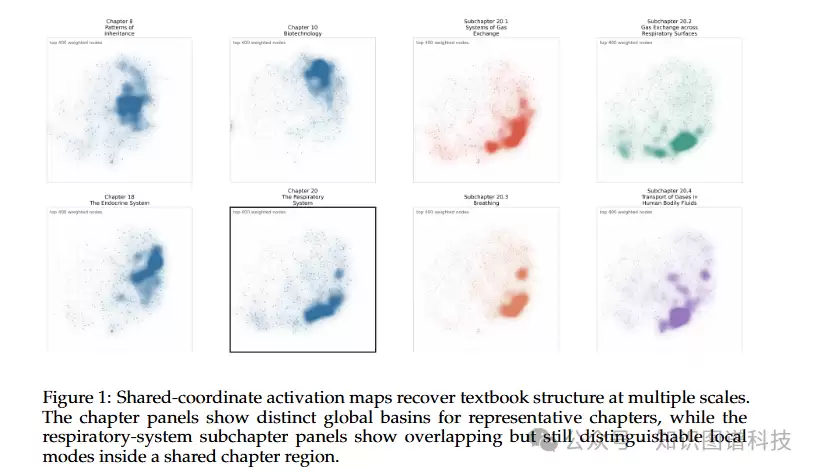
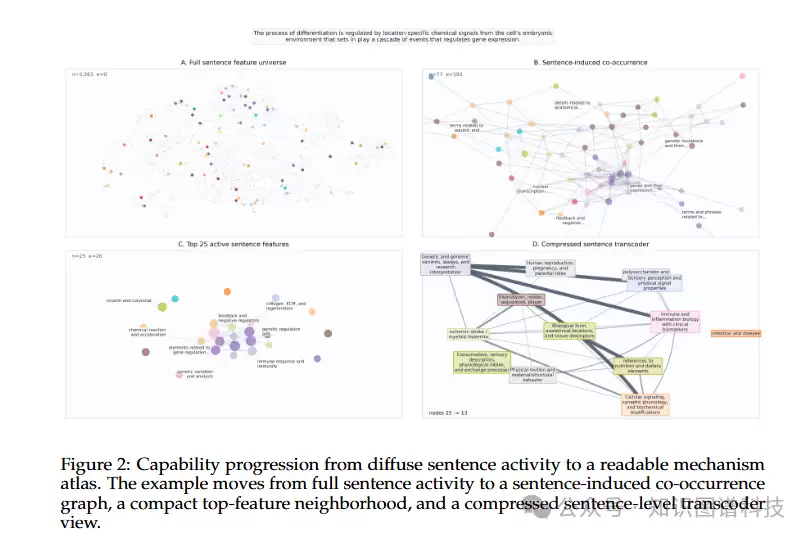
这个视图回答“概念如何全局组织”的问题。它不是一个简单的无标签网络,而是一个经过分层压缩的多粒度结构。概念根据它们在语料库中的共现模式自然聚类,形成从细粒度(子章节内概念)、中粒度(主题集群)到粗粒度(整体领域架构)的层次化组织。这让我们既能看清“树木”(具体概念),也能把握“森林”(整体结构)。
第二个视图:转录器机制图
这个视图则深入到模型内部,回答“概念如何流动与协作”的问题。它建立在“转录器”技术之上。转录器是一种特殊架构,能够稀疏地捕捉一个层的激活如何影响另一个层的激活。通过这个视角,我们可以追踪一个上游概念(例如,“细胞膜”)如何通过中间层的计算,支撑下游概念(例如,“选择性通透”)的激活。这与“电路追踪”的研究精神一脉相承,但目标不同:电路追踪旨在为特定输入寻找因果路径;而我们构建的是一个可重用的、领域通用的框架,其图中的边是模型内部潜在中介结构的可读投影。
四、边标注:从无标签图到可读知识图谱
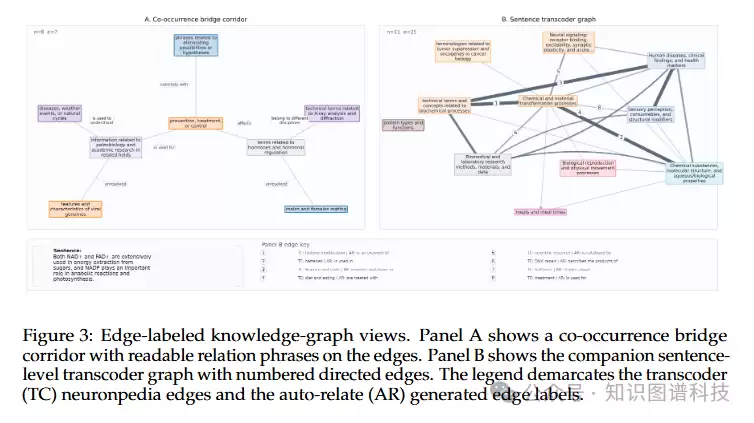
仅有节点和连线的图结构还不够。我们进一步为图中的每条边自动添加丰富的标签,将其转化为真正的、可读的知识图谱。
这一步骤借鉴了传统知识图谱(如Freebase、Wikidata)的思想,但场景截然不同。传统方法是从文本中抽取关于外部世界的实体和关系。而我们是在模型内部的特征之上,诱导出反映其内部知识结构的图,然后为机制诱导出的边附上证据支持的标签。这些标签可能包括关系类型(如“是组成部分”、“导致”)、机制解释以及支持该关系的具体文本证据。
五、多层次压缩:从混乱活动到可读地图
在实际应用中,一个句子可能激活横跨多个残差流的数千个特征。直接呈现这种原始活动模式,对人类理解毫无帮助。因此,我们引入了分层压缩策略。
通过压缩,我们可以将句子级别的、混乱的特征激活模式,转化成一个紧凑、可读的“机制图谱”。这张图谱清晰地标明了在该输入上,哪些关键概念被激活,以及它们之间通过哪些主要路径进行信息传递和推理。这个过程,好比从观察显微镜下单个细胞的纷繁活动,升级到理解整个器官如何协调工作——既保留了必要的机制细节,又获得了整体性的、可理解的视图。
六、案例研究:生物学教科书的应用
为了验证整个框架,我们在一本生物学教科书上进行了测试。结果清晰地展示了系统的三项关键能力:
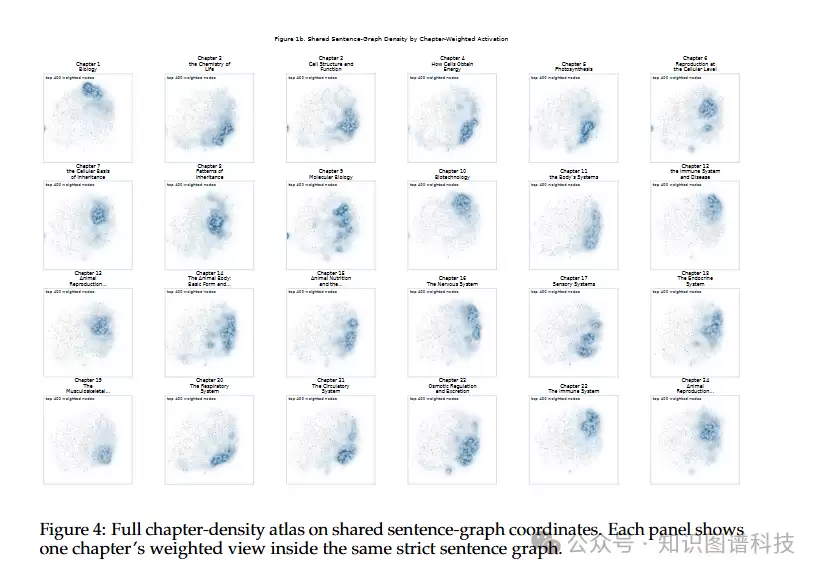
章节结构恢复:共现图成功地从模型内部的特征激活中,自然浮现出了教科书本身的章节和小节级组织结构。这表明,模型确实在某种程度上“学习”并内化了文本的编排逻辑。
概念桥接识别:系统自动识别出那些在相邻主题(如“细胞呼吸”与“能量代谢”)之间起到桥梁作用的关键概念。这些“桥接”概念往往揭示了知识体系中更深层的联系。
机制图谱生成:对于单个复杂的生物学句子,系统能够生成简洁的机制图谱,将数千个底层特征的激活,归结为相对少量的关键概念节点及其间的有效推理路径,使得模型的“思考过程”一目了然。
七、深层意义:从特征可解释性到模型知识审计
这项工作的核心价值,在于它实现了一次关键的范式跃迁:从孤立地解释“某个特征是什么”,升级到系统地审计“模型的知识体系如何构成、如何运作”。
从研究视角看,这意味着我们可以对模型的知识完备性和推理忠实性进行审计。我们不仅能知道模型“认识”某个概念,还能知道这个概念在其整体知识架构中的位置、它与其他概念的关系、以及它如何参与到具体的推理链条中。这对于评估模型在特定领域的理解深度、识别潜在的知识盲区或逻辑缺陷至关重要。
从实践角度出发,这一框架为多个应用场景打开了大门:
模型审计与风险评估:对于部署在医疗、金融等关键领域的模型,可以通过知识图谱检查其是否遗漏核心概念、是否存在错误关联、推理链是否存在薄弱环节。
模型对比与选择:在多个性能相近的候选模型中,可以比较其知识图谱的完整性、准确性和组织结构,作为比单纯准确率更深入的选型依据。
针对性改进:知识图谱能直观暴露模型的薄弱点,使得数据增强、微调等改进措施可以有的放矢,而非盲目优化。
八、与现有工作的关系与创新点
这项工作站在了多个前沿领域的交叉点上,并做出了独特贡献:
与SAE几何研究的关系:先前工作揭示了SAE特征空间存在有意义的几何结构。我们的推进在于,不仅关注几何,更先为特定领域构建了严格的概念集合,并在此基础上建立了连接结构与机制的双视图图模型。
与电路追踪研究的关系:电路追踪致力于为单个输入寻找因果解释。我们的方法则构建了一个可重用的、领域通用的知识框架,其边表示的是潜在的、可复用的中介结构,而非一次性的因果路径。
与传统知识图谱的关系:传统知识图谱抽取外部世界事实。我们则是在模型内部诱导其“心智”中的概念图。传统的关系抽取技术主要影响了我们的边标注层,而节点和边的来源完全基于模型的内部激活与计算流。
九、实现挑战与解决方案
将这一框架付诸实践,需要克服几个显著的技术挑战:
规模挑战:处理数十万量级的特征,构建、存储和可视化如此大规模的图,需要精心设计的数据结构和高效的算法。
验证挑战:如何确保概念过滤和边标注的准确性?这需要建立可靠的自动化评估指标,并结合必要的人类专家验证流程。
可解释性挑战:最终的知识图谱必须能让人类专家理解和信任。这意味着需要为每条边提供清晰的证据溯源,使用直观的概念命名,并提供从概览到细节的多层级交互视图。
十、对企业和机构的实践意义
对于日益关注AI可解释性与安全性的企业和研究机构而言,这项工作提供了切实的抓手:
合规与监管:面对日益严格的AI法规,企业可以使用知识图谱作为一种结构化的、可审计的方式,向监管方展示模型的内在知识结构和决策依据。
质量保证:在模型部署前,对其核心应用领域进行知识图谱审计,成为一道重要的质量关卡。
定向改进:基于知识图谱识别出的缺陷进行针对性优化,提升研发效率。
模型选型:在采购或评估第三方模型时,知识图谱提供了超越“黑盒”测试的深度洞察维度。
十一、未来方向与局限
当然,当前方法也存在局限,并指明了未来的探索方向:
语料库特异性:目前框架针对单一领域语料库构建。如何将其无缝扩展到多领域,并处理跨领域的交叉概念,是一个待解决的问题。
人工验证依赖:虽然自动化程度很高,但关键环节仍需人类专家介入,这在一定程度上限制了大规模应用的效率。
动态图维护:模型会随着新数据微调而演变。如何设计高效的算法,使知识图谱能够与模型同步演化,而非每次重建,是一个重要的工程挑战。
跨模型对比:比较不同架构、不同数据训练的模型所构建的知识图谱,可能揭示训练数据偏差、架构偏好等更深层次的规律,这将是未来一个富有前景的研究方向。