

深入解析V8引擎原理与JavaScript代码优化实战指南
本文深入解析V8引擎的执行机制,涵盖从JIT编译、隐藏类到内联缓存的核心优化原理。通过剖析V8 5.9版本前后的架构演变,详细阐述如何编写高性能JavaScript代码。重点讲解对象属性顺序、动态属性管理、数组处理及数值表示对性能的影响,提供5个实用的代码优化策略,帮助开发者提升Chrome浏览器与Node.js环境下的应用性能。
V8引擎概述与主流实现
概述
JavaScript引擎是负责执行JavaScript代码的程序或解释器。这类引擎可以采用标准解释器的形式,也可以实现为即时编译器(JIT),将JavaScript代码编译为字节码以执行。
以下是目前流行的JavaScript引擎实现项目列表:
- V8 — 开源项目,由Google开发,使用C++编写。
- Rhino — 由Mozilla基金会管理,开源,完全使用Java开发。
- SpiderMonkey — 首个支持Netscape Navigator的JavaScript引擎,目前供Firefox浏览器使用。
- JavaScriptCore — 开源项目,以Nitro品牌销售,由苹果公司为Safari浏览器开发。
- KJS — KDE项目的引擎,最初由Harri Porten为Konqueror网页浏览器开发。
- Chakra (JScript9) — Internet Explorer浏览器使用的引擎。
- Chakra (JavaScript) — Microsoft Edge浏览器使用的引擎。
- Nashorn — 作为OpenJDK的一部分,由Oracle Java语言和工具组编写。
- JerryScript — 专为物联网设计的轻量级引擎。
V8引擎的设计初衷与架构
为什么要创建V8引擎?
由Google构建的V8引擎是开源的,使用C++编写。该引擎不仅用于Google Chrome浏览器,还广泛应用于流行的Node.js环境中,这与其它仅用于浏览器的引擎有所不同。
V8最初的设计目标是提升Web浏览器中JavaScript的执行性能。为了追求速度,V8将JavaScript代码直接转换为高效的机器码,而非依赖传统的解释器。它通过实现即时编译器(JIT),在代码执行时将其编译为机器码,这与SpiderMonkey或Rhino等现代JavaScript引擎的做法类似。主要区别在于,V8不生成字节码或任何中间代码。
V8 5.9版本前的双编译器机制
V8 引擎也曾包含两个编译器
在V8 5.9版本发布之前,V8引擎内部使用了两个编译器:
- full-codegen — 一个简单且速度极快的编译器,生成的机器码相对简单但执行速度较慢。
- Crankshaft — 一种更复杂的即时优化编译器,能够生成高度优化的代码。
V8的多线程执行模型
V8 引擎在内部也利用多个线程进行工作:
- 主线程负责常规操作:获取代码、编译代码并执行它。
- 此外还有一个独立的编译线程,使得主线程可以在前一个线程优化代码的同时继续执行当前任务。
- 一个Profiler线程,用于监控运行时的耗时情况,告知Crankshaft哪些部分需要优化。
- 若干线程专门处理垃圾回收器的工作。
V8核心优化技术解析
当JavaScript代码首次执行时,V8利用full-codegen编译器,直接将解析后的JavaScript翻译成机器代码,不进行任何中间转换。这使得机器代码能够非常快速地开始执行。需要注意的是,V8不使用中间字节码,因此不需要解释器介入。
当代码运行一段时间后,分析线程会收集足够的数据,以判断应当优化哪些方法。
随后,Crankshaft从另一个线程开始执行优化。它将JavaScript抽象语法树转换为称为Hydrogen的高级静态单赋值(SSA)表示形式,并尝试优化Hydrogen图。大多数优化工作都在这一层级完成。
代码内联优化
内联代码
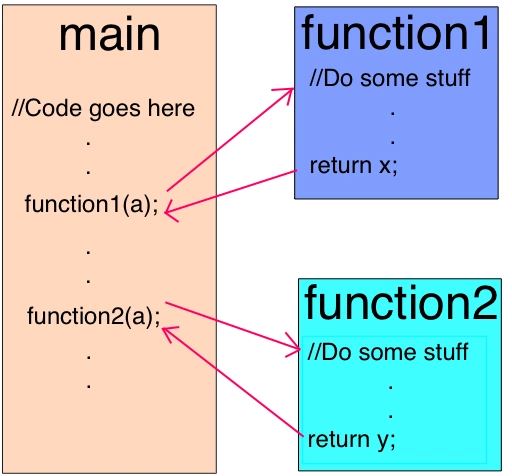
首要优化步骤是尽可能提前内联代码。内联是指用被调用函数的主体替换调用点(即调用函数的代码行)的过程。这一简单步骤使得后续的优化更具意义。
隐藏类与对象布局
隐藏类
JavaScript是一种基于原型的语言,不使用克隆过程来创建类和对象。同时,JavaScript也是动态编程语言,意味着可以在实例化后轻松地在对象中添加或删除属性。
大多数JavaScript解释器使用类似字典的结构(基于哈希函数)来存储对象属性值在内存中的位置。这种结构导致在JavaScript中检索属性值的计算成本,高于Java或C#等非动态编程语言。
在Java中,所有对象属性都在编译前由固定的对象布局确定,且无法在运行时动态添加或删除(尽管C#具有动态类型,但这属于另一个话题)。
因此,属性值(或指向这些属性的指针)可以存储在内存的连续缓冲区中,每个缓冲区之间具有固定偏移量。根据属性类型可以轻松确定偏移长度,而在运行时可更改属性类型的JavaScript中,这是无法实现的。
由于使用字典查找内存中对象属性的位置效率非常低,V8采用了不同的方法:隐藏类。隐藏类的工作方式类似于Java等语言中使用的固定对象(类),只是它们是在运行时创建的。现在,让我们通过实际例子来观察它们:
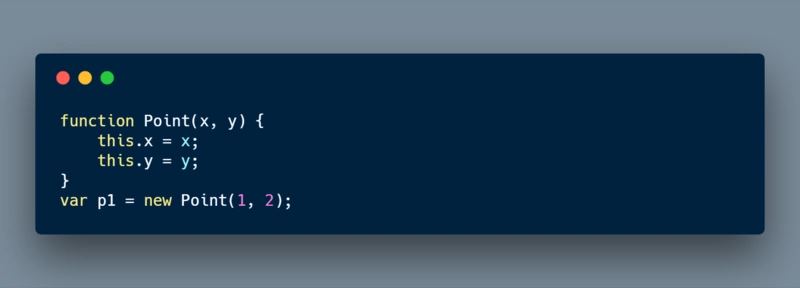
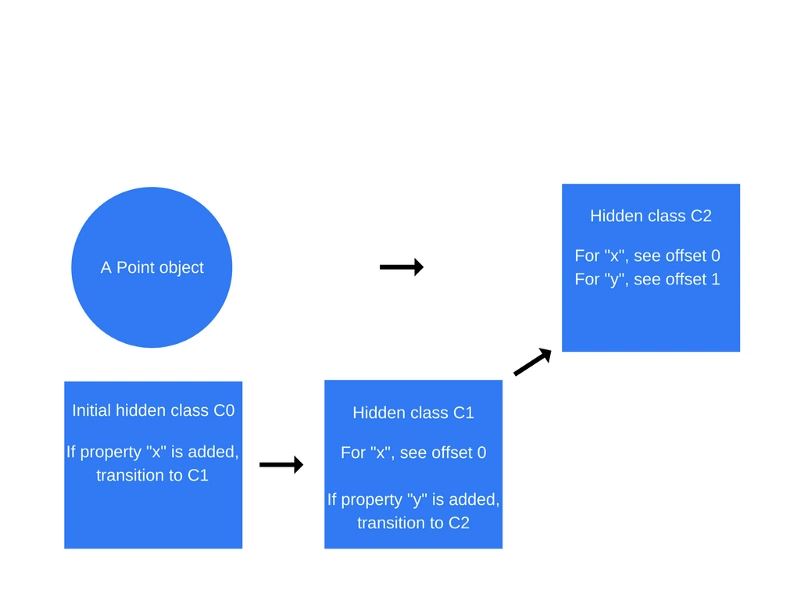
一旦执行“new Point(1, 2)”调用,V8将创建一个名为“C0”的隐藏类。
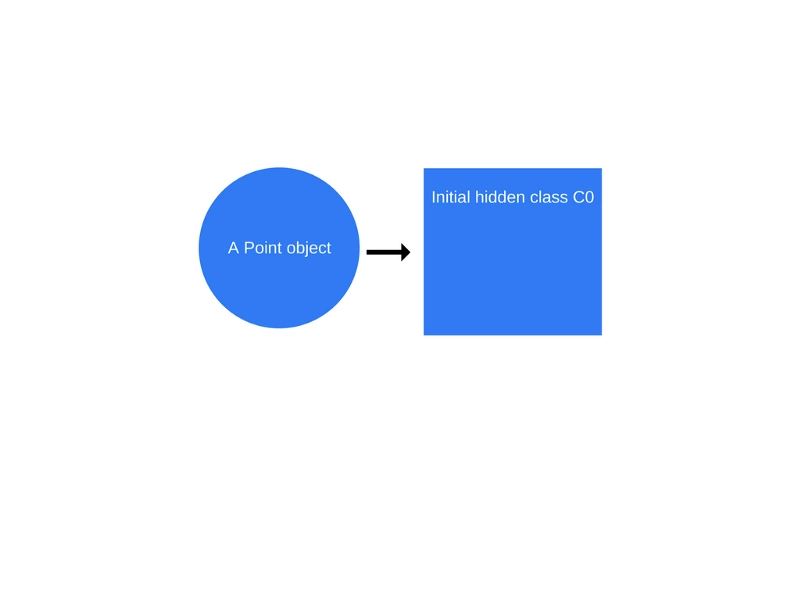
此时尚未为Point定义任何属性,因此“C0”是空的。
一旦执行第一条语句“this.x = x”(在“Point”函数内部),V8将基于“C0”创建名为“C1”的第二个隐藏类。“C1”描述了在内存中可以找到属性x的位置(相对于对象指针)。
在这种情况下,“x”存储在偏移量为0的位置。这意味着,当将内存中的point对象视为连续缓冲区时,第一个偏移量将对应于属性“x”。V8还将使用“类转换”更新“C0”,该类转换指出,如果向point对象添加属性“x”,则隐藏类应从“C0”切换到“C1”。此时,point对象的隐藏类变为“C1”。
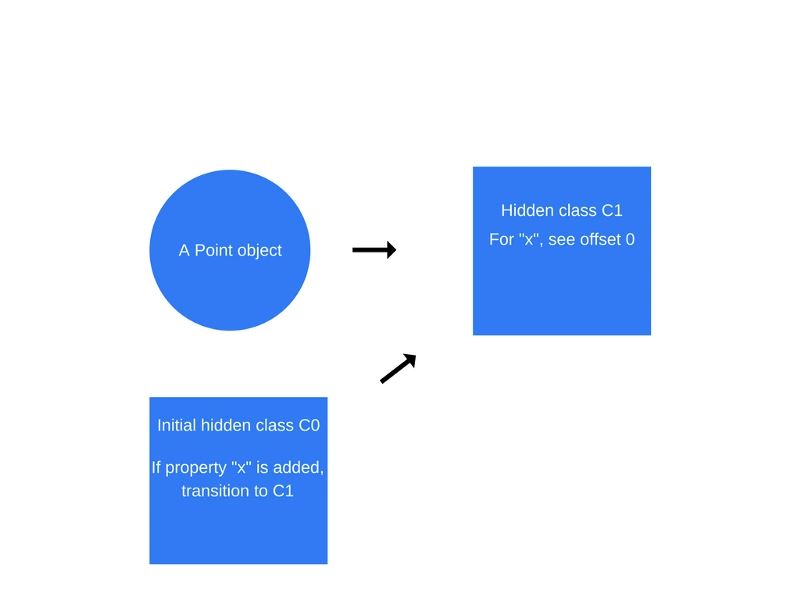
每次向对象添加新属性时,旧的隐藏类都会更新以指向新的隐藏类转换路径。隐藏类转换至关重要,因为它们允许以相同方式创建的对象之间共享隐藏类。如果两个对象共享一个隐藏类,并且向它们添加了相同的属性,则转换将确保两个对象都获得相同的新隐藏类以及随之而来的所有优化代码。
当执行语句“this.y = y”时(在“Point”函数内部,位于“this.x = x”语句之后),会重复同样的过程。
系统会创建一个名为“C2”的新隐藏类。如果向一个已包含属性“x”的Point对象添加属性“y”,则会在“C1”中添加一个类转换,指示隐藏类应更改为“C2”。point对象的隐藏类随之更新为“C2”。
隐藏类转换取决于向对象添加属性的顺序。请观察以下代码片段:
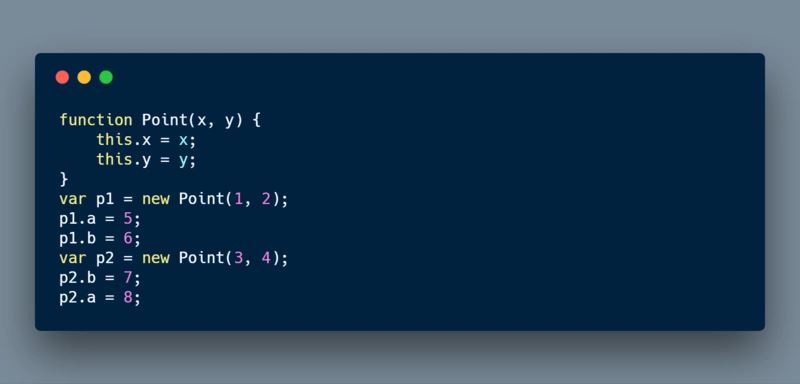
现在,假设对于p1和p2,将使用相同的隐藏类和转换。然而,对于“p1”,首先添加属性“a”,然后添加属性“b”。而“p2”首先分配“b”,然后是“a”。因此,由于不同的转换路径,“p1”和“p2”最终拥有不同的隐藏类。在这种情况下,以相同的顺序初始化动态属性要好得多,以便隐藏类可以被重用。
内联缓存机制
内联缓存
V8利用了另一种针对动态类型语言的优化技术,称为内联缓存。内联缓存基于这样一个观察:对同一方法的重复调用往往发生在同一类型的对象上。这里可以找到对内联缓存的深入解释。
接下来将讨论内联缓存的一般概念(如果您没有时间通过上面的深入了解)。
那么它是如何工作的呢?V8维护了在最近的方法调用中作为参数传递的对象类型的缓存,并利用这些信息预测将来作为参数传递的对象类型。如果V8能够准确预测传递给方法的对象类型,它就可以绕过如何访问对象属性的过程,而是使用从以前的查找到对象隐藏类的存储信息。
那么隐藏类和内联缓存的概念如何相关呢?无论何时在特定对象上调用方法时,V8引擎都必须执行对该对象的隐藏类的查找,以确定访问特定属性的偏移量。在同一个隐藏类的两次成功调用之后,V8省略了隐藏类的查找,并简单地将该属性的偏移量添加到对象指针本身。对于该方法的所有下一次调用,V8引擎都假设隐藏类没有更改,并使用从以前的查找存储的偏移量直接跳转到特定属性的内存地址。这大大提高了执行速度。
内联缓存也是为什么相同类型的对象共享隐藏类非常重要的原因。如果您创建两个相同类型但拥有不同隐藏类的对象(正如我们之前的例子中所做的那样),V8将无法使用内联缓存,因为即使这两个对象属于同一类型,它们对应的隐藏类为其属性分配了不同的偏移量。
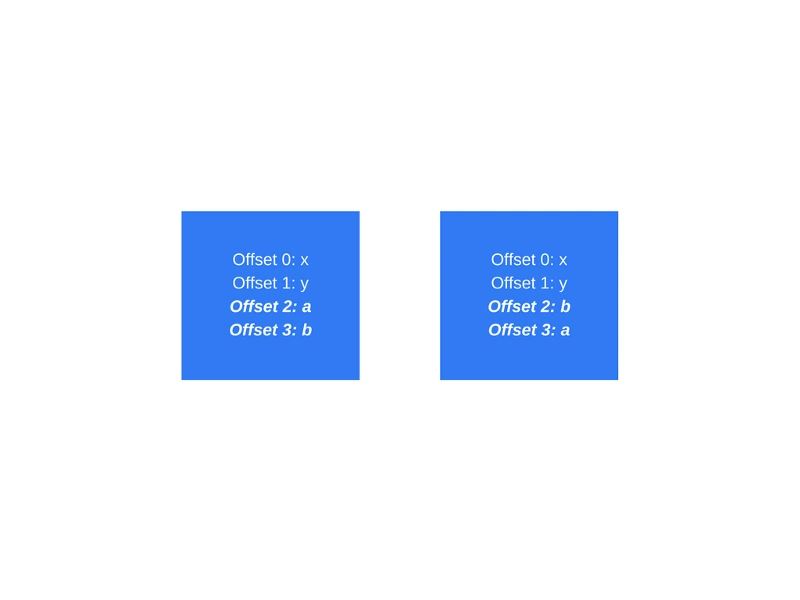
这两个对象基本相同,但是“a”和“b”属性的创建顺序不同。
机器码编译与栈上替换
编译成机器码
一旦Hydrogen图被优化,Crankshaft将其降低到称为Lithium的较低级表示。大部分的Lithium实现都是特定于架构的。寄存器分配往往发生在这个级别。
最后,Lithium被编译成机器码。随后涉及OSR(On-Stack Replacement,栈上替换)。在我们开始编译和优化一个明确的长期运行的方法之前,可能会运行栈上替换。V8并没有缓慢地执行栈上替换并再次开始优化,而是转换了我们拥有的所有上下文(堆栈、寄存器),以便在执行过程中切换到优化版本上。这是一个非常复杂的任务,考虑到除了其他优化之外,V8最初还将代码内联。V8不是唯一能够做到的引擎。
有一种称为去优化的安全措施来进行相反的转换,并在假设引擎判断无效的情况下返回未优化的代码。
垃圾回收策略
垃圾收集
对于垃圾收集,V8采用传统的mark-and-sweep(标记-清除)算法来清理旧一代对象。标记阶段应该停止JavaScript执行。为了控制GC成本并使执行更稳定,V8使用增量标记:不是遍历整个堆并尝试标记每个可能的对象,它只是遍历堆的一部分,然后恢复正常执行。下一个GC停止将从上一个堆行走停止的位置继续,这允许在正常执行期间产生非常短暂的暂停。如前所述,扫描阶段由单独的线程处理。
JavaScript代码优化实战技巧
如何编写优化的 JavaScript
- 对象属性的顺序:始终以相同的顺序实例化对象属性,以便可以共享隐藏的类和随后优化的代码。
- 动态属性:因为在实例化之后向对象添加属性将强制执行隐藏类的更改,并降低之前隐藏类所优化的所有方法的执行速度,所以在其构造函数中分配所有对象的属性。
- 方法:重复执行相同方法的代码将比仅执行一次的多个不同方法(由于内联缓存)的代码运行得更快。
- 数组:避免稀疏数组,其中键值不是自增的数字,并没有存储所有元素的稀疏数组是哈希表。这种数组中的元素访问开销较高。另外,尽量避免预分配大数组。最好是按需增长。最后,不要删除数组中的元素,这会使键值变得稀疏。
- 标记值:V8 使用 32 位表示对象和数值。由于数值是 31 位的,它使用了一位来区分它是一个对象(flag = 1)还是一个称为 SMI(SMall Integer)整数(flag = 0)。那么,如果一个数值大于 31 位,V8会将该数字装箱,把它变成一个双精度数,并创建一个新的对象来存放该数字。尽可能使用 31 位有符号数字,以避免对 JS 对象的高开销的装箱操作。
Ignition与TurboFan新架构
Ignition and TurboFan
随着2017年早些时候发布V8 5.9,引入了新的执行管道。这个新的管道在实际的JavaScript应用程序中实现了更大的性能提升和显着节省内存。
新的执行流程是建立在Ignition(V8的解释器)和TurboFan(V8的最新优化编译器)之上的。
自从V8 5.9版本问世以来,由于V8团队一直努力跟上新的JavaScript语言特性以及这些特性所需要的优化,V8团队已经不再使用full-codegen和Crankshaft(自2010年以来为V8技术所服务)。
这意味着V8整体上将有更简单和更易维护的架构。
这些改进只是一个开始。新的Ignition和TurboFan管道为进一步优化铺平了道路,这些优化将在未来几年内提升JavaScript性能并缩小V8在Chrome和Node.js中的占用空间。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
基于AST抽象语法树的JS代码反混淆实战教程
2026-11-03 21:22:24
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19
相关标签: