

Node.js Koa框架入门:中间件机制与简单爬虫实战
本文介绍基于Node.js的Koa轻量级Web框架,重点解析其利用ES7 async/await特性处理异步请求的中间件机制。通过ctx对象详解请求上下文,并结合request与cheerio模块演示如何抓取网页数据,适合初学者掌握Koa核心概念及基础爬虫开发。
Koa框架概述
Koa 是一个运行在 Node.js 平台上的下一代 Web 开发框架。
Koa 由 Express 的原班团队开发,旨在构建更小、更具表现力且更健壮的 Web 应用。使用 Koa 可以避免繁琐的回调函数嵌套,并显著提升错误处理效率。Koa 内核不绑定任何中间件,仅提供轻量级的函数库,使 Web 应用开发更加简洁。其开发思路与 Express 类似,但最大优势在于避免了异步代码的深层嵌套。Koa 2 利用 ES7 的 async/await 特性,极大解决了 Node.js 开发中异步编程带来的复杂性。
英文官网地址:http://koajs.com
中文官网地址:http://koajs.cn
1. 安装 Koa
Koa安装与配置
安装 Koa 包的命令为:npm i -S koa@latest。引入模块的代码为:const koa = require("koa");。实例化 Koa 对象的代码为:const app = new koa;。
中间件机制详解
专门用于处理客户端请求的函数称为中间件,通过 use() 方法进行注册。
use() 函数内部必须使用异步关键字 async;use() 可以被调用多次。
中间件函数包含两个参数:
a) ctx:上下文环境,封装了 Node.js 的请求和响应对象。建议不使用 Node.js 原生的 req 和 res 属性,而是使用 Koa 封装后的 request 和 response 属性。
b) next:调用 next() 可将当前请求的控制权传递给下一个中间件。
最后一个中间件中调用 next() 没有实际意义,执行完毕后控制权会逐层返回,直至回到第一个中间件。
1. next 参数使用示例
const Koa = require("koa");
const koa = new Koa();
//中间件1
koa.use(async (ctx, next) => {
console.log("1 , 接收请求控制权");
await next(); //将控制权传给下一个中间件
console.log("1 , 返回请求控制权");
});    //将中间件注册到koa的实例上

//中间件2
koa.use(async (ctx, next) => {
 console.log("2 , 接收请求控制权");
await next();
console.log("2 , 返回请求控制权");
});

//中间件3
koa.use(async (ctx, next) => {
console.log("3 , 接收请求控制权");
 console.log("3 ,返回请求控制权");
});
koa.listen(3000, ()=>{
 console.log("开始监听3000端口");
});
注意:如果中间件中未调用 next(),后续注册的中间件将不会执行。
访问 localhost:3000 的运行效果如下:
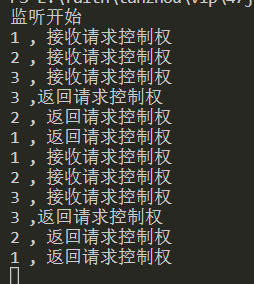
注意:页面显示两次操作日志是因为浏览器会自动请求一次 favicon.ico 图标。
上下文对象ctx的使用
2. ctx 参数使用示例
const Koa = require("koa");
const koa = new Koa();
koa.use(async (ctx, next)=>{
 ctx.body = "body可以返回数据,";
 ctx.body += "可以多次调用,";
 ctx.body += "不需要end()";
});
koa.listen(3000, ()=>{
 console.log("监听开始");
});
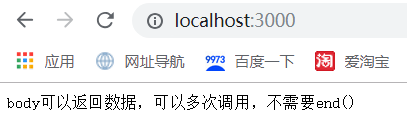
运行效果如下:
涉及 ctx 的属性包括:ctx.url、ctx.path、ctx.query、ctx.querystring、ctx.state、ctx.type。
const Koa = require("koa");
const koa = new Koa();
koa.use(async (ctx, next)=>{
 ctx.body = ctx.url;
 ctx.body = ctx.path;
 ctx.body = ctx.query;
 ctx.body = ctx.querystring;
});
koa.listen(3000, ()=>{
 console.log("监听开始");
});
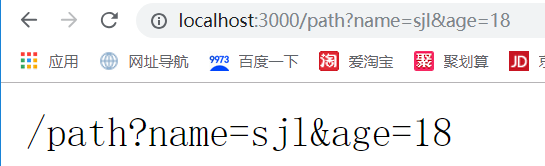
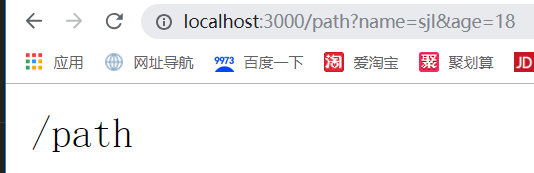
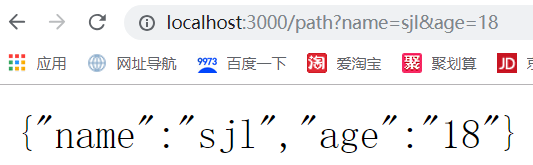
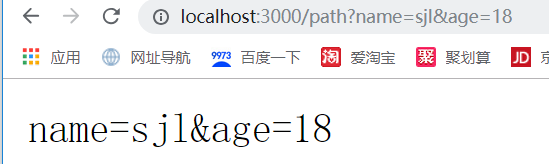
以访问 http://localhost:3000/path?name=sjl&age=18 为例,运行效果如下:
1. url:获取完整的 URL 路径。
2. path:获取不包含查询参数的路径部分。
3. query:将查询字符串解析为 JSON 对象。
4. querystring:将查询部分保持为字符串格式。
5. ctx.state 和 ctx.type 分别表示响应状态码和内容类型。
基于Koa的简单爬虫实战
2. 简单爬虫练习
安装 request 和 cheerio 模块。
npm i -S request: 请求模块
npm i -S cheerio: 抓取页面模块(JQ核心)
以下是一个抓取随机网页数据的案例。
//导入模块
const request = require("superagent"); //导入请求模块
const cheerio = require("cheerio");
const {join} = require("path");
const fs = require("fs");

let arr = [], //存放数据
 reg = /\n|\s+/g, //replace中使用
 url = "https://www.shiguangkey.com/course/search?key=%E5%89%8D%E7%AB%AF/";
request
 .get(url)
 .end((err, res) => {
  const $ = cheerio.load(res.text); //把字符串内的标签当成dom来使用
  $(".course-item").each((i, v) => {
   // v当前进来的dom,根据网页的布局结构来找到准确的dom节点
   const obj = {
    imgSrc : $(v).find("img").prop("src"),
    price : $(v).find(".fr span").text().replace(reg, ""),
    total : $(v).find(".item-txt").text().replace(reg, ""),
    href : join(url + $(v).find(".cimg").prop("href"))
   };
   console.log(join(url + $(v).find(".cimg").prop("href"))); //拼接
   arr.push(obj); //把对象放进数组里
  });

  fs.writeFile("./sjl.json", JSON.stringify(arr)); //将爬到的数据写入文档中
 });
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
macOS卸载Node.js指南:区分Homebrew与pkg安装包的处理方式
2026-11-05 11:28:12
JS逆向入门:浏览器Console调试与Node.js环境搭建指南
2026-11-05 10:57:15
Node.js 大版本升级需要注意哪些破坏性变更
2026-11-03 20:35:44
Node.js官网LTS版与Current版有什么区别
2026-11-03 19:33:49
Windows彻底卸载Node.js:清理AppData残留与PATH环境变量
2026-11-03 19:15:35
相关标签: